ELBO, Diffusion-Loss, pass@k und Skalierungsgesetze lesen

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Teil erklärt, was zwei generative Models trainieren und was vier verbreitete Messgrößen aussagen. Er richtet sich an Ingenieure, die ELBO und Diffusion-Loss verstehen oder Paper mit Angaben zu pass@k, Perplexität, Rechenkomplexität und Skalierungsgesetzen vergleichen möchten. Die Diagramme zeigen die Berechnungen; die Gleichungen geben genau an, was optimiert oder gezählt wird.
Die Abschnitte über generative Models bauen aufeinander auf. Die Abschnitte über Metriken lassen sich unabhängig lesen. Teil 1 bietet bei Bedarf eine Notationsübersicht. Alle Logarithmen hier sind natürliche Logarithmen.
Generative Models: ELBO und Diffusion
Ein Sprachmodell kann einer vorgegebenen Antwort Token für Token eine Wahrscheinlichkeit zuweisen. Andere generative Models führen verborgene Variablen ein: Zwischenwerte, die bei der Datengenerierung helfen, aber im Trainingsdataset fehlen. Um die Wahrscheinlichkeit eines Bildes zu berechnen, müsste man dann möglicherweise über zu viele verborgene Werte mitteln. Die nächsten beiden Methoden trainieren, ohne diesen Mittelwert exakt zu berechnen.
ELBO: eine berechenbare untere Schranke
Ein Variational Autoencoder (VAE) erzeugt ein Bild aus einem latenten Vektor : einer Liste von Zahlen. Ein einfaches zweidimensionales Beispiel ist . Diese Zahlen sind Eingaben für ein neuronales Netz, keine Anweisungen in einer Programmiersprache. Der Vektor ist latent, weil das Trainingsdataset Bilder enthält, aber die zugehörigen -Werte nicht vorgibt.
Um in dem hier beschriebenen Standard-VAE ein Bild zu generieren, ziehe jeden Eintrag von unabhängig aus einer Normalverteilung mit Mittelwert 0 und Standardabweichung 1. Das Ziehen von Werten gemäß einer Verteilung heißt Sampling. Diese feste Verteilung über Vektoren ist der Prior, geschrieben als .
Der Decoder ist ein trainiertes neuronales Netz. Seine gelernten Weights transformieren in die Parameter einer Verteilung über Pixelwerte. Ein Decoder für Bilder mit 28 mal 28 Pixeln, deren Werte 0 oder 1 sind, kann beispielsweise 784 Wahrscheinlichkeiten ausgeben, eine pro Pixel. Jede Wahrscheinlichkeit gibt an, wie wahrscheinlich der Wert 1 für dieses Pixel ist. Das Sampling dieser Pixelwerte erzeugt ein Bild. Die Einträge des Vektors bestimmen über das gelernte Netz die Pixelwahrscheinlichkeiten; sie sind nicht selbst Pixel. Kingma und Welling, §3 und Anhang C, beschreiben diesen Standardaufbau.
Beim Training stammt ein Bild aus dem Dataset. Ein Encoder, ein weiteres neuronales Netz, erhält dieses Bild als Eingabe. In dem hier verwendeten gaußschen Aufbau sagt er für jeden Eintrag von einen Mittelwert und eine Standardabweichung vorher. Zusammen definieren diese , eine Verteilung über latente Vektoren für dieses Bild. Wir sampeln aus dieser Verteilung statt aus dem Prior. Der Decoder weist dann dem ursprünglichen Bild mithilfe des gesampelten Vektors die Wahrscheinlichkeit zu.
Das Training belohnt den Decoder dafür, dem beobachteten Bild eine hohe Log-Wahrscheinlichkeit zuzuweisen. Außerdem zieht es die KL-Divergenz ab: ein nichtnegatives Maß dafür, wie stark die Vektorverteilung des Encoders vom festen Prior abweicht. Das Diagramm zeigt beide Terme und die andere Herkunft der Vektoren bei der Generierung.
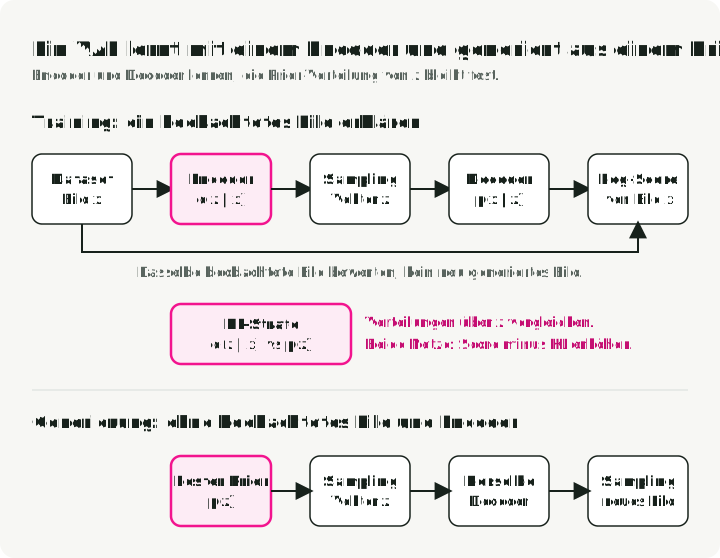
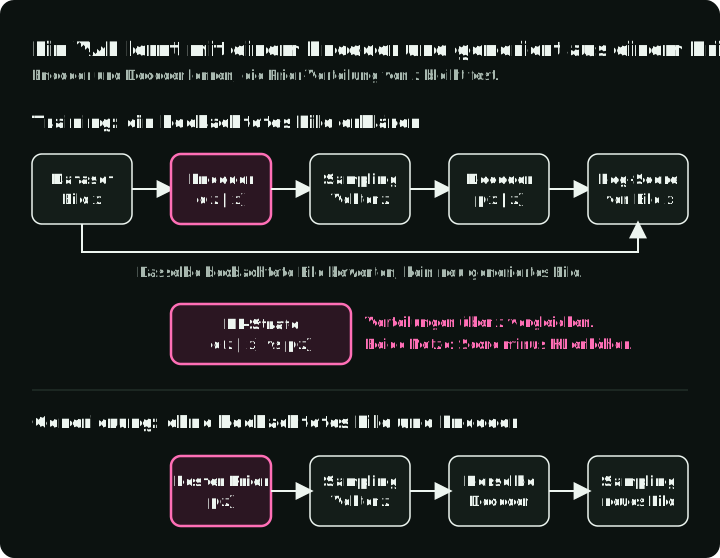
Der Trainingsscore hat zwei Terme:
Der erste Term mittelt die Log-Wahrscheinlichkeit des Bildes über die vom Encoder gesampelten Vektoren. Der zweite ist die KL-Strafe. Die Symbole und bezeichnen die gelernten Parameter von Encoder und Decoder. Beide Netze lernen, diesen Score zu erhöhen; Code, der einen Loss minimiert, verwendet den negativen Score.
Dies ist der Evidence Lower Bound, kurz ELBO. Die Evidenz ist die Wahrscheinlichkeit des Models für das beobachtete Bild, gemittelt über alle möglichen latenten Vektoren. Kingma und Welling, §2.2, Gleichungen (1)–(3), setzen sie zum Trainingsscore in Beziehung:
Hier ist der wahre Posterior: die Verteilung des Models über latente Vektoren, wenn dieses Bild gegeben ist. Der nichtnegative KL-Term ist die Differenz zwischen ELBO und Log-Evidenz; er ist null, wenn der Encoder diesen Posterior nachbildet. Diese Identität erklärt die Schranke. Die berechenbare Trainingsstrafe im Diagramm vergleicht den Encoder dagegen mit dem bekannten Prior . Ein Trainingsschritt benötigt daher den unbekannten Posterior nicht.
Ein höherer ELBO beweist allein nicht, dass sich der Decoder verbessert hat. Ein besserer Encoder kann die Schranke genauer machen, während der Decoder unverändert bleibt. Außerdem gilt die Schranke für den exakten Erwartungswert: Eine Schätzung aus wenigen gesampelten Vektoren kann bei einer einzelnen Ziehung die Log-Evidenz überschreiten. Die ausführliche ELBO-Lektüre leitet die Schranke her und prüft sie an einem durchgerechneten Beispiel.
DDPM: das hinzugefügte Rauschen vorhersagen
Bei DDPM sind die verborgenen Variablen verrauschte Versionen eines Bildes. Beim Training nimmt es ein unverrauschtes Bild aus dem Dataset und zieht zufälliges Rauschen: eine standardnormalverteilte Zahl pro Bildkoordinate. Es wählt zufällig einen Schritt aus einem festen Rauschplan, der die Mischanteile von Bild und Rauschen bestimmt. Das Netz sieht dieses verrauschte Bild und ; seine Aufgabe ist, genau das gerade hinzugefügte Rauschen vorherzusagen.
Die Generierung verwendet das trainierte Netz wiederholt. Sie beginnt mit zufälligem Rauschen, sagt Rauschen auf der aktuellen Stufe vorher und verwendet diese Vorhersage für einen kleinen Entrauschungsschritt. Die Weights bleiben dabei unverändert. Das Training hat somit einen bekannten Zielwert, der den Fehler zur Aktualisierung des Netzes liefert; die Generierung erzeugt mit dem gelernten Netz über viele Schritte ein Bild.
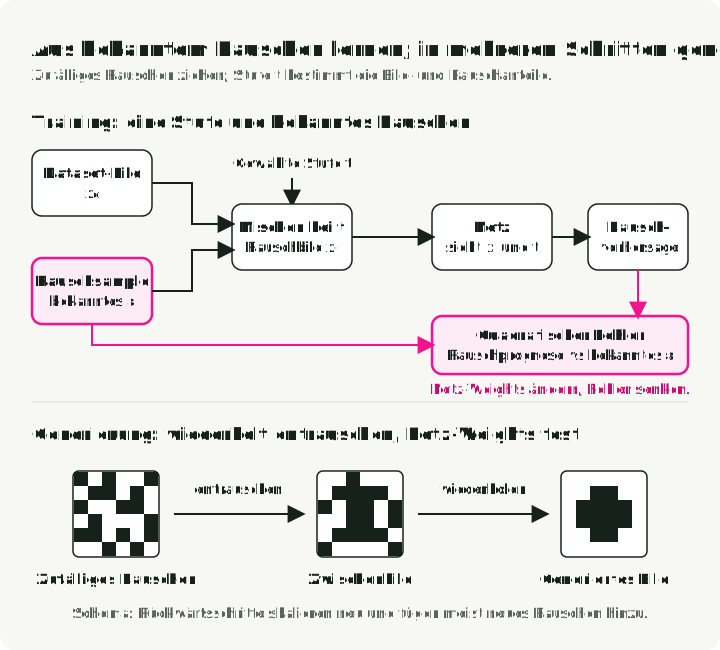
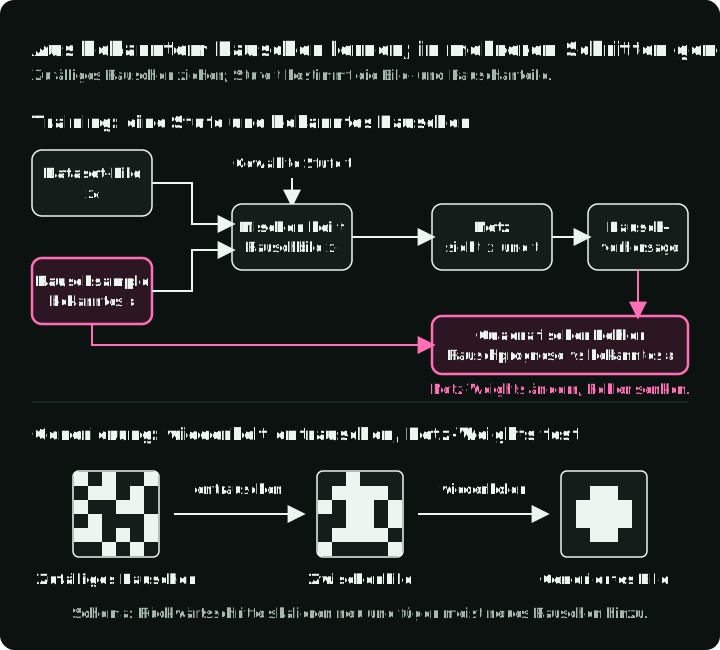
Die Schreibweise für die verrauschte Eingabe erleichtert das Lesen des Loss:
ist ein unverrauschtes Trainingsbild, ein zufällig gewählter Schritt und eine neue standardnormalverteilte Rauschstichprobe. Das Netz mit gelernten Parametern sagt diese Stichprobe vorher. Die quadrierte Norm summiert die quadrierten Vorhersagefehler über die Bildkoordinaten; der Erwartungswert mittelt über Bilder, Schritte und Rauschstichproben.
Der feste Plan definiert und , wobei die in Schritt hinzugefügte Rauschvarianz ist. Der Überstrich bezeichnet dieses Produkt, keinen Mittelwert. Es bestimmt die beiden Koeffizienten der Mischung im Diagramm: für das Bild und für das Rauschen. Nahe 1 bedeutet überwiegend Bild; nahe 0 bedeutet überwiegend Rauschen.
Das Training kann direkt konstruieren; es muss nicht jeden vorhergehenden Rauschschritt ausführen. Das ursprüngliche DDPM verwendet 1.000 Stufen und sampelt die Trainingsschritte gleichverteilt. Siehe Gleichung (4), Gleichung (14) und Algorithmus 1 oder die ausführliche DDPM-Lektüre.
Das Paper leitet eine mit dem ELBO verwandte Variationsschranke her und ändert dann die Gewichtung ihrer Terme, um diesen praktischen Loss zu erhalten. Der vereinfachte Loss ist selbst nicht die ursprüngliche Likelihood-Schranke. Bei der Generierung skaliert Algorithmus 2 das aktuelle Bild neu, zieht ein Vielfaches des vorhergesagten Rauschens ab und fügt außer im letzten Schritt neues Rauschen hinzu. Er zieht nicht einfach die Vorhersage einmal ab, um ein unverrauschtes Bild zu erhalten.
Metriken und Kostenangaben
Eine Trainingszielfunktion, ein Evaluationsscore und eine Kostenschätzung beantworten unterschiedliche Fragen. Die nächsten Abschnitte zeigen, was jede angegebene Zahl zählt und was für einen sinnvollen Vergleich unverändert bleiben muss.
Pass@k: die Wahrscheinlichkeit, dass mindestens eines von k Samples besteht
pass@k fragt, ob mindestens eines von generierten Programmen die Tests besteht. Es erlaubt mehrere Versuche; es bedeutet nicht, dass die erste Antwort des Models richtig ist.
Das Codex-Paper sampelt für jede Aufgabe unabhängig Programme und zählt die Programme, die bestehen. Dann betrachtet es jede mögliche Menge aus Samples. Vom Wert eins wird der Anteil der Mengen abgezogen, die nur Fehlschläge enthalten:
Die Notation zählt, auf wie viele Arten sich Elemente aus ohne Zurücklegen auswählen lassen. Dies ist die Schätzung für eine Aufgabe; der angegebene Score mittelt sie über die Aufgaben. Bei fünf Samples, von denen zwei bestehen und drei scheitern, gibt es zehn Paare. Nur drei Paare enthalten zwei Fehlschläge. Die Schätzung für pass@2 ist daher .
Das Raster zeigt diese zehn Paare im hypothetischen Beispiel. Alle fünf Programme lösen dieselbe Aufgabe und durchlaufen dieselben Tests. Ein Paar besteht, sobald eines seiner beiden Programme besteht.
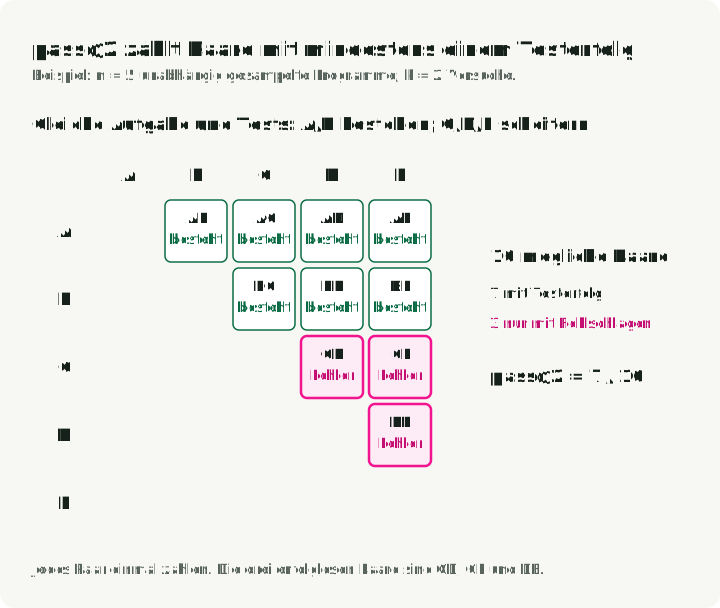
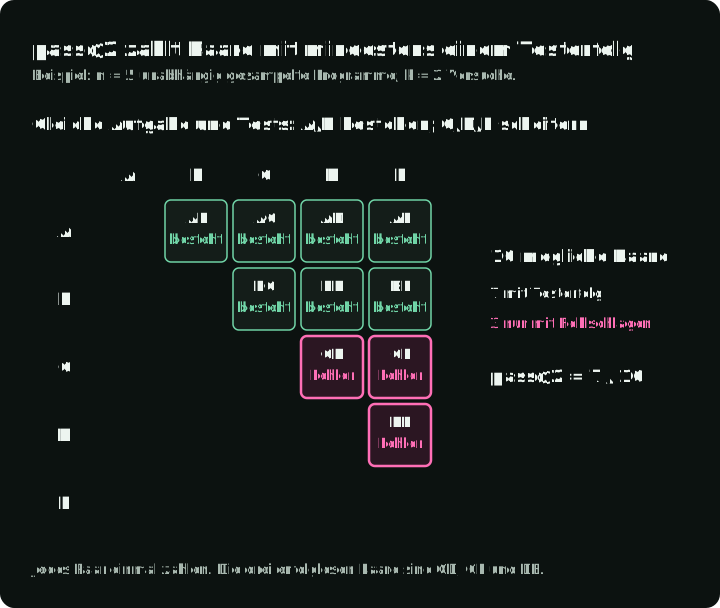
Verwende diesen Schätzer mit ganzzahligen Anzahlen und . Wenn weniger als Samples scheitern, enthält jede Menge ein Sample, das die Tests besteht, und die Schätzung ist 1. Die naheliegende Abkürzung ist verzerrt; im Beispiel ergibt sie 0.64. Das Codex-Paper, §2.1 und Abbildung 3, liefert den Schätzer und eine numerisch stabile Implementierung; die ausführliche Lektüre erklärt, warum er funktioniert.
Vergleiche dasselbe , dieselben Aufgaben, Tests, Prompts und Generierungseinstellungen. Bestandene Tests belegen nicht die Korrektheit für jede Eingabe. Ein eingesetztes System braucht außerdem eine Möglichkeit, einen Kandidaten auszuwählen, der die Tests besteht, etwa durch Ausführen dieser Tests; das bloße Generieren mehrerer Antworten identifiziert die richtige nicht.
Perplexität: die effektive Anzahl von Auswahlmöglichkeiten pro Token
Perplexität bewertet die Wahrscheinlichkeiten, die ein Sprachmodell den tatsächlichen nächsten Tokens eines vorgegebenen Texts zuweist. An jeder Position erhält das Model den vorhergehenden Text und liefert Wahrscheinlichkeiten für die möglichen nächsten Tokens. Dann wird die Wahrscheinlichkeit des tatsächlich folgenden Tokens abgelesen. Eine generierte Antwort ist nicht nötig. Der Score überführt die mittlere negative Log-Wahrscheinlichkeit auf eine leichter interpretierbare Skala:
ist die Anzahl der Tokens, das beobachtete Token und sein vorhergehender Kontext. Wenn das Model jedem beobachteten Token die Wahrscheinlichkeit gibt, ist die Perplexität 4. Bei unterschiedlichen Wahrscheinlichkeiten verwendet der Score ihr geometrisches Mittel. Die Wahrscheinlichkeiten 0.5, 0.2 und 0.1 ergeben eine Perplexität von ungefähr 4.64: denselben Score wie die Wahrscheinlichkeit für jedes Token.
Die Diagramme verwenden erfundene Wahrscheinlichkeiten für drei aufeinanderfolgende Positionen. Jeder Balken stammt aus einer anderen Next-Token-Vorhersage; die Balken müssen sich daher nicht zu 1 summieren. Das rechte Diagramm ersetzt sie durch einen konstanten Wert. Die Produkte stimmen überein, also auch die Perplexitäten.
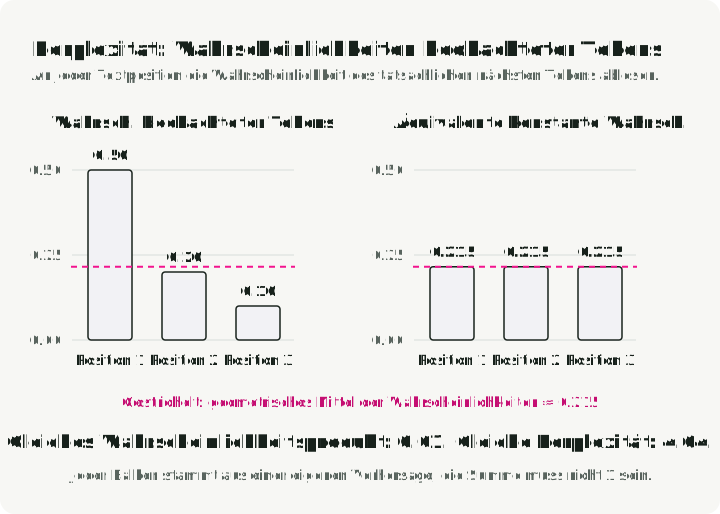
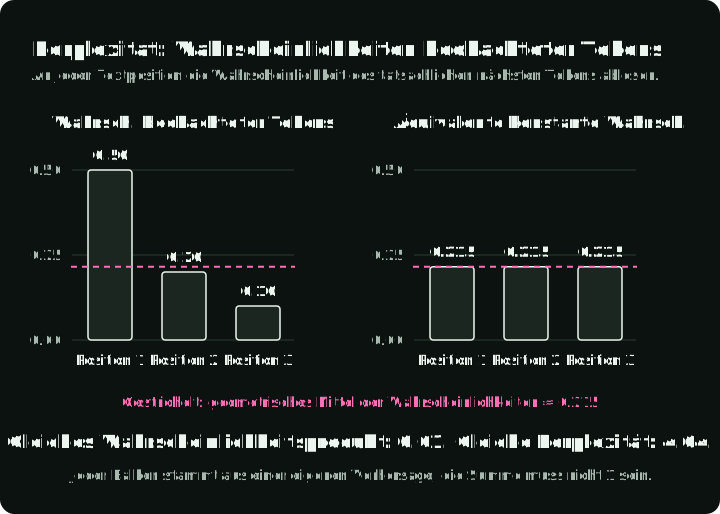
Bei gleichem Evaluationstext, Tokenizer und Kontextverfahren ist ein kleinerer Wert besser. Er bedeutet, dass das Model dem beobachteten Text eine höhere Wahrscheinlichkeit zugewiesen hat, nicht dass seine generierten Antworten nützlicher oder richtiger sind. Tokenizer teilen Text unterschiedlich auf, und der Umgang mit dem Context Window verändert die Wahrscheinlichkeiten. Der Perplexitätsleitfaden von Hugging Face erklärt diese Vergleichsbedingungen.
Big-O: wie die Kosten mit der Sequenzlänge wachsen
Self-Attention transformiert den aktuellen Vektor jedes Tokens mithilfe gelernter Matrizen in Query, Key und Value. Ein Query-Key-Vergleich bewertet, wie stark eine Position eine andere verwenden soll. Diese Scores werden zu Gewichtungsfaktoren für die Kombination der Values, wie in der Attention-Definition des Transformers, §3.2.
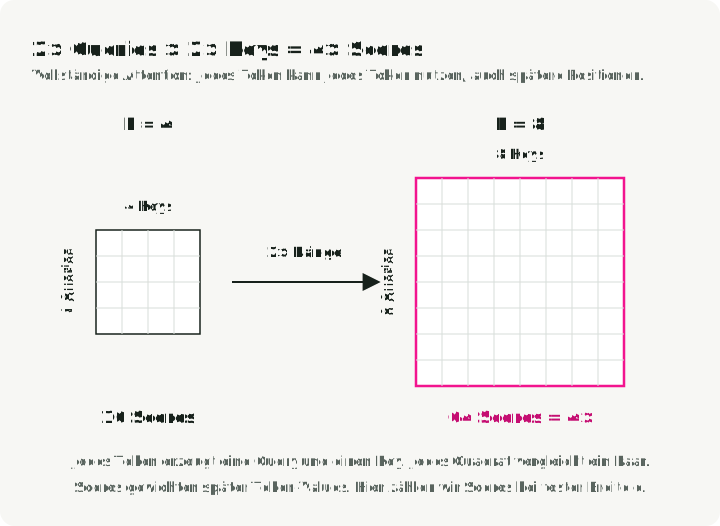
Für einen Attention Head und Tokens ergibt der Vergleich jeder Query mit jedem Key eine Score-Tabelle der Größe . Eine Verdopplung der Sequenzlänge vervierfacht diese Tabelle. Ist jeder Vergleich ein Skalarprodukt der Länge , wächst der Rechenaufwand für die Scores gemäß . Big-O beschreibt eine asymptotische obere Schranke; es lässt Konstanten weg und sagt allein keine Laufzeit voraus.
Die Raster zeigen vollständige Attention: Jede Position kann jede Position verwenden. Eine längere Sequenz fügt sowohl Query-Zeilen als auch Key-Spalten hinzu. Jede Zelle ist ein Score; Implementierungen wie FlashAttention können die Scores berechnen, ohne das ganze Raster gleichzeitig zu speichern. Kausale Attention schließt künftige Positionen aus, aber die Anzahl der zulässigen Paare wächst weiterhin quadratisch.
Unterschiedliche Attention-Änderungen senken unterschiedliche Kosten:
| Methode | Was sich ändert | Was mit der Sequenz weiter wächst |
|---|---|---|
| FlashAttention | Berechnet Attention blockweise und vermeidet eine vollständige Score-Tabelle im GPU-Hauptspeicher | Der Rechenaufwand für die Scores bleibt quadratisch |
| DSA | Ein günstigerer Scorer wählt bis zu Tokens für vollständige Attention | Der Scorer vergleicht weiterhin alle zulässigen Paare |
| MLA | Speichert weniger Attention-Daten pro gecachtem Token | Die Cache-Größe wächst weiterhin linear mit der Tokenanzahl |
Diese Einsparungen sind keine austauschbaren Beschleunigungen. Prüfe, ob ein Paper Rechenoperationen, belegten Speicher, Speichertransfers oder Cache-Größe gemessen hat. Prüfe außerdem, ob es die Prompt-Verarbeitung oder die Token-Generierung gemessen hat; DeepSeek-V3.2, Abbildung 3, weist diese Phasen getrennt aus.
Skalierungsgesetze: angepasste Kurven mit begrenztem Gültigkeitsbereich
Ein Skalierungsgesetz hilft, ein Trainingsbudget zwischen einem größeren Model und mehr Daten aufzuteilen. Es ist eine an Experimente angepasste Kurve. Beispielsweise berichtet DeepSeek LLM, §3.2, Gleichung (4):
ist der Trainingsrechenaufwand in Gleitkommaoperationen. ist der Rechenaufwand pro Token ohne Embeddings und dient hier als Maß für die Model-Größe; es ist nicht die Parameteranzahl. ist die Anzahl der Trainingstokens. Der Index „opt“ kennzeichnet die angepasste Aufteilung, die den Validierungsloss bei diesem Budget minimieren soll. Die Koeffizienten 0.1715 und 5.8316 gehören zu dieser Anpassung und diesen Einheiten.
Die folgenden Kurven teilen die angepassten Aufteilungen durch ihre Werte bei einem Budget von FLOPs, sodass sich jeder angepasste Koeffizient herauskürzt. Ein hundertfaches Budget ergibt den -fachen Rechenaufwand pro Token und die -fache Tokenanzahl. Dies sind die beiden Endpunkte der Abbildung. Ihre Faktoren multiplizieren sich, weil das Paper den Gesamtrechenaufwand als definiert.
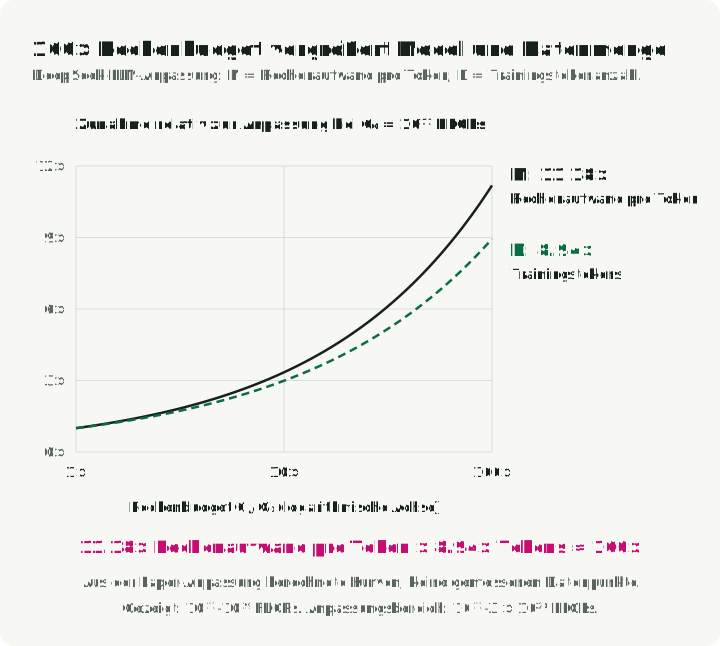
Diese Schlussfolgerung gilt für diese Experimente. Die Anpassung deckt bis FLOPs ab. Außerhalb dieses Bereichs ist sie eine Extrapolation; selbst innerhalb können andere Daten oder Trainingseinstellungen die beste Aufteilung verändern. Abschnitt 3.3 berichtet unterschiedliche Exponenten für unterschiedliche Datasets. Die ausführliche Lektüre zu Skalierungsgesetzen erklärt die Einheiten und prüft das Zusammenspiel der angepassten Formeln.
Eine Gleichung lesen, die diese Serie nicht behandelt
Verwende für eine andere Gleichung die sechs Fragen aus Teil 1: Bestimme die Objekte, Operationen, Dimensionen, das Sampling, die gelernten Größen und die getroffene Aussage.
Das Repository paper-math-skills liefert Agent-Anweisungen zum Schreiben und Prüfen einer ausführlichen Erläuterung. Die verlinkten Lektüren zeigen solche Ergebnisse mit Symboldefinitionen und numerischen Prüfungen.
Quellen und Versionen
Eine ausführlichere Einführung in die Grundlagen bietet Tianhua Chens The Little Book of Generative AI Foundations, §3.2 behandelt den ELBO.