De ELBO, diffusion loss, pass@k en schaalwetten lezen

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit deel legt uit wat twee generatieve models trainen en wat vier veelgebruikte metingen vertellen. Het is voor engineers die de ELBO en diffusion loss willen begrijpen, of papers willen vergelijken die pass@k, perplexiteit, rekencomplexiteit en schaalwetten rapporteren. De diagrammen tonen de berekeningen; de vergelijkingen geven precies aan wat wordt geoptimaliseerd of geteld.
De secties over generatieve models bouwen op elkaar voort. De secties over meetwaarden kun je onafhankelijk lezen. Deel 1 biedt zo nodig een naslagwerk voor de notatie. Alle logaritmen hier zijn natuurlijke logaritmen.
Generatieve models: de ELBO en diffusie
Een taalmodel kan een gegeven antwoord token voor token een kans toekennen. Andere generatieve models introduceren verborgen variabelen: tussenwaarden die helpen gegevens te genereren, maar ontbreken in de trainingsdataset. De kans op een afbeelding berekenen kan dan een gemiddelde over te veel mogelijke verborgen waarden vereisen. De volgende twee methoden trainen zonder dat gemiddelde exact te berekenen.
ELBO: een ondergrens die je kunt berekenen
Een variational autoencoder (VAE) genereert een afbeelding uit een latente vector : een lijst getallen. Een tweedimensionaal voorbeeld is . Deze getallen zijn invoer voor een neuraal netwerk, geen instructies in een programmeertaal. De vector is latent omdat de trainingsdataset afbeeldingen bevat, maar niet de bijbehorende -waarden.
Om in de hier beschreven standaard-VAE een afbeelding te genereren, trek je elk element van onafhankelijk uit een normale verdeling met gemiddelde 0 en standaardafwijking 1. Waarden trekken volgens een verdeling heet sampling. Deze vaste verdeling over vectoren is de prior, geschreven als .
De decoder is een getraind neuraal netwerk. Zijn geleerde weights zetten om in de parameters van een verdeling over pixelwaarden. Een decoder voor afbeeldingen van 28 bij 28 pixels met waarde 0 of 1 kan bijvoorbeeld 784 kansen geven, één per pixel. Elke kans geeft aan hoe waarschijnlijk het is dat die pixel 1 is. Door die pixelwaarden te samplen ontstaat een afbeelding. De elementen van de vector bepalen via het geleerde netwerk de pixelkansen; ze zijn zelf geen pixels. Kingma en Welling, §3 en appendix C, beschrijven deze standaardopzet.
Tijdens training komt een afbeelding uit de dataset. Een encoder, een ander neuraal netwerk, krijgt deze afbeelding als invoer. In de Gaussische opzet hier voorspelt die voor elk element van een gemiddelde en standaardafwijking. Samen definiëren die , een verdeling over latente vectoren voor deze afbeelding. We samplen uit die verdeling in plaats van uit de prior. De decoder kent vervolgens met de gesamplede vector kans toe aan de oorspronkelijke afbeelding.
Training beloont de decoder voor een hoge logkans op de waargenomen afbeelding. Ook trekt training KL-divergentie af: een niet-negatieve maat voor hoeveel de verdeling van vectoren van de encoder afwijkt van de vaste prior. Het diagram toont beide termen en de andere herkomst van vectoren tijdens generatie.
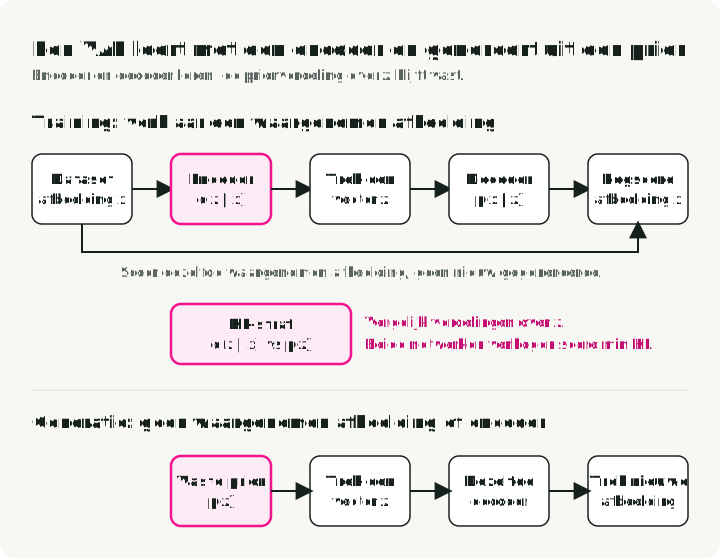
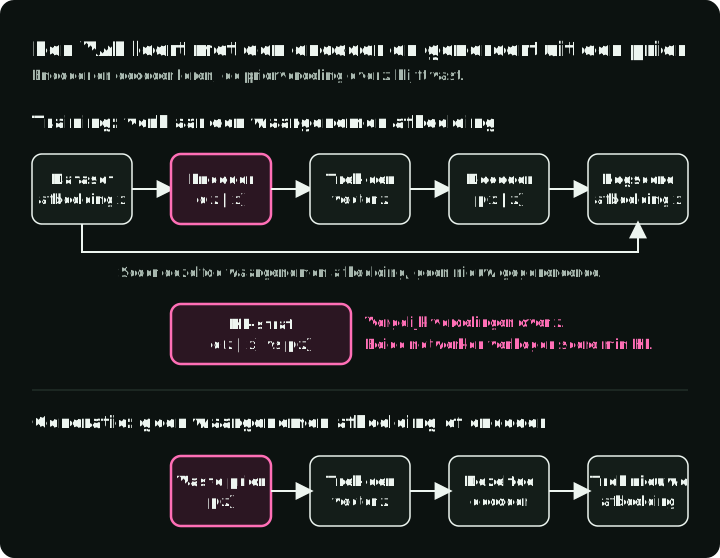
De trainingsscore heeft twee termen:
De eerste term middelt de logkans op de afbeelding over vectoren die uit de encoder zijn getrokken. De tweede is de KL-strafterm. De symbolen en geven de geleerde parameters van de encoder en decoder aan. Beide netwerken leren deze score te verhogen; code die een loss minimaliseert, gebruikt het negatieve ervan.
Dit is de evidence lower bound, of ELBO. De evidence is de kans die het model aan de waargenomen afbeelding toekent, gemiddeld over alle mogelijke latente vectoren. Kingma en Welling, §2.2, vergelijkingen (1)–(3), verbinden die met de trainingsscore:
Hier is de echte posterior: de verdeling van het model over latente vectoren, gegeven deze afbeelding. De niet-negatieve KL-term is het verschil tussen de ELBO en de log-evidence; hij is nul als de encoder overeenkomt met die posterior. Deze identiteit verklaart de ondergrens. De berekenbare trainingsstraf in het diagram vergelijkt de encoder juist met de bekende prior , zodat een trainingsstap de onbekende posterior niet nodig heeft.
Een hogere ELBO bewijst op zichzelf niet dat de decoder beter is geworden. Een betere encoder kan de ondergrens nauwkeuriger maken zonder de decoder te veranderen. De grens geldt bovendien voor de exacte verwachtingswaarde: een schatting uit een paar getrokken vectoren kan bij een afzonderlijke trekking boven de log-evidence liggen. De uitgebreide ELBO-uitwerking leidt de grens af en controleert hem met een uitgewerkt voorbeeld.
DDPM: voorspel de toegevoegde ruis
DDPM gebruikt versies van een afbeelding met ruis als verborgen variabelen. Tijdens training neemt het een schone afbeelding uit de dataset en trekt het willekeurige ruis: één standaardnormaal getal voor elke afbeeldingscoördinaat. Het kiest willekeurig een stap uit een vast ruisschema dat bepaalt in welke verhouding afbeelding en ruis worden gemengd. Het netwerk ziet deze aangetaste afbeelding en ; het moet de zojuist toegevoegde ruistrekking voorspellen.
Generatie gebruikt het getrainde netwerk herhaaldelijk. Het proces begint met willekeurige ruis, voorspelt ruis op het huidige niveau en gebruikt die voorspelling voor een kleine stap die ruis verwijdert. De weights blijven tijdens dit proces vast. Training heeft dus een bekend doel dat de fout levert om het netwerk bij te werken; generatie gebruikt het geleerde netwerk om via vele stappen een afbeelding te produceren.
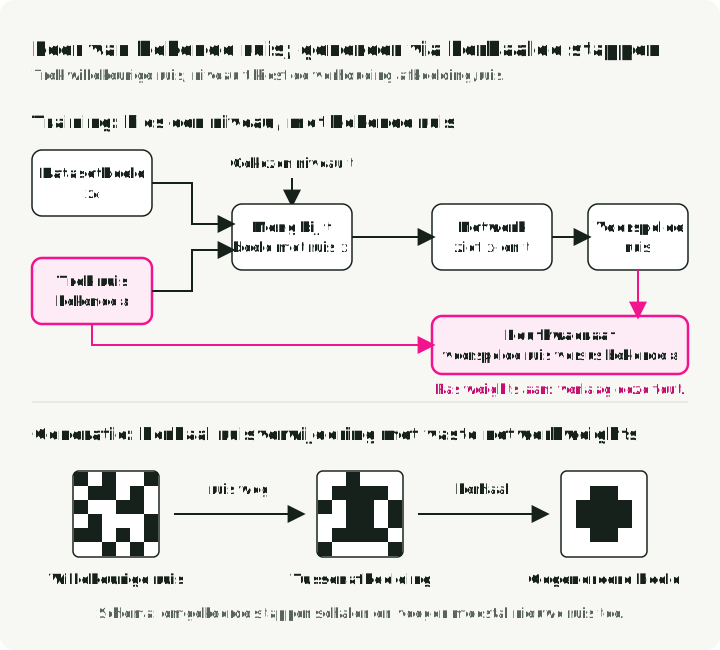
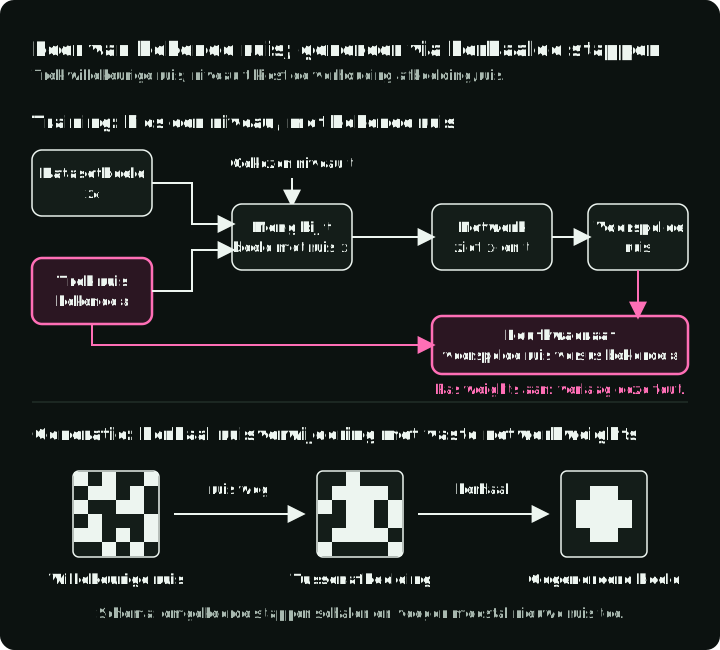
De loss is makkelijker te lezen als we de invoer met ruis schrijven als :
is een schone trainingsafbeelding, een willekeurig gekozen stap en een nieuwe standaardnormale ruistrekking. Het netwerk , met geleerde parameters , voorspelt die trekking. De gekwadrateerde norm telt de gekwadrateerde voorspellingsfouten over afbeeldingscoördinaten op; de verwachtingswaarde middelt over afbeeldingen, stappen en ruistrekkingen.
Het vaste schema definieert en , waarbij de variantie is van de in stap toegevoegde ruis. De streep geeft dit product aan, geen gemiddelde. Het bepaalt de twee coëfficiënten in het mengsel van het diagram: voor de afbeelding en voor de ruis. Dicht bij 1 betekent vooral afbeelding; dicht bij 0 vooral ruis.
Training kan direct construeren en hoeft niet elke voorafgaande ruisstap uit te voeren. De oorspronkelijke DDPM gebruikt 1.000 niveaus en trekt trainingsstappen uniform. Zie vergelijking (4), vergelijking (14) en algoritme 1, of de uitgebreide DDPM-uitwerking.
De paper leidt een variationele grens af die verband houdt met de ELBO en verandert vervolgens de weging van de termen om deze praktische loss te krijgen. De vereenvoudigde loss is zelf niet de oorspronkelijke likelihood-grens. Tijdens generatie schaalt algoritme 2 de huidige afbeelding, trekt het een veelvoud van de voorspelde ruis af en voegt het, behalve bij de laatste stap, nieuwe ruis toe. Het trekt de voorspelling dus niet simpelweg één keer af om een schone afbeelding terug te krijgen.
Meetwaarden en uitspraken over kosten
Een trainingsdoel, een evaluatiescore en een kostenschatting beantwoorden verschillende vragen. De volgende secties tonen wat elk gerapporteerd getal telt en wat gelijk moet blijven voor een nuttige vergelijking.
Pass@k: de kans dat minstens één van k trekkingen slaagt
pass@k vraagt of minstens één van gegenereerde programma’s de tests doorstaat. Het staat meerdere pogingen toe; het betekent niet dat het eerste antwoord van het model correct is.
De Codex-paper trekt voor elke opgave onafhankelijk programma’s en telt de die slagen. Daarna bekijkt de paper elke mogelijke verzameling van trekkingen. Trek het aandeel verzamelingen met alleen mislukkingen af:
De notatie telt de manieren om items uit te kiezen zonder teruglegging. Dit is de schatting voor één opgave; de gerapporteerde score middelt die over opgaven. Met vijf trekkingen, twee geslaagde en drie mislukte, zijn er tien paren. Slechts drie paren bevatten twee mislukkingen, dus de geschatte pass@2 is .
Het raster toont die tien paren in dit hypothetische voorbeeld. Alle vijf programma’s beantwoorden dezelfde opgave en worden met dezelfde tests getest. Een paar slaagt zodra een van zijn twee programma’s slaagt.
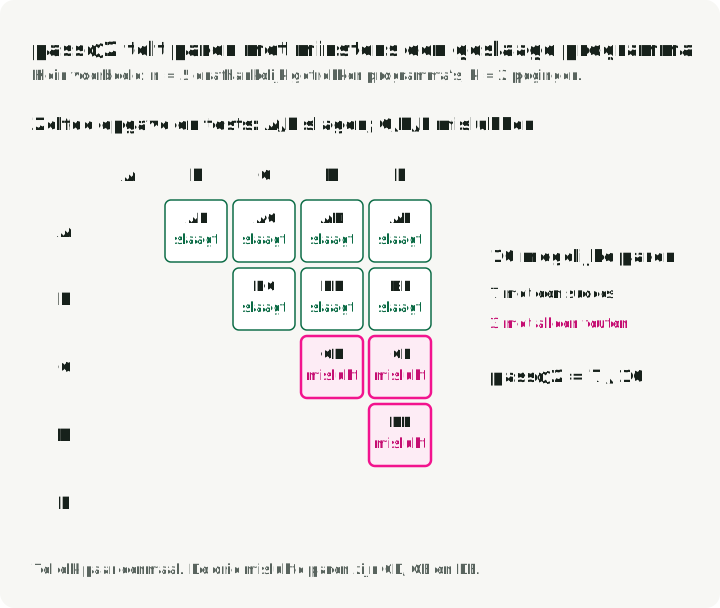
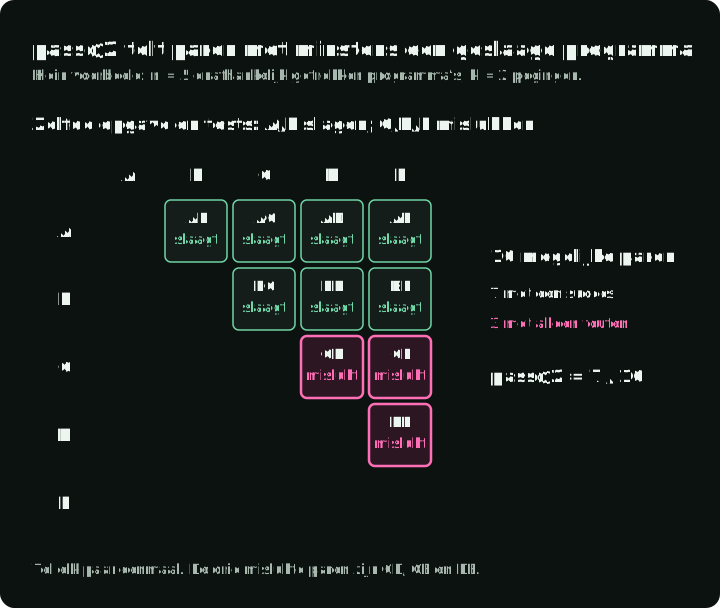
Gebruik deze schatter met gehele aantallen en . Als minder dan trekkingen mislukken, bevat elke verzameling een geslaagde trekking en is de schatting 1. De verleidelijke verkorte berekening is vertekend; die geeft hier 0.64. De Codex-paper, §2.1 en figuur 3, geeft de schatter en een numeriek stabiele implementatie; de uitgebreide uitwerking legt uit waarom hij werkt.
Vergelijk bij dezelfde , opgaven, tests, prompts en generatie-instellingen. De tests doorstaan bewijst niet dat een programma voor elke invoer correct is. Een ingezet systeem heeft ook een manier nodig om een geslaagde kandidaat te selecteren, bijvoorbeeld door die tests uit te voeren; meerdere antwoorden genereren wijst het goede antwoord niet aan.
Perplexiteit: het effectieve aantal keuzes per token
Perplexiteit beoordeelt de kansen die een taalmodel toekent aan de werkelijke volgende tokens van een gegeven tekst. Geef het model op elke positie de voorafgaande tekst, vraag zijn kansen voor de mogelijke volgende tokens op en lees de kans van het token dat echt volgt. Een gegenereerd antwoord is niet nodig. De score zet de gemiddelde negatieve logkans om naar een makkelijker te interpreteren schaal:
is het aantal tokens, het waargenomen token en de voorafgaande context. Als het model elk waargenomen token kans geeft, is de perplexiteit 4. Als hun kansen verschillen, gebruikt de score het meetkundig gemiddelde. Kansen 0.5, 0.2 en 0.1 geven een perplexiteit van ongeveer 4.64: dezelfde score als wanneer elk token kans krijgt.
De grafieken gebruiken verzonnen kansen voor drie opeenvolgende posities. Elke staaf komt uit een andere voorspelling van het volgende token, dus de staven hoeven niet op te tellen tot 1. De rechtergrafiek vervangt ze door één constante waarde; de producten zijn gelijk, dus de perplexiteiten ook.
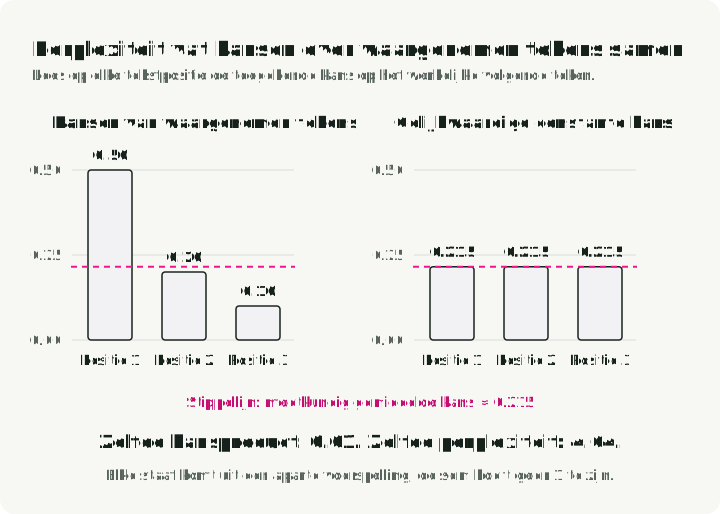
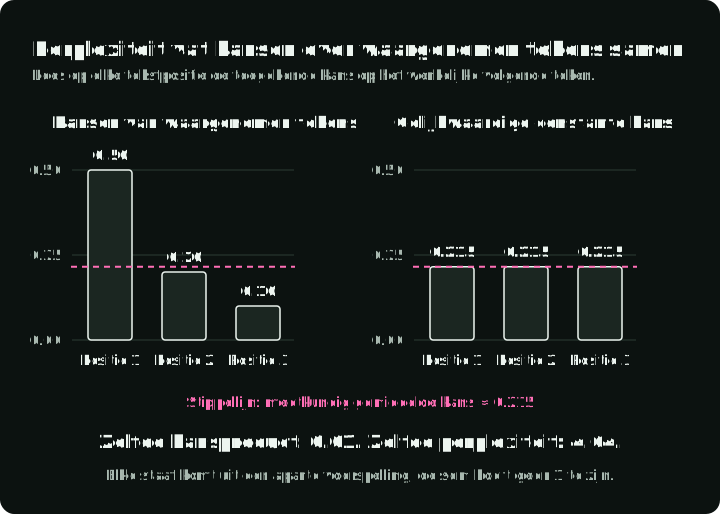
Lager is beter voor dezelfde evaluatietekst, tokenizer en contextprocedure. Het betekent dat het model de waargenomen tekst een hogere kans gaf, niet dat zijn gegenereerde antwoorden nuttiger of correcter zijn. Tokenizers splitsen tekst verschillend en de omgang met het context window verandert de kansen. De perplexiteitshandleiding van Hugging Face legt deze vergelijkingsvoorwaarden uit.
Big-O: hoe kosten groeien met de sequentielengte
Self-attention zet de huidige vector van elk token via geleerde matrices om in een query, een key en een value. Een query–key-vergelijking geeft een score voor hoe sterk de ene positie de andere moet gebruiken. Die scores worden weights om de values te combineren, zoals in de attention-definitie van de Transformer, §3.2.
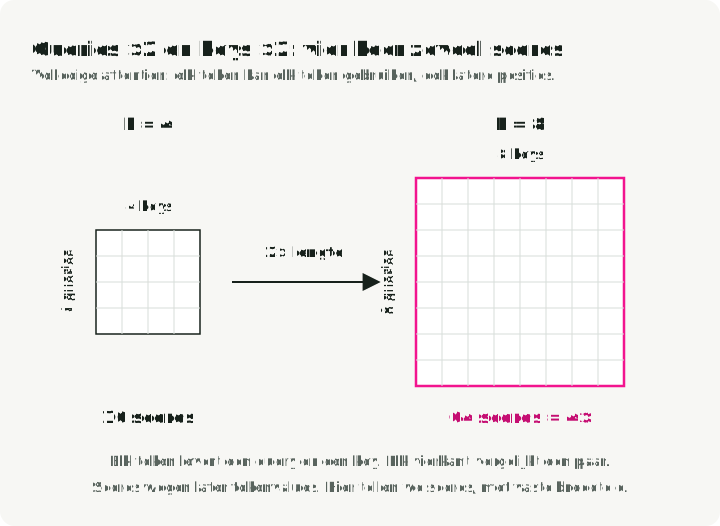
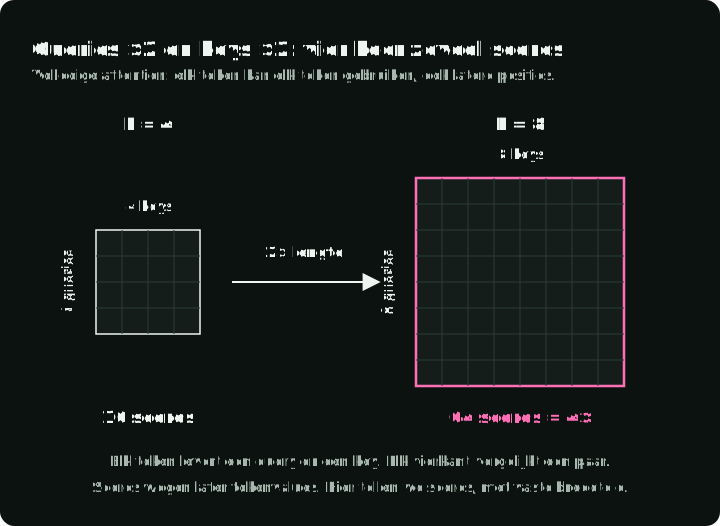
Voor één attention head en tokens levert elke query met elke key vergelijken een scoretabel van op. De sequentielengte verdubbelen maakt die tabel vier keer zo groot. Als elke vergelijking een inwendig product van lengte is, groeit het rekenwerk voor de scores als . Big-O beschrijft een asymptotische bovengrens; het laat constanten weg en voorspelt op zichzelf geen runtime.
De rasters tonen volledige attention: elke positie kan elke positie gebruiken. Een langere sequentie voegt zowel queryrijen als keykolommen toe. Elke cel is één score; implementaties zoals FlashAttention kunnen de scores berekenen zonder het hele raster tegelijk op te slaan. Causale attention sluit toekomstige posities uit, maar het aantal toegestane paren groeit nog steeds kwadratisch.
Verschillende aanpassingen van attention verminderen verschillende kosten:
| Methode | Wat verandert | Wat nog steeds groeit met de sequentie |
|---|---|---|
| FlashAttention | Berekent attention in blokken en vermijdt een volledige scoretabel in het hoofdgeheugen van de GPU | Het rekenwerk voor scores blijft kwadratisch |
| DSA | Een goedkopere scorefunctie selecteert tot tokens voor volledige attention | De scorefunctie vergelijkt nog steeds alle toegestane paren |
| MLA | Slaat minder attention-gegevens per gecachet token op | De cachegrootte groeit nog steeds lineair met het aantal tokens |
Deze besparingen zijn niet onderling uitwisselbare snelheidswinsten. Controleer of een paper rekenwerk, toegewezen geheugen, geheugenoverdrachten of cachegrootte heeft gemeten. Controleer ook of het om promptverwerking of tokengeneratie ging; DeepSeek-V3.2, figuur 3, rapporteert die fasen apart.
Schaalwetten: gefitte curves met een geldig bereik
Een schaalwet helpt een trainingsbudget te verdelen over een groter model en meer gegevens. Het is een curve die aan experimenten is gefit. DeepSeek LLM, §3.2, vergelijking (4), rapporteert bijvoorbeeld:
is het rekenwerk voor training in drijvendekommabewerkingen. is het rekenwerk per token buiten embeddings, hier gebruikt als maat voor de modelgrootte; het is niet het aantal parameters. is het aantal trainingstokens. De index “opt” geeft de verdeling aan die is gefit om de validatieloss bij dat budget te minimaliseren. De coëfficiënten 0.1715 en 5.8316 horen bij deze fit en deze eenheden.
De onderstaande curves delen de gefitte verdelingen door hun waarden bij een budget van FLOP, zodat elke gefitte coëfficiënt wegvalt. Een 100 keer groter budget geeft keer zoveel rekenwerk per token en keer zoveel tokens. Dat zijn de twee eindpunten in de figuur. Je vermenigvuldigt deze factoren, omdat de paper het totale rekenwerk definieert als .
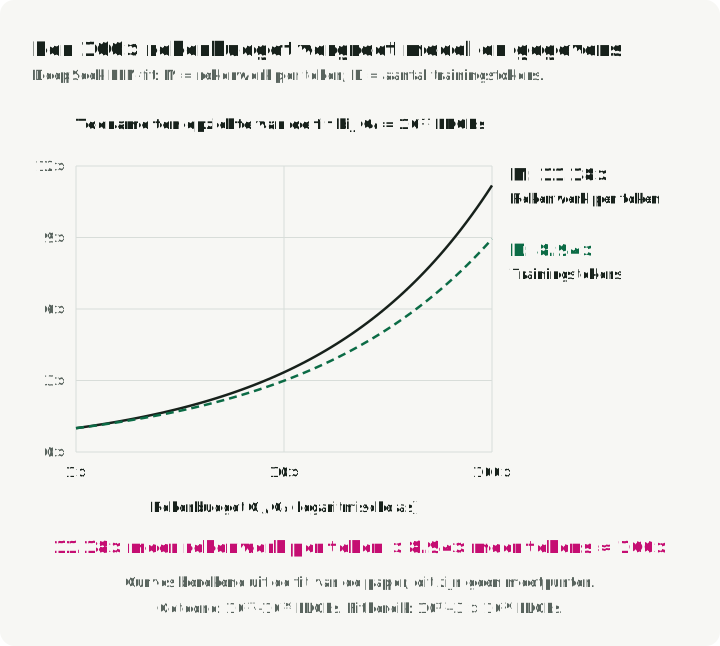
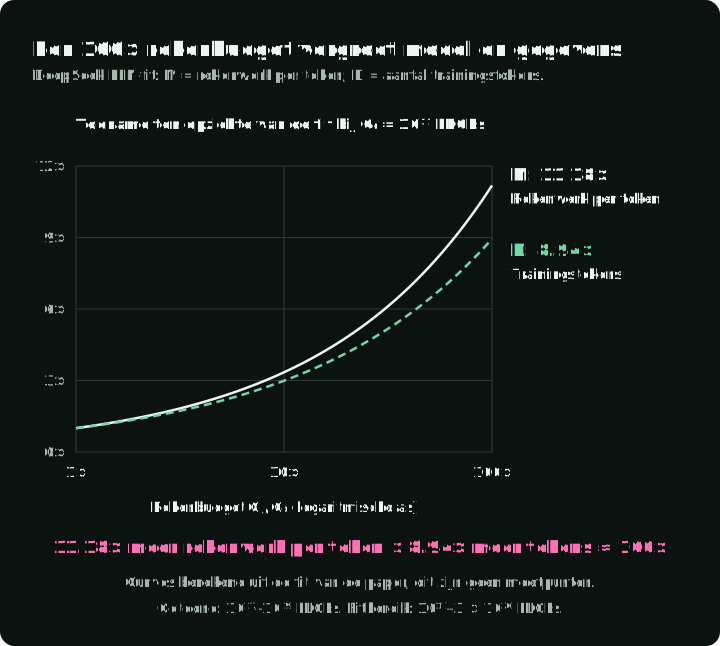
Die conclusie hoort bij deze experimenten. De fit bestrijkt tot FLOPs. Daarbuiten is het een extrapolatie; ook daarbinnen kunnen andere gegevens of trainingsinstellingen de beste verdeling veranderen. Sectie 3.3 rapporteert verschillende exponenten voor verschillende datasets. De uitgebreide uitwerking van schaalwetten legt de eenheden uit en controleert hoe de gefitte formules samengaan.
Een vergelijking lezen die deze reeks niet behandelt
Gebruik voor een andere vergelijking de zes vragen uit deel 1: identificeer de objecten, bewerkingen, dimensies, steekproeven, geleerde grootheden en de gedane uitspraak.
De repository paper-math-skills biedt agentinstructies om een uitgebreide uitwerking te schrijven en te controleren. De gekoppelde uitwerkingen zijn voorbeelden van die uitvoer, met symbooldefinities en numerieke controles.
Bronnen en versies
Zie voor een langere inleiding tot de grondslagen The Little Book of Generative AI Foundations van Tianhua Chen, §3.2 voor de ELBO.