Ler a ELBO, a perda de difusão, pass@k e leis de escala

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Esta parte explica o que dois modelos generativos aprendem e o que quatro medidas comuns nos dizem. Destina-se a engenheiros que querem compreender a ELBO e a perda de difusão ou comparar artigos que apresentam pass@k, perplexidade, complexidade computacional e leis de escala. Os diagramas mostram os cálculos; as equações identificam exatamente o que é otimizado ou contado.
As secções sobre modelos generativos desenvolvem-se em sequência. As secções sobre métricas podem ser lidas de forma independente. A Parte 1 fornece uma referência de notação, se precisar. Todos os logaritmos aqui são naturais.
Modelos generativos: a ELBO e a difusão
Um modelo de linguagem pode atribuir uma probabilidade a uma resposta fornecida, token a token. Outros modelos generativos introduzem variáveis ocultas: valores intermédios que ajudam a gerar dados, mas que não existem no dataset de treino. Calcular a probabilidade de uma imagem pode então exigir uma média sobre demasiados valores ocultos possíveis. Os dois métodos seguintes treinam sem calcular essa média exatamente.
ELBO: um limite inferior que pode calcular
Um autoencoder variacional (VAE) gera uma imagem a partir de um vetor latente : uma lista de números. Um exemplo simples de duas dimensões é . Estes números são entradas de uma rede neuronal, não instruções de uma linguagem de programação. O vetor é latente porque o dataset de treino contém imagens, mas não fornece os valores correspondentes.
Para gerar uma imagem no VAE padrão aqui descrito, extraia cada elemento de de forma independente de uma distribuição normal com média 0 e desvio-padrão 1. Extrair valores segundo uma distribuição chama-se amostragem. Esta distribuição fixa sobre vetores é a distribuição a priori, escrita .
O descodificador é uma rede neuronal treinada. Os seus pesos aprendidos transformam nos parâmetros de uma distribuição sobre valores de píxeis. Por exemplo, um descodificador para imagens de 28 por 28 cujos píxeis são 0 ou 1 pode produzir 784 probabilidades, uma por píxel. Cada probabilidade indica a possibilidade de o respetivo píxel ser 1. Amostrar esses valores de píxeis produz uma imagem. Os elementos do vetor determinam as probabilidades dos píxeis através da rede treinada; não são píxeis. Kingma e Welling, §3 e Apêndice C, descrevem esta configuração padrão.
Durante o treino, uma imagem vem do dataset. Um codificador, outra rede neuronal, recebe esta imagem como entrada. Na configuração gaussiana usada aqui, prevê uma média e um desvio-padrão para cada elemento de . Em conjunto, definem , uma distribuição sobre vetores latentes para esta imagem. Amostramos dessa distribuição em vez da distribuição a priori. O descodificador atribui depois a probabilidade à imagem original usando o vetor amostrado.
O treino recompensa o descodificador por atribuir um logaritmo de probabilidade alto à imagem observada. Também subtrai a divergência KL: uma medida não negativa da diferença entre a distribuição de vetores do codificador e a distribuição a priori fixa. O diagrama mostra os dois termos e a origem diferente dos vetores durante a geração.
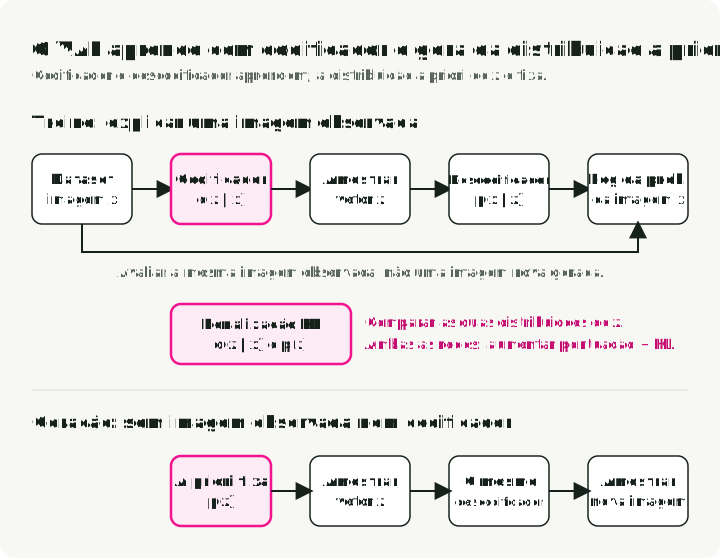
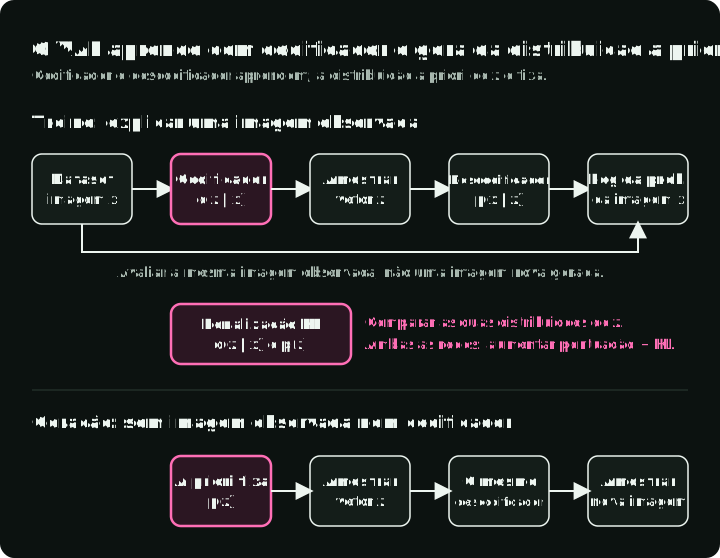
A pontuação de treino tem dois termos:
O primeiro termo calcula a média do logaritmo da probabilidade da imagem nos vetores amostrados do codificador. O segundo é a penalização KL. Os símbolos e representam os parâmetros aprendidos do codificador e do descodificador. As duas redes aprendem a aumentar esta pontuação; uma implementação que minimiza uma perda usa o seu negativo.
Este é o limite inferior da log-evidência, ou ELBO. A evidência é a probabilidade da imagem observada segundo o modelo, calculada pela média sobre todos os vetores latentes possíveis. Kingma e Welling, §2.2, equações (1)–(3), relacionam-na com a pontuação de treino:
Aqui, é a verdadeira distribuição a posteriori: a distribuição do modelo sobre vetores latentes dada esta imagem. O termo KL não negativo é a diferença entre a log-evidência e a ELBO; vale zero quando o codificador reproduz essa distribuição a posteriori. Esta identidade explica o limite. A penalização de treino calculável do diagrama compara antes o codificador com a distribuição a priori conhecida , pelo que um passo de treino não exige a distribuição a posteriori desconhecida.
Uma ELBO mais alta, por si só, não prova que o descodificador melhorou. Um codificador melhor pode tornar o limite mais preciso sem alterar o descodificador. Além disso, o limite aplica-se à esperança exata: uma estimativa com poucos vetores amostrados pode exceder a log-evidência numa amostragem individual. A análise detalhada da ELBO deriva o limite e verifica-o com um exemplo resolvido.
DDPM: prever o ruído que foi adicionado
O DDPM usa versões ruidosas de uma imagem como variáveis ocultas. Durante o treino, obtém uma imagem limpa do dataset e amostra ruído aleatório: um número de uma normal padrão para cada coordenada da imagem. Escolhe aleatoriamente um passo de um esquema de ruído fixo, que define as proporções de imagem e ruído a misturar. A rede recebe esta imagem corrompida e ; a sua tarefa é prever a amostra de ruído que acabámos de adicionar.
A geração usa a rede treinada repetidamente. Começa com ruído aleatório, prevê o ruído no nível atual e usa essa previsão para dar um pequeno passo de remoção de ruído. Os pesos mantêm-se fixos durante este processo. O treino tem, assim, um alvo conhecido que fornece o erro usado para atualizar a rede; a geração usa a rede aprendida para produzir uma imagem em muitos passos.
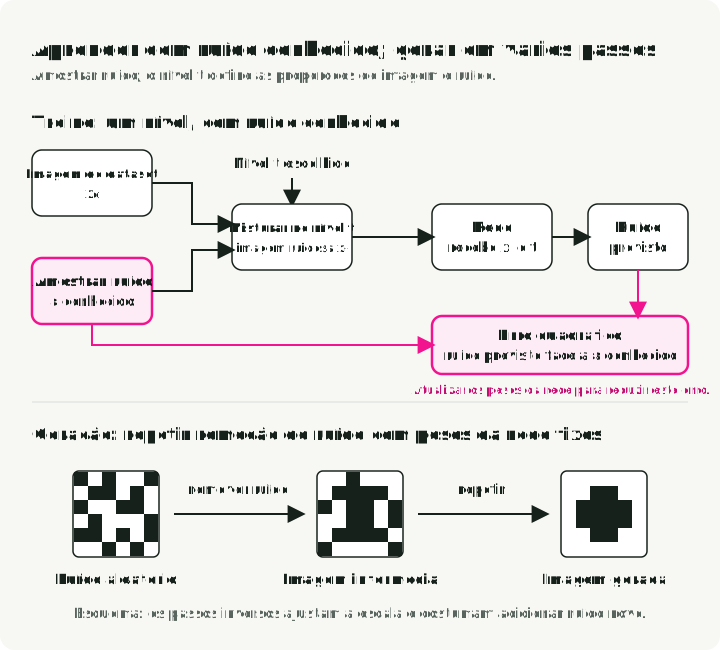
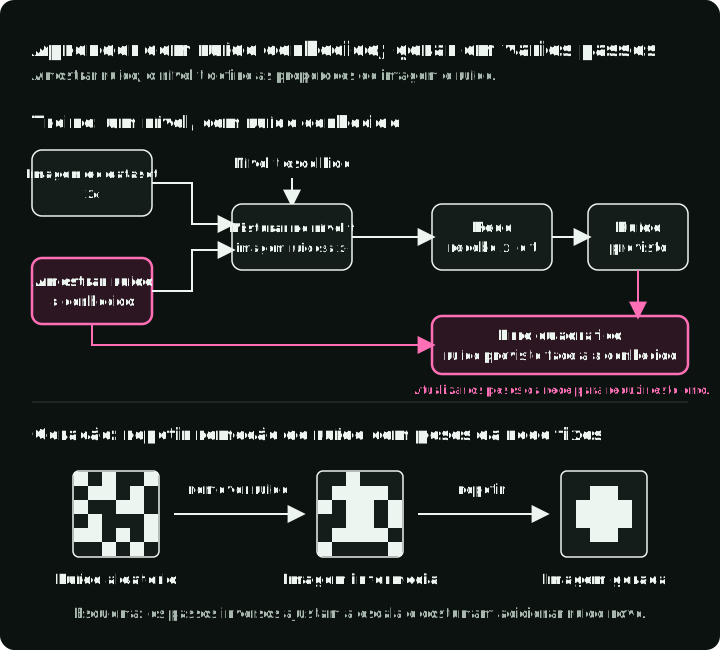
Escrever a entrada ruidosa como torna a perda mais fácil de ler:
é uma imagem de treino limpa, é um passo escolhido aleatoriamente e é uma nova amostra de ruído de uma normal padrão. A rede , com parâmetros aprendidos , prevê essa amostra. O quadrado da norma soma os quadrados dos erros de previsão nas coordenadas da imagem; a esperança calcula a média sobre imagens, passos e amostras de ruído.
O esquema fixo define e , onde é a variância do ruído adicionado no passo . A barra representa este produto, não uma média. Define os dois coeficientes da mistura no diagrama: para a imagem e para o ruído. Perto de 1 significa sobretudo imagem; perto de 0 significa sobretudo ruído.
O treino pode construir diretamente; não precisa de executar todos os passos de ruído anteriores. O DDPM original usa 1000 níveis e amostra uniformemente os passos de treino. Veja a equação (4), a equação (14) e o Algoritmo 1 ou a análise detalhada do DDPM.
O artigo deriva um limite variacional relacionado com a ELBO e altera depois os pesos dos seus termos para obter esta perda prática. A perda simplificada não é, em si, o limite de verosimilhança original. Durante a geração, o Algoritmo 2 ajusta a escala da imagem atual, subtrai um múltiplo do ruído previsto e, exceto no último passo, adiciona ruído novo. Não se limita a subtrair a previsão uma vez para recuperar uma imagem limpa.
Métricas e afirmações sobre custos
Um objetivo de treino, uma pontuação de avaliação e uma estimativa de custo respondem a perguntas diferentes. As próximas secções mostram o que cada número apresentado conta e o que tem de se manter fixo para uma comparação ser útil.
Pass@k: a probabilidade de pelo menos uma de k amostras passar
pass@k pergunta se pelo menos um de programas gerados passa os testes. Permite várias tentativas; não significa que a primeira resposta do modelo esteja correta.
O artigo do Codex amostra programas de forma independente para cada problema e conta os que passam. Considera depois todos os conjuntos possíveis de amostras. Subtraia de um a fração de conjuntos que contêm apenas falhas:
A notação conta as formas de escolher elementos entre sem reposição. Esta é a estimativa para um problema; a pontuação apresentada calcula a sua média nos vários problemas. Com cinco amostras, duas aprovadas e três reprovadas, há dez pares. Só três pares contêm duas falhas, pelo que a estimativa de pass@2 é .
A grelha mostra esses dez pares neste exemplo hipotético. Os cinco programas respondem ao mesmo problema e são executados com os mesmos testes. Um par tem sucesso assim que um dos seus dois programas passa.
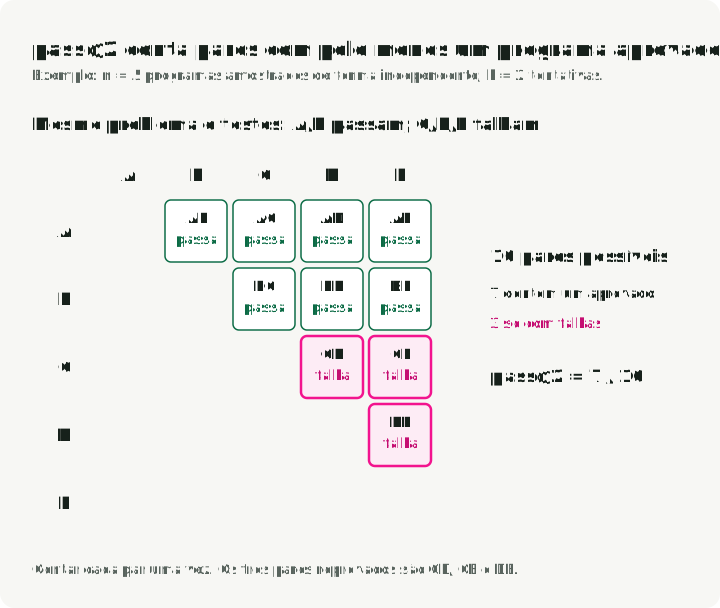
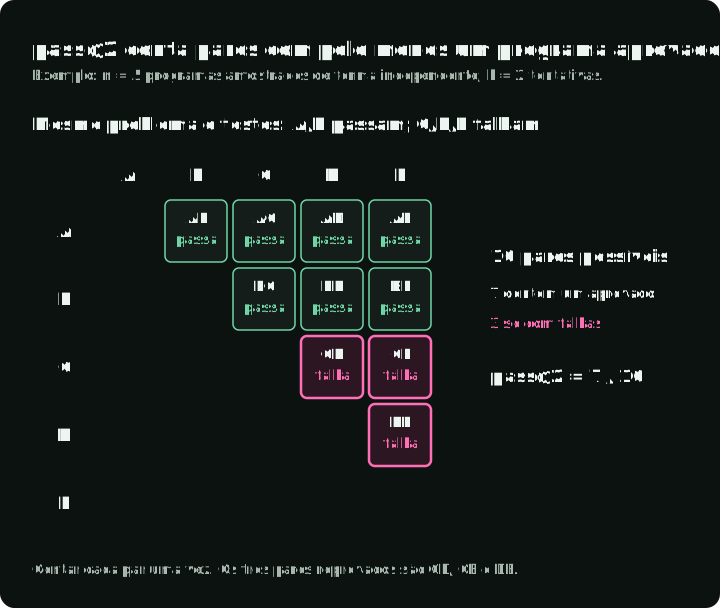
Use este estimador com contagens inteiras e . Se menos de amostras falham, cada conjunto contém uma amostra aprovada e a estimativa é 1. O atalho tentador é enviesado; dá 0,64 neste exemplo. O artigo do Codex, §2.1 e Figura 3, fornece o estimador e uma implementação numericamente estável; a análise detalhada explica por que funciona.
Compare o mesmo , problemas, testes, prompts e configurações de geração. Passar os testes não estabelece correção para todas as entradas. Um sistema em produção também precisa de uma forma de selecionar um candidato aprovado, como executar esses testes; gerar várias respostas, por si só, não identifica a boa.
Perplexidade: o número efetivo de escolhas por token
A perplexidade avalia as probabilidades que um modelo de linguagem atribui aos tokens seguintes reais de um texto fornecido. Em cada posição, dê ao modelo o texto anterior, obtenha as suas probabilidades para os tokens seguintes possíveis e leia a probabilidade do token que realmente se segue. Não é necessária uma resposta gerada. A pontuação converte o logaritmo negativo médio da probabilidade numa escala mais interpretável:
é o número de tokens, é o token observado e é o contexto que o precede. Se o modelo atribui a cada token observado probabilidade , a perplexidade é 4. Se as probabilidades diferem, a pontuação usa a sua média geométrica. As probabilidades 0,5, 0,2 e 0,1 dão perplexidade de cerca de 4,64: a mesma pontuação que atribuir a cada token probabilidade .
Os gráficos usam probabilidades inventadas para três posições sucessivas. Cada barra vem de uma previsão diferente do token seguinte, pelo que as barras não precisam de somar 1. O gráfico da direita substitui-as por um valor constante; os produtos coincidem, logo as perplexidades também.
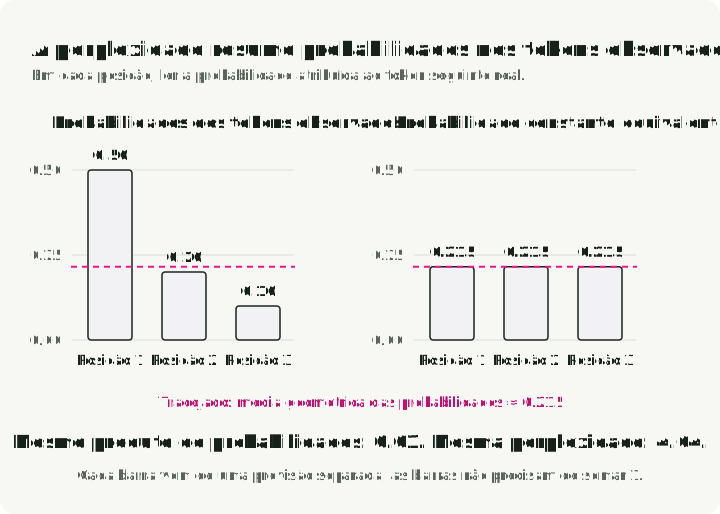
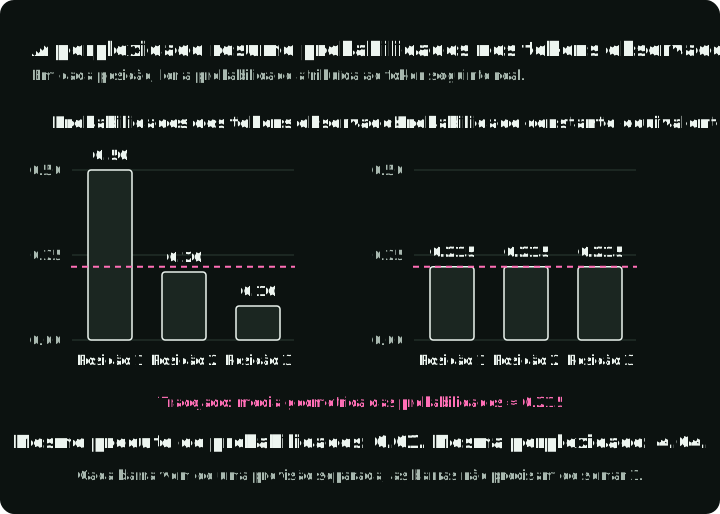
Um valor menor é melhor para o mesmo texto de avaliação, tokenizador e procedimento de contexto. Significa que o modelo atribuiu maior probabilidade ao texto observado, não que as respostas que gera sejam mais úteis ou corretas. Os tokenizadores dividem o texto de formas diferentes, e o tratamento da janela de contexto altera as probabilidades. O guia de perplexidade da Hugging Face explica estas condições de comparação.
Big-O: como o custo cresce com o comprimento da sequência
A autoatenção transforma o vetor atual de cada token numa consulta, numa chave e num valor usando matrizes aprendidas. Uma comparação consulta–chave avalia com que intensidade uma posição deve usar outra. Estas pontuações tornam-se pesos para combinar os valores, como na definição de atenção do Transformer, §3.2.
Para uma cabeça de atenção e tokens, comparar cada consulta com cada chave produz uma tabela de pontuações . Duplicar o comprimento da sequência torna essa tabela quatro vezes maior. Se cada comparação é um produto interno de comprimento , a aritmética das pontuações cresce como . Big-O descreve um limite superior assintótico; omite constantes e, por si só, não prevê o tempo de execução.
As grelhas mostram atenção completa: cada posição pode usar todas as posições. Uma sequência mais longa acrescenta tanto linhas de consultas como colunas de chaves. Cada célula é uma pontuação; implementações como FlashAttention podem calcular as pontuações sem guardar toda a grelha de uma vez. A atenção causal exclui posições futuras, mas o número de pares permitidos continua a crescer quadraticamente.
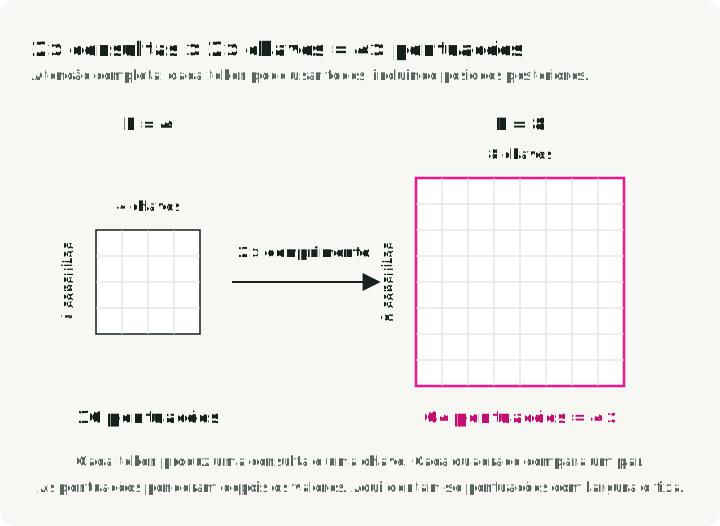
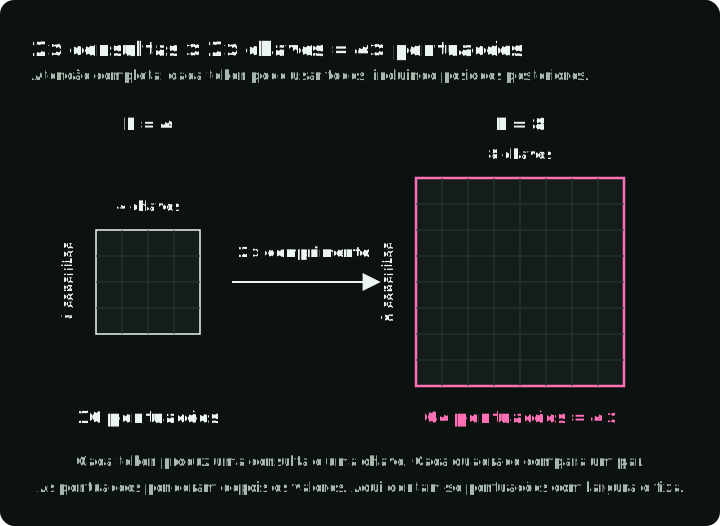
Diferentes alterações à atenção reduzem custos diferentes:
| Método | O que muda | O que continua a crescer com a sequência |
|---|---|---|
| FlashAttention | Calcula a atenção em blocos, evitando uma tabela completa de pontuações na memória principal da GPU | A aritmética das pontuações continua quadrática |
| DSA | Um avaliador mais barato seleciona até tokens para atenção completa | O avaliador continua a comparar todos os pares elegíveis |
| MLA | Guarda menos dados de atenção por token em cache | O tamanho da cache continua a crescer linearmente com o número de tokens |
Estas poupanças não podem ser lidas como acelerações equivalentes. Verifique se um artigo mediu aritmética, memória atribuída, transferências de memória ou tamanho da cache. Verifique também se mediu o processamento do prompt ou a geração de tokens; o DeepSeek-V3.2, Figura 3, apresenta essas fases separadamente.
Leis de escala: curvas ajustadas com um intervalo válido
Uma lei de escala ajuda a repartir um orçamento de treino entre um modelo maior e mais dados. É uma curva ajustada a experiências. Por exemplo, o DeepSeek LLM, §3.2, equação (4), apresenta:
é a computação de treino em operações de vírgula flutuante. é a computação por token sem os embeddings, usada aqui como medida do tamanho do modelo; não é o número de parâmetros. é o número de tokens de treino. O índice «opt» marca a repartição ajustada para minimizar a perda de validação com esse orçamento. Os coeficientes 0,1715 e 5,8316 pertencem a este ajuste e a estas unidades.
As curvas abaixo dividem as repartições ajustadas pelos seus valores num orçamento de FLOPs, pelo que cada coeficiente ajustado se cancela. Um aumento de orçamento de 100 vezes dá vezes a computação por token e vezes os tokens. Estes são os dois extremos da figura. Os fatores multiplicam-se porque o artigo define a computação total como .
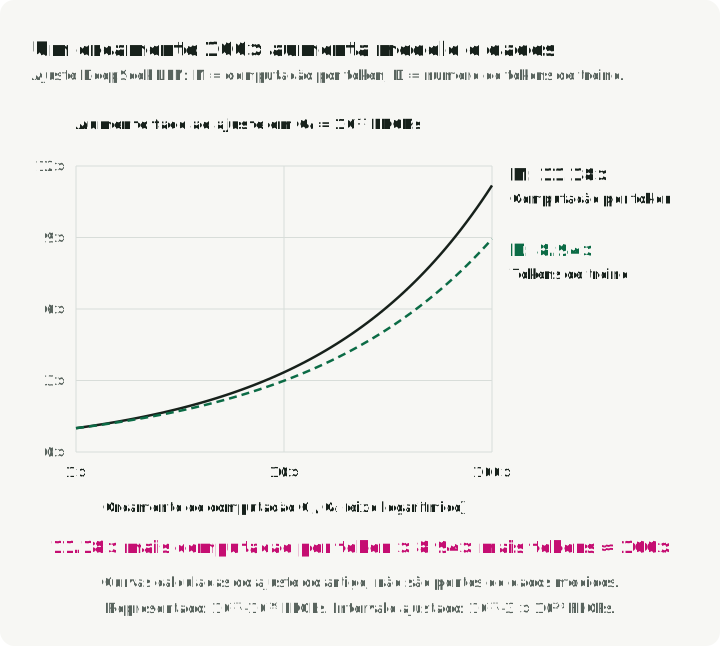
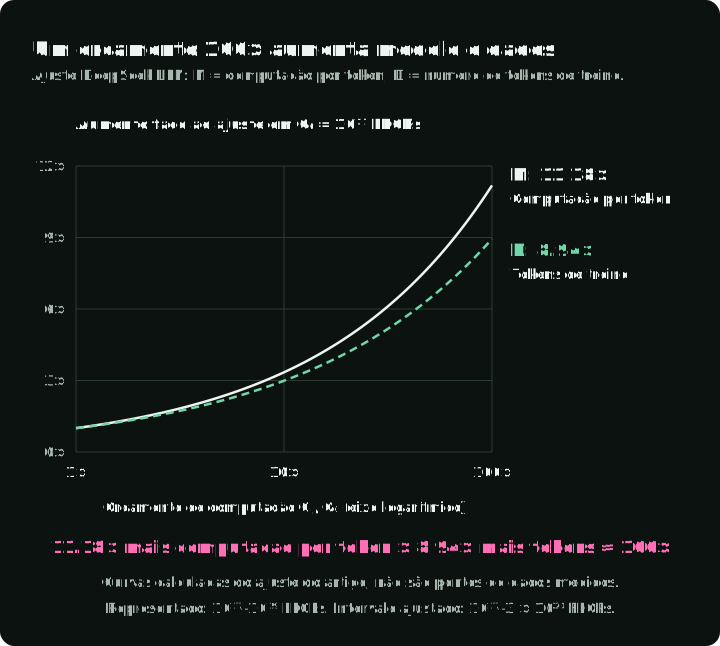
Esta conclusão pertence a estas experiências. O ajuste abrange de a FLOPs. Fora desse intervalo, é uma extrapolação; mesmo dentro dele, dados ou configurações de treino diferentes podem mudar a melhor repartição. A secção 3.3 apresenta expoentes diferentes para datasets diferentes. A análise detalhada das leis de escala explica as unidades e verifica como se combinam as fórmulas ajustadas.
Ler uma equação que esta série não aborda
Para outra equação, use as seis perguntas da Parte 1: identifique os objetos, as operações, as dimensões, a amostragem, as grandezas aprendidas e a afirmação feita.
O repositório paper-math-skills fornece instruções para agentes escreverem e verificarem uma análise detalhada. As análises indicadas são exemplos desse resultado, com definições dos símbolos e verificações numéricas.
Fontes e versões
Para uma introdução mais extensa aos fundamentos, veja The Little Book of Generative AI Foundations, de Tianhua Chen, §3.2 para a ELBO.