Как читать ELBO, потерю диффузии, pass@k и законы масштабирования

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Эта часть объясняет, чему учатся две генеративные модели и что показывают четыре распространённые меры. Она предназначена для инженеров, которые хотят понять ELBO и потерю диффузии или сравнить статьи, где приводят pass@k, перплексию, вычислительную сложность и законы масштабирования. Схемы показывают вычисления; уравнения точно определяют, что оптимизируется или подсчитывается.
Разделы о генеративных моделях последовательно дополняют друг друга. Разделы о метриках можно читать независимо. В части 1 есть справочник обозначений, если он нужен. Все логарифмы здесь натуральные.
Генеративные модели: ELBO и диффузия
Языковая модель может присвоить вероятность заданному ответу токен за токеном. Другие генеративные модели вводят скрытые переменные: промежуточные значения, которые помогают генерировать данные, но отсутствуют в обучающем датасете. Вычисление вероятности изображения тогда может требовать усреднения по слишком большому числу возможных скрытых значений. Следующие два метода обучаются без точного вычисления этого среднего.
ELBO: нижняя граница, которую можно вычислить
Вариационный автоэнкодер (VAE) генерирует изображение из латентного вектора — списка чисел. Пример двумерного вектора: . Эти числа подаются на вход нейросети и не являются инструкциями на языке программирования. Вектор называют латентным, потому что обучающий датасет содержит изображения, но не содержит соответствующих им значений .
Для генерации изображения в рассмотренном здесь стандартном VAE каждую компоненту независимо сэмплируют из нормального распределения со средним 0 и стандартным отклонением 1. Выбор значений согласно распределению называется сэмплированием. Это фиксированное распределение векторов называется априорным и обозначается .
Декодер — обученная нейросеть. Её обученные веса преобразуют в параметры распределения значений пикселей. Например, декодер изображений 28 на 28 пикселей со значениями 0 или 1 может выдать 784 вероятности, по одной на пиксель. Каждая вероятность задаёт шанс, что соответствующий пиксель равен 1. Сэмплирование этих значений пикселей создаёт изображение. Компоненты вектора определяют вероятности пикселей через обученную сеть; сами они не являются пикселями. Кингма и Веллинг, §3 и приложение C, описывают эту стандартную конфигурацию.
При обучении изображение берётся из датасета. Энкодер, другая нейросеть, получает это изображение на вход. В используемой здесь гауссовской конфигурации он предсказывает среднее и стандартное отклонение для каждой компоненты . Вместе они задают — распределение латентных векторов для этого изображения. Мы сэмплируем из этого распределения, а не из априорного. Затем декодер присваивает исходному изображению вероятность с помощью сэмплированного вектора.
Обучение поощряет декодер за высокий логарифм вероятности наблюдаемого изображения. Оно также вычитает KL-дивергенцию: неотрицательную меру отличия распределения векторов энкодера от фиксированного априорного распределения. Схема показывает оба члена и другой источник векторов при генерации.
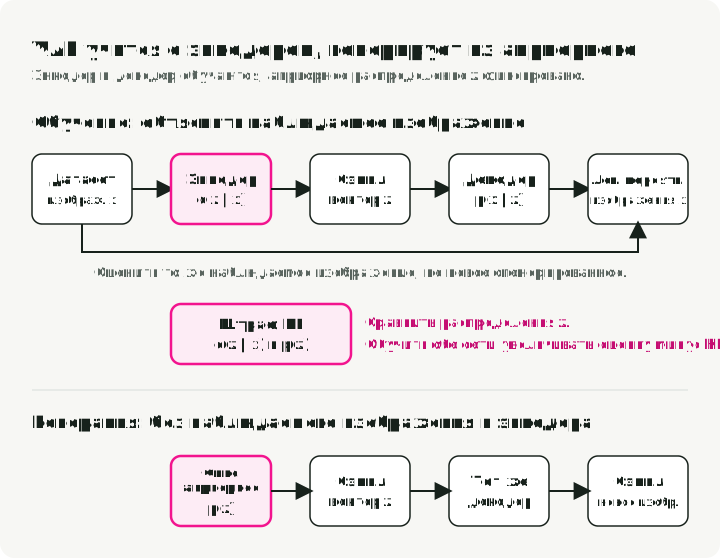
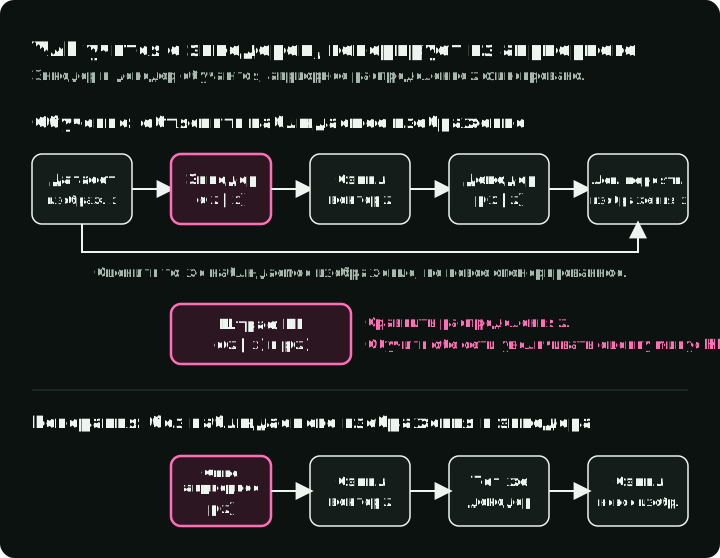
Обучающая оценка состоит из двух членов:
Первый член усредняет логарифм вероятности изображения по векторам, сэмплированным из энкодера. Второй — штраф KL. Символы и обозначают обучаемые параметры энкодера и декодера. Обе сети учатся увеличивать эту оценку; код, минимизирующий потерю, использует её со знаком минус.
Это нижняя граница логарифма правдоподобия, или ELBO. Маргинальное правдоподобие — вероятность наблюдаемого изображения по модели, усреднённая по всем возможным латентным векторам. Кингма и Веллинг, §2.2, уравнения (1)–(3), связывают его с обучающей оценкой:
Здесь — истинное апостериорное распределение: распределение латентных векторов модели при данном изображении. Неотрицательный член KL — разность между логарифмом маргинального правдоподобия и ELBO; она равна нулю, когда энкодер воспроизводит это апостериорное распределение. Это тождество объясняет границу. Вычислимый обучающий штраф на схеме вместо этого сравнивает энкодер с известным априорным распределением , поэтому шагу обучения не нужно неизвестное апостериорное распределение.
Более высокая ELBO сама по себе не доказывает, что декодер улучшился. Более точный энкодер может приблизить границу к истинному значению, не меняя декодер. Кроме того, граница относится к точному математическому ожиданию: оценка по нескольким сэмплированным векторам при отдельном сэмплировании может превысить логарифм маргинального правдоподобия. Подробный разбор ELBO выводит границу и проверяет её на подробном примере.
DDPM: предсказать добавленный шум
DDPM использует зашумлённые версии изображения как скрытые переменные. При обучении берёт чистое изображение из датасета и сэмплирует случайный шум: одно стандартно нормально распределённое число для каждой координаты изображения. Случайно выбирает шаг из фиксированного расписания шума, которое задаёт пропорции смешивания изображения и шума. Сеть видит это искажённое изображение и ; её задача — предсказать только что добавленный сэмпл шума.
Генерация многократно использует обученную сеть. Она начинает со случайного шума, предсказывает шум на текущем уровне и использует предсказание для небольшого шага удаления шума. Веса во время этого процесса фиксированы. У обучения, таким образом, есть известная цель, которая задаёт ошибку для обновления сети; генерация использует обученную сеть для создания изображения за много шагов.
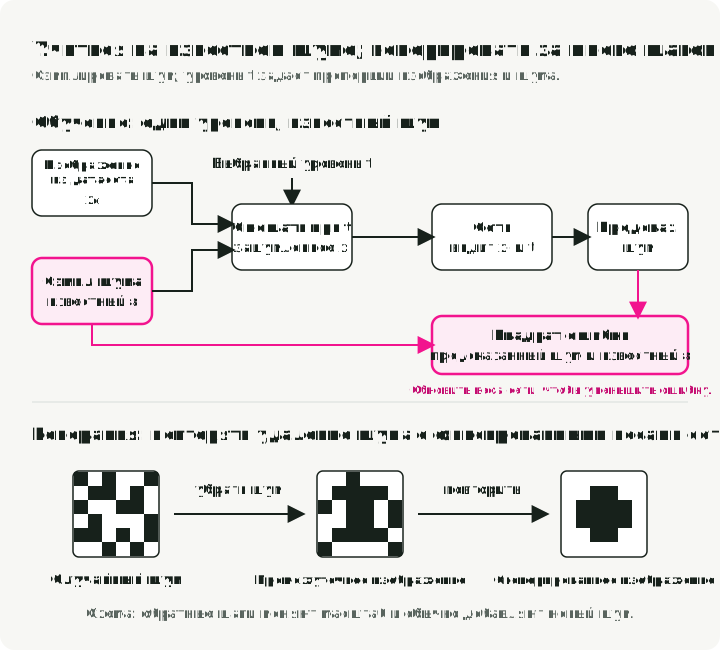
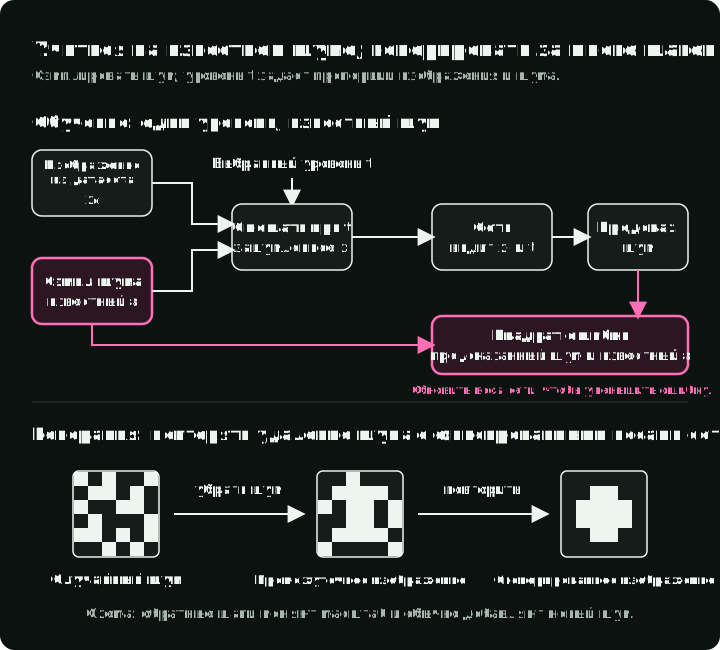
Обозначим зашумлённый вход через , чтобы было проще читать потерю:
— чистое обучающее изображение, — случайно выбранный шаг, а — новый сэмпл стандартного нормального шума. Сеть с обучаемыми параметрами предсказывает этот сэмпл. Квадрат нормы суммирует квадраты ошибок предсказания по координатам изображения; математическое ожидание усредняет по изображениям, шагам и сэмплам шума.
Фиксированное расписание задаёт и , где — дисперсия шума, добавленного на шаге . Черта обозначает это произведение, а не среднее. Оно задаёт два коэффициента смеси на схеме: для изображения и для шума. Значение около 1 означает в основном изображение; около 0 — в основном шум.
Обучение может построить напрямую; выполнять все предыдущие шаги добавления шума не нужно. Исходный DDPM использует 1000 уровней и равномерно сэмплирует шаги обучения. См. уравнение (4), уравнение (14) и алгоритм 1 или подробный разбор DDPM.
Статья выводит вариационную границу, связанную с ELBO, а затем меняет веса её членов, чтобы получить эту практическую потерю. Упрощённая потеря сама по себе не является исходной границей правдоподобия. При генерации алгоритм 2 меняет масштаб текущего изображения, вычитает кратное предсказанного шума и, кроме последнего шага, добавляет новый шум. Он не просто один раз вычитает предсказание, чтобы восстановить чистое изображение.
Метрики и утверждения о затратах
Целевая функция обучения, оценочная метрика и оценка затрат отвечают на разные вопросы. Следующие разделы показывают, что подсчитывает каждое опубликованное число и что должно оставаться фиксированным для полезного сравнения.
Pass@k: вероятность, что хотя бы один из k сэмплов пройдёт тесты
pass@k показывает, проходит ли тесты хотя бы одна из сгенерированных программ. Он допускает несколько попыток; это не означает, что первый ответ модели верен.
Статья о Codex независимо сэмплирует программ для каждой задачи и подсчитывает прошедших тесты. Затем рассматривает все возможные наборы из сэмплов. Вычтите из единицы долю наборов, содержащих только неудачи:
Обозначение подсчитывает способы выбрать элементов из без возвращения. Это оценка для одной задачи; опубликованная метрика усредняет её по задачам. Для пяти сэмплов, двух прошедших и трёх не прошедших тесты, есть десять пар. Только три пары содержат две неудачи, поэтому оценка pass@2 равна .
Сетка показывает эти десять пар в условном примере. Все пять программ решают одну задачу и запускаются на одних тестах. Пара успешна, если хотя бы одна из двух программ проходит тесты.
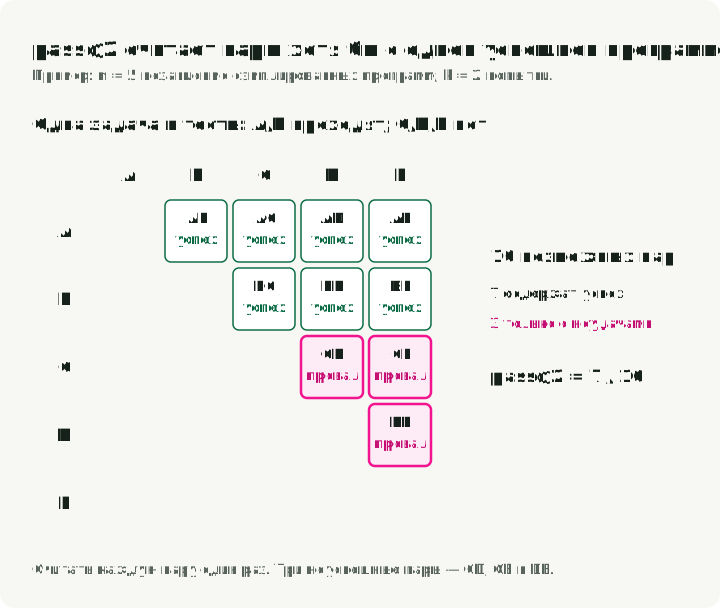
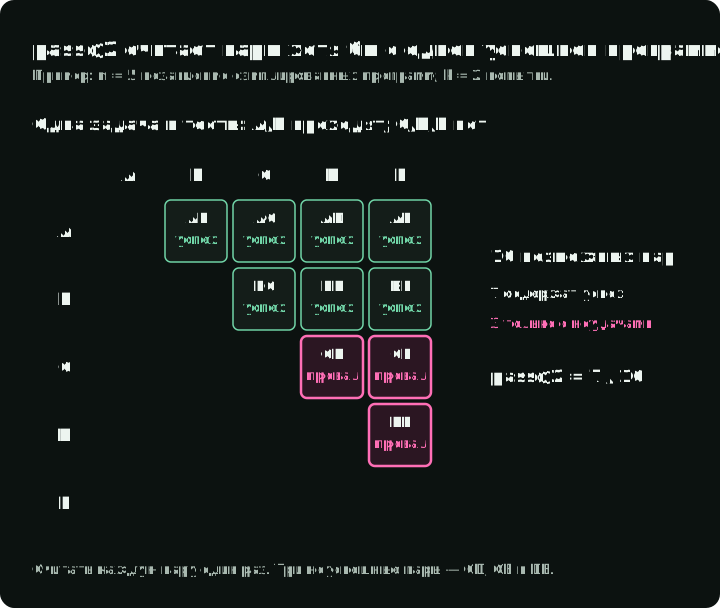
Используйте этот оцениватель с целыми числами и . Если неудачных сэмплов меньше , каждый набор содержит успешный сэмпл и оценка равна 1. Соблазнительное упрощение смещено; в этом примере даёт 0,64. Статья о Codex, §2.1 и рисунок 3, приводит оцениватель и численно устойчивую реализацию; подробный разбор объясняет, почему он работает.
Сравнивайте одинаковые , задачи, тесты, промпты и настройки генерации. Прохождение тестов не устанавливает корректность на всех входах. Системе в эксплуатации также нужен способ выбрать успешного кандидата, например запустить эти тесты; сама генерация нескольких ответов не указывает, какой из них хорош.
Перплексия: эффективное число вариантов на токен
Перплексия оценивает вероятности, которые языковая модель присваивает фактическим следующим токенам заданного текста. В каждой позиции дайте модели предыдущий текст, получите вероятности возможных следующих токенов и прочитайте вероятность токена, который действительно идёт следующим. Генерировать ответ не нужно. Оценка переводит средний отрицательный логарифм вероятности в более понятную шкалу:
— число токенов, — наблюдаемый токен, а — предшествующий ему контекст. Если модель присваивает каждому наблюдаемому токену вероятность , перплексия равна 4. Если вероятности различаются, оценка использует их среднее геометрическое. Вероятности 0,5, 0,2 и 0,1 дают перплексию около 4,64: такую же оценку, как вероятность для каждого токена.
Графики используют заданные для примера вероятности для трёх последовательных позиций. Каждый столбец относится к отдельному предсказанию следующего токена, поэтому их сумма не обязана равняться 1. Правый график заменяет их одним постоянным значением; произведения совпадают, поэтому совпадают и перплексии.
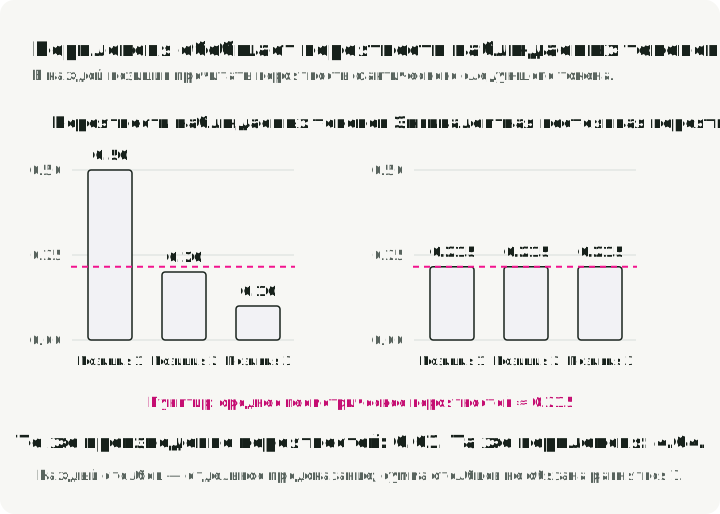
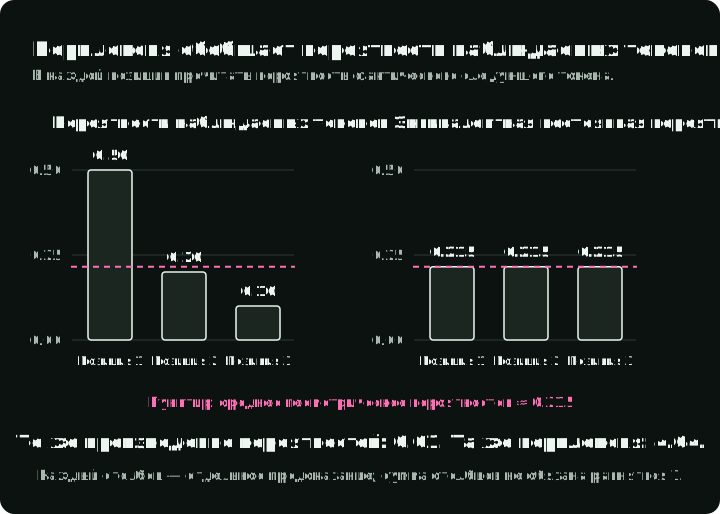
Меньше — лучше при одинаковых тексте оценки, токенизаторе и способе работы с контекстом. Это означает, что модель присвоила наблюдаемому тексту более высокую вероятность, а не что её сгенерированные ответы полезнее или корректнее. Токенизаторы по-разному разбивают текст, а обработка контекстного окна меняет вероятности. Руководство Hugging Face по перплексии объясняет эти условия сравнения.
Big-O: как затраты растут с длиной последовательности
Self-attention преобразует текущий вектор каждого токена в запрос, ключ и значение с помощью обученных матриц. Сравнение запроса с ключом оценивает, насколько сильно одна позиция должна использовать другую. Эти оценки становятся весами для объединения значений, как в определении аттеншна Transformer, §3.2.
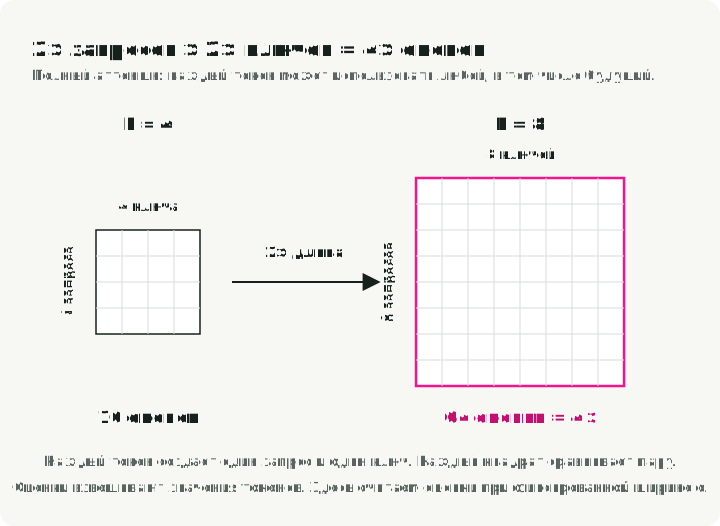
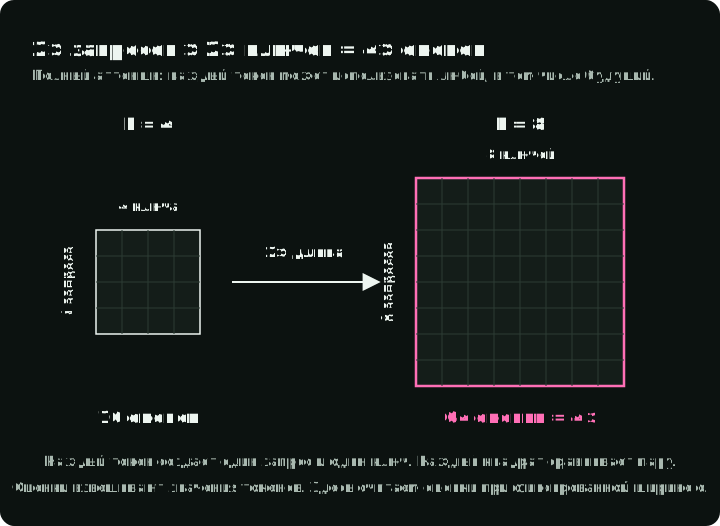
Для одной attention head и токенов сравнение каждого запроса с каждым ключом создаёт таблицу оценок . Удвоение длины последовательности увеличивает таблицу в четыре раза. Если каждое сравнение — скалярное произведение длины , число арифметических операций для оценок растёт как . Big-O описывает асимптотическую верхнюю границу; опускает константы и само по себе не предсказывает время выполнения.
Сетки показывают полный аттеншн: каждая позиция может использовать каждую. Более длинная последовательность добавляет и строки запросов, и столбцы ключей. Каждая ячейка — одна оценка; реализации вроде FlashAttention могут вычислять оценки, не сохраняя всю сетку сразу. Причинный аттеншн исключает будущие позиции, но число допустимых пар всё равно растёт квадратично.
Разные изменения аттеншна сокращают разные затраты:
| Метод | Что меняется | Что по-прежнему растёт с последовательностью |
|---|---|---|
| FlashAttention | Вычисляет аттеншн блоками, не сохраняя полную таблицу оценок в основной памяти GPU | Арифметика оценок остаётся квадратичной |
| DSA | Более дешёвый механизм оценки выбирает до токенов для полного аттеншна | Механизм оценки по-прежнему сравнивает все допустимые пары |
| MLA | Хранит меньше данных аттеншна на каждый закэшированный токен | Размер кэша по-прежнему растёт линейно с числом токенов |
Эту экономию нельзя читать как взаимозаменяемые ускорения. Проверьте, измеряла ли статья арифметику, выделенную память, передачи данных из памяти или размер кэша. Также проверьте, измеряла ли она обработку промпта или генерацию токенов; DeepSeek-V3.2, рисунок 3, приводит эти фазы отдельно.
Законы масштабирования: подобранные кривые с областью применимости
Закон масштабирования помогает распределить бюджет обучения между большей моделью и большим объёмом данных. Это кривая, подобранная по экспериментам. Например, DeepSeek LLM, §3.2, уравнение (4), приводит:
— вычислительные затраты обучения в операциях с плавающей точкой. — затраты на токен без учёта эмбеддингов, используемые здесь как мера размера модели; это не число параметров. — число обучающих токенов. Нижний индекс «opt» отмечает распределение, подобранное для минимизации потери на валидации при данном бюджете. Коэффициенты 0,1715 и 5,8316 относятся к этой аппроксимации и этим единицам.
Кривые ниже делят подобранные распределения ресурсов на их значения при бюджете FLOP, поэтому каждый подобранный коэффициент сокращается. Увеличение бюджета в 100 раз даёт рост затрат на токен в раза и числа токенов в раза. Это две конечные точки на рисунке. Их множители перемножаются, потому что статья определяет общие затраты как .
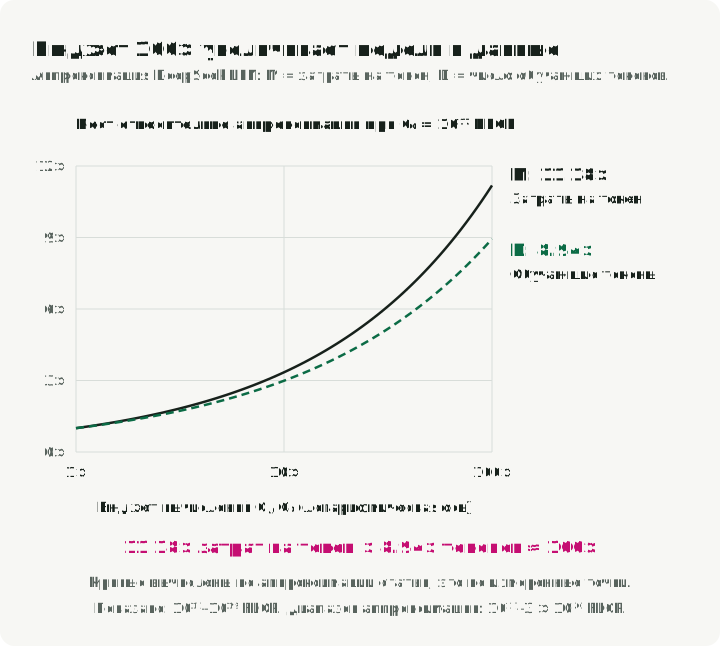
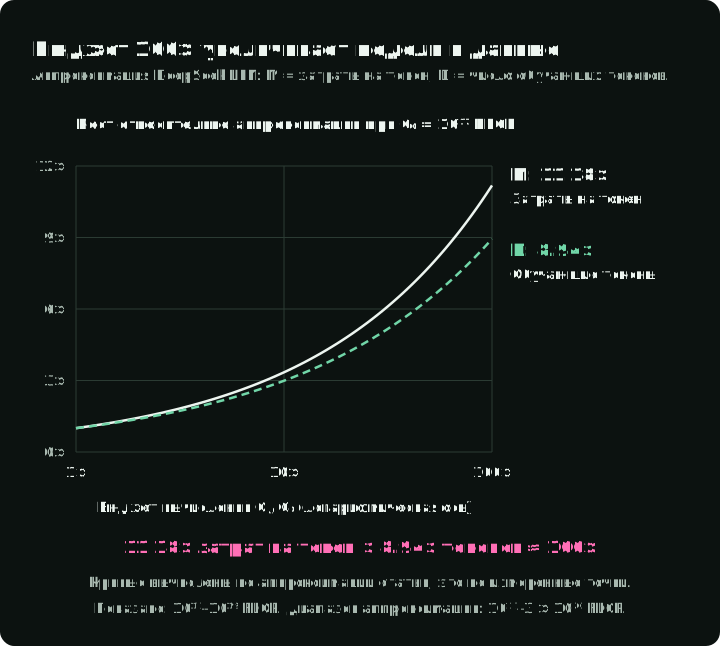
Этот вывод относится к этим экспериментам. Аппроксимация охватывает от до FLOP. За пределами диапазона это экстраполяция; даже внутри него другие данные или настройки обучения могут изменить лучшее распределение. Раздел 3.3 приводит разные показатели степени для разных датасетов. Подробный разбор законов масштабирования объясняет единицы и проверяет, как сочетаются подобранные формулы.
Как читать уравнение, которого нет в этой серии
Для другого уравнения используйте шесть вопросов из части 1: определите объекты, операции, размерности, сэмплирование, обучаемые величины и утверждение.
Репозиторий paper-math-skills даёт агентам инструкции для написания и проверки подробного разбора. Разборы по ссылке — примеры такого результата с определениями символов и численными проверками.
Источники и версии
Более подробное введение в основы см. в The Little Book of Generative AI Foundations Тяньхуа Чэня; §3.2 посвящён ELBO.