Jak czytać ELBO, stratę dyfuzji, pass@k i prawa skalowania

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ta część wyjaśnia, czego uczą się dwa modele generatywne i co mówią cztery popularne miary. Jest przeznaczona dla inżynierów, którzy chcą zrozumieć ELBO i stratę dyfuzji lub porównywać prace podające pass@k, perplexity, złożoność obliczeniową i prawa skalowania. Diagramy pokazują obliczenia; równania precyzują, co jest optymalizowane lub zliczane.
Sekcje o modelach generatywnych opierają się na sobie nawzajem. Sekcje o metrykach można czytać niezależnie. Część 1 zawiera zestawienie notacji, jeśli go potrzebujesz. Wszystkie logarytmy tutaj są naturalne.
Modele generatywne: ELBO i dyfuzja
Model językowy może przypisywać prawdopodobieństwo podanej odpowiedzi token po tokenie. Inne modele generatywne wprowadzają zmienne ukryte: wartości pośrednie, które pomagają generować dane, ale nie występują w zbiorze treningowym. Obliczenie prawdopodobieństwa obrazu może wtedy wymagać uśrednienia po zbyt wielu możliwych wartościach ukrytych. Następne dwie metody uczą się bez dokładnego obliczania tej średniej.
ELBO: dolne ograniczenie, które można obliczyć
Wariacyjny autoenkoder (VAE) generuje obraz z wektora ukrytego : listy liczb. Prosty przykład dwuwymiarowy to . Liczby te są wejściem do sieci neuronowej, a nie instrukcjami w języku programowania. Wektor jest ukryty, ponieważ zbiór treningowy zawiera obrazy, ale nie podaje odpowiadających im wartości .
Aby wygenerować obraz w opisanym tu standardowym VAE, losujemy każdy element niezależnie z rozkładu normalnego o średniej 0 i odchyleniu standardowym 1. Losowanie wartości zgodnie z rozkładem nazywa się próbkowaniem. Ten stały rozkład wektorów to rozkład a priori, zapisywany jako .
Dekoder jest wytrenowaną siecią neuronową. Jego wyuczone wagi przekształcają w parametry rozkładu wartości pikseli. Na przykład dekoder obrazów o wymiarach 28 na 28 pikseli, których wartości to 0 lub 1, może zwrócić 784 prawdopodobieństwa, po jednym na piksel. Każde oznacza prawdopodobieństwo, że dany piksel ma wartość 1. Wylosowanie tych wartości pikseli daje obraz. Elementy wektora określają prawdopodobieństwa pikseli za pośrednictwem wyuczonej sieci; same nie są pikselami. Kingma i Welling, §3 i dodatek C, opisują ten standardowy układ.
Podczas treningu obraz pochodzi ze zbioru danych. Enkoder, kolejna sieć neuronowa, otrzymuje ten obraz na wejściu. W użytym tu układzie gaussowskim przewiduje średnią i odchylenie standardowe dla każdego elementu . Razem określają one , rozkład wektorów ukrytych dla tego obrazu. Losujemy z tego rozkładu zamiast z rozkładu a priori. Dekoder przypisuje następnie oryginalnemu obrazowi prawdopodobieństwo przy użyciu wylosowanego wektora.
Trening nagradza dekoder za przypisanie obserwowanemu obrazowi wysokiego logarytmu prawdopodobieństwa. Odejmuje też dywergencję KL: nieujemną miarę różnicy między rozkładem wektorów enkodera a stałym rozkładem a priori. Diagram pokazuje oba składniki i inne źródło wektorów podczas generowania.
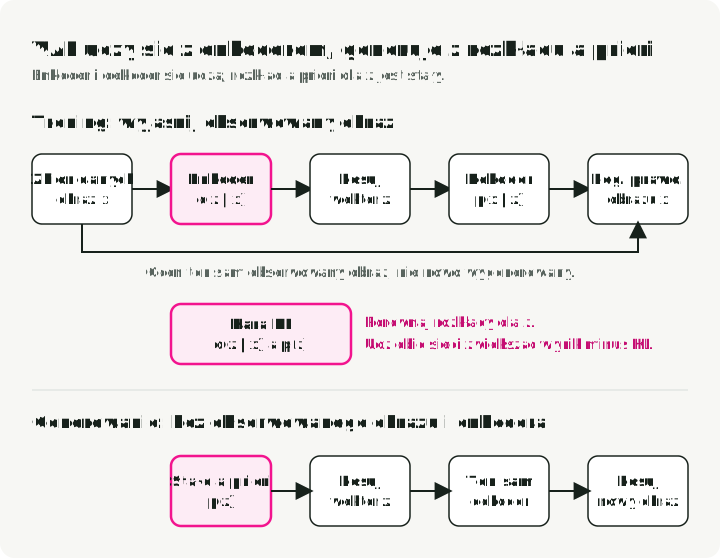
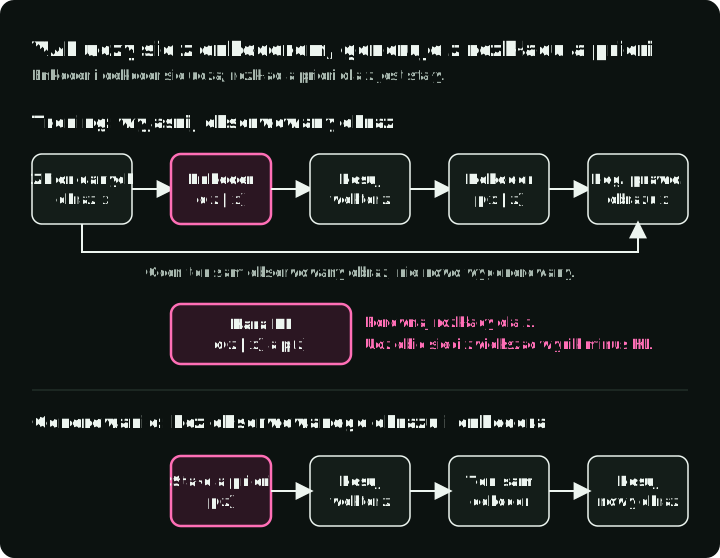
Wynik treningowy ma dwa składniki:
Pierwszy składnik uśrednia logarytm prawdopodobieństwa obrazu po wektorach wylosowanych z enkodera. Drugi to kara KL. Symbole i oznaczają wyuczone parametry enkodera i dekodera. Obie sieci uczą się zwiększać ten wynik; kod minimalizujący stratę używa jego wartości ze zmienionym znakiem.
To dolne ograniczenie logarytmu wiarygodności brzegowej, czyli ELBO. Wiarygodność brzegowa to prawdopodobieństwo obserwowanego obrazu według modelu, uśrednione po wszystkich możliwych wektorach ukrytych. Kingma i Welling, §2.2, równania (1)–(3), wiążą ją z wynikiem treningowym:
Tutaj to prawdziwy rozkład a posteriori: rozkład wektorów ukrytych modelu przy danym obrazie. Nieujemny składnik KL jest różnicą między logarytmem wiarygodności brzegowej a ELBO; wynosi zero, gdy enkoder odtwarza ten rozkład a posteriori. Ta tożsamość wyjaśnia ograniczenie. Obliczalna kara treningowa z diagramu porównuje natomiast enkoder ze znanym rozkładem a priori , więc krok treningu nie wymaga nieznanego rozkładu a posteriori.
Wyższe ELBO samo w sobie nie dowodzi, że dekoder się poprawił. Lepszy enkoder może przybliżyć ograniczenie do rzeczywistej wartości bez zmiany dekodera. Ponadto ograniczenie dotyczy dokładnej wartości oczekiwanej: estymata z kilku wylosowanych wektorów może w pojedynczym losowaniu przekroczyć logarytm wiarygodności brzegowej. Szczegółowe omówienie ELBO wyprowadza ograniczenie i sprawdza je na przykładzie obliczeniowym.
DDPM: przewiduj dodany szum
DDPM używa zaszumionych wersji obrazu jako zmiennych ukrytych. Podczas treningu bierze czysty obraz ze zbioru danych i losuje szum: jedną liczbę ze standardowego rozkładu normalnego dla każdej współrzędnej obrazu. Losowo wybiera krok z ustalonego harmonogramu szumu, który określa proporcje mieszania obrazu i szumu. Sieć widzi ten zniekształcony obraz i ; jej zadaniem jest przewidzenie właśnie dodanej próbki szumu.
Generowanie wielokrotnie używa wytrenowanej sieci. Zaczyna od losowego szumu, przewiduje szum na bieżącym poziomie i używa tej predykcji do wykonania małego kroku odszumiania. Wagi pozostają podczas tego procesu stałe. Trening ma więc znany cel, z którego wynika błąd służący do aktualizacji sieci; generowanie używa wyuczonej sieci do utworzenia obrazu w wielu krokach.
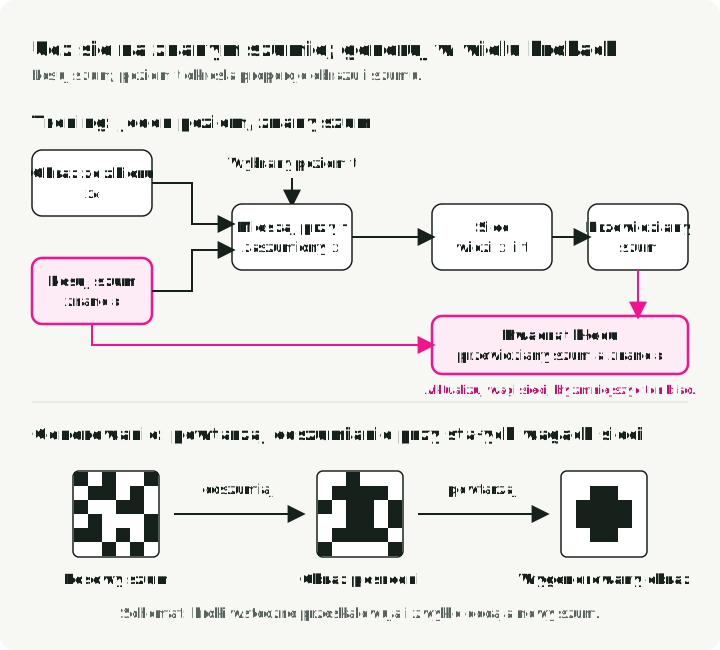
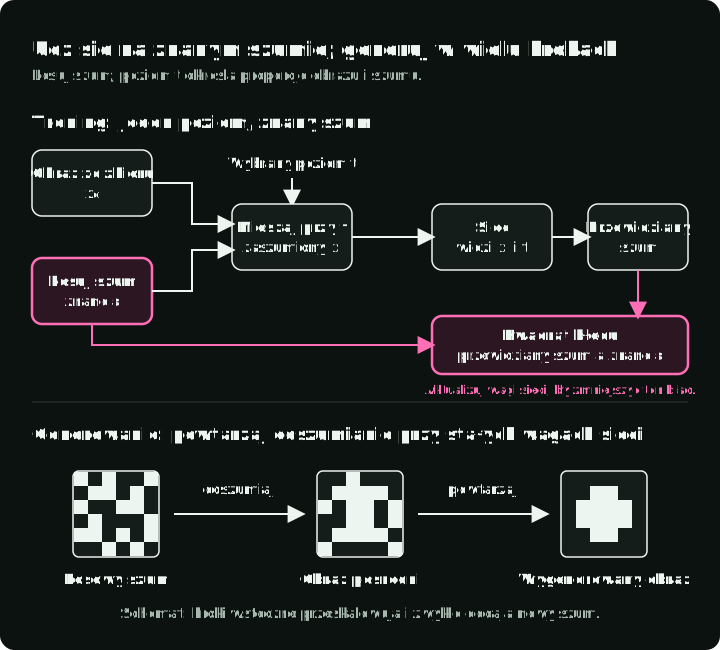
Zapisanie zaszumionego wejścia jako ułatwia odczytanie straty:
to czysty obraz treningowy, to losowo wybrany krok, a to nowa próbka szumu ze standardowego rozkładu normalnego. Sieć z wyuczonymi parametrami przewiduje tę próbkę. Kwadrat normy sumuje kwadraty błędów predykcji po współrzędnych obrazu; wartość oczekiwana uśrednia po obrazach, krokach i próbkach szumu.
Ustalony harmonogram definiuje i , gdzie to wariancja szumu dodawanego w kroku . Kreska oznacza ten iloczyn, a nie średnią. Ustala dwa współczynniki mieszanki z diagramu: dla obrazu i dla szumu. Wartość bliska 1 oznacza przewagę obrazu; bliska 0 — przewagę szumu.
Trening może utworzyć bezpośrednio; nie musi wykonywać wszystkich wcześniejszych kroków dodawania szumu. Oryginalny DDPM używa 1000 poziomów i losuje kroki treningowe jednostajnie. Zobacz równanie (4), równanie (14) i algorytm 1 lub szczegółowe omówienie DDPM.
Praca wyprowadza ograniczenie wariacyjne powiązane z ELBO, a następnie zmienia wagi jego składników, by uzyskać tę praktyczną stratę. Uproszczona strata nie jest sama w sobie oryginalnym ograniczeniem wiarygodności. Podczas generowania algorytm 2 przeskalowuje bieżący obraz, odejmuje wielokrotność przewidzianego szumu i, poza ostatnim krokiem, dodaje nowy szum. Nie odejmuje po prostu predykcji jeden raz, by odzyskać czysty obraz.
Metryki i twierdzenia o kosztach
Funkcja celu treningu, wynik ewaluacji i oszacowanie kosztu odpowiadają na różne pytania. Następne sekcje pokazują, co zlicza każda raportowana liczba i co musi pozostać stałe, by porównanie było użyteczne.
Pass@k: szansa, że co najmniej jedna z k próbek przejdzie testy
pass@k sprawdza, czy co najmniej jeden z wygenerowanych programów przechodzi testy. Dopuszcza kilka prób; nie oznacza, że pierwsza odpowiedź modelu jest poprawna.
Praca o Codex losuje niezależnie programów dla każdego zadania i zlicza przechodzących testy. Następnie rozważa każdy możliwy zbiór próbek. Odejmujemy od jedności odsetek zbiorów zawierających wyłącznie niepowodzenia:
Notacja zlicza sposoby wyboru elementów spośród bez zwracania. To estymata dla jednego zadania; raportowany wynik uśrednia ją po zadaniach. Dla pięciu próbek, dwóch przechodzących testy i trzech nieprzechodzących, istnieje dziesięć par. Tylko trzy zawierają dwa niepowodzenia, więc szacowane pass@2 wynosi .
Siatka pokazuje te dziesięć par w tym hipotetycznym przykładzie. Wszystkie pięć programów rozwiązuje to samo zadanie i jest uruchamiane na tych samych testach. Para odnosi sukces, gdy choć jeden z jej dwóch programów przechodzi testy.
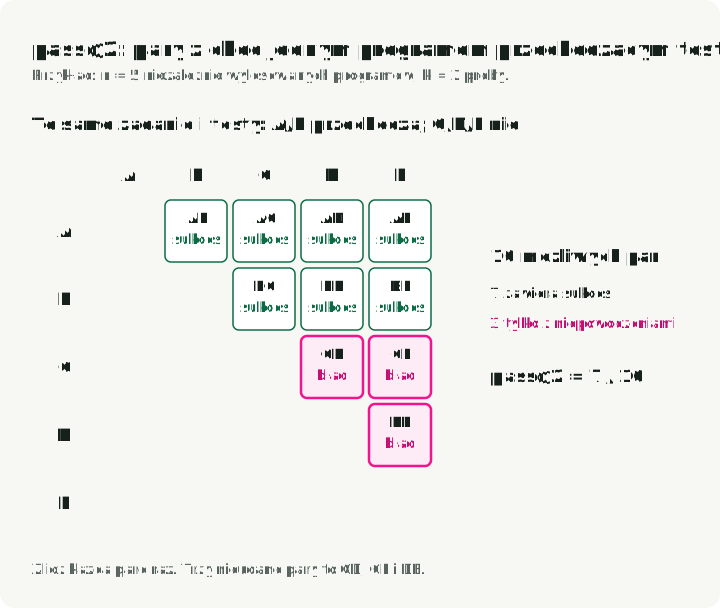
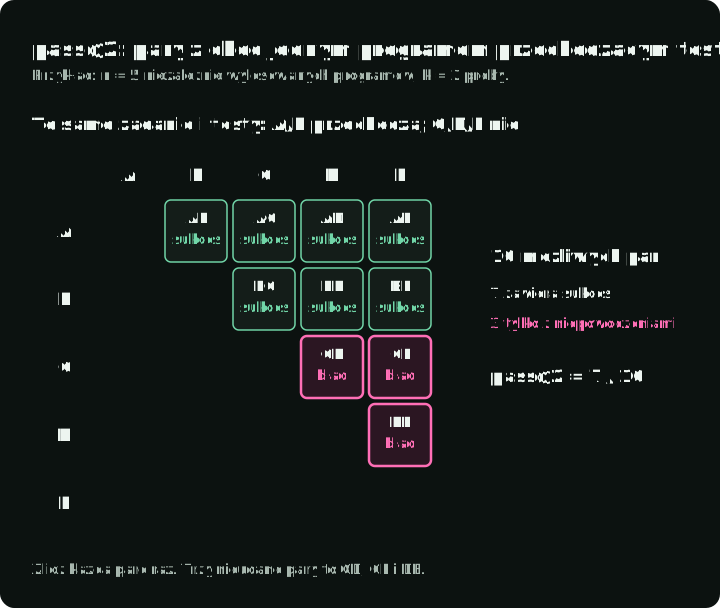
Używaj tego estymatora z całkowitymi liczebnościami i . Jeśli mniej niż próbek nie przechodzi testów, każdy zbiór zawiera próbkę przechodzącą i estymata wynosi 1. Kuszący skrót jest obciążony; w tym przykładzie daje 0,64. Praca o Codex, §2.1 i rysunek 3, podaje estymator i numerycznie stabilną implementację; szczegółowe omówienie wyjaśnia, dlaczego działa.
Porównuj to samo , zadania, testy, prompty i ustawienia generowania. Przejście testów nie dowodzi poprawności dla każdego wejścia. Wdrożony system potrzebuje też sposobu wyboru kandydata przechodzącego testy, na przykład ich uruchomienia; samo wygenerowanie kilku odpowiedzi nie wskazuje dobrej.
Perplexity: efektywna liczba możliwości na token
Perplexity ocenia prawdopodobieństwa przypisywane przez model językowy rzeczywistym kolejnym tokenom podanego tekstu. Na każdej pozycji podaj modelowi wcześniejszy tekst, uzyskaj jego prawdopodobieństwa możliwych kolejnych tokenów i odczytaj prawdopodobieństwo tokenu, który rzeczywiście następuje. Nie potrzeba wygenerowanej odpowiedzi. Wynik przekształca średni ujemny logarytm prawdopodobieństwa w bardziej zrozumiałą skalę:
to liczba tokenów, to obserwowany token, a to jego wcześniejszy kontekst. Jeśli model przypisuje każdemu obserwowanemu tokenowi prawdopodobieństwo , perplexity wynosi 4. Jeśli prawdopodobieństwa się różnią, wynik używa ich średniej geometrycznej. Prawdopodobieństwa 0,5, 0,2 i 0,1 dają perplexity około 4,64: taki sam wynik jak przypisanie każdemu tokenowi prawdopodobieństwa .
Wykresy używają przykładowych prawdopodobieństw dla trzech kolejnych pozycji. Każdy słupek pochodzi z innej predykcji kolejnego tokenu, więc słupki nie muszą sumować się do 1. Prawy wykres zastępuje je jedną stałą wartością; iloczyny są równe, więc perplexity też są równe.
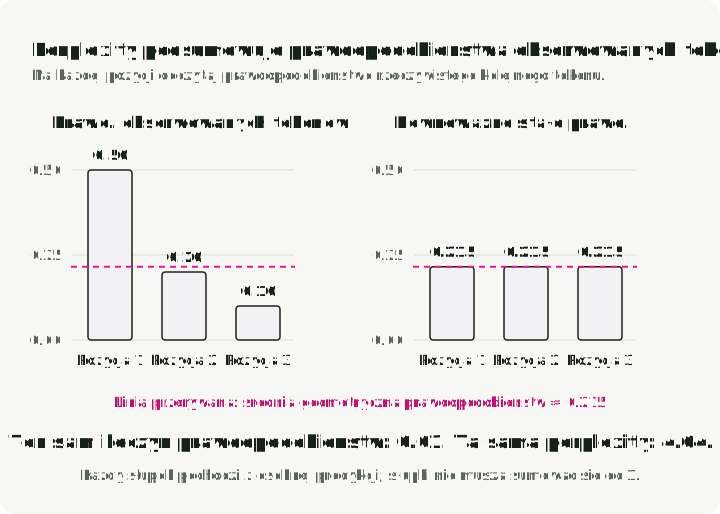
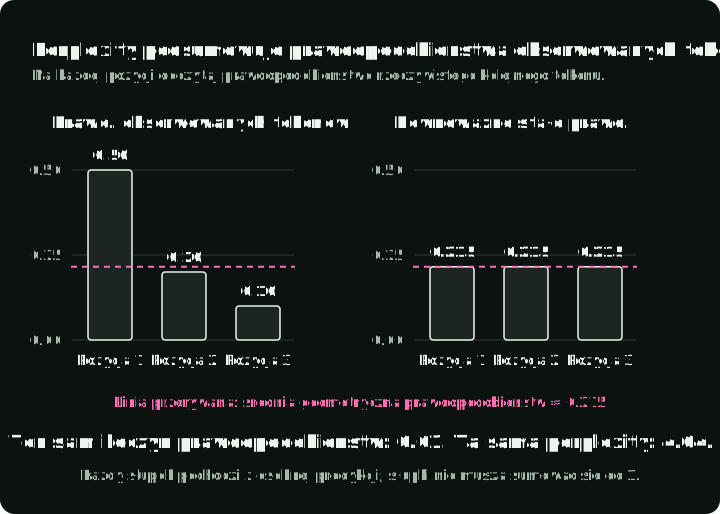
Niższy wynik jest lepszy dla tego samego tekstu ewaluacyjnego, tokenizatora i sposobu użycia kontekstu. Oznacza, że model przypisał obserwowanemu tekstowi wyższe prawdopodobieństwo, a nie że jego generowane odpowiedzi są bardziej użyteczne lub poprawne. Tokenizatory dzielą tekst różnie, a obsługa okna kontekstowego zmienia prawdopodobieństwa. Przewodnik Hugging Face o perplexity wyjaśnia te warunki porównania.
Big-O: jak koszt rośnie z długością sekwencji
Self-attention przekształca bieżący wektor każdego tokenu w zapytanie, klucz i wartość przy użyciu wyuczonych macierzy. Porównanie zapytania z kluczem ocenia, jak silnie jedna pozycja powinna korzystać z drugiej. Te oceny stają się wagami do łączenia wartości, jak w definicji atencji Transformera, §3.2.
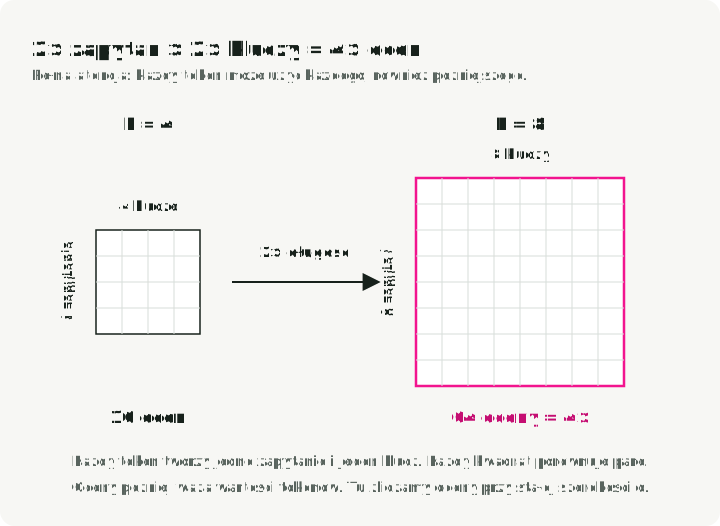
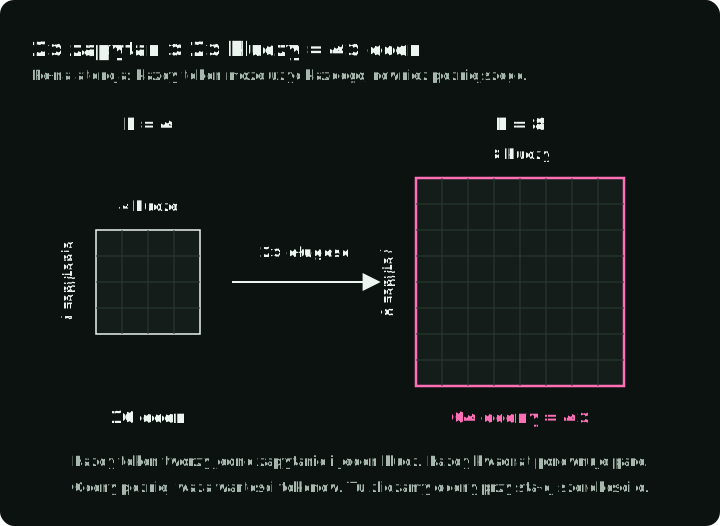
Dla jednej głowy atencji i tokenów porównanie każdego zapytania z każdym kluczem tworzy tabelę ocen . Podwojenie długości sekwencji powiększa tę tabelę czterokrotnie. Jeśli każde porównanie jest iloczynem skalarnym długości , liczba operacji obliczania ocen rośnie jak . Big-O opisuje asymptotyczne ograniczenie górne; pomija stałe i samo nie przewiduje czasu wykonania.
Siatki pokazują pełną atencję: każda pozycja może korzystać z każdej pozycji. Dłuższa sekwencja dodaje zarówno wiersze zapytań, jak i kolumny kluczy. Każda komórka to jedna ocena; implementacje takie jak FlashAttention mogą obliczać oceny bez przechowywania całej siatki naraz. Atencja przyczynowa wyklucza przyszłe pozycje, ale liczba dozwolonych par nadal rośnie kwadratowo.
Różne zmiany atencji zmniejszają różne koszty:
| Metoda | Co się zmienia | Co nadal rośnie z sekwencją |
|---|---|---|
| FlashAttention | Oblicza atencję blokami, unikając pełnej tabeli ocen w głównej pamięci GPU | Liczba operacji obliczania ocen pozostaje kwadratowa |
| DSA | Tańszy mechanizm oceny wybiera do tokenów do pełnej atencji | Mechanizm oceny nadal porównuje wszystkie dozwolone pary |
| MLA | Przechowuje mniej danych atencji na każdy buforowany token | Rozmiar pamięci podręcznej nadal rośnie liniowo z liczbą tokenów |
Tych oszczędności nie można traktować jak wymiennych przyspieszeń. Sprawdź, czy praca mierzyła operacje obliczeniowe, przydzieloną pamięć, transfery pamięci czy rozmiar pamięci podręcznej. Sprawdź też, czy mierzyła przetwarzanie promptu czy generowanie tokenów; DeepSeek-V3.2, rysunek 3, podaje te fazy osobno.
Prawa skalowania: dopasowane krzywe o określonym zakresie stosowalności
Prawo skalowania pomaga podzielić budżet treningowy między większy model a więcej danych. Jest krzywą dopasowaną do eksperymentów. Na przykład DeepSeek LLM, §3.2, równanie (4), podaje:
to koszt obliczeniowy treningu w operacjach zmiennoprzecinkowych. to koszt obliczeniowy na token z pominięciem embeddingów, używany tu jako miara rozmiaru modelu; nie jest liczbą parametrów. to liczba tokenów treningowych. Indeks dolny „opt” oznacza podział dopasowany tak, by minimalizować stratę walidacyjną przy danym budżecie. Współczynniki 0,1715 i 5,8316 należą do tego dopasowania i tych jednostek.
Poniższe krzywe dzielą dopasowane przydziały przez ich wartości dla budżetu FLOP, więc każdy dopasowany współczynnik się skraca. Stukrotny wzrost budżetu daje razy większy koszt obliczeniowy na token i razy więcej tokenów. To dwa końce krzywych na rysunku. Ich mnożniki się mnożą, ponieważ praca definiuje całkowity koszt jako .
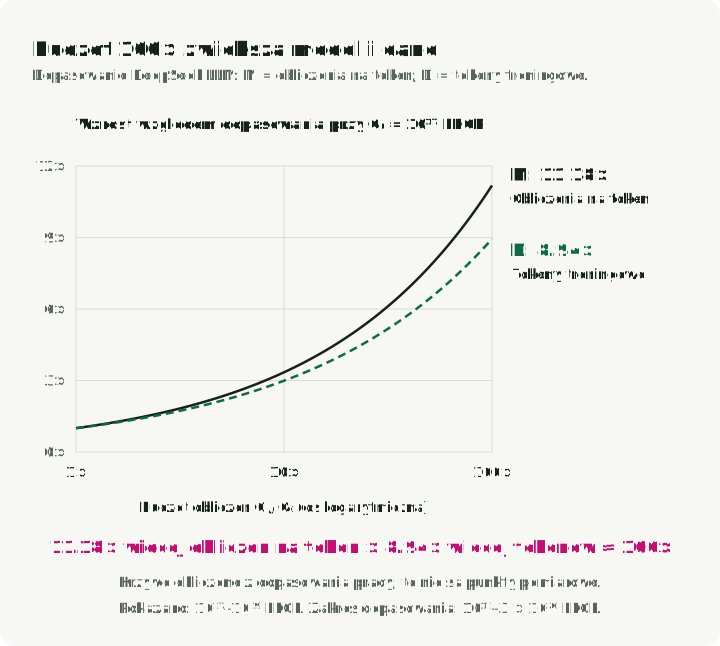
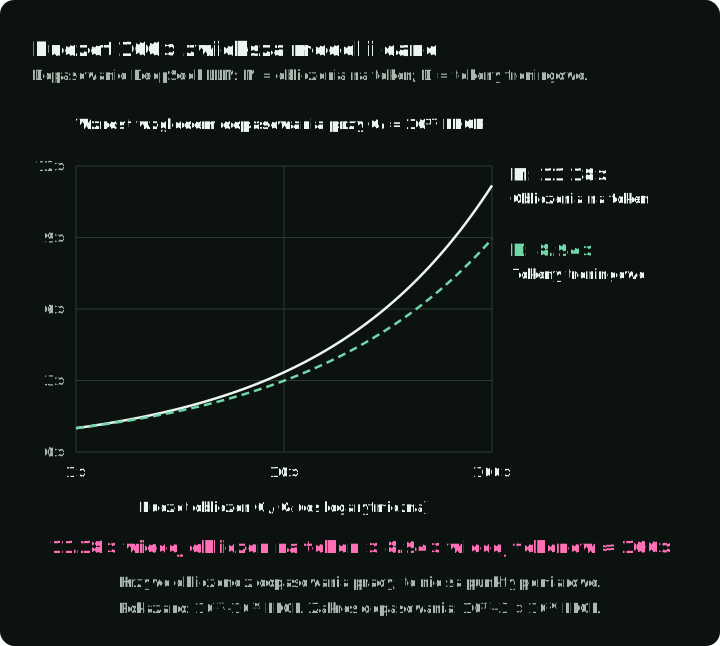
Ten wniosek dotyczy tych eksperymentów. Dopasowanie obejmuje od do FLOP. Poza tym zakresem jest ekstrapolacją; nawet w jego obrębie inne dane lub ustawienia treningu mogą zmienić najlepszy podział. Sekcja 3.3 podaje różne wykładniki dla różnych zbiorów danych. Szczegółowe omówienie praw skalowania wyjaśnia jednostki i sprawdza, jak łączą się dopasowane wzory.
Jak czytać równanie, którego seria nie omawia
Dla innego równania użyj sześciu pytań z części 1: określ obiekty, operacje, wymiary, losowanie, wyuczane wielkości i formułowane twierdzenie.
Repozytorium paper-math-skills zawiera instrukcje dla agentów dotyczące pisania i sprawdzania szczegółowego omówienia. Podlinkowane analizy to przykłady takiego wyniku, z definicjami symboli i sprawdzeniami liczbowymi.
Źródła i wersje
Szersze wprowadzenie do podstaw zawiera The Little Book of Generative AI Foundations Tianhua Chena; §3.2 dotyczy ELBO.