Leer el ELBO, la pérdida de difusión, pass@k y las leyes de escalado

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta parte explica qué entrenan dos modelos generativos y qué indican cuatro medidas habituales. Se dirige a ingenieros que quieren entender el ELBO y la pérdida de difusión o comparar artículos que presentan pass@k, perplejidad, complejidad computacional y leyes de escalado. Los diagramas muestran los cálculos; las ecuaciones identifican exactamente qué se optimiza o se cuenta.
Las secciones sobre modelos generativos se apoyan unas en otras. Las de métricas pueden leerse de forma independiente. La parte 1 ofrece una referencia de notación si hace falta. Todos los logaritmos de aquí son naturales.
Modelos generativos: el ELBO y la difusión
Un modelo de lenguaje puede asignar una probabilidad a una respuesta proporcionada token a token. Otros modelos generativos introducen variables ocultas: valores intermedios que ayudan a generar datos, pero no aparecen en el dataset de entrenamiento. Calcular la probabilidad de una imagen puede exigir entonces promediar sobre demasiados valores ocultos posibles. Los dos métodos siguientes entrenan sin calcular esa media de forma exacta.
ELBO: una cota inferior que se puede calcular
Un autocodificador variacional (VAE) genera una imagen a partir de un vector latente : una lista de números. Un ejemplo sencillo de dos dimensiones es . Estos números son entradas de una red neuronal, no instrucciones de un lenguaje de programación. El vector es latente porque el dataset de entrenamiento contiene imágenes, pero no proporciona los valores correspondientes.
Para generar una imagen en el VAE estándar descrito aquí, se extrae cada componente de de forma independiente de una distribución normal con media 0 y desviación típica 1. Extraer valores según una distribución se llama muestreo. Esta distribución fija sobre vectores es la distribución a priori, escrita .
El decodificador es una red neuronal entrenada. Sus pesos aprendidos transforman en los parámetros de una distribución sobre los valores de los píxeles. Por ejemplo, un decodificador para imágenes de 28 por 28 cuyos píxeles son 0 o 1 puede producir 784 probabilidades, una por píxel. Cada probabilidad indica la posibilidad de que su píxel sea 1. Al muestrear esos valores de píxel se obtiene una imagen. Los componentes del vector determinan las probabilidades de los píxeles a través de la red entrenada; no son píxeles. Kingma y Welling, §3 y apéndice C, describen esta configuración estándar.
Durante el entrenamiento, una imagen procede del dataset. Un codificador, otra red neuronal, recibe esta imagen como entrada. En la configuración gaussiana utilizada aquí, predice una media y una desviación típica para cada componente de . Juntas definen , una distribución sobre vectores latentes para esta imagen. Muestreamos de esa distribución en lugar de la distribución a priori. El decodificador asigna entonces la probabilidad a la imagen original usando el vector muestreado.
El entrenamiento recompensa al decodificador por asignar un logaritmo de probabilidad alto a la imagen observada. También resta la divergencia KL: una medida no negativa de cuánto difiere la distribución de vectores del codificador de la distribución a priori fija. El diagrama muestra ambos términos y la distinta procedencia de los vectores durante la generación.
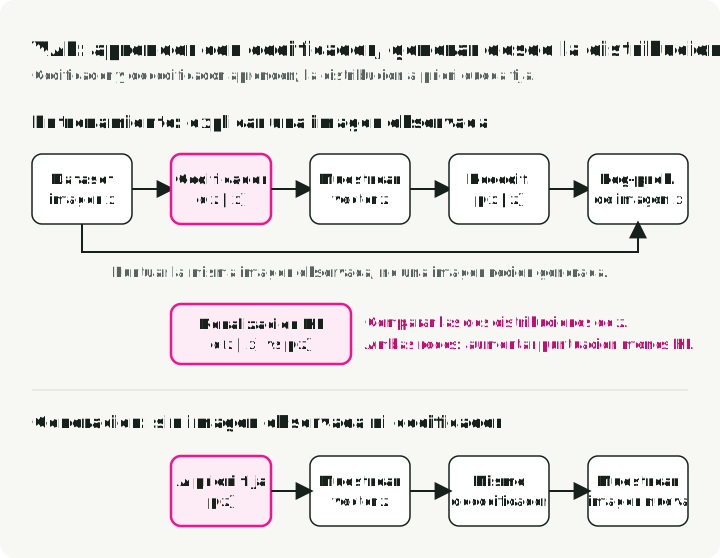
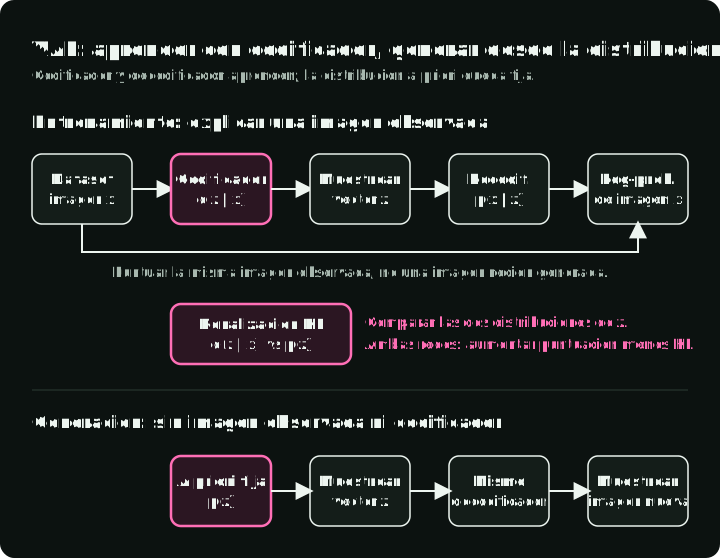
La puntuación de entrenamiento tiene dos términos:
El primer término promedia el logaritmo de la probabilidad de la imagen sobre vectores muestreados del codificador. El segundo es la penalización KL. Los símbolos y denotan los parámetros aprendidos del codificador y del decodificador. Ambas redes aprenden a aumentar esta puntuación; una implementación que minimiza una pérdida utiliza su negativo.
Es la cota inferior de la evidencia, o ELBO. La evidencia es la probabilidad del modelo para la imagen observada, promediada sobre todos los vectores latentes posibles. Kingma y Welling, §2.2, ecuaciones (1)–(3), la relacionan con la puntuación de entrenamiento:
Aquí es la distribución a posteriori verdadera: la distribución del modelo sobre los vectores latentes dada esta imagen. El término KL no negativo es la diferencia entre el ELBO y el logaritmo de la evidencia; vale cero cuando el codificador coincide con esa distribución a posteriori. Esta identidad explica la cota. La penalización de entrenamiento calculable del diagrama compara en cambio el codificador con la distribución a priori conocida , por lo que un paso de entrenamiento no requiere la distribución a posteriori desconocida.
Un ELBO mayor no demuestra por sí solo que el decodificador haya mejorado. Un codificador mejor puede hacer más precisa la cota sin modificar el decodificador. Además, la cota se aplica a la esperanza exacta: una estimación con unos pocos vectores muestreados puede superar el logaritmo de la evidencia en una extracción individual. La lectura detallada sobre el ELBO deriva la cota y la comprueba con un ejemplo desarrollado.
DDPM: predecir el ruido añadido
En DDPM, las variables ocultas son versiones ruidosas de una imagen. Durante el entrenamiento, toma una imagen limpia del dataset y extrae ruido aleatorio: un número de una normal estándar por cada coordenada de la imagen. Elige aleatoriamente un paso de un calendario de ruido fijo, que establece las proporciones de imagen y ruido que se mezclan. La red ve esta imagen alterada y ; su tarea es predecir la muestra de ruido que acabamos de añadir.
La generación utiliza repetidamente la red entrenada. Parte de ruido aleatorio, predice el ruido en el nivel actual y usa esa predicción para dar un pequeño paso de eliminación de ruido. Sus pesos permanecen fijos durante este proceso. El entrenamiento dispone, por tanto, de un objetivo conocido que proporciona el error utilizado para actualizar la red; la generación usa la red aprendida para producir una imagen a través de muchos pasos.
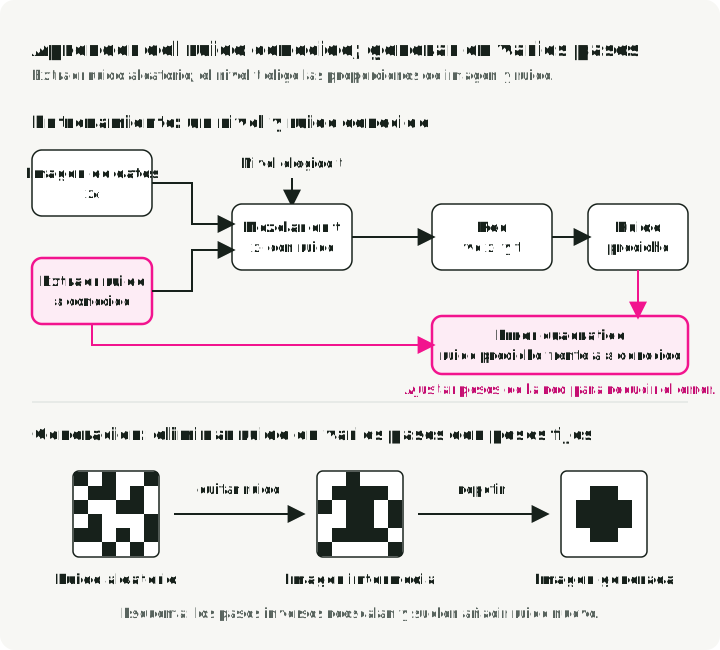
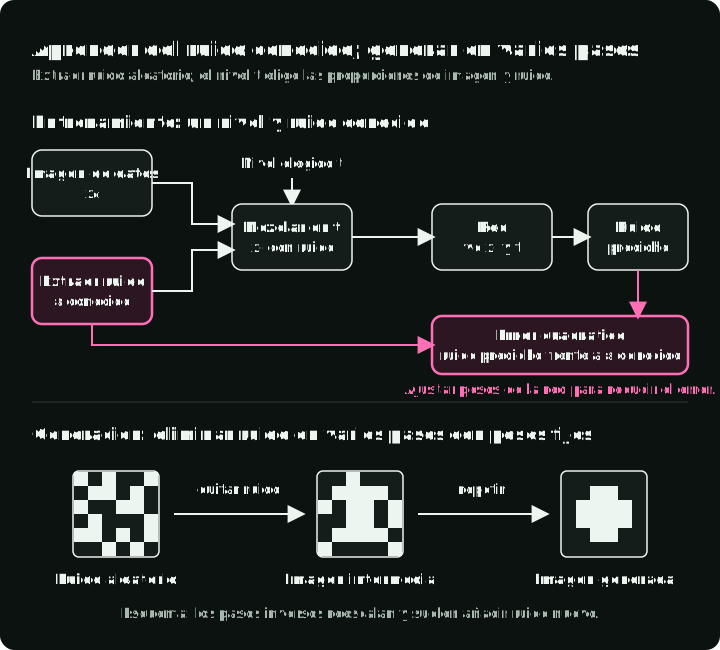
Escribir la entrada ruidosa como facilita la lectura de la pérdida:
es una imagen limpia de entrenamiento, un paso elegido aleatoriamente y una muestra nueva de ruido normal estándar. La red , con parámetros aprendidos , predice esa muestra. La norma al cuadrado suma los errores de predicción al cuadrado sobre las coordenadas de la imagen; la esperanza promedia sobre imágenes, pasos y muestras de ruido.
El calendario fijo define y , donde es la varianza de ruido añadida en el paso . La barra denota este producto, no una media. Establece los dos coeficientes de la mezcla del diagrama: para la imagen y para el ruido. Cerca de 1 significa principalmente imagen; cerca de 0, principalmente ruido.
El entrenamiento puede construir directamente; no necesita ejecutar todos los pasos de ruido anteriores. El DDPM original usa 1.000 niveles y muestrea los pasos de entrenamiento de manera uniforme. Véanse la ecuación (4), la ecuación (14) y el algoritmo 1, o la lectura detallada sobre DDPM.
El artículo deriva una cota variacional relacionada con el ELBO y después cambia la ponderación de sus términos para obtener esta pérdida práctica. La pérdida simplificada no es en sí misma la cota de verosimilitud original. Durante la generación, el algoritmo 2 reescala la imagen actual, resta un múltiplo del ruido predicho y, salvo en el último paso, añade ruido nuevo. No basta con restar la predicción una vez para recuperar una imagen limpia.
Métricas y afirmaciones sobre costes
Un objetivo de entrenamiento, una puntuación de evaluación y una estimación de costes responden a preguntas distintas. Las secciones siguientes muestran qué cuenta cada cifra presentada y qué debe mantenerse fijo para que una comparación resulte útil.
Pass@k: la probabilidad de que al menos una de k muestras pase las pruebas
pass@k pregunta si al menos uno de programas generados pasa las pruebas. Permite varios intentos; no significa que la primera respuesta del modelo sea correcta.
El artículo de Codex muestrea programas de forma independiente para cada problema y cuenta los que pasan las pruebas. Después considera todos los conjuntos posibles de muestras. Se resta de uno la fracción de conjuntos que solo contienen fallos:
La notación cuenta las formas de elegir elementos de sin reemplazo. Es la estimación para un problema; la puntuación presentada la promedia entre problemas. Con cinco muestras, dos que pasan y tres que fallan, hay diez pares. Solo tres contienen dos fallos, por lo que el pass@2 estimado es .
La cuadrícula muestra esos diez pares en este ejemplo hipotético. Los cinco programas responden al mismo problema y se ejecutan con las mismas pruebas. Un par tiene éxito en cuanto cualquiera de sus dos programas pasa las pruebas.
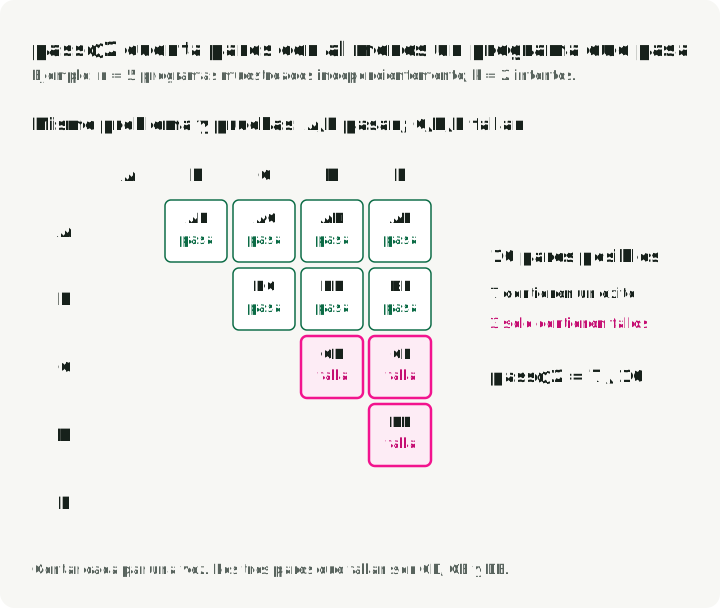
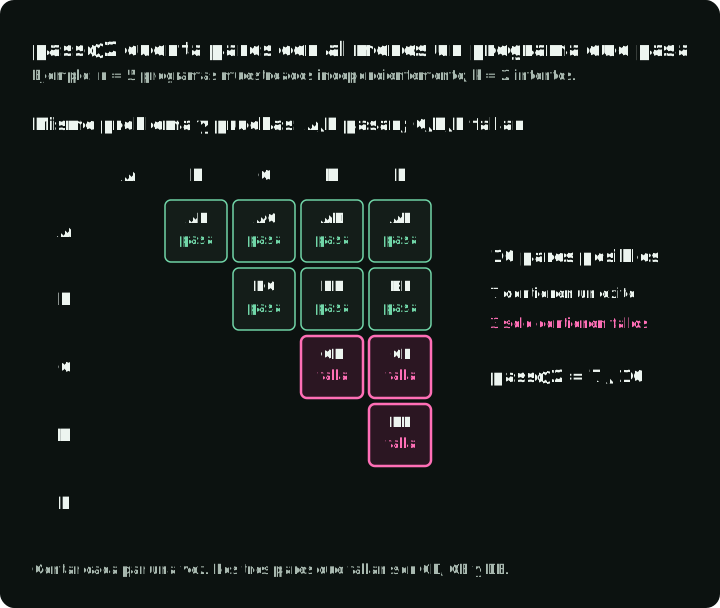
Se usa este estimador con recuentos enteros y . Si fallan menos de muestras, cada conjunto contiene una muestra que pasa y la estimación es 1. El atajo tentador es sesgado; en este ejemplo da 0.64. El artículo de Codex, §2.1 y figura 3, proporciona el estimador y una implementación numéricamente estable; la lectura detallada explica por qué funciona.
Se deben comparar el mismo , los mismos problemas, pruebas, prompts y ajustes de generación. Pasar las pruebas no demuestra la corrección para cualquier entrada. Un sistema desplegado también necesita una forma de seleccionar un candidato que pase, como ejecutar esas pruebas; generar varias respuestas no identifica por sí solo la buena.
Perplejidad: el número efectivo de opciones por token
La perplejidad evalúa las probabilidades que un modelo de lenguaje asigna a los siguientes tokens reales de un texto proporcionado. En cada posición se da al modelo el texto anterior, se obtienen sus probabilidades sobre los siguientes tokens posibles y se lee la probabilidad del token que realmente sigue. No hace falta ninguna respuesta generada. La puntuación convierte el promedio del logaritmo negativo de la probabilidad en una escala más interpretable:
es el número de tokens, el token observado e su contexto anterior. Si el modelo asigna a cada token observado la probabilidad , la perplejidad es 4. Si las probabilidades difieren, la puntuación usa su media geométrica. Las probabilidades 0.5, 0.2 y 0.1 dan una perplejidad aproximada de 4.64: la misma puntuación que asignar a cada token la probabilidad .
Los gráficos usan probabilidades inventadas para tres posiciones sucesivas. Cada barra procede de una predicción distinta del siguiente token, así que las barras no tienen que sumar 1. El gráfico de la derecha las sustituye por un valor constante; los productos coinciden, por lo que las perplejidades también.
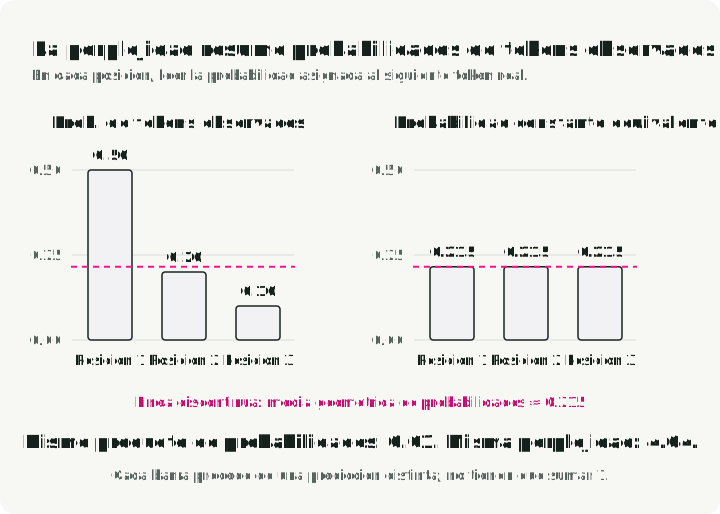
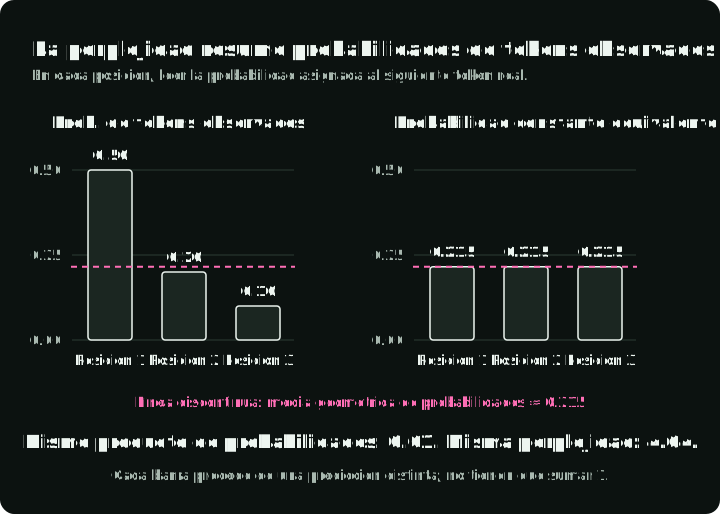
Un valor menor es mejor con el mismo texto de evaluación, tokenizador y procedimiento de contexto. Significa que el modelo asignó mayor probabilidad al texto observado, no que sus respuestas generadas sean más útiles o correctas. Los tokenizadores dividen el texto de formas distintas, y el tratamiento de la ventana de contexto cambia las probabilidades. La guía de perplejidad de Hugging Face explica estas condiciones de comparación.
Big-O: cómo crece el coste con la longitud de secuencia
La autoatención transforma el vector actual de cada token en una consulta, una clave y un valor mediante matrices aprendidas. La comparación entre consulta y clave puntúa con qué intensidad una posición debe usar otra. Estas puntuaciones se convierten en pesos para combinar los valores, como en la definición de atención del Transformer, §3.2.
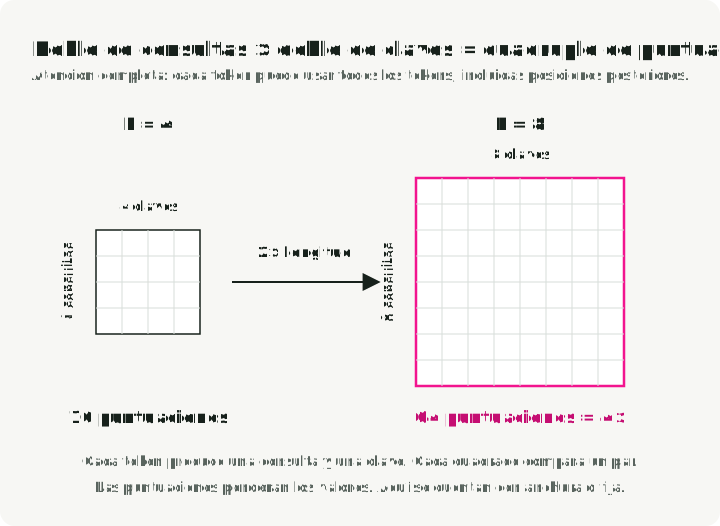
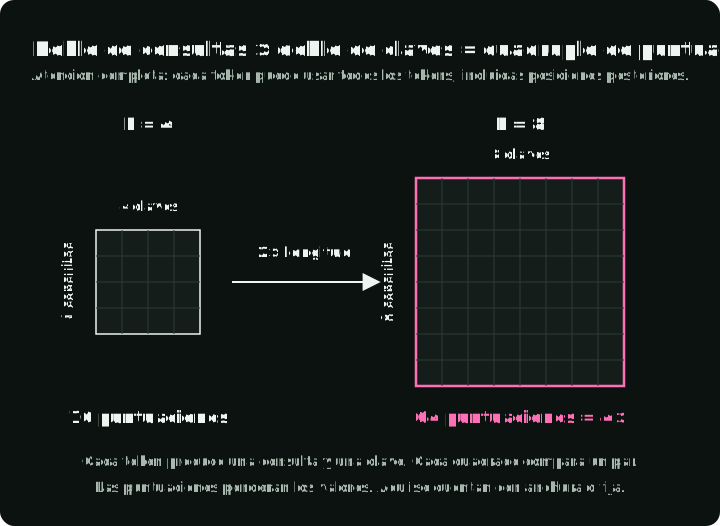
Para una cabeza de atención y tokens, comparar cada consulta con cada clave produce una tabla de puntuaciones de . Duplicar la longitud de secuencia cuadruplica esa tabla. Si cada comparación es un producto escalar de longitud , la aritmética de puntuación crece como . Big-O describe una cota superior asintótica; omite constantes y no predice por sí solo el tiempo de ejecución.
Las cuadrículas muestran atención completa: cada posición puede usar todas las posiciones. Una secuencia más larga añade tanto filas de consultas como columnas de claves. Cada celda es una puntuación; implementaciones como FlashAttention pueden calcularlas sin almacenar toda la cuadrícula a la vez. La atención causal excluye posiciones futuras, pero su número de pares permitidos sigue creciendo de forma cuadrática.
Distintos cambios en la atención reducen costes distintos:
| Método | Qué cambia | Qué sigue creciendo con la secuencia |
|---|---|---|
| FlashAttention | Calcula la atención por bloques y evita una tabla completa de puntuaciones en la memoria principal de la GPU | La aritmética de puntuación sigue siendo cuadrática |
| DSA | Un evaluador más barato selecciona hasta tokens para la atención completa | El evaluador sigue comparando todos los pares permitidos |
| MLA | Almacena menos datos de atención por token en caché | El tamaño de caché sigue creciendo linealmente con el número de tokens |
Estos ahorros no pueden interpretarse como aceleraciones intercambiables. Hay que comprobar si un artículo midió operaciones aritméticas, memoria asignada, transferencias de memoria o tamaño de caché. También si midió el procesamiento del prompt o la generación de tokens; DeepSeek-V3.2, figura 3, presenta esas fases por separado.
Leyes de escalado: curvas ajustadas con un intervalo de validez
Una ley de escalado ayuda a repartir un presupuesto de entrenamiento entre un modelo mayor y más datos. Es una curva ajustada a experimentos. Por ejemplo, DeepSeek LLM, §3.2, ecuación (4), presenta:
es el cómputo de entrenamiento en operaciones de coma flotante. es el cómputo por token sin embeddings, usado aquí como medida del tamaño del modelo; no es el número de parámetros. es el número de tokens de entrenamiento. El subíndice «opt» marca el reparto ajustado para minimizar la pérdida de validación con ese presupuesto. Los coeficientes 0.1715 y 5.8316 pertenecen a este ajuste y a estas unidades.
Las curvas siguientes dividen los repartos ajustados por sus valores con un presupuesto de FLOPs, de modo que cada coeficiente ajustado se cancela. Multiplicar el presupuesto por 100 da veces más cómputo por token y veces más tokens. Son los dos extremos de la figura. Sus factores se multiplican porque el artículo define el cómputo total como .
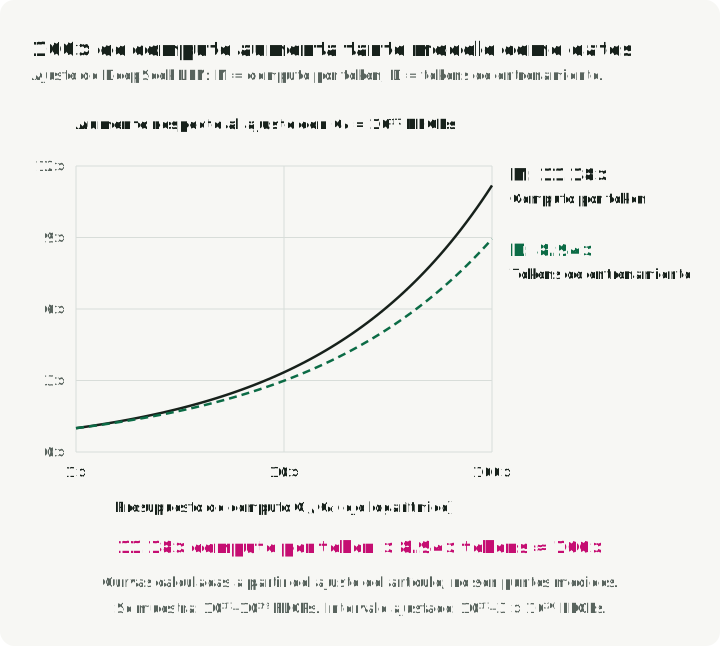
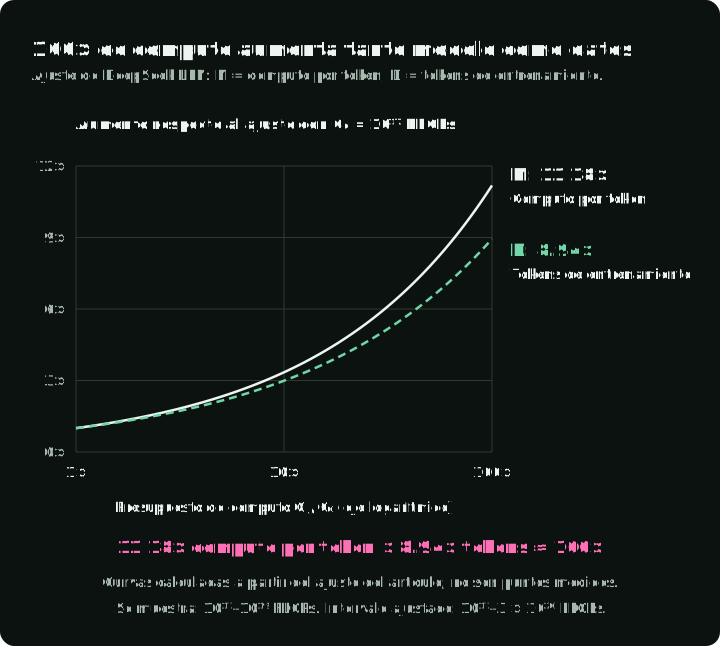
Esa conclusión corresponde a estos experimentos. El ajuste cubre de a FLOPs. Fuera de ese intervalo es una extrapolación; incluso dentro, otros datos o ajustes de entrenamiento pueden cambiar el mejor reparto. La sección 3.3 presenta distintos exponentes para distintos datasets. La lectura detallada sobre leyes de escalado explica las unidades y comprueba cómo se combinan las fórmulas ajustadas.
Leer una ecuación que esta serie no cubre
Para otra ecuación, se pueden usar las seis preguntas de la parte 1: identificar los objetos, las operaciones, las dimensiones, el muestreo, las cantidades aprendidas y la afirmación realizada.
El repositorio paper-math-skills proporciona instrucciones para que un agente escriba y compruebe una explicación detallada. Las lecturas enlazadas son ejemplos de ese resultado, con definiciones de símbolos y comprobaciones numéricas.
Fuentes y versiones
Para una introducción más extensa a los fundamentos, véase The Little Book of Generative AI Foundations de Tianhua Chen, §3.2 para el ELBO.