Lire l’ELBO, la perte de diffusion, pass@k et les lois d’échelle

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cette partie explique ce que deux modèles génératifs apprennent et ce que quatre mesures courantes indiquent. Elle s’adresse aux ingénieurs qui veulent comprendre l’ELBO et la perte de diffusion, ou comparer des articles qui présentent pass@k, la perplexité, la complexité de calcul et les lois d’échelle. Les diagrammes montrent les calculs ; les équations précisent exactement ce qui est optimisé ou compté.
Les sections sur les modèles génératifs se suivent dans l’ordre. Les sections sur les métriques peuvent se lire indépendamment. La partie 1 fournit une référence pour la notation si nécessaire. Tous les logarithmes utilisés ici sont naturels.
Modèles génératifs : l’ELBO et la diffusion
Un modèle de langage peut attribuer une probabilité à une réponse fournie, un token à la fois. D’autres modèles génératifs introduisent des variables cachées : des valeurs intermédiaires qui aident à générer les données, mais ne figurent pas dans le dataset d’entraînement. Calculer la probabilité d’une image peut alors exiger une moyenne sur un trop grand nombre de valeurs cachées possibles. Les deux méthodes suivantes s’entraînent sans calculer exactement cette moyenne.
ELBO : une borne inférieure calculable
Un autoencodeur variationnel (VAE) génère une image à partir d’un vecteur latent : une liste de nombres. Un exemple simplifié à deux dimensions est . Ces nombres sont des entrées d’un réseau de neurones, pas des instructions dans un langage de programmation. Le vecteur est latent parce que le dataset d’entraînement contient des images sans fournir les valeurs correspondantes.
Pour générer une image dans le VAE standard présenté ici, tirez chaque composante de indépendamment selon une loi normale de moyenne 0 et d’écart-type 1. Tirer des valeurs selon une distribution s’appelle l’échantillonnage. Cette distribution fixe sur les vecteurs est la loi a priori, notée .
Le décodeur est un réseau de neurones entraîné. Ses poids appris transforment en paramètres d’une distribution sur les valeurs des pixels. Par exemple, pour des images de 28 × 28 pixels valant 0 ou 1, un décodeur peut produire 784 probabilités, une par pixel. Chaque probabilité donne la chance que son pixel vaille 1. Échantillonner ces valeurs de pixels produit une image. Les composantes du vecteur déterminent les probabilités des pixels par l’intermédiaire du réseau entraîné ; elles ne sont pas elles-mêmes des pixels. Kingma et Welling, §3 et annexe C, décrivent cette configuration standard.
Pendant l’entraînement, une image provient du dataset. Un encodeur, un autre réseau de neurones, reçoit cette image en entrée. Dans la configuration gaussienne utilisée ici, il prédit une moyenne et un écart-type pour chaque composante de . Ensemble, ils définissent , une distribution sur les vecteurs latents pour cette image. Nous tirons dans cette distribution plutôt que dans la loi a priori. Le décodeur attribue alors à l’image d’origine la probabilité à partir du vecteur tiré.
L’entraînement récompense le décodeur lorsqu’il attribue une log-probabilité élevée à l’image observée. Il soustrait aussi la divergence KL : une mesure non négative de la différence entre la distribution des vecteurs de l’encodeur et la loi a priori fixe. Le diagramme montre ces deux termes et l’origine différente des vecteurs lors de la génération.
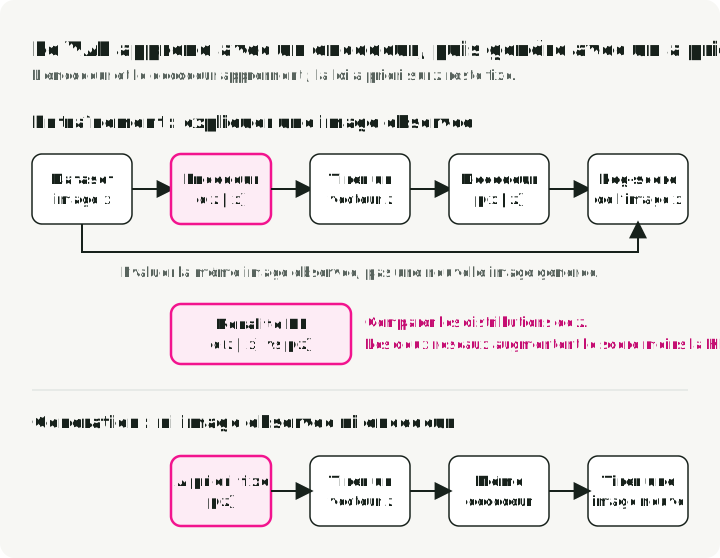
Le score d’entraînement comprend deux termes :
Le premier terme moyenne la log-probabilité de l’image sur les vecteurs tirés dans la distribution de l’encodeur. Le second est la pénalité KL. Les symboles et désignent les paramètres appris de l’encodeur et du décodeur. Les deux réseaux apprennent à augmenter ce score ; le code qui minimise une perte utilise son opposé.
C’est la borne inférieure de l’évidence, ou ELBO. L’évidence est la probabilité que le modèle attribue à l’image observée, moyennée sur tous les vecteurs latents possibles. Kingma et Welling, §2.2, équations (1)–(3), la relient au score d’entraînement :
Ici, est la vraie loi a posteriori : la distribution du modèle sur les vecteurs latents sachant cette image. Le terme KL non négatif est l’écart entre l’ELBO et la log-évidence ; il vaut zéro lorsque l’encodeur coïncide avec cette loi a posteriori. Cette identité explique la borne. La pénalité d’entraînement calculable du diagramme compare au contraire l’encodeur à la loi a priori connue : une étape d’entraînement ne nécessite donc pas la loi a posteriori inconnue.
Une ELBO plus élevée ne prouve pas à elle seule que le décodeur s’est amélioré. Un meilleur encodeur peut rendre la borne plus précise sans changer le décodeur. De plus, la borne s’applique à l’espérance exacte : une estimation à partir de quelques vecteurs tirés peut dépasser la log-évidence lors d’un tirage donné. La lecture détaillée de l’ELBO dérive la borne et la vérifie avec un exemple détaillé.
DDPM : prédire le bruit ajouté
DDPM utilise des versions bruitées d’une image comme variables cachées. Pendant l’entraînement, il prend une image propre du dataset et tire un bruit aléatoire : un nombre suivant une loi normale centrée réduite pour chaque coordonnée de l’image. Il choisit aléatoirement une étape dans un programme de bruitage fixe, qui détermine les proportions d’image et de bruit à mélanger. Le réseau reçoit cette image dégradée et ; il doit prédire l’échantillon de bruit que nous venons d’ajouter.
La génération utilise le réseau entraîné à plusieurs reprises. Elle part d’un bruit aléatoire, prédit le bruit au niveau courant et utilise cette prédiction pour effectuer une petite étape de débruitage. Les poids du réseau restent fixes pendant ce processus. L’entraînement dispose donc d’une cible connue qui fournit l’erreur utilisée pour mettre à jour le réseau ; la génération utilise le réseau appris pour produire une image en de nombreuses étapes.
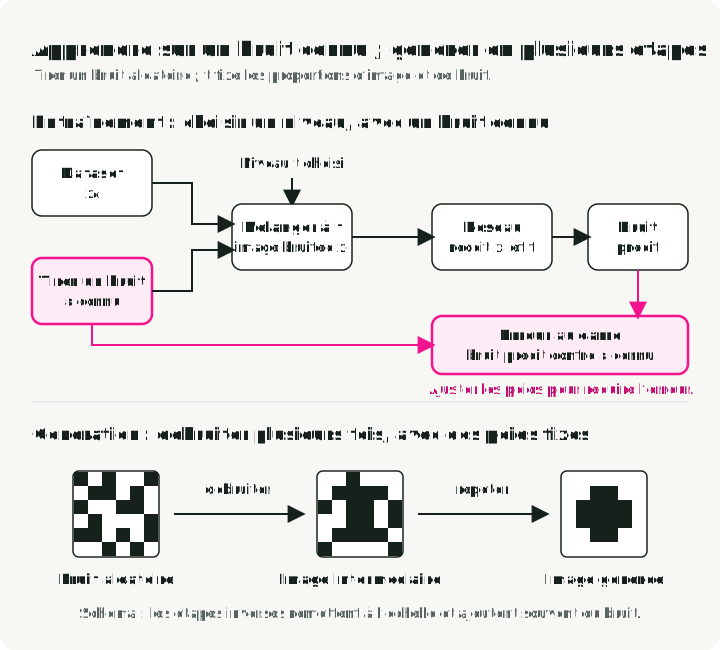
Noter l’entrée bruitée facilite la lecture de la perte :
est une image d’entraînement propre, une étape choisie aléatoirement et un nouvel échantillon de bruit suivant une loi normale centrée réduite. Le réseau , dont les paramètres appris sont , prédit cet échantillon. La norme au carré somme les erreurs de prédiction au carré sur les coordonnées de l’image ; l’espérance moyenne sur les images, les étapes et les échantillons de bruit.
Le programme fixe définit et , où est la variance du bruit ajouté à l’étape . La barre désigne ce produit, pas une moyenne. Il détermine les deux coefficients du mélange dans le diagramme : pour l’image et pour le bruit. Une valeur proche de 1 signifie surtout de l’image ; proche de 0, surtout du bruit.
L’entraînement peut construire directement ; il n’a pas besoin d’exécuter chaque étape de bruitage précédente. Le DDPM d’origine utilise 1 000 niveaux et tire les étapes d’entraînement uniformément. Voir l’équation (4), l’équation (14) et l’algorithme 1, ou la lecture détaillée de DDPM.
L’article dérive une borne variationnelle liée à l’ELBO, puis modifie la pondération de ses termes pour obtenir cette perte pratique. La perte simplifiée n’est pas elle-même la borne de vraisemblance d’origine. Pendant la génération, l’algorithme 2 remet l’image courante à l’échelle, soustrait un multiple du bruit prédit et, sauf à la dernière étape, ajoute un nouveau bruit. Il ne suffit pas de soustraire une seule fois la prédiction pour retrouver une image propre.
Métriques et affirmations sur les coûts
Un objectif d’entraînement, un score d’évaluation et une estimation de coût répondent à des questions différentes. Les sections suivantes montrent ce que chaque chiffre publié compte et ce qui doit rester fixe pour qu’une comparaison soit utile.
Pass@k : la probabilité qu’au moins un échantillon sur k réussisse
pass@k demande si au moins un des programmes générés réussit les tests. Il autorise plusieurs tentatives ; il ne signifie pas que la première réponse du modèle est correcte.
L’article Codex tire indépendamment programmes pour chaque problème et compte les qui réussissent. Il considère ensuite tous les ensembles possibles de échantillons. On soustrait la fraction des ensembles qui ne contiennent que des échecs :
La notation compte les façons de choisir éléments parmi sans remise. C’est l’estimation pour un problème ; le score publié en fait la moyenne sur les problèmes. Avec cinq échantillons, deux réussites et trois échecs, il existe dix paires. Seules trois paires contiennent deux échecs : l’estimation de pass@2 est donc .
La grille montre ces dix paires dans cet exemple hypothétique. Les cinq programmes répondent au même problème et sont soumis aux mêmes tests. Une paire réussit dès que l’un de ses deux programmes réussit.
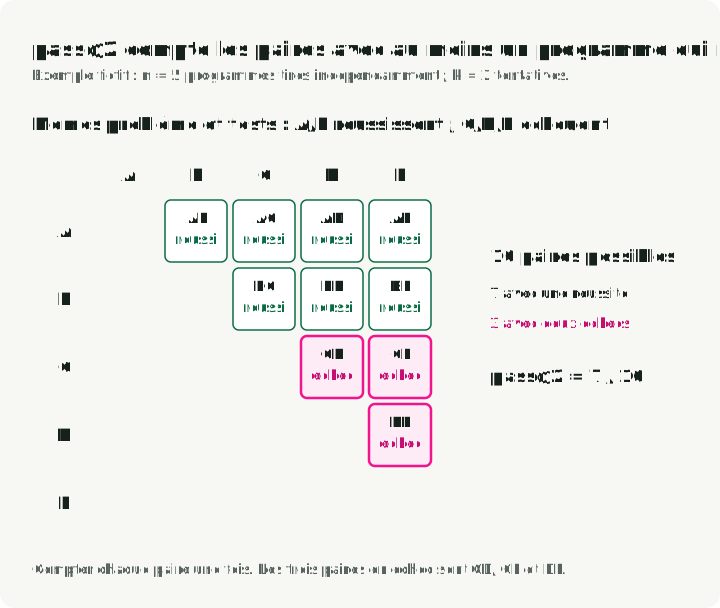
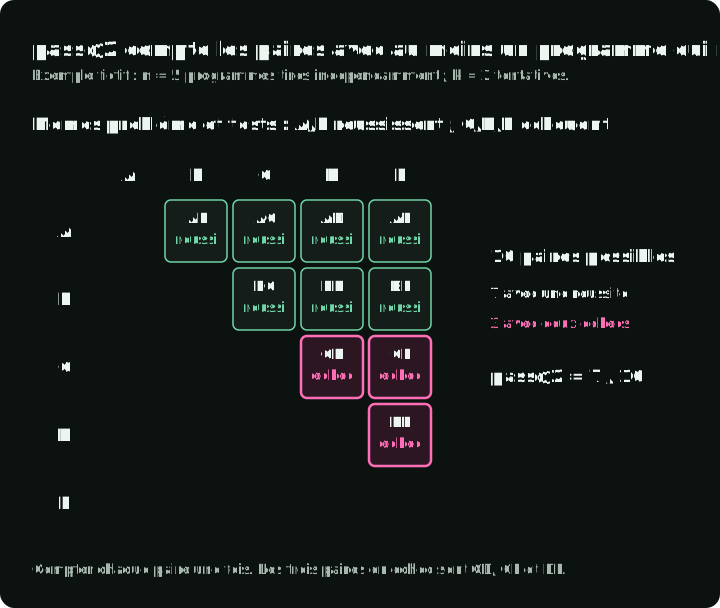
Utilisez cet estimateur avec des effectifs entiers et . Si moins de échantillons échouent, chaque ensemble contient une réussite et l’estimation vaut 1. Le raccourci tentant est biaisé ; il donne 0.64 dans cet exemple. L’article Codex, §2.1 et figure 3, fournit l’estimateur et une implémentation numériquement stable ; la lecture détaillée explique pourquoi il fonctionne.
Comparez avec les mêmes , problèmes, tests, prompts et réglages de génération. Réussir les tests ne prouve pas la correction pour toute entrée. Un système déployé a aussi besoin d’un moyen de sélectionner un candidat qui réussit, par exemple en exécutant ces tests ; générer plusieurs réponses ne suffit pas à identifier la bonne.
Perplexité : le nombre effectif de choix par token
La perplexité évalue les probabilités qu’un modèle de langage attribue aux véritables tokens suivants d’un texte fourni. À chaque position, donnez au modèle le texte précédent, obtenez ses probabilités sur les tokens suivants possibles et relevez celle du token qui suit réellement. Aucune réponse générée n’est nécessaire. Le score convertit la log-probabilité négative moyenne en une échelle plus facile à interpréter :
est le nombre de tokens, le token observé et son contexte précédent. Si le modèle attribue une probabilité à chaque token observé, la perplexité vaut 4. Si leurs probabilités diffèrent, le score utilise leur moyenne géométrique. Des probabilités de 0.5, 0.2 et 0.1 donnent une perplexité d’environ 4.64 : le même score que si chaque token recevait une probabilité .
Les graphiques utilisent des probabilités inventées pour trois positions successives. Chaque barre provient d’une prédiction différente du token suivant : leur somme n’a donc pas à valoir 1. Le graphique de droite les remplace par une valeur constante ; les produits sont égaux, donc les perplexités aussi.
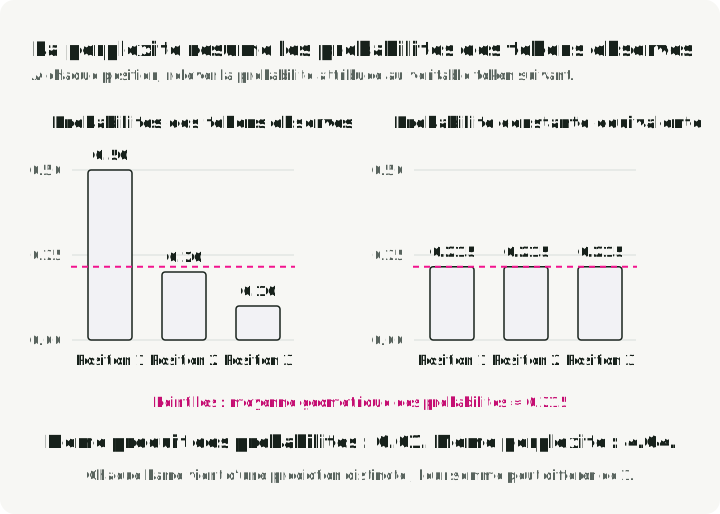
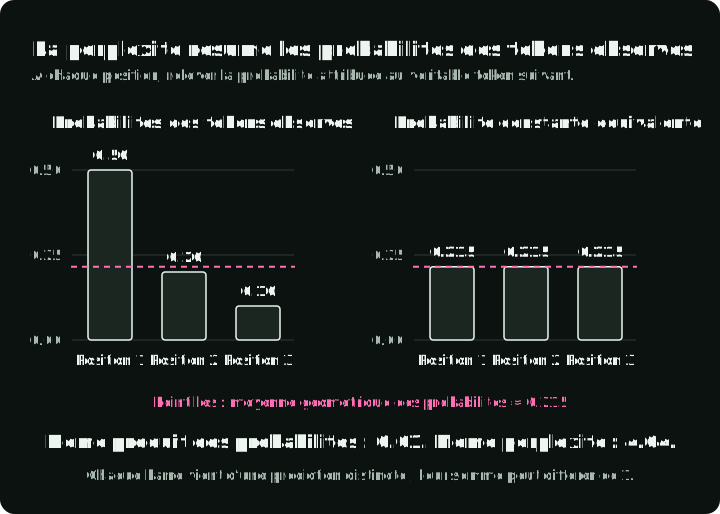
Une valeur plus basse est meilleure pour un même texte d’évaluation, un même tokenizer et une même procédure de contexte. Elle signifie que le modèle a attribué une probabilité plus élevée au texte observé, pas que ses réponses générées sont plus utiles ou correctes. Les tokenizers découpent le texte différemment, et la gestion de la fenêtre de contexte modifie les probabilités. Le guide de la perplexité de Hugging Face explique ces conditions de comparaison.
Grand O : comment le coût augmente avec la longueur de séquence
L’auto-attention transforme le vecteur courant de chaque token en une requête, une clé et une valeur à l’aide de matrices apprises. Une comparaison requête–clé évalue dans quelle mesure une position doit utiliser une autre. Ces scores deviennent des poids pour combiner les valeurs, comme dans la définition de l’attention du Transformer, §3.2.
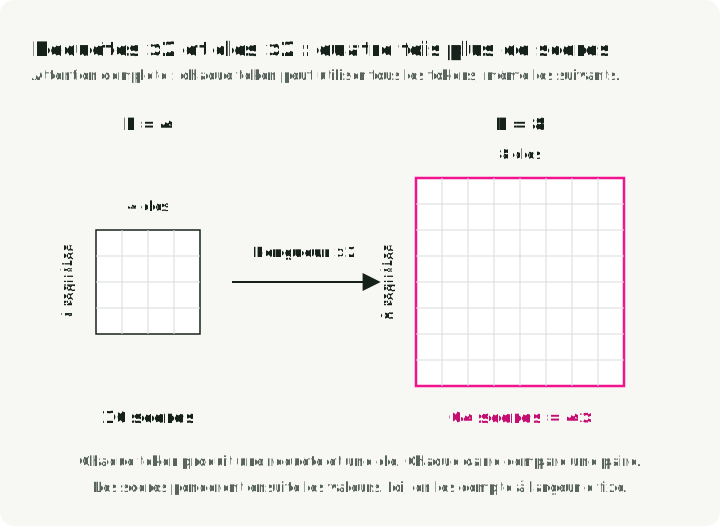
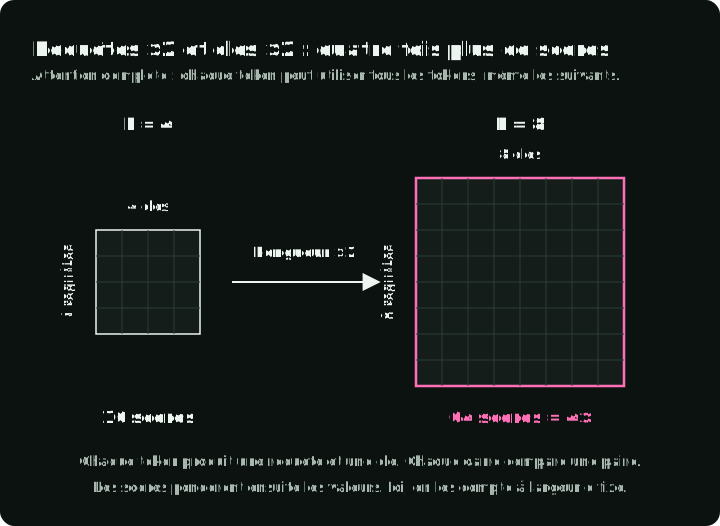
Pour une tête d’attention et tokens, comparer chaque requête à chaque clé produit une table de scores . Doubler la longueur de séquence quadruple la taille de cette table. Si chaque comparaison est un produit scalaire de longueur , le calcul des scores croît en . La notation grand O décrit une borne supérieure asymptotique ; elle omet les constantes et ne prédit pas à elle seule le temps d’exécution.
Les grilles montrent l’attention complète : chaque position peut utiliser toutes les positions. Une séquence plus longue ajoute à la fois des lignes de requêtes et des colonnes de clés. Chaque cellule représente un score ; des implémentations comme FlashAttention peuvent calculer les scores sans stocker toute la grille à la fois. L’attention causale exclut les positions futures, mais son nombre de paires autorisées croît toujours de façon quadratique.
Des modifications différentes de l’attention réduisent des coûts différents :
| Méthode | Ce qui change | Ce qui croît encore avec la séquence |
|---|---|---|
| FlashAttention | Calcule l’attention par blocs, sans table de scores complète dans la mémoire principale du GPU | Le calcul des scores reste quadratique |
| DSA | Une fonction de score moins coûteuse sélectionne jusqu’à tokens pour l’attention complète | La fonction compare toujours toutes les paires admissibles |
| MLA | Stocke moins de données d’attention par token mis en cache | La taille du cache croît toujours linéairement avec le nombre de tokens |
Ces économies ne sont pas des accélérations interchangeables. Vérifiez si l’article mesure les calculs, la mémoire allouée, les transferts mémoire ou la taille du cache. Vérifiez aussi s’il mesure le traitement du prompt ou la génération de tokens ; DeepSeek-V3.2, figure 3, présente ces phases séparément.
Lois d’échelle : des courbes ajustées avec un domaine de validité
Une loi d’échelle aide à répartir un budget d’entraînement entre un modèle plus grand et davantage de données. C’est une courbe ajustée à des expériences. Par exemple, DeepSeek LLM, §3.2, équation (4), donne :
est le calcul d’entraînement en opérations en virgule flottante. est le calcul par token hors embeddings, utilisé ici pour mesurer la taille du modèle ; ce n’est pas le nombre de paramètres. est le nombre de tokens d’entraînement. L’indice « opt » indique la répartition ajustée pour minimiser la perte de validation à ce budget. Les coefficients 0.1715 et 5.8316 sont propres à cet ajustement et à ces unités.
Les courbes ci-dessous divisent les répartitions ajustées par leurs valeurs à un budget de FLOPs : chaque coefficient ajusté s’annule donc. Un budget multiplié par 100 donne fois le calcul par token et fois les tokens. Ce sont les deux valeurs finales de la figure. Leurs facteurs se multiplient car l’article définit le calcul total par .
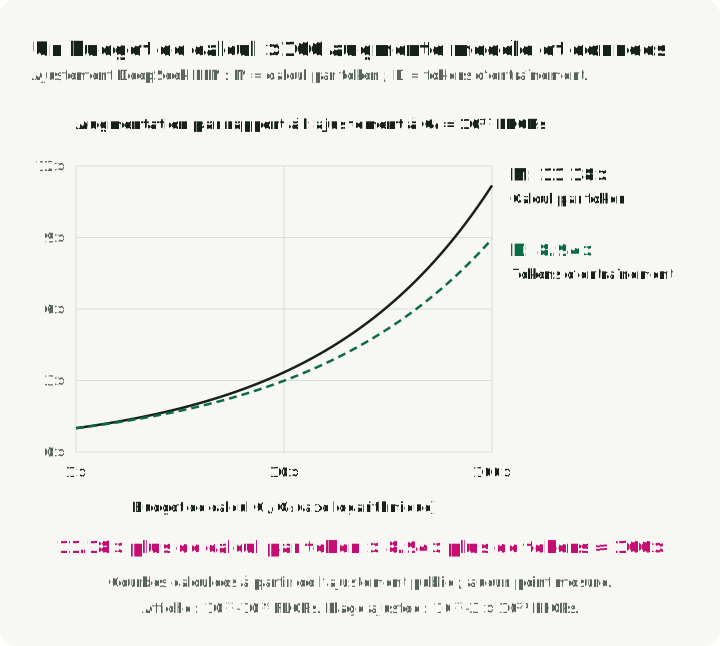
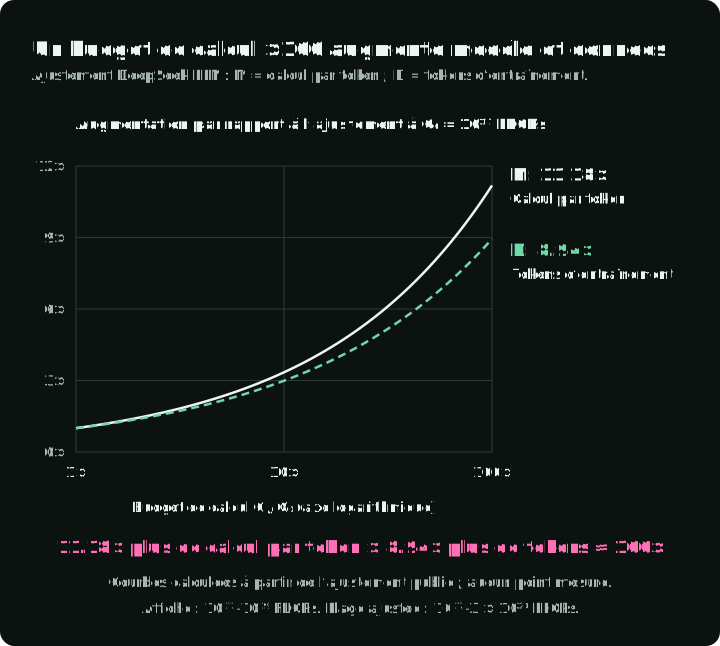
Cette conclusion est propre à ces expériences. L’ajustement couvre de à FLOPs. Hors de cette plage, c’est une extrapolation ; même à l’intérieur, d’autres données ou réglages d’entraînement peuvent modifier la meilleure répartition. La section 3.3 présente différents exposants pour différents datasets. La lecture détaillée des lois d’échelle explique les unités et vérifie comment les formules ajustées se combinent.
Lire une équation que cette série ne traite pas
Pour une autre équation, utilisez les six questions de la partie 1 : identifiez les objets, les opérations, les dimensions, l’échantillonnage, les quantités apprises et l’affirmation formulée.
Le dépôt paper-math-skills fournit des instructions pour qu’un agent rédige et vérifie une explication détaillée. Les lectures liées sont des exemples de ce résultat, avec des définitions de symboles et des vérifications numériques.
Sources et versions
Pour une introduction plus longue aux fondements, voir The Little Book of Generative AI Foundations de Tianhua Chen, §3.2 pour l’ELBO.