Guía de ingeniería de LLM: 45 conceptos para sistemas en producción

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta es una referencia para ingenieros que ya conocen los conceptos básicos de ML y de sistemas, y que necesitan relacionar un síntoma de producción con la parte del stack que lo explica. Cubre 45 conceptos de hardware, inferencia, entrenamiento, despliegue, aplicaciones y operaciones. Cada entrada explica el mecanismo, qué cambia en un sistema en funcionamiento y en qué condiciones se cumple el resultado citado. Si partes de un síntoma, como un primer token lento o un OOM bajo carga, usa la tabla de síntomas de más abajo para encontrar las entradas que debes leer.
Para una pregunta concreta, consulta las LLM engineering Fast Answers. Cada tema tiene su propia respuesta y enlaces a la sección correspondiente de esta guía.
| Parte | Temas | Secciones |
|---|---|---|
| I — Fundamentos del hardware | Modelo roofline, memoria de la GPU, glosario de hardware | 1–3 |
| II — Fundamentos de la inferencia | Latencia, throughput, KV cache, atención, cuantización | 4–9 |
| III — Optimizaciones de inferencia | CUDA kernels, FlashAttention, batching, PagedAttention, speculative decoding | 10–17 |
| IV — Arquitectura del modelo | Componentes internos del transformer, decoder-only, MoE, tokenización, ventanas de contexto | 18–22 |
| V — Entrenamiento y alineamiento | Pretraining, LoRA, precisión mixta, ZeRO, scaling laws, RLHF/DPO/GRPO, destilación | 23–32 |
| VI — Escalado y despliegue | Paralelismo, frameworks de serving, selección de GPU, routing | 33–36 |
| VII — Aplicaciones | Embeddings, RAG, agentes, prompt engineering | 37–40 |
| VIII — Operaciones en producción | Rate limiting, modos de fallo, monitorización, costes, planificación de capacidad | 41–45 |
Empieza por un síntoma
Cada fila indica las entradas que debes leer primero y qué medir antes de cambiar el stack.
| Síntoma o decisión | Empieza por | Mide antes de cambiar el stack |
|---|---|---|
| El primer token tarda | Prefill y decode, TTFT | Tiempo en cola, longitud del prompt, tiempo de prefill y TTFT P99 |
| Los tokens se emiten despacio | Roofline, TPOT | TPOT según la concurrencia, ancho de banda de memoria y forma del batch |
| Los contextos largos provocan preemption u OOM | KV cache, PagedAttention | Uso de KV, longitudes de las peticiones, desperdicio del allocator y número de preemptions |
| Un modelo no cabe en el presupuesto | Cuantización, Selección de GPU | Calidad, throughput del kernel, reserva de memoria y goodput con el SLO objetivo |
| Elegir un runtime de serving | Frameworks de serving, Paralelismo | Throughput y latencia P99 con el SLO objetivo, sobre tus propios prompts |
| Las peticiones agotan el tiempo bajo carga | Modos de fallo, Rate limiting | Profundidad de la cola, preemptions, tasa de reintentos y longitudes de salida |
| Un entrenamiento no cabe en memoria | LoRA y QLoRA, ZeRO, FSDP | Memoria del estado del modelo, comunicación, throughput y calidad en datos reservados |
| Los costes suben | Routing, optimización de costes | Tráfico apto, errores de calidad, tasa de aciertos de caché y datos de facturación |
Guías más profundas según la decisión
| Si estás decidiendo… | Empieza por | Después lee |
|---|---|---|
| Cómo servir muchos adaptadores fine-tuned | Fundamentos de la inferencia y despliegue | Guía de LoRAX Serving |
| Si cuantizar | Cuantización | Guía de cuantización de modelos |
| Cómo repartir un modelo entre GPUs | Paralelismo | Scaling Large Language Models |
| Si hacer fine-tuning | Entrenamiento y alineamiento | Guía de fine-tuning de LLM |
| Cómo encaja el retrieval en una aplicación | Embeddings y RAG | Métricas de evaluación de RAG |
| Cómo funcionan los sistemas de agentes | Agentes y prompt engineering | Bucles de razonamiento de agentes de AI |
| Cómo ordenar los resultados de búsqueda | Embeddings y reranking | Stack de ranking de búsqueda |
Parte I — Fundamentos del hardware
La intensidad aritmética, la jerarquía de memoria de la GPU y los términos de hardware de esta parte explican muchas de las decisiones que aparecen más adelante en la guía.
1. Limitado por memoria frente a limitado por cómputo y el modelo roofline
El punto de partida del rendimiento de los LLM es la intensidad aritmética: por cada byte de datos que la GPU carga desde la memoria, ¿cuántos cálculos útiles realiza? Esa proporción decide si una operación está limitada por cómputo (espera al procesador) o limitada por memoria (espera a que se carguen los datos).
Toda GPU tiene una «intensidad crítica», el umbral en el que su capacidad máxima de cómputo iguala a su ancho de banda de memoria. Para una NVIDIA H100 SXM con Tensor Cores densos en BF16 o FP16 (989 TFLOPS; la especificación de 1.979 TFLOPS supone sparsity estructurada):
El gráfico roofline de abajo muestra el cómputo alcanzable según la intensidad aritmética. La línea inclinada es la región limitada por memoria, donde el ancho de banda fija el límite; la línea horizontal es el throughput máximo de cómputo; la intersección marca el umbral de 295 FLOPs/byte.
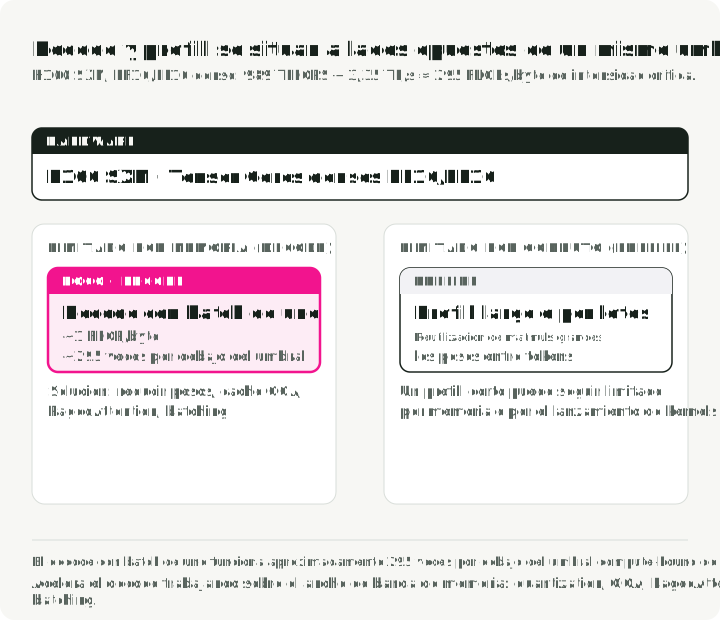
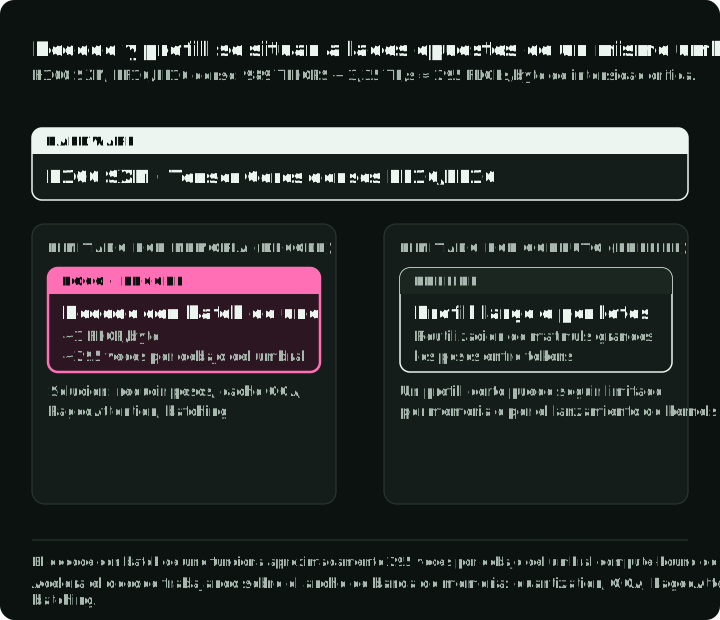
El decode con batch de uno y el prefill largo, o con batch suficiente, suelen quedar en lados opuestos de este umbral:
- El decode está limitado por memoria. Generar tokens de uno en uno obliga a cargar desde la memoria la matriz de pesos, de varios gigabytes, para multiplicarla por un único token nuevo. En un análisis simplificado con modelo denso en 16 bits y batch de uno, la operación tiene unos 1 FLOP/byte, aproximadamente 295 veces por debajo del umbral roofline de la H100. Esa diferencia explica por qué, en este régimen, el decode no puede acercarse al cómputo máximo.
- El prefill largo, o con batch suficiente, suele estar limitado por cómputo. Procesar muchos tokens del prompt reutiliza los pesos en multiplicaciones de matrices grandes, lo que puede llevar la intensidad aritmética por encima del umbral roofline. Los prompts cortos y los batches pequeños pueden, en cambio, verse limitados por el tráfico de memoria o por la sobrecarga de lanzar kernels.
Por tanto, para acelerar el decode hay que actuar sobre el ancho de banda de memoria: reducir los pesos con cuantización, reducir la sobrecarga de memoria del KV con GQA y PagedAttention, y aumentar la intensidad con batching. Para los prefills largos o bien agrupados en batches, pueden ayudar un cálculo matricial más rápido y un cómputo de menor precisión; las cargas con prefills cortos conviene perfilarlas aparte.
2. Jerarquía de memoria de la GPU
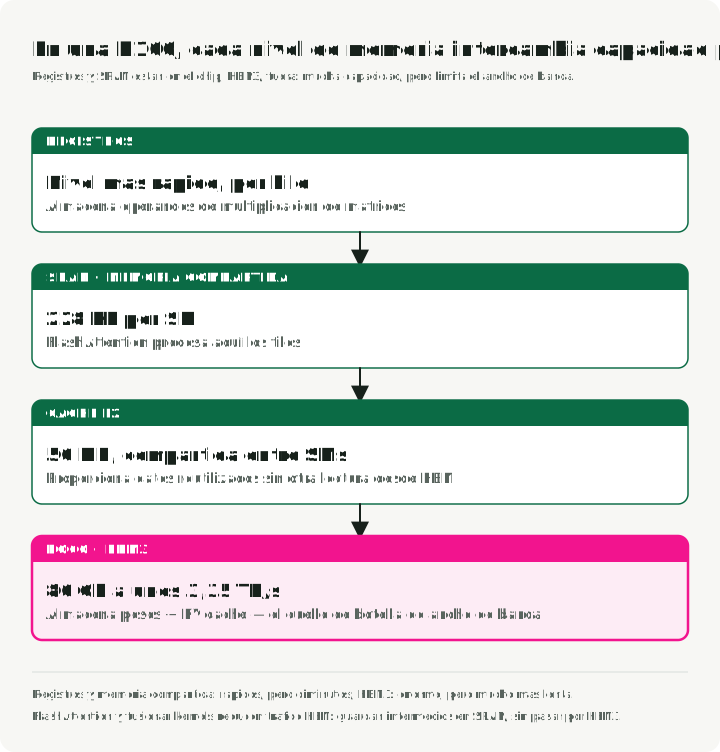
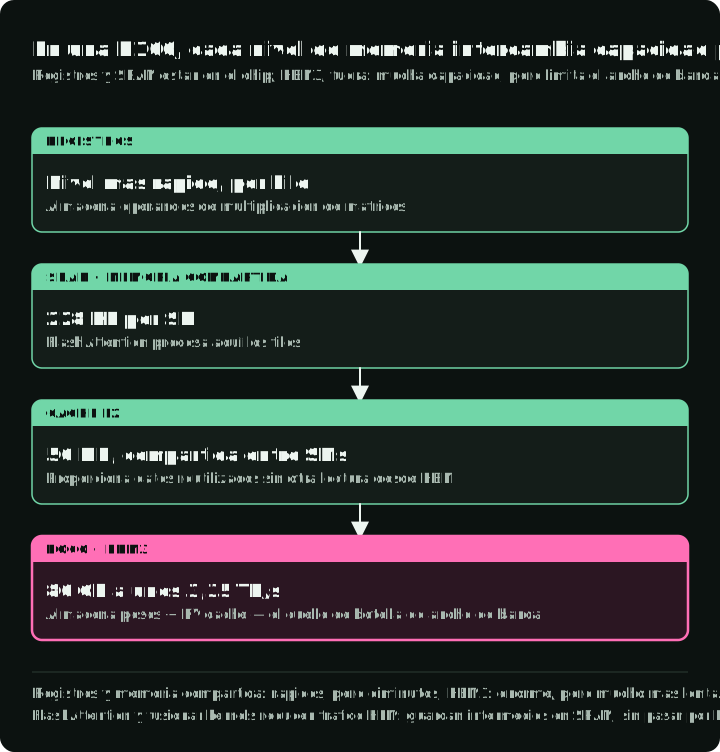
Una GPU tiene cuatro niveles de memoria con distintas capacidades y velocidades de acceso. Los registros son pequeños y rápidos; HBM almacena muchos más datos, pero acceder a ellos tarda más. Mover datos entre estos niveles es una limitación importante del rendimiento. La figura muestra una H100 SXM: registros y memoria compartida dentro de cada SM, L2 en el chip y 80 GB de HBM3 en pilas a su lado.
De la memoria más rápida a la más lenta en una H100 SXM:
- Los registros son la memoria más rápida y están unidos directamente a los hilos de procesamiento. En el WGMMA de Hopper, la matriz A puede venir de registros o de la memoria compartida, mientras que la matriz B viene de la memoria compartida.
- La SRAM (memoria compartida) es una memoria de trabajo rápida, dentro del chip y local a cada SM.
- La caché L2 es una capa compartida de 50 MB. Puede servir datos reutilizados entre SMs sin otra lectura de HBM.
- La HBM3 es la memoria principal de 80 GB que guarda los pesos del modelo y el KV cache, con un ancho de banda de ~3,35 TB/s.
La brecha entre los niveles dentro y fuera del chip es grande. En una A100, el artículo de FlashAttention estima el ancho de banda de la SRAM del chip en unos 19 TB/s, frente a 1,5–2,0 TB/s de la HBM (Dao et al., 2022), una diferencia de aproximadamente 10 veces. FlashAttention y la fusión de kernels reducen el tráfico a HBM al conservar o combinar el trabajo intermedio dentro del chip. PagedAttention ataca otro problema: asigna bloques lógicos de KV a bloques físicos no contiguos de la memoria de la GPU, lo que reduce la fragmentación y permite compartir bloques.
3. Glosario de hardware de GPU
Los términos siguientes aparecen a lo largo del resto de la guía.
HBM (High Bandwidth Memory) apila dies de DRAM conectados mediante through-silicon vias (TSV) junto al die de la GPU. Entre sus generaciones están HBM2e (A100, 2 TB/s), HBM3 (H100, 3,35 TB/s) y HBM3e (H200/B200, 4,8–8 TB/s). El ancho de banda de la HBM limita directamente el TPOT en los regímenes de decode limitados por memoria.
GDDR (Graphics DDR) es la memoria gráfica tradicional de GPUs de consumo y de estaciones de trabajo como la RTX 4090 y la L40S. Estas tarjetas tienen menos ancho de banda de memoria que la H100 SXM. La GDDR6X de la RTX 4090 ofrece 1.008 GB/s según el informe de arquitectura Ada de NVIDIA, frente a los 3,35 TB/s de la HBM3 de la H100 SXM.
Un SM (Streaming Multiprocessor) es el bloque básico de cómputo de una GPU NVIDIA. Cada SM contiene CUDA cores, Tensor Cores, memoria compartida y un planificador de warps. La H100 SXM tiene 132 SMs; la H100 PCIe tiene 114. La A100 tiene 108.
Los Tensor Cores son unidades especializadas de multiplicación y acumulación de matrices dentro de cada SM. Aceleran los matmuls de precisión mixta que dominan el cálculo del transformer. Los Tensor Cores de la H100 SXM ofrecen 494,5 TFLOPS TF32 densos o 989 con sparsity; al comparar esta cifra, indica siempre la precisión y el modo de sparsity.
Los CUDA Cores son unidades de propósito general de coma flotante y enteros. Se encargan de las operaciones elemento a elemento, las funciones de activación y el resto del trabajo no matricial mientras los Tensor Cores ejecutan las operaciones matriciales compatibles.
Un warp es un grupo de 32 hilos en un SM. Los hilos pueden seguir rutas distintas, y las GPUs Volta y posteriores permiten la planificación independiente de hilos. La especialización de warps asigna el movimiento de datos y el cómputo a warps distintos para que las tareas puedan solaparse.
NVLink es la interconexión de alta velocidad de NVIDIA entre GPUs dentro de un nodo. NVLink 4.0 en la H100 ofrece 900 GB/s de ancho de banda bidireccional; NVLink 5.0 en la B200 llega a 1,8 TB/s. Este ancho de banda importa para el paralelismo tensorial porque las GPUs intercambian resultados parciales en cada capa del transformer.
InfiniBand es una red de alta velocidad para la comunicación entre nodos. Los adaptadores InfiniBand de la clase ConnectX aportan la red entre nodos para el tráfico de paralelismo de pipeline o de entrenamiento distribuido; el ancho de banda depende del adaptador y de la configuración de los puertos.
RDMA (Remote Direct Memory Access) permite que un dispositivo acceda a la memoria de otra máquina sin que la ruta de datos pase por ninguna de las dos CPUs. GPUDirect RDMA admite transferencias directas de GPU a GPU entre nodos, incluidas las transferencias de KV cache en el serving desagregado.
NVMe (Non-Volatile Memory Express) es la interfaz de SSD que se usa para descargar el KV cache y para descargar parámetros con ZeRO-Infinity cuando la memoria de la GPU y de la CPU no bastan. El ancho de banda secuencial depende de la unidad y de la carga de trabajo, y sigue estando muy por debajo del ancho de banda de la HBM.
TFLOPS y PFLOPS son billones y mil billones de operaciones de coma flotante por segundo. Un TFLOPS equivale a FLOPS. La H100 alcanza 989 TFLOPS tensoriales TF32 con sparsity, mientras que FlashAttention-3 indica cerca de 1,2 PFLOPS en FP8; esos valores usan formatos distintos y no deben compararse como si fueran una sola métrica.
Parte II — Fundamentos de la inferencia
La inferencia convierte un modelo en un servicio visible para el usuario. Los conceptos siguientes separan el trabajo que retrasa el primer token del que ralentiza todos los tokens posteriores, y dejan ver los límites de memoria que hay detrás de ambos.
4. Latencia: TTFT, TPOT y percentiles
Time to First Token (TTFT) es el retraso de extremo a extremo desde que se envía la petición hasta el primer token de salida. Incluye la cola, la tokenización, la planificación, el paso de prefill que produce el primer token y la entrega por red. Los motores de serving habituales muestrean el primer token de salida a partir de los logits del forward pass del prefill, así que no se ejecuta un paso de decode aparte antes de él. Los prompts más largos suelen aumentar el componente de prefill, pero cualquiera de estas etapas puede dominar. Los objetivos dependen del producto; MLPerf Inference v5.0 usa un límite de TTFT P99 de 450 ms en su escenario interactivo de Llama 2 70B.
Time Per Output Token (TPOT) es el intervalo medio entre tokens consecutivos después del primero. Corresponde a la fase de decode. El decode con batch de uno o de baja intensidad suele estar limitado por el ancho de banda de memoria, mientras que los batches suficientemente grandes pueden pasar a estar limitados por cómputo:
Esta definición requiere al menos dos tokens de salida; TPOT no está definido para una respuesta de un solo token. En esta ecuación, la latencia E2E termina en el último token de salida. Un temporizador hasta la finalización HTTP puede incluir metadatos posteriores o el cierre de la conexión; registra ese tiempo por separado.
Una estimación de la velocidad de lectura en inglés ofrece una referencia aproximada para el streaming. La velocidad media de lectura silenciosa de adultos para textos de no ficción en inglés es de unas 238 palabras por minuto (Brysbaert, 2019), unas 4 palabras por segundo. Si un token equivale de media a tres cuartos de palabra, son unos 5 tokens por segundo o 200 ms por token. Esta estimación no es un umbral de usabilidad: el idioma, el tokenizador, la tarea y el buffering del cliente cambian el resultado. El escenario interactivo de MLPerf usa un límite de TPOT P99 mucho más estricto, de 40 ms. Fija tu propio objetivo mediante pruebas de producto.
P50 frente a P99. La latencia P99 importa porque la mediana oculta la cola. Un sistema con un buen P50 y un mal P99 puede tener problemas de batching, preemption, colas o desequilibrio en la carga de trabajo; hacen falta trazas para distinguirlos.
5. Throughput: tokens por segundo y el compromiso con la latencia
El throughput se mide en tokens de salida por segundo entre peticiones concurrentes. Las peticiones por segundo son una medida más débil por sí solas, porque una respuesta de 10 tokens y una de 1.000 tokens tienen costes muy distintos. Las cifras publicadas en benchmarks varían con el modelo, la precisión, el hardware, las longitudes del prompt y de la salida, la concurrencia y el SLO. Compara vLLM, SGLang y TensorRT-LLM con un mismo harness, en lugar de combinar sus resultados destacados.
Aumentar un lote pequeño de decodificación puede elevar el throughput al compartir las lecturas de pesos. Los lotes mayores o una carga ofrecida más alta acaban aumentando la latencia o alcanzando límites de memoria, cómputo o comunicación. Mide esa curva en lugar de suponer un escalado lineal. Goodput, la tasa de solicitudes por segundo que cumplen tus objetivos SLO, relaciona el throughput bruto con lo que experimentan los usuarios.
6. KV cache: memoria que crece con cada token
Durante la generación autorregresiva con atención completa, cada token nuevo atiende al token actual y a los anteriores. El KV cache almacena las proyecciones Key y Value para que la generación no recalcule las proyecciones de tokens anteriores en cada paso. La decodificación con atención completa sigue leyendo un historial creciente; el trabajo total de atención sobre una secuencia generada sigue siendo cuadrático respecto a su longitud.
En un cache MHA o GQA convencional con atención completa, la memoria crece linealmente con la longitud de la secuencia, el tamaño del lote y el número de capas. La siguiente fórmula no se aplica sin cambios a arquitecturas MLA, de ventana deslizante, recurrentes o híbridas:
donde:
- = número de capas
- = número de cabezas KV
- = dimensión de la cabeza
- = longitud de la secuencia
- = tamaño del batch
- = bytes por elemento en caché, determinados por la precisión del KV cache
Ejemplos concretos con FP16 y un lote de tamaño 1: Llama 3.1 8B con 8.192 tokens usa ~1,07 GB (1 GiB) de KV cache; con 128K tokens, 16 GiB. Llama 3.1 70B con 128K tokens necesita 40 GiB (unos 43 GB) para una sola secuencia, aproximadamente la mitad de los 80 GB de una H100. Con alta concurrencia o contextos largos, el KV cache puede superar la memoria de los pesos del modelo; el resultado depende de la longitud de la secuencia, el tamaño del lote activo, la precisión KV y el número de cabezas KV. La evaluación original de vLLM de 2023 informó de un 60–80 % de desperdicio por fragmentación y preasignación en los sistemas que comparó.
Las principales optimizaciones son GQA (menos cabezas KV), la cuantización del KV cache (FP8/INT8), PagedAttention (asignación por bloques) y la descarga de datos KV reutilizables a CPU o NVMe. Sus beneficios dependen de la carga de trabajo y de la implementación.
Para saber cuántas secuencias caben en tu presupuesto KV con otro modelo, lee tres valores de su config.json: num_hidden_layers, num_key_value_heads y head_dim cuando exista. En los ejemplos de Llama, la dimensión de la cabeza es hidden_size / num_attention_heads. La memoria por dispositivo también depende del sharding del cache y de cualquier replicación de cabezas KV. La función de abajo aplica la fórmula; los asserts reproducen las cifras anteriores y el ejemplo de capacidad de la Sección 45.
def kv_cache_bytes(layers, kv_heads, head_dim, seq_len, batch=1, bytes_per_elem=2):
    """Bytes of KV cache: a key and a value per layer, KV head, and token."""
    return 2 * layers * kv_heads * head_dim * seq_len * batch * bytes_per_elem

GiB = 2**30

# Llama 3.1 8B: 32 layers, 8 KV heads, head dimension 128, FP16 cache.
llama_8b = kv_cache_bytes(32, 8, 128, seq_len=8_192)
print(f"8B at 8K tokens: {llama_8b / 1e9:.2f} GB")  # 1.07 GB
assert llama_8b == 1 * GiB

# Llama 3.1 70B: 80 layers, 8 KV heads, head dimension 128.
assert kv_cache_bytes(80, 8, 128, seq_len=131_072) == 40 * GiB

# How many 4K-token sequences fit in a 40 GiB KV budget?
per_4k = kv_cache_bytes(80, 8, 128, seq_len=4_096)
print(f"70B at 4K tokens: {per_4k / GiB:.2f} GiB per sequence")  # 1.25 GiB
print("4K sequences in 40 GiB:", 40 * GiB // per_4k)  # 32
assert 40 * GiB // per_4k == 32

# An FP8 KV cache halves the size per sequence and doubles the count.
assert 40 * GiB // kv_cache_bytes(80, 8, 128, 4_096, bytes_per_elem=1) == 64
El resultado es un límite superior. El runtime también necesita memoria para las activaciones, la sobrecarga del allocator y un margen para la variación en la longitud de las peticiones.
7. Prefill frente a decode: dos fases, dos cuellos de botella
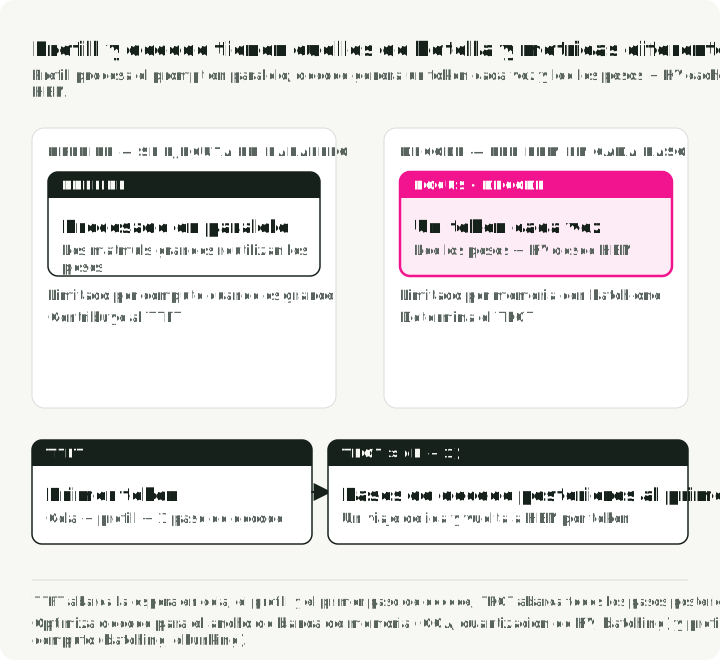
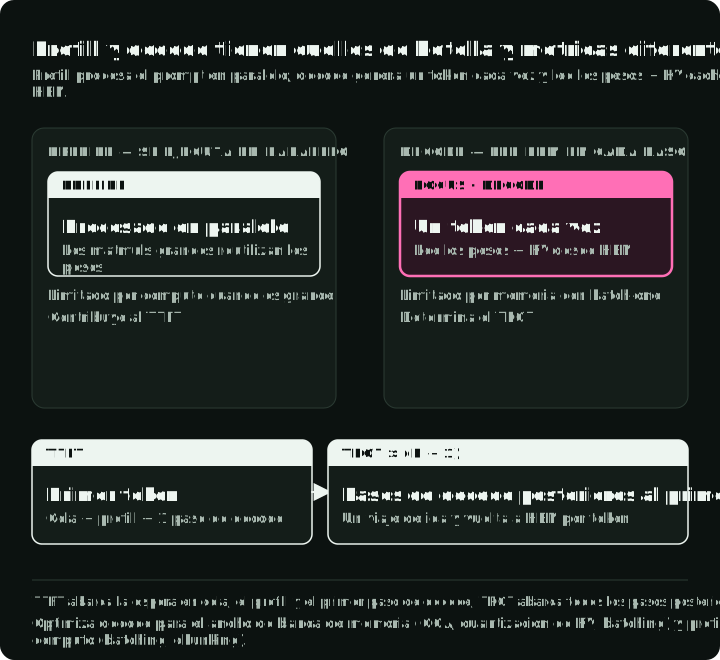
La fase de prefill procesa el prompt de entrada en paralelo y rellena el KV cache. Los prefills largos, o con batch suficiente, suelen quedar limitados por cómputo porque usan multiplicaciones de matrices grandes; los prefills cortos pueden seguir limitados por el tráfico de memoria o por la sobrecarga de lanzar kernels. El prefill contribuye al time to first token (TTFT), junto con la cola, la tokenización, la planificación y la entrega por red; su forward pass también produce el primer token de salida. La fase de decode genera un token cada vez. Cada paso lee los pesos del modelo y el KV cache desde la HBM, de modo que el decode con batch de uno queda limitado por el ancho de banda de memoria y es el principal factor del tiempo por token de salida (TPOT).
La figura sigue una solicitud: el prefill reutiliza los pesos entre los tokens del prompt y termina con el primer token, dentro del TTFT; cada paso posterior de decodificación vuelve a leer los pesos y el KV cache para un token y contribuye al TPOT.
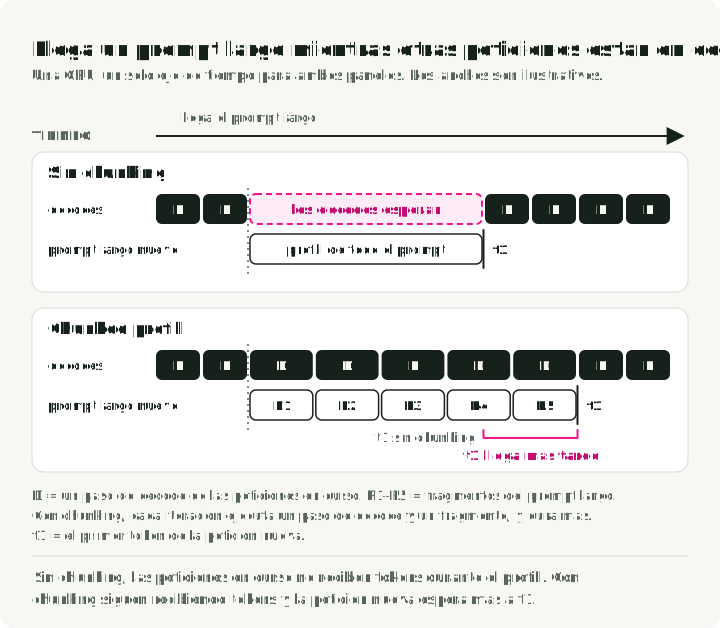
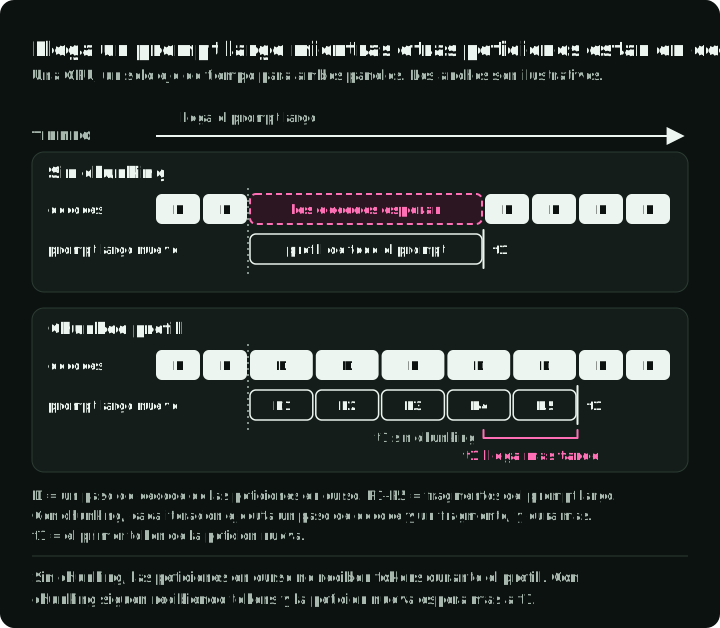
El chunked prefill divide un prompt largo en fragmentos y los programa junto a los decodes en curso. El tamaño real de los fragmentos puede variar según el presupuesto de tokens disponible en la iteración. En Sarathi-Serve (sección 4.2) y en vLLM, el planificador mete primero los decodes en curso en el batch y llena el resto de un presupuesto de tokens por iteración con tokens de prefill. Así, un prompt largo ya no impide que las demás peticiones reciban tokens. La petición nueva paga el precio: su prefill abarca varias iteraciones y cada fragmento vuelve a leer el KV cache de los fragmentos anteriores. Sarathi-Serve midió aproximadamente un 25 % más de tiempo de prefill para Yi-34B con paralelismo tensorial de dos y fragmentos de 512 tokens (sección 5.4.1), y la documentación de vLLM indica que un presupuesto de tokens menor da mejor latencia entre tokens y peor TTFT. Sarathi-Serve informa de mejores compromisos entre throughput y latencia en las cargas que probó, pero la mejora depende del modelo, del hardware, de la distribución de longitudes de las peticiones, del tamaño del fragmento y de la referencia con la que se compare.
El serving desagregado coloca el prefill y el decode en pools de GPUs distintos, de modo que cada pool pueda atacar un cuello de botella diferente. Splitwise y DistServe describen el patrón. El pool de prefill envía el KV cache de cada petición al pool de decode. DistServe usa NVLink dentro de un nodo e InfiniBand entre nodos; Splitwise usa InfiniBand, que admite RDMA. El coste de la transferencia pasa a formar parte del diseño.
La figura pone ambas planificaciones en un mismo eje de tiempo: llega un prompt largo mientras otras peticiones están en decode. El chunking mantiene los tokens de las demás peticiones y retrasa el primer token de la petición nueva.
8. GQA y MQA: reducir el KV cache
La Multi-Head Attention (MHA) estándar da a cada cabeza de query sus propias cabezas K y V. La Multi-Query Attention (MQA) comparte una única cabeza KV entre todas las cabezas de query, lo que es una reducción extrema. La Grouped-Query Attention (GQA) es el término medio práctico: grupos de cabezas de query comparten una cabeza KV. La figura dibuja ocho cabezas de query y las cabezas KV que conserva cada variante; el KV cache se reduce en proporción al número de cabezas KV.
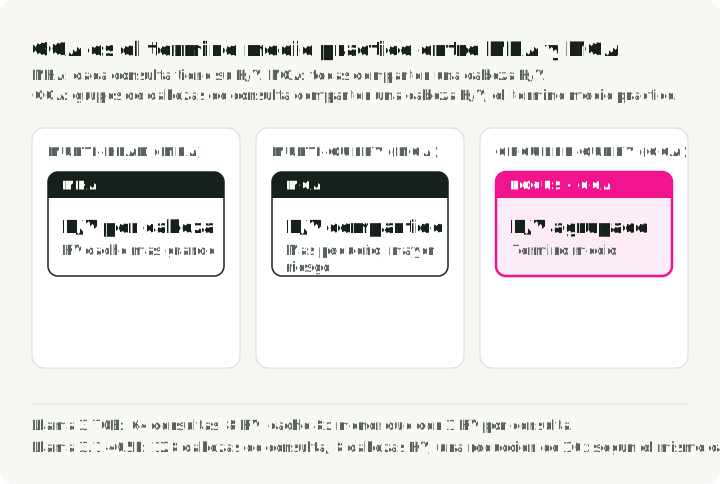
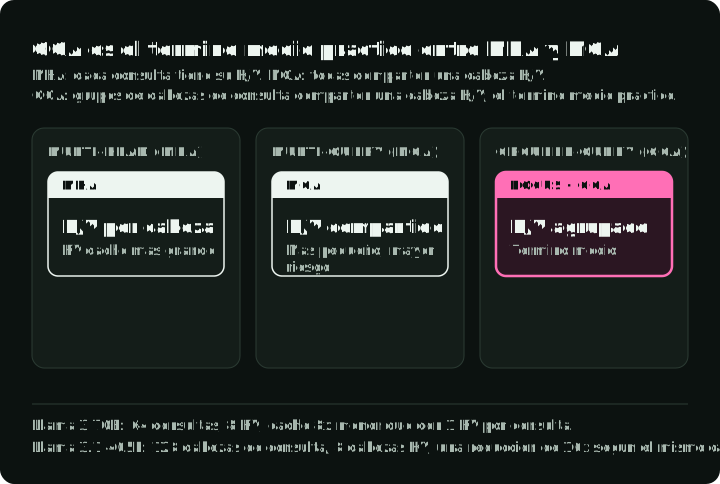
Llama 3 70B usa 64 cabezas de query pero solo 8 cabezas KV, una reducción de 8 veces del KV cache respecto a la misma arquitectura con una cabeza KV por cabeza de query. Llama 3.1 405B usa 128 cabezas de query y 8 cabezas KV, una reducción de 16 veces con el mismo cálculo (Meta, 2024). Ainslie et al. informan de una calidad de GQA cercana a la de MHA en los modelos que probaron, con una velocidad próxima a la de MQA. Un KV cache menor permite batches más grandes, pero la mejora real de latencia y throughput sigue dependiendo del kernel y de la carga de trabajo.
9. Cuantización: intercambiar bits por velocidad y memoria
La cuantización reduce la precisión de los pesos del modelo o de las activaciones, o de ambos. Los compromisos principales:
| Formato | Bits | Memoria de pesos (modelo de 7B) | Nota de calidad |
|---|---|---|---|
| FP16/BF16 | 16 | ~14 GB | Referencia para comparar |
| FP8 | 8 | ~7 GB | Nativo en Hopper; evalúa el modelo |
| INT8 | 8 | ~7 GB | Depende de la calibración y del kernel |
| INT4 | 4 | ~3,5 GB | Mayor compresión; evalúa con cuidado |
AWQ (Activation-Aware Weight Quantization) identifica los canales de pesos relevantes a partir de la magnitud de las activaciones y aplica un escalado por canal para protegerlos. Sus necesidades de calibración dependen del modelo y de la configuración; en una comparación con OPT-6.7B en INT3-g128, AWQ usó 16 secuencias de calibración mientras que GPTQ usó 192. En una configuración reproducible, indica tanto el número de secuencias como su longitud. GPTQ usa información aproximada de segundo orden para cuantizar capa a capa. bitsandbytes puede cuantizar durante la carga del modelo sin un paso de preprocesamiento aparte; su formato NF4 es la base del fine-tuning con QLoRA. FP8 en hardware de clase Hopper reduce a la mitad la memoria de los pesos respecto a FP16/BF16, pero la calidad y la velocidad siguen dependiendo del modelo, de la calibración y del kernel.
La tabla asigna a cada método el trabajo para el que suele ser adecuado. La guía de cuantización de modelos trata cada método en profundidad.
| Método | Datos de calibración | Uso habitual |
|---|---|---|
| AWQ o GPTQ (INT4 solo pesos) | Sí, una muestra pequeña | Servir un modelo grande en GPUs con poca memoria mediante un kernel INT4 compatible |
| bitsandbytes NF4 | No | Fine-tuning con QLoRA y experimentos rápidos |
| FP8 | Muestra pequeña o escalado dinámico | Servir en GPUs Hopper o posteriores, con una comprobación de calidad en la tarea objetivo |
| INT8 (W8A8) | Sí, para las escalas de activación | GPUs sin FP8, como A100 o A10G, cuando el kernel de serving lo admite |
El kernel de serving puede importar tanto como el algoritmo de cuantización. La Sección 10 da un resultado acotado de Marlin y explica por qué la mejora depende de la configuración de serving.
Parte III — Optimizaciones de inferencia
Las optimizaciones de esta parte resuelven restricciones distintas. FlashAttention reduce el tráfico de HBM de la atención; PagedAttention mejora la asignación del KV; el continuous batching evita que las secuencias terminadas sigan ocupando capacidad del batch.
10. CUDA kernels y fusión de kernels
Un CUDA kernel es una función escrita para la GPU que se ejecuta en paralelo en miles de hilos. Cuando la CPU llama a un kernel, la GPU distribuye el trabajo entre sus SMs: cada SM ejecuta varios warps de 32 hilos, y cada hilo procesa una parte de los datos. Una implementación de serving con CUDA ejecuta el trabajo de la GPU mediante kernels. El número de lanzamientos depende del grafo del modelo, del compilador, del runtime y de la fusión. La implementación del kernel puede determinar si el sistema cumple su SLO de latencia.
Las categorías principales de kernels en el serving de LLM:
- Kernels GEMM para la multiplicación de matrices, que dominan el cómputo tanto del prefill como del decode.
- Kernels de atención, como FlashAttention, que dividen los cálculos en bloques para quedarse en SRAM en lugar de volcarse a la HBM.
- Kernels fusionados que combinan varias operaciones (como suma + layer norm o la proyección QKV) en un solo lanzamiento para evitar los viajes intermedios a la HBM.
- Kernels de muestreo que convierten los logits en IDs de token mediante muestreo top-k, top-p o por temperatura.
La calidad del kernel puede determinar si los pesos comprimidos se traducen en una aceleración. El artículo de Marlin informa de hasta 2,8 veces de aceleración de extremo a extremo sobre su referencia en FP16 en las configuraciones de vLLM con INT4 solo de pesos que probó. Ese resultado es específico de los modelos, las GPUs, los tamaños de batch y la configuración de serving del artículo, así que no es una ganancia universal de INT4.
Triton reduce la barrera para escribir kernels propios al exponer la programación de GPU mediante Python en lugar de CUDA C++ puro, lo que pone la optimización a nivel de kernel al alcance de los ingenieros de ML y no solo de los especialistas en GPU. La mayoría de las optimizaciones que siguen en esta parte (FlashAttention, kernels fusionados, PagedAttention) son o bien mejores kernels o bien formas más inteligentes de orquestar los lanzamientos de kernels.
La fusión de kernels combina operaciones consecutivas en un solo kernel de GPU y evita escrituras intermedias en HBM. Las fusiones habituales incluyen la proyección QKV, atención más softmax y suma residual más RMSNorm. FlashNorm, en cambio, combina el escalado de RMSNorm con la proyección lineal siguiente y aplaza la normalización. DeepFusionKernel fusiona un MLP SwiGLU completo, incluidas sus multiplicaciones de matrices. Las mejoras exactas en lanzamientos y utilización dependen del grafo del modelo, del compilador, de la GPU y del framework de serving, así que mide el stack desplegado en lugar de confiar en un porcentaje universal.
11. FlashAttention: dividir la atención en bloques para permanecer en SRAM
La atención estándar materializa la matriz de atención completa de en la HBM, lo que cuesta de memoria y genera mucho tráfico de memoria. La idea de FlashAttention es no materializar nunca esa matriz. Divide las matrices Q, K y V en bloques que caben en SRAM, calcula la atención parcial dentro de cada bloque y combina los resultados con un softmax online (que va siguiendo de forma incremental el máximo y la suma acumulados entre bloques). El almacenamiento intermedio baja de a , con menos lecturas y escrituras en HBM en las formas probadas en el artículo. El cómputo de atención densa sigue siendo cuadrático respecto a la longitud de la secuencia.
Cada versión ataca el cuello de botella de la generación de GPU para la que se diseñó:
- FlashAttention v1 (A100, 2022) demostró que la idea de dividir en bloques con softmax online funciona. El artículo informó de una aceleración de 2–4 veces sobre la atención estándar, pero de solo un 25–40 % de utilización de la GPU. El artículo de FA2 lo atribuye al trabajo distinto de matmul, a la comunicación en memoria compartida y al paralelismo limitado.
- FlashAttention v2 (A100, 2023) rehízo el paralelismo para repartir el trabajo por la dimensión de la secuencia además de por batch y cabezas. Alcanzó un 50–73 % de utilización en A100, aproximadamente 2 veces más rápido que v1.
- FlashAttention v3 (H100 Hopper, 2024) añadió la especialización de warps (warps separados para el movimiento de datos y para las operaciones matemáticas) y el pipelining de GEMM y softmax para solapar las cargas de memoria con el cómputo. El artículo informa de hasta 740 TFLOPS en FP16 (75 % de utilización) y cerca de 1,2 PFLOPS en FP8 en H100.
- FlashAttention v4 (B200 Blackwell, 2026) ataca un cuello de botella nuevo: en Blackwell, la capacidad de los tensor cores crece tan deprisa que las operaciones que no son matmul (exponenciales del softmax, reescalado) pasan a ser el límite. FA4 emula por software la exponencial con aproximaciones polinómicas en unidades FMA, usa reescalado condicional para reducir la sobrecarga y guarda los resultados intermedios en la memoria tensorial dedicada de Blackwell (TMEM) en lugar de en registros. El artículo informa de cerca de 1,6 PFLOPS en B200 con BF16, 1,3 veces más rápido que cuDNN 9.13 y 2,7 veces más rápido que Triton en sus pruebas.
12. FlashDecoding: paralelizar el cuello de botella del decode
FlashAttention estándar mantiene ocupada la GPU repartiendo el trabajo por tamaño de batch y longitud de query. Durante el decode, el modelo genera exactamente 1 token cada vez (longitud de query = 1). Cuando el tamaño del batch multiplicado por el número de cabezas de atención queda muy por debajo del número de SMs de la GPU (108 en una A100), muchos SMs pueden quedar ociosos mientras los activos procesan el historial de tokens.
FlashDecoding lo resuelve añadiendo una nueva dimensión de paralelización: la propia longitud de la secuencia de KV. Trocea el KV cache en fragmentos más pequeños y los reparte entre todos los procesadores de la GPU que de otro modo estarían ociosos, para evaluarlos en paralelo, y luego combina sus cálculos parciales con una reducción log-sum-exp.
En el benchmark de Stanford con CodeLlama-34B y batch de uno, en cuatro GPUs A100 y con longitudes de secuencia de 512 a 64K tokens, FlashDecoding alcanzó hasta 8 veces de aceleración de extremo a extremo sobre las referencias probadas y mejoró el escalado de la atención en los contextos largos probados. El resultado está acotado a ese hardware y a ese benchmark, y no es una garantía general para el decode.
13. Continuous batching frente a static batching
El static batching espera a que terminen todas las secuencias de un batch antes de empezar el siguiente, de modo que las secuencias cortas desperdician ciclos de GPU en espera una vez que llegan al final de secuencia. El continuous batching (introducido por el artículo de Orca, OSDI 2022) opera con granularidad de iteración: en cada paso de decode se retiran las secuencias completadas y se insertan otras nuevas. La figura muestra cuatro slots de batch a lo largo de diez pasos de decode con cada política.
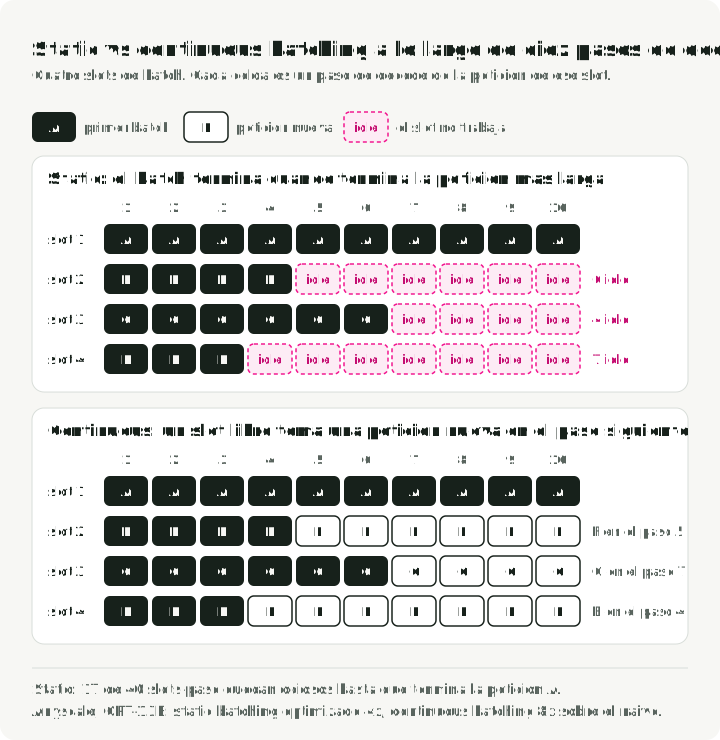
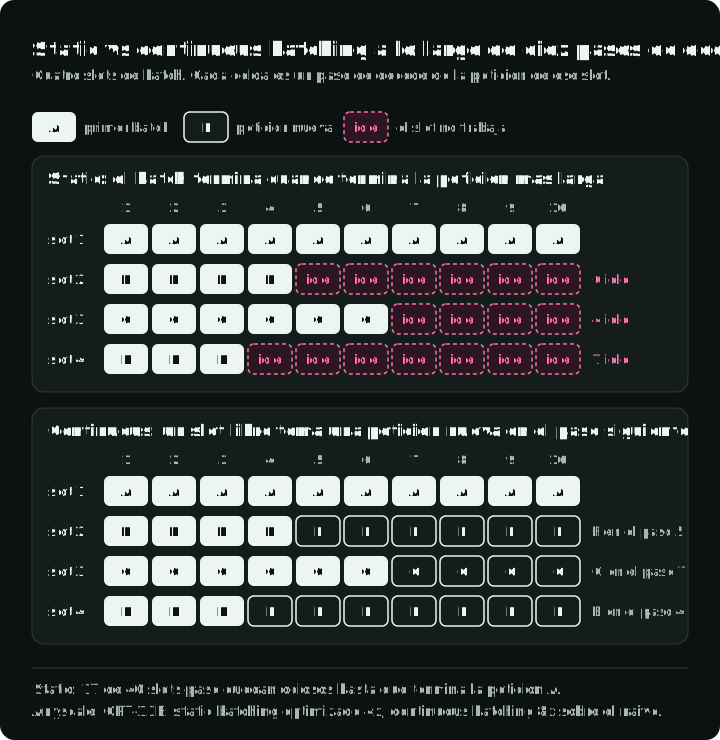
En el benchmark de Anyscale de 2023 con OPT-13B en una A100-40GB, con 1.000 peticiones, prompts de 512 tokens y salidas de 128 tokens de media, el static batching optimizado alcanzó 4 veces su referencia ingenua, el continuous batching alcanzó 8 veces, y vLLM con continuous batching más PagedAttention alcanzó 23 veces (Anyscale, 2023). El continuous batching también aumenta la presión sobre la asignación de KV, por eso suele combinarse con una gestión de memoria paginada.
14. PagedAttention: memoria virtual para el KV cache
PagedAttention de vLLM aplica la idea de memoria virtual de los sistemas operativos a la gestión del KV cache. El KV cache se divide en bloques de tamaño fijo (16 tokens en esta ilustración; el tamaño de bloque varía según el runtime), los bloques se asignan bajo demanda a medida que se generan tokens, y las posiciones lógicas (secuenciales) se asignan a ubicaciones físicas (dispersas) de la memoria mediante tablas de bloques. Varias peticiones que comparten un prefijo (system prompts, beam search) pueden apuntar a los mismos bloques físicos. Reutilizar prefijos también requiere claves de cache compatibles y una política de búsqueda en el cache. La figura muestra una tabla de bloques para dos peticiones que comparten un system prompt.
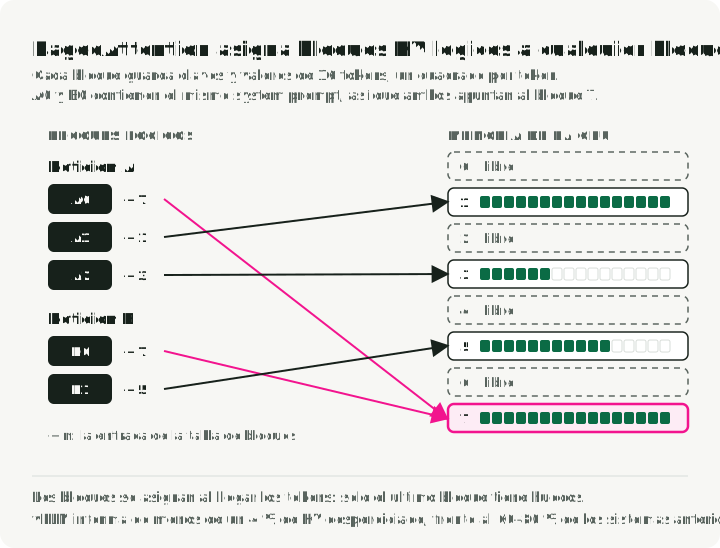
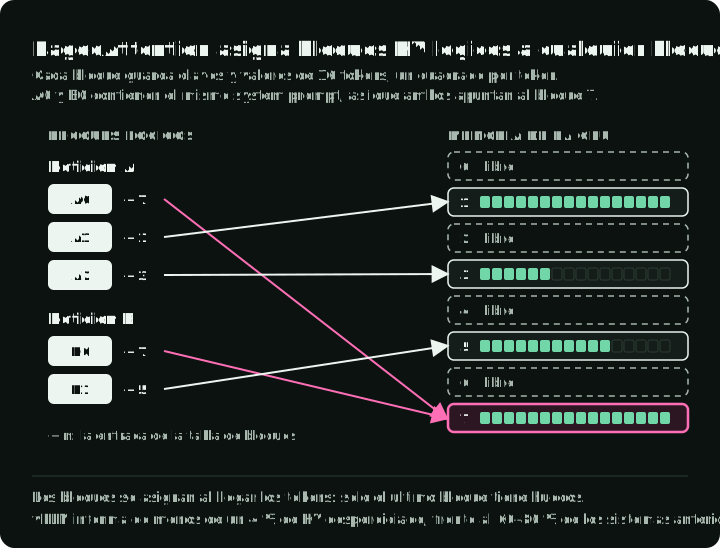
La evaluación de vLLM de junio de 2023 informó de un 60–80 % de desperdicio de memoria KV en los sistemas anteriores que probó y de menos del 4 % con su asignador paginado. Informó de un throughput 2–4 veces mayor que TGI y hasta 24 veces mayor que Hugging Face Transformers en cargas seleccionadas. Son comparaciones históricas de extremo a extremo entre sistemas de serving, no una aceleración ni un límite de desperdicio universal de PagedAttention. Un último bloque parcialmente lleno puede desperdiciar una proporción mayor en secuencias cortas.
15. Speculative decoding: varios tokens por forward pass
En el speculative decoding, un modelo draft pequeño genera tokens candidatos y después el modelo target grande puntúa las posiciones en un único forward pass. El decodificador acepta los tokens del draft de izquierda a derecha con probabilidades derivadas de las distribuciones del target y del draft. Tras el primer rechazo, muestrea una corrección a partir de la distribución residual del target y descarta el resto de tokens del draft. Este paso modificado de muestreo por rechazo conserva la distribución de salida del modelo target dentro de la precisión numérica del hardware; la coincidencia exacta de tokens por sí sola no lo consigue. La figura recorre una ronda con cuatro tokens de draft.
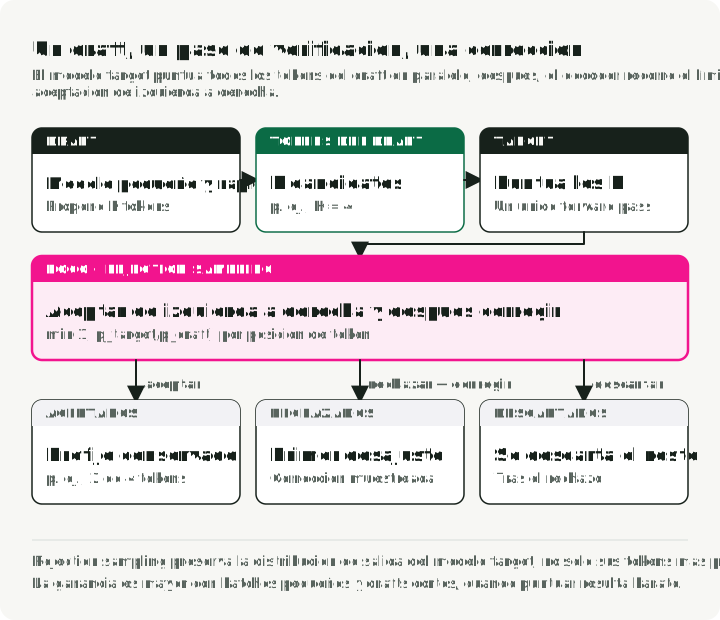
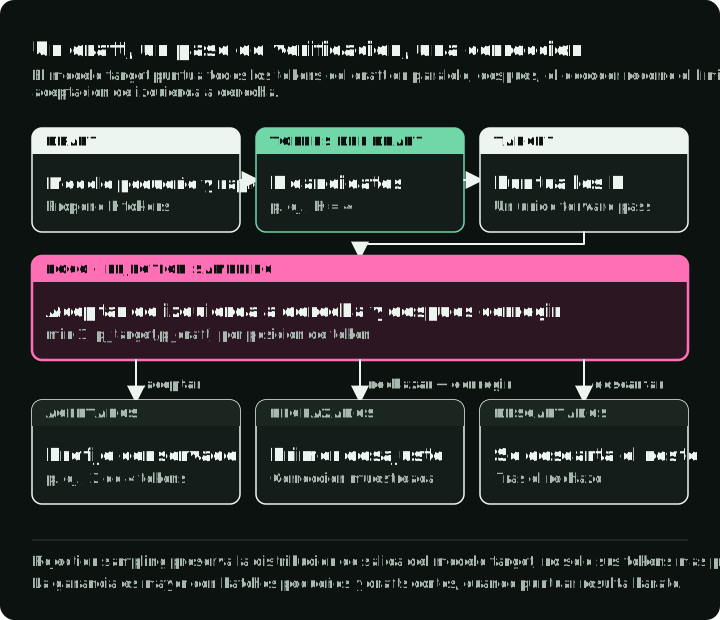
La mejora es más plausible con batches de serving pequeños y longitudes de draft cortas, cuando puntuar el draft queda dominado por el tráfico de pesos, de KV cache o de comunicación y no por el cómputo de los tokens adicionales. El artículo original de speculative sampling informó de una aceleración del decoding de 2–2,5 veces en su configuración probada con Chinchilla de 70B; EAGLE-3 v3 informó de hasta 6,5 veces en sus pruebas. Entre las variantes están Medusa (cabezas de predicción adicionales, sin modelo aparte), el prompt lookup decoding (coincidencia de n-gramas con la entrada, sin un forward pass de un modelo draft aparte) y EAGLE. El EAGLE original extrapola features; EAGLE-3 combina varios niveles de features y predice tokens directamente.
Con batches grandes, el trabajo adicional de draft y de verificación puede anular la mejora. El speculative decoding es más prometedor cuando el batch de serving es suficientemente pequeño y la aceptación del draft es alta; haz el benchmark de todo el bucle de serving y no solo del kernel de verificación.
16. Prefix caching y reutilización del KV cache
En lugar de descartar el KV cache cuando termina una petición, el prefix caching lo conserva para reutilizarlo en peticiones nuevas que compartan los mismos tokens de prefijo. Así se recorta el prefill redundante de system prompts, ejemplos few-shot, contexto de RAG e historial de conversaciones de varios turnos.
El Automatic Prefix Caching de vLLM calcula hashes de bloques KV y usa una tabla hash global para buscarlos. RadixAttention de SGLang mantiene un árbol radix de tensores KV almacenados en cache con granularidad de token. Ambos requieren prefijos idénticos a nivel de token y claves de cache compatibles. La identidad del modelo o del adaptador, las entradas multimodales y los ajustes de aislamiento también pueden afectar a la reutilización. Indica la tasa de aciertos junto con la latencia o el throughput.
17. Streaming en la práctica
El streaming envía los tokens al cliente a medida que se generan en lugar de esperar a la respuesta completa. Muchos frameworks de serving lo exponen mediante Server-Sent Events: el cliente abre una conexión HTTP de larga duración y el servidor envía cada token, o cada grupo de tokens, como un evento data:. El TTFT determina cuándo ve el usuario por primera vez la salida; el TPOT contribuye a determinar lo fluida que resulta. Fija el objetivo mediante pruebas con el producto y según el modelo de interacción elegido.
En el lado del cliente, el streaming obliga a tomar decisiones de buffering. Renderizar token a token puede causar parpadeo visual, sobre todo con markdown o bloques de código que necesitan contexto de varios tokens para formatearse bien. Los patrones habituales son el buffering por palabras (acumular tokens hasta un límite de espacio en blanco), el buffering por líneas (esperar a un salto de línea antes de renderizar) y el buffering adaptativo (renderizar de inmediato la prosa y acumular en buffer los bloques de código). En la API Chat Completions de OpenAI, stream_options: {"include_usage": true} añade un último fragmento de uso antes del mensaje data: [DONE]. Los streams interrumpidos de OpenAI pueden omitir el fragmento final de uso. Los servidores compatibles con OpenAI pueden diferir, así que verifica la implementación que elijas.
El chunked prefill es una forma de evitar que los prefills largos bloqueen la entrega de tokens a los usuarios concurrentes. La planificación con prioridad para el decode puede proteger las peticiones en curso, mientras que el serving desagregado aísla el prefill y el decode en pools de GPUs separados.
Parte IV — Arquitectura del modelo
La arquitectura fija la huella de memoria, el comportamiento de la atención y la dinámica del entrenamiento, y las secciones de serving y de entrenamiento tienen que trabajar alrededor de todo ello.
18. Fundamentos de la arquitectura transformer
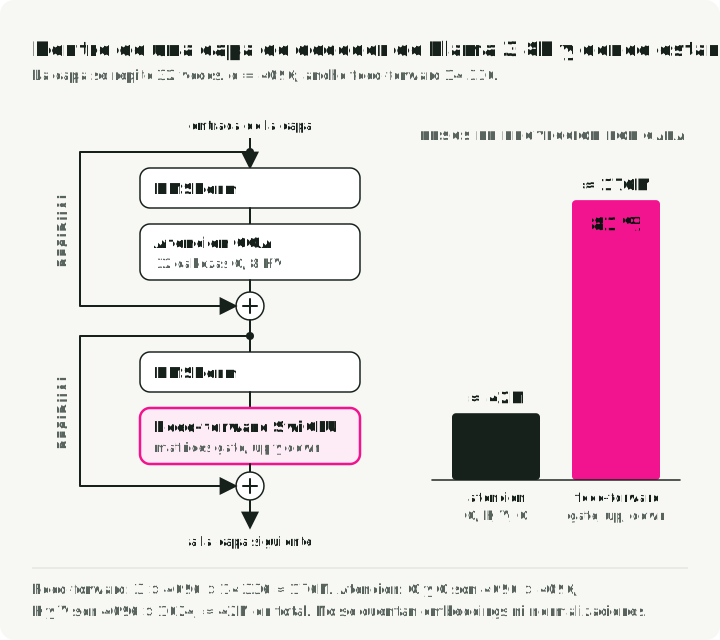
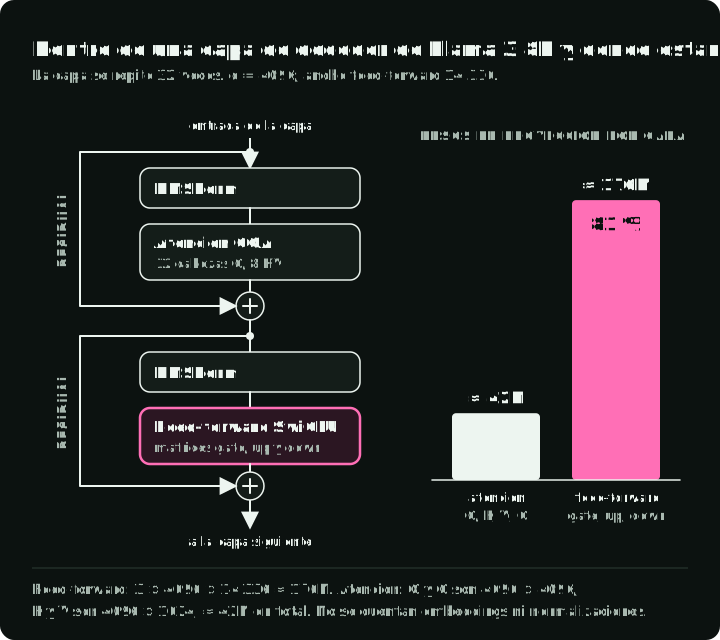
Un transformer decoder-only moderno (GPT, Llama) es una pila de capas idénticas, cada una con dos subbloques: atención y feed-forward. Cada subbloque va envuelto en una conexión residual y en una normalización. La figura muestra una capa de estilo Llama, con los dos caminos que se saltan un subbloque, y cómo se reparten sus pesos de proyección entre la atención y la red feed-forward; los componentes se describen debajo.
Los componentes clave:
La Multi-Head Attention permite que cada token pondere la información de los tokens visibles según la máscara de atención. La entrada se proyecta en tres matrices: Queries (¿qué busco?), Keys (¿qué contengo?) y Values (¿qué información transporto?). Las puntuaciones de atención se calculan entonces así:
El producto escalar mide la similitud entre cada par de tokens. Dividir por evita que los productos escalares crezcan demasiado (lo que empujaría al softmax a regiones con gradientes que se desvanecen). El softmax convierte las puntuaciones en probabilidades, y la multiplicación por produce una combinación ponderada de vectores de valor. Ejecutar esto en varias cabezas en paralelo permite que el modelo atienda a distintas relaciones al mismo tiempo (las cabezas pueden aprender relaciones distintas; sus funciones no son fijas).
La Feed-Forward Network (FFN) transforma cada representación de token de forma independiente después de que la atención mezcle información entre tokens. Los LLM modernos suelen usar SwiGLU en lugar de la FFN original de dos matrices con ReLU:
SwiGLU tiene tres matrices de pesos, frente a dos en una FFN con ReLU, y usa Swish, que es suave. Llama, Mistral y Qwen lo usan; Gemma usa una variante aproximada, GeGLU. La conocida regla de las dos terceras se aplica a un bloque MHA completo convencional con : sus dos matrices FFN aportan unos parámetros, frente a unos de la atención. No es una estimación general para arquitecturas SwiGLU/GQA. En Llama 3 8B, , y ocho cabezas de key/value hacen que la FFN tenga M parámetros por capa, frente a unos 42M parámetros de proyección de atención: cerca del 81 % de esos pesos de proyección, sin contar los embeddings ni la normalización.
Las conexiones residuales suman la salida de cada subbloque a su entrada: . El camino de salto mejora la propagación de la señal y del gradiente a través de pilas profundas.
RMSNorm es habitual en las familias modernas de LLM. LayerNorm recentra restando la media y reescala con la desviación típica. RMSNorm se salta la resta de la media y solo reescala; su artículo informa de reducciones del 7–64 % en el tiempo de ejecución en los modelos y frameworks probados sin reducir el rendimiento medido en la tarea. La colocación pre-norm, que normaliza antes de la atención o de la FFN, también es habitual porque mejora la estabilidad del gradiente.
Estimación del número de parámetros de un decoder convencional con MHA completa, una FFN de dos matrices y anchura , y embeddings de entrada y salida compartidos:
donde es el tamaño del vocabulario, es la dimensión oculta y es el número de capas. El término es la matriz de embeddings de entrada; el término aproxima los pesos de atención y de FFN de cada capa. Para Llama 3 8B (, , ), la estimación es de unos parámetros. El total publicado, 8,03B, es mayor porque la aproximación omite detalles de la arquitectura, como el ancho exacto de la FFN y la proyección de salida independiente.
19. Modelos decoder-only para generación de propósito general
El Transformer original (2017) tenía un encoder y un decoder. Desde entonces, el campo se dividió en tres familias arquitectónicas, y una se convirtió en la opción por defecto para la AI generativa.
| Familia | Atención | Objetivo de entrenamiento | Uso actual | Ejemplos |
|---|---|---|---|---|
| Encoder-only | Bidireccional | Predicción de tokens enmascarados | Embeddings, rerankers, clasificadores | BERT, RoBERTa |
| Encoder-decoder | Encoder bidireccional; decoder causal con cross-attention | Secuencia a secuencia (span corruption, T5) | Traducción, reconocimiento de voz | T5, BART, Whisper |
| Decoder-only | Causal | Predicción del siguiente token | Generación de texto general, chat, código | GPT, Llama |
Los modelos encoder-only usan atención bidireccional: cada token atiende a todos los demás en ambas direcciones. Eso produce representaciones para tareas de comprensión. Los modelos encoder-only estándar no se usan normalmente como decoders autorregresivos; suelen proporcionar la arquitectura base de los modelos de embeddings, rerankers y clasificadores ligeros (por ejemplo, los routers basados en BERT de RouteLLM).
Los modelos encoder-decoder separan la comprensión de la generación. El encoder procesa toda la entrada con atención bidireccional, y después el decoder genera la salida de forma autorregresiva mientras atiende a las representaciones del encoder mediante cross-attention. Esto encaja en tareas en las que la entrada y la salida son secuencias distintas, como la traducción y el reconocimiento de voz.
Los modelos decoder-only, como GPT, Llama y Mistral, usan atención causal: cada token atiende a sí mismo y a los anteriores. Cuatro propiedades útiles para la generación son:
- Reutilización del KV cache. Con atención causal, los tokens anteriores nunca atienden a los posteriores, así que sus keys y values siguen siendo válidos a medida que se generan tokens nuevos. Una caché por secuencia crece por adición (Sección 6). Un encoder-decoder también mantiene estado de cross-attention sobre la salida del encoder.
- Entrenamiento con texto sin procesar. La predicción del siguiente token no necesita pares de entrada y salida, así que cualquier corpus de texto sirve como datos de entrenamiento.
- Un único bloque repetido. El modelo es una pila de capas de decoder idénticas, sin una pila de encoder aparte ni una ruta de cross-attention que construir, repartir en shards y optimizar.
- In-context learning. Las instrucciones, los ejemplos few-shot y la consulta son todos tokens de un mismo prefijo, de modo que un solo modelo puede asumir una tarea nueva a partir del prompt.
20. Mixture of experts
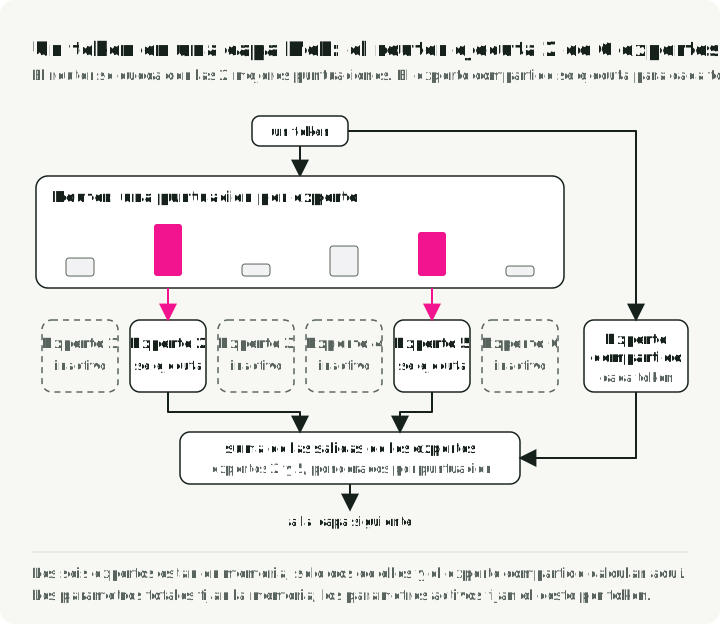
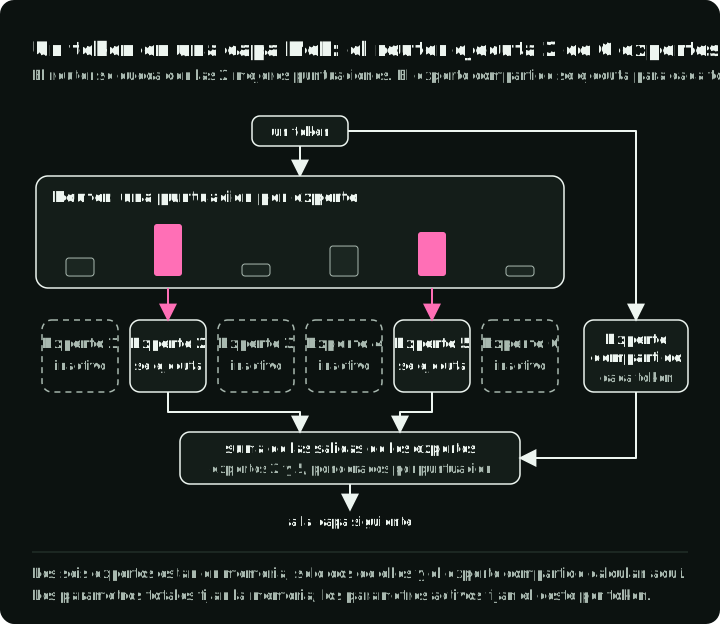
MoE sustituye determinadas FFN densas por varias FFN expertas y un router de gating ligero. El router calcula una puntuación para cada experto (normalmente un softmax sobre proyecciones lineales aprendidas) y selecciona los top- expertos por token. Solo calculan los expertos activados, de modo que un modelo puede tener una capacidad total enorme y mantener bajo el coste por token. Es cómputo condicional disperso. Los parámetros activos aproximan el cómputo por token, pero todos los pesos de los expertos necesitan almacenamiento. La comunicación, el routing, la ocupación del batch y la memoria KV también afectan al coste de ejecución. La figura sigue a un token a través de una capa MoE con seis expertos enrutados y un experto compartido.
| Modelo | Parámetros totales | Parámetros activos | Expertos (enrutados + compartidos) | Top- |
|---|---|---|---|---|
| Mixtral 8x7B | 47B | ~13B | 8 + 0 | 2 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 | 8 |
El experto compartido de DeepSeek-V3 se activa para cada token. Aporta una representación base sobre la que los expertos enrutados pueden especializarse.
Entrenar MoE tiene tres problemas recurrentes: el desequilibrio de carga, el colapso de expertos y la sobrecarga de comunicación del paralelismo de expertos. Los modelos MoE tradicionales añaden una pérdida auxiliar para penalizar el enrutamiento desequilibrado, pero esa pérdida puede competir con el objetivo principal. DeepSeek-V3 usa sobre todo una estrategia por batch sin pérdida auxiliar: unos términos de sesgo, fuera de la retropropagación, bajan la puntuación de los expertos sobrecargados y suben la de los infrautilizados. Además aplica una pérdida de equilibrio complementaria, por secuencia y extremadamente pequeña, para evitar un desequilibrio extremo dentro de una secuencia. El artículo informa de un mejor equilibrio del enrutamiento sin el inconveniente principal de la pérdida auxiliar en su configuración.
21. Tokenización: BPE, SentencePiece y tiktoken
Los LLM no ven texto. Ven secuencias de IDs de token enteros. Un tokenizador divide el texto sin procesar en tokens (fragmentos de subpalabras) y asigna un ID a cada uno. La elección del tokenizador afecta a la calidad del modelo, a la velocidad de inferencia y a la equidad entre idiomas.
Byte Pair Encoding (BPE) es el algoritmo habitual. Fusiona de forma iterativa los pares adyacentes más frecuentes del corpus de entrenamiento. Un ejemplo simplificado:
- Se parte de un vocabulario de caracteres:
[l, o, w, e, r, _] - El par más frecuente es
(l, o)→ se fusiona enlo→ vocabulario:[l, o, w, e, r, _, lo] - El siguiente par más frecuente es
(lo, w)→ se fusiona enlow→ el vocabulario añadelow - Se continúa hasta que el vocabulario alcanza el tamaño objetivo (por ejemplo, 128K tokens)
Las palabras comunes como «the» se convierten en un solo token, mientras que las palabras raras como «defenestration» se dividen en fragmentos de subpalabras como ["def", "en", "est", "ration"] en una ilustración inventada. Las divisiones reales dependen del tokenizador y de la versión. El compromiso es entre el tamaño del vocabulario y la longitud de la secuencia.
Tres implementaciones de tokenizador cubren la mayor parte del uso en producción:
- SentencePiece se entrena directamente sobre texto Unicode sin procesar, sin un pretokenizador específico de cada idioma. Conserva los espacios en blanco con el metasímbolo
▁y, de forma opcional, puede recurrir a tokens de bytes UTF-8. Admite modelos BPE y unigram, y lo usan Llama 1/2, T5 y los primeros tokenizadores de Mistral. Los tokenizadores Mistral Tekken más recientes usan BPE al estilo tiktoken. - tiktoken es el tokenizador de OpenAI, escrito en Rust, que usa BPE a nivel de byte. En su benchmark publicado con GPT-2, funcionó entre 3 y 6 veces más rápido que la configuración probada de
GPT2TokenizerFast. Llama 3 pasó de SentencePiece al algoritmo de tiktoken. - Hugging Face Tokenizers es una biblioteca muy extendida, escrita en Rust, que admite BPE, WordPiece y Unigram.
El tamaño del vocabulario varía mucho entre familias de modelos:
| Modelo | Tokenizador | Tamaño del vocabulario |
|---|---|---|
| GPT-2 | BPE a nivel de byte | 50,257 |
| Llama 2 | SentencePiece BPE | 32,000 |
| Llama 3 | BPE al estilo tiktoken | 128,256 |
| GPT-4o | tiktoken o200k_base | ~200K |
En una configuración comparable de entrenamiento del tokenizador, un vocabulario mayor puede significar menos tokens para el mismo texto, pero una matriz de embeddings mayor (el término de la Sección 18).
La fertilidad mide cuántos tokens produce un tokenizador por palabra o por otra unidad de texto elegida. Varía con el tokenizador exacto, el idioma, la escritura, la normalización, el dominio y la muestra. Mídela con tráfico representativo en lugar de extrapolar a partir de un solo tokenizador o idioma.
22. Ventanas de contexto y codificaciones posicionales
La ventana de contexto limita la secuencia de tokens disponible para una solicitud de generación. El chunked prefill y la decodificación con cache procesan solo parte de esa secuencia en cada pasada. Las APIs también pueden establecer límites de entrada y salida independientes. Los límites publicados incluyen:
| Modelo | Límite publicado de tokens | Año |
|---|---|---|
| Llama 1 | 2,048 | 2023 |
| Llama 3.1 | 128K | 2024 |
| GPT-4.1 | 1,047,576 | 2025 |
| Gemini 2.5 Pro | 1,048,576 de entrada | 2025 |
GPT-4.1 también limita la salida a 32.768 tokens; Gemini 2.5 Pro la limita a 65.536. La fila de Gemini indica un límite de entrada, mientras que GPT-4.1 indica una ventana de contexto, así que estos campos no son idénticos.
La atención compara todos los pares de tokens visibles, pero nada en esa comparación indica a qué distancia están. Sin información posicional, la autoatención completa no puede distinguir distintos órdenes de palabras del mismo conjunto de tokens; los estados de cada token siguen la permutación de la entrada. La máscara causal de un decoder da cierta señal de orden, porque cada token solo ve su prefijo, pero no proporciona posiciones relativas explícitas. Las codificaciones posicionales añaden de forma explícita la posición y la distancia relativa.
Tres enfoques habituales son:
-
RoPE (Rotary Position Embeddings) rota los vectores de query y de key con ángulos que dependen de la posición, de modo que su producto escalar depende de la posición relativa. El contenido del token sigue determinando la puntuación de atención; RoPE añade información de posición sin embeddings de posición absoluta aprendidos. Lo usan familias de modelos abiertos como Llama, Mistral y Qwen.
-
ALiBi (Attention with Linear Biases) renuncia a modificar los embeddings y añade una penalización directamente a las puntuaciones de atención: cuanto más separados están dos tokens, mayor es el sesgo negativo. No tiene parámetros posicionales aprendidos. En el artículo original, un modelo de 1,3B entrenado con secuencias de 1.024 tokens rindió de forma comparable con 2.048 tokens a un modelo con posiciones sinusoidales entrenado con 2.048. El comportamiento más allá de los modelos y las longitudes probados en el artículo depende del modelo.
-
YaRN (Yet another RoPE extensioN) extiende un modelo RoPE más allá de su contexto de entrenamiento. Agrupa las dimensiones de frecuencia en tres categorías y escala cada una de forma distinta. En la comparación del artículo con la misma receta frente a la interpolación de posiciones, YaRN usó 400 pasos de entrenamiento en lugar de 1.000 (apéndice B.2). La afirmación más amplia del resumen sobre usar 10 veces menos datos emplea otra comparación.
Parte V — Entrenamiento y alineamiento
Esta parte distingue el objetivo que crea las capacidades, las técnicas que hacen que el entrenamiento quepa en el hardware disponible y los métodos que moldean después el comportamiento del modelo.
23. Pretraining, fine-tuning y alineamiento
El pretraining de un LLM autorregresivo usa predicción autosupervisada del siguiente token sobre un corpus grande. Los modelos encoder pueden usar otros objetivos, como la predicción de tokens enmascarados. Su cómputo abarca muchos órdenes de magnitud; Llama 3 405B, por ejemplo, usó FLOPs. El fine-tuning supervisado (SFT) adapta el modelo preentrenado a datos etiquetados específicos de una tarea. RLHF / RLAIF usa datos de preferencias para moldear el comportamiento: una pipeline RLHF convencional recopila comparaciones, entrena un modelo de recompensa y después optimiza la política. RLAIF sustituye parte de los juicios humanos por feedback generado por AI. La Sección 31 trata la destilación, una ruta independiente en la que un modelo profesor alineado genera datos de entrenamiento para un modelo alumno más pequeño.
El cómputo depende del tamaño del modelo, de la longitud de la secuencia, del volumen de datos, del optimizador y del método. PPO también carga más estado del modelo que SFT, porque una configuración típica incluye modelos de política, de referencia, de recompensa y crítico. Traté el marco completo de decisión sobre fine-tuning en la Guía de fine-tuning de LLM.
24. LoRA y QLoRA: fine-tuning eficiente en parámetros
LoRA congela los pesos preentrenados e inyecta matrices de bajo rango entrenables () y (), de modo que el peso actualizado es . El artículo de LoRA redujo GPT-3 175B a unos 18 millones de parámetros entrenables en su configuración. El rango es un parámetro de ajuste y no una regla de complejidad de la tarea; elígelo con un barrido de calidad y memoria. Los adaptadores LoRA pueden fusionarse con los pesos base tras el entrenamiento para evitar una ruta de adaptador aparte en la inferencia.
QLoRA carga el modelo base con cuantización NF4 de 4 bits mientras entrena los adaptadores LoRA en BF16. NormalFloat4 coloca más niveles de cuantización cerca de cero, donde la densidad de pesos es mayor. El artículo hizo fine-tuning de un modelo de 65B en una sola GPU de 48 GB e informó de resultados cercanos a sus referencias de 16 bits. Sus compromisos de runtime y de memoria son específicos del stack probado.
25. Entrenamiento con precisión mixta
Todo formato de coma flotante reparte sus bits en tres campos: signo (siempre 1 bit), exponente (fija el rango dinámico) y mantisa (fija la precisión). Más bits de exponente significan un rango más amplio de magnitudes representables; más bits de mantisa significan distinciones más finas entre valores próximos. Los formatos enteros no tienen exponente y solo representan números enteros espaciados de manera uniforme dentro de un rango fijo.
| Formato | Bits | Disposición (S / E / M) | Rango | Precisión | Uso habitual |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ~7 dígitos decimales | Pesos maestros, estados del optimizador (momento y varianza de Adam) | |
| BF16 | 16 | 1 / 8 / 7 | ~2 dígitos decimales | Formato de entrenamiento preferido; mismo rango que FP32 y normalmente sin loss scaling | |
| FP16 | 16 | 1 / 5 / 10 | ~3 dígitos decimales | Entrenamiento con loss scaling (GPUs antiguas); inferencia en hardware anterior a Hopper | |
| FP8 E4M3 | 8 | 1 / 4 / 3 | ~1 dígito decimal | Forward pass en Hopper (H100): más precisión para pesos y activaciones | |
| FP8 E5M2 | 8 | 1 / 5 / 2 | ~0,6 dígitos decimales | Backward pass en Hopper: más rango para los gradientes | |
| INT8 | 8 | entero con signo | a | Enteros exactos | Cuantización de pesos posterior al entrenamiento para inferencia (W8A8); cuantización del KV cache |
| INT4 | 4 | entero con signo | a | Enteros exactos | Cuantización agresiva de solo pesos (AWQ, GPTQ) para inferencia en hardware con poca memoria |
BF16 tiene el mismo rango que FP32 porque el rango lo fija el campo del exponente, y BF16 conserva los 8 bits de exponente de FP32. En cambio renuncia a bits de mantisa (7 frente a 23), cambiando precisión por una reducción de memoria de 2 veces y evitando muchos de los problemas de rango que afectan al entrenamiento en FP16. FP16 tiene solo 5 bits de exponente, lo que limita su rango finito a unos 65K. Muchos gradientes son demasiado pequeños para FP16 y sufren underflow hacia cero. El loss scaling multiplica la pérdida antes de la retropropagación para que esos gradientes sigan siendo representables, y luego los reescala a su valor original antes del paso del optimizador; el escalado dinámico reduce el factor si se produce overflow. El rango de exponente más amplio de BF16 normalmente evita este requisito.
Los formatos enteros no son habituales para la aritmética principal del entrenamiento porque la retropropagación necesita un rango dinámico amplio. Se usan mucho en inferencia, donde los pesos congelados pueden asignarse a escalas calibradas. La cuantización de pesos a INT4 reduce un modelo de 7B de unos 14 GB a 3,5 GB antes de la sobrecarga del runtime; la calidad hay que medirla para el modelo y el método elegidos.
El entrenamiento en FP8 en H100 mediante Transformer Engine usa E4M3 donde importa la precisión y E5M2 donde importa un rango más amplio. El artículo FP8-LM informa de que su framework de precisión mixta entrenó GPT-175B un 75 % más rápido que su referencia Megatron-LM en BF16 y un 37 % más rápido que NVIDIA Transformer Engine en la configuración H100 probada. DeepSeek-V3 usó precisión mixta FP8 e informó de unos $5.6 millones en cómputo equivalente de alquiler para su entrenamiento final, sin contar I+D ni infraestructura.
26. Gradient checkpointing
Cada capa del forward pass produce una salida intermedia llamada activación:
Normalmente todas las activaciones tienen que permanecer en memoria porque la retropropagación las necesita para calcular los gradientes. En un transformer profundo, las activaciones almacenadas pueden ocupar más memoria que los propios pesos del modelo.
El gradient checkpointing cambia cómputo por memoria: descarta la mayoría de esas activaciones y las recalcula sobre la marcha durante la retropropagación. La estrategia estándar (Chen et al., 2016) divide una red de capas en segmentos equiespaciados y guarda solo la activación del límite de cada segmento. Esos límites guardados son los «checkpoints». Todas las activaciones intermedias dentro de un segmento se descartan de inmediato.
Cuando el backward pass llega a una capa dentro de un segmento, sus activaciones se recalculan a partir del checkpoint más cercano. En la estrategia de segmentos equiespaciados, la memoria de activaciones guardadas baja de a . Cada segmento se recalcula una vez, lo que cuesta aproximadamente un forward pass adicional por paso de entrenamiento (Chen et al., 2016). El ahorro real de memoria y la sobrecarga de recálculo dependen del modelo, de los límites de los checkpoints, de la longitud de la secuencia, del framework y de la implementación, así que mide ambos en el entrenamiento objetivo. FlashAttention aplica el mismo principio dentro de la atención al no materializar la matriz de atención completa. Para entrenamientos habituales con Hugging Face Trainer, actívalo con gradient_checkpointing=True. Con FSDP, usa la integración de activation checkpointing del framework cuando esté disponible; la opción genérica puede causar all-gathers redundantes en el backward pass.
27. Etapas de DeepSpeed ZeRO
En el paralelismo de datos estándar, cada GPU guarda una copia completa de los pesos del modelo, los gradientes y los estados del optimizador. Con Adam, cada parámetro ocupa 2 bytes del peso en FP16 + 4 bytes del peso maestro en FP32 + 4 bytes del momento + 4 bytes de la varianza + 2 bytes del gradiente, es decir, 16 bytes por parámetro. Un modelo de 7,5B de parámetros necesita ~120 GB por GPU, y todas las GPUs almacenan lo mismo. Con 64 GPUs son 64 copias idénticas de 120 GB.
DeepSpeed ZeRO (Zero Redundancy Optimizer) elimina esta duplicación repartiendo estos componentes en shards entre las GPUs en lugar de replicarlos:
- Etapa 1: particionar los estados del optimizador. Cada GPU guarda solo 1/N de los estados del optimizador (los pesos maestros en FP32 más el primer y el segundo momento de Adam, 12 bytes/parámetro). Cuando una GPU necesita actualizar un peso, actualiza solo su porción y difunde el resultado. Con los supuestos de abajo, la memoria baja de ~120 GB a ~41,3 GB por GPU.
- Etapa 2: particionar también los gradientes. Los gradientes (2 bytes/parámetro) ya no se reducen con all-reduce hacia todas las GPUs. Cada GPU recibe solo la porción de gradiente que necesita mediante reduce-scatter. Con los mismos supuestos, la memoria baja a ~28,1 GB por GPU.
- Etapa 3: particionar también los pesos del modelo. Cada GPU guarda solo 1/N de los pesos en FP16. Antes del forward o del backward pass de cada capa, la GPU llama a all-gather para reconstruir temporalmente los pesos completos de la capa a partir de todas las demás GPUs, calcula y descarta los pesos reunidos. Con los mismos supuestos, la memoria baja a ~15,0 GB por GPU.
La figura dibuja a escala el estado del modelo por GPU en cada etapa, con el coste de comunicación de cada una.
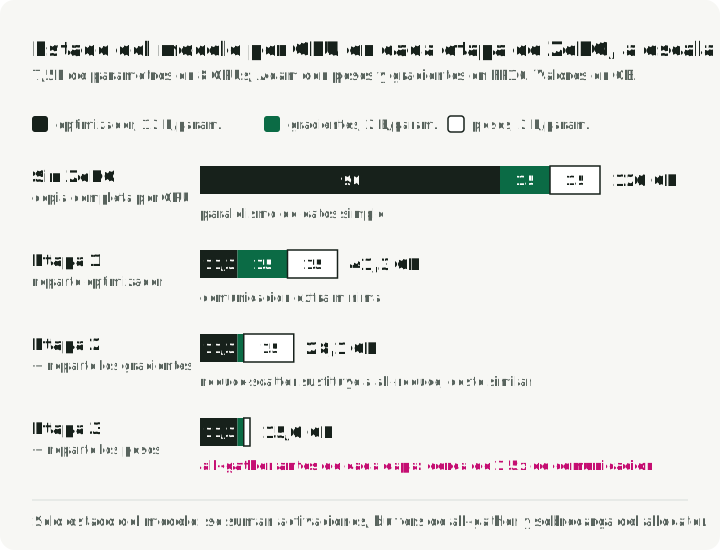
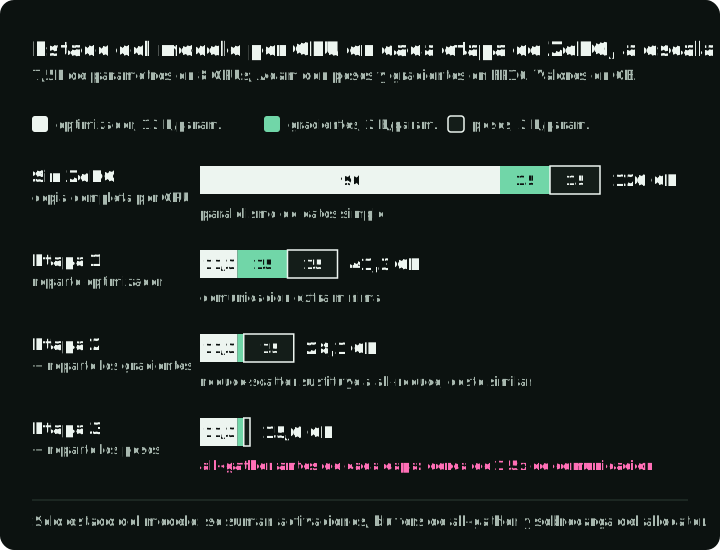
Son valores aproximados del estado del modelo para un modelo de 7,5B de parámetros en 8 GPUs (world size ), con pesos y gradientes en FP16 y con pesos maestros, momento y varianza de Adam en FP32. Excluyen las activaciones, los buffers temporales de all-gather, la fragmentación del allocator y la sobrecarga del framework y del runtime. El límite del cálculo es bytes por parámetro, dividiendo cada estado entre solo en las etapas que lo reparten en shards.
Para repetir el cálculo con otro tamaño de modelo o número de GPUs:
def zero_model_state_gb(params_b, n_gpus, stage):
    """Model-state GB per GPU for Adam with FP16 weights and gradients.

    Optimizer states (FP32 master weights, momentum, variance) take 12 bytes
    per parameter, gradients 2, and weights 2. Stage 1 shards the optimizer
    states, stage 2 also the gradients, and stage 3 also the weights.
    """
    optimizer, gradients, weights = 12, 2, 2
    if stage >= 1:
        optimizer /= n_gpus
    if stage >= 2:
        gradients /= n_gpus
    if stage >= 3:
        weights /= n_gpus
    return params_b * (optimizer + gradients + weights)

for stage in range(4):
    print(f"stage {stage}: {zero_model_state_gb(7.5, 8, stage):g} GB per GPU")

assert [zero_model_state_gb(7.5, 8, s) for s in range(4)] == [120.0, 41.25, 28.125, 15.0]
# 70B parameters: Stage 3 on 8 GPUs still needs 140 GB of model state per GPU;
# 16 GPUs bring it to 70 GB, before activations.
assert zero_model_state_gb(70, 8, 3) == 140.0
assert zero_model_state_gb(70, 16, 3) == 70.0
El compromiso es la comunicación. La etapa 1 añade una sobrecarga mínima, y la etapa 2 sustituye all-reduce por reduce-scatter con un coste similar. La etapa 3 necesita llamadas a all-gather antes de cada capa, tanto en el forward como en el backward pass, lo que supone aproximadamente 1,5 veces el volumen de comunicación del paralelismo de datos estándar.
ZeRO-Infinity amplía la etapa 3 descargando los estados particionados a la RAM de la CPU e incluso a SSDs NVMe, lo que puede hacer posible entrenar modelos con billones de parámetros en clústeres de GPUs limitados. La descarga a almacenamiento añade el coste de PCIe y de la transferencia de almacenamiento; su impacto medido depende de la unidad, de la topología PCIe, del particionado, del prefetch, del solapamiento de las transferencias y de la carga de trabajo. Úsala para cumplir requisitos de capacidad, sin dar por supuesta una ralentización fija, y perfila la configuración objetivo.
28. FSDP: sharding nativo de PyTorch
Fully Sharded Data Parallel (FSDP) es la respuesta integrada de PyTorch a DeepSpeed ZeRO-3. Reparte en shards los parámetros, los gradientes y los estados del optimizador entre las GPUs con la misma idea central. Con sharding completo y resharding activados, las operaciones de cada unidad encapsulada son:
- All-gather de los parámetros completos desde todas las GPUs (reconstruye temporalmente la capa completa).
- Calcular el forward o el backward pass de esa capa.
- Liberar de inmediato los parámetros reunidos. Cada GPU conserva solo su propio shard.
- Reduce-scatter de los gradientes para que cada GPU reciba solo su porción de gradiente asignada.
Como FSDP es nativo de PyTorch, se integra directamente con las herramientas de depuración y los profilers de PyTorch y con torch.compile. Su rendimiento frente a DeepSpeed ZeRO-3 depende de la política de wrapping, de la topología de comunicación, de los ajustes de offload y del tamaño del modelo, así que compáralos en el mismo clúster.
| Criterio | FSDP (PyTorch) | DeepSpeed ZeRO |
|---|---|---|
| Estilo de control | Sharding completo mediante las APIs de PyTorch | Etapas de ZeRO seleccionables |
| Offloading | Offloading a CPU | CPU + NVMe con ZeRO-Infinity |
| Integración con el framework | PyTorch nativo, rutas de torch.compile | Biblioteca aparte y sistema de configuración propio |
| Criterio de selección | Perfila la carga de PyTorch objetivo | Perfila las funciones y el offload necesarios |
FSDP2 (2024–2025) es una reescritura que mejora la integración con torch.compile para una mejor fusión de kernels, añade soporte de entrenamiento en FP8 mediante TorchAO y simplifica la API. Tanto FSDP como DeepSpeed son accesibles mediante Hugging Face Accelerate, que admite ambos mediante configuración para scripts de entrenamiento compatibles y preparados. Los ajustes necesarios de wrapping, checkpointing y offload siguen siendo distintos.
29. Scaling laws y coste de inferencia
El escalado de Chinchilla (DeepMind, 2022) encontró una asignación óptima de cómputo cercana a 20 tokens de entrenamiento por parámetro bajo sus supuestos. Ese objetivo no incluye el coste de serving posterior. Si un modelo más pequeño entrenado con más datos alcanza la calidad necesaria, puede costar menos a lo largo de un ciclo de vida con mucho volumen de inferencia.
Una estrategia de coste del ciclo de vida es entrenar un modelo más pequeño con muchos más datos:
| Modelo | Parámetros | Tokens de entrenamiento | Tokens/parámetro | Tokens/parámetro ÷ 20 (derivado) |
|---|---|---|---|---|
| Chinchilla | 70B | 1.4T | 20:1 | 1× |
| Llama 1 | 65B | 1.4T | 22:1 | 1× |
| Llama 2 | 70B | 2.0T | 29:1 | 1.4× |
| Llama 3 8B | 8B | 15T | 1,875:1 | 94× |
| Qwen3-0.6B | 0.6B | 36T | 60,000:1 | 3,000× |
Es la proporción de tokens por parámetro mostrada, dividida entre el punto aproximado de 20 tokens por parámetro del artículo de Chinchilla. Es una proporción descriptiva, no un multiplicador medido de calidad o de coste.
Para un modelo servido con mucho volumen, dedicar más cómputo de entrenamiento a un modelo más pequeño puede reducir el coste del ciclo de vida. Llama 3 8B ilustra la estrategia, pero que resulte ganadora depende de la calidad necesaria y del volumen de inferencia previsto. «Óptimo según Chinchilla» se refiere a la eficiencia del cómputo de entrenamiento, que es un objetivo distinto del coste del ciclo de vida.
30. RLHF, DPO, GRPO y el panorama del alineamiento
El alineamiento orienta un modelo preentrenado hacia las instrucciones, las preferencias y las políticas de seguridad deseadas. Por sí solo no garantiza veracidad ni un comportamiento seguro. Los métodos siguientes tienen compromisos distintos en complejidad de implementación, requisitos de datos, exploración y estabilidad del entrenamiento.
La pipeline RLHF clásica: SFT → recopilar pares de preferencias humanas → entrenar un modelo de recompensa con esos pares → hacer fine-tuning de la política con PPO (Proximal Policy Optimization). Una configuración PPO convencional tiene cuatro funciones de modelo: política, referencia, modelo crítico/de valor y modelo de recompensa. Su consumo de memoria depende de la compartición, el sharding, la precisión, el offload y la ubicación; cuatro funciones no implican cuatro copias completas residentes en GPU. PPO también es sensible a los hiperparámetros. También es propenso al reward hacking, en el que el modelo explota rarezas del modelo de recompensa, como las respuestas extensas y de apariencia segura, en lugar de mejorar de verdad la calidad.
DPO (Direct Preference Optimization) prescinde del modelo de recompensa aprendido y del bucle de RL online al optimizar directamente una pérdida sobre pares de preferencias. Eso simplifica la pipeline de entrenamiento. El DPO estándar es offline: entrena con un dataset fijo y no explora respuestas nuevas durante el bucle de actualización. Que esa limitación importe depende de la tarea y de la cobertura de los datos.
GRPO (Group Relative Policy Optimization, DeepSeek) elimina el crítico aprendido de PPO al generar varias completions por prompt y usar las recompensas relativas al grupo como referencia. Esto reduce la carga de estado del modelo respecto a una configuración típica de PPO. A diferencia de DPO, GRPO es on-policy: el modelo genera respuestas nuevas durante el entrenamiento. DeepSeek-R1 combina GRPO con RLVR (aprendizaje por refuerzo con recompensas verificables), usando comprobaciones como respuestas matemáticas, compilación de código y pruebas unitarias. Estas recompensas son más fáciles de auditar que una puntuación de preferencias aprendida, pero las pruebas incompletas y los objetivos sustitutos todavía pueden explotarse.
| Método | Funciones de modelo en una configuración convencional | Señal de recompensa | Online/offline | Limitación principal |
|---|---|---|---|---|
| PPO | Política, referencia, crítico, recompensa | Modelo de recompensa aprendido | Online | Reward hacking, ajuste complejo |
| DPO | Política más puntuaciones de referencia, que pueden precalcularse | Implícita (pares de preferencias) | Offline | Sin exploración, datos fijos |
| GRPO | Política; referencia opcional para KL y recompensa aprendida opcional | Explícita (regla/verificador o aprendida) | Online | Depende de la calidad de la recompensa y de una varianza informativa dentro del grupo |
La política de referencia de GRPO depende de la implementación. Por ejemplo, TRL GRPOTrainer no carga un modelo de referencia cuando su coeficiente KL beta es cero. Incluye la ubicación del modelo y la precisión al comparar la memoria de entrenamiento.
31. Destilación: comprimir conocimiento entre modelos
La destilación de conocimiento transfiere capacidades de un modelo profesor grande a un modelo alumno más pequeño. La destilación basada en logits entrena al modelo alumno para que reproduzca la distribución de salida del modelo profesor. La destilación basada en datos hace que el modelo profesor genere ejemplos con los que el modelo alumno hace fine-tuning. Los métodos basados en datos son habituales con los LLM porque funcionan entre arquitecturas distintas y con modelos profesores accesibles solo por API, pero su valor está acotado por la calidad del modelo profesor, la cobertura de los datos, el filtrado y el coste de generación.
DeepSeek-R1 seleccionó una mezcla de aproximadamente 800.000 ejemplos (unas 600.000 muestras relacionadas con razonamiento y 200.000 que no) y la usó para hacer destilación de modelos Qwen2.5 y Llama 3 de 1,5B a 70B de parámetros. En la evaluación del artículo:
- DeepSeek-R1-Distill-Qwen-32B obtiene un 72,6 % en AIME 2024 y un 94,3 % en MATH-500, por encima de las cifras de OpenAI o1-mini que recoge el artículo.
- DeepSeek-R1-Distill-Qwen-7B obtiene un 55,5 % en AIME 2024, por encima del resultado de QwQ-32B-Preview que recoge el artículo, con un modelo más pequeño.
En los experimentos con modelos pequeños de DeepSeek-R1, la destilación superó a GRPO directo en los modelos base probados. Ese resultado respalda la destilación en esta configuración; no establece una clasificación universal entre destilación y RL.
32. Generación de datos sintéticos
Los datos de entrenamiento generados por LLM se usan en varios patrones recurrentes:
- Self-Instruct arranca de un pequeño conjunto semilla de instrucciones escritas por humanos: el LLM genera instrucciones, entradas y salidas nuevas, que se filtran y se devuelven al conjunto. El proyecto Alpaca usó 52.000 ejemplos generados a partir de 175 semillas. Stanford informó de una generación de datos por menos de $500 y de un fine-tuning por menos de $100, lo que sitúa el coste inicial de reproducción por debajo de $600; su comparación con GPT-3.5 fue una evaluación limitada del proyecto, no una equivalencia amplia.
- Evol-Instruct (WizardLM) toma instrucciones existentes y las hace evolucionar de forma iterativa según ejes de complejidad (añadir restricciones, profundizar el razonamiento, concretar más los problemas) para producir ejemplos de entrenamiento cada vez más difíciles.
- Phi-4 de Microsoft (14B) usó datos sintéticos en gran parte del pretraining, con generación, crítica, autorrevisión e inversión de instrucciones. Su informe técnico compara el rendimiento resultante en STEM y en programación con el de modelos más grandes en los benchmarks seleccionados.
Un riesgo es el colapso del modelo cuando los datos reales se sustituyen de forma recursiva por datos generados. En los escenarios estudiados, las partes raras de la distribución original desaparecen progresivamente (Shumailov et al., publicado en Nature en 2024). No es un resultado inevitable de todo uso de datos sintéticos. Un estudio de acumulación independiente encontró un comportamiento distinto cuando se conservaban datos reales y generados entre generaciones. Otro estudio de un clasificador de Ahrefs tomó una página en inglés recién detectada por dominio de entre 900.000 páginas en abril de 2025 y clasificó el 74,2 % como páginas que contenían algún texto generado por AI. Ese estudio de un proveedor no es un censo de la web. La mitigación empieza por mezclar datos sintéticos y reales, filtrar y registrar su procedencia para poder medir el material generado recursivamente.
Parte VI — Escalado y despliegue
Cuando una carga de trabajo deja de caber o de cumplir su SLO en un solo dispositivo, las decisiones son cómo repartir el trabajo, qué runtime ofrece los controles necesarios y si todas las peticiones necesitan el mismo modelo.
33. Cuatro formas de paralelismo
Las cuatro formas se diferencian en qué parte del modelo guarda cada GPU y en qué cruza el enlace entre GPUs. La figura muestra cada una en dos GPUs.
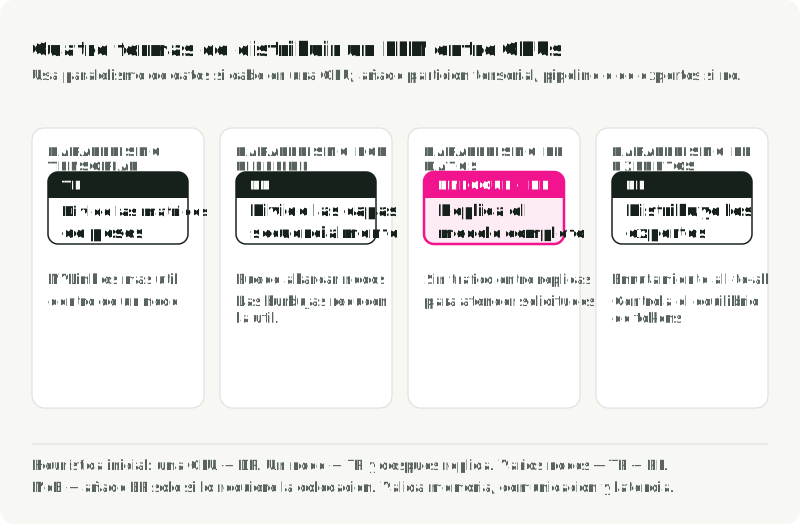
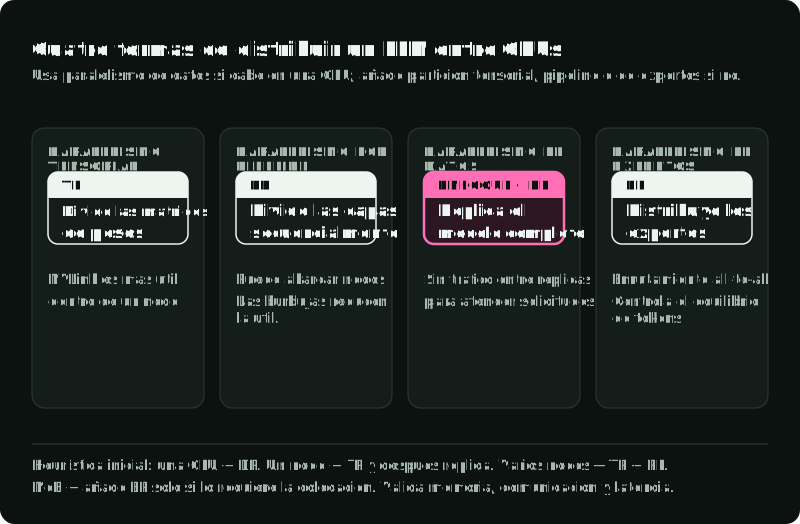
El paralelismo tensorial (TP) divide cada matriz de pesos entre las GPUs y suele comunicarse después de cada capa. Los enlaces rápidos dentro del nodo, como NVLink, lo hacen más práctico dentro de un nodo. Más shards reducen la memoria y el cómputo por dispositivo, pero aumentan la comunicación, así que elige el grado con un benchmark de latencia.
El paralelismo de pipeline (PP) reparte las capas de forma secuencial entre las GPUs y pasa activaciones entre etapas. Su patrón de comunicación puede funcionar entre nodos, pero las burbujas del pipeline y los tiempos desiguales entre etapas reducen la utilización. Los despliegues grandes suelen combinar TP dentro de un nodo y PP entre nodos.
El paralelismo de datos (DP) replica el modelo de serving para que cada réplica atienda peticiones independientes sin comunicación entre réplicas para cada petición. Es eficiente cuando el modelo cabe y el tráfico se puede equilibrar. En el entrenamiento, DP suele combinarse con ZeRO o FSDP para repartir el estado en shards.
El paralelismo de expertos (EP) distribuye los expertos de MoE entre las GPUs con comunicación all-to-all para enrutar los tokens. Su rendimiento depende del equilibrio de tokens, de la ubicación de los expertos y de la topología de la interconexión; el tráfico all-to-all puede convertirse en el cuello de botella dominante.
Una heurística inicial de paralelismo:
- El modelo cabe en una GPU: empieza con réplicas independientes y mide el escalado de DP.
- El modelo cabe en un nodo: prueba TP dentro del nodo y después replica el grupo si el tráfico lo exige.
- El modelo ocupa varios nodos: prueba una combinación de TP y PP frente a la interconexión y al objetivo de latencia.
- Mixture of experts: añade EP solo cuando la ubicación de los expertos lo requiera.
34. Comparativa de frameworks de serving
El runtime decide cuáles de las optimizaciones de la Parte III obtienes sin escribir kernels. Usa la tabla para elegir el primero que someter a benchmark y después compáralo con una alternativa sobre los mismos prompts, longitudes de salida, hardware y SLO.
| Runtime | Úsalo cuando | Comprueba primero |
|---|---|---|
| vLLM | Serving general en GPU con una API compatible con OpenAI | El modelo y la GPU objetivo en la matriz de compatibilidad actual |
| SGLang | El tráfico comparte prefijos largos (system prompts, chat de varios turnos, agentes) o necesita structured output | La tasa de aciertos de la caché de prefijos con tu propio tráfico |
| TensorRT-LLM | La flota es solo de NVIDIA y la latencia más baja importa más que la portabilidad | Soporte para tu modelo y precisión (FP8, FP4) |
| llama.cpp | CPU, Apple silicon o una única GPU de consumo, con modelos cuantizados en GGUF | Tokens por segundo de su herramienta de benchmark en la máquina objetivo |
| Ollama | Desarrollo local y demos | Pasa a un runtime de serving antes de trabajar con alta concurrencia o con SLOs |
Los mismos puntos de partida para benchmarks como lista ordenada:
- Una máquina local o una GPU de consumo: empieza con llama.cpp, u Ollama para desarrollo.
- Solo NVIDIA y la latencia es la prioridad: incluye TensorRT-LLM en el benchmark.
- Prefijos largos compartidos o structured output: SGLang.
- En cualquier otro caso: vLLM.
Haz un benchmark de la primera opción con tus prompts, longitudes de salida, hardware y SLO.
vLLM ofrece asignación paginada del KV, continuous batching, una API compatible con OpenAI y varios modos de paralelismo. El soporte de modelos y de hardware cambia con frecuencia.
SGLang combina RadixAttention para reutilizar prefijos, un planificador propio y generación estructurada. Las mejoras de throughput que publica dependen de la carga de trabajo y de la configuración.
TensorRT-LLM busca una latencia baja para solicitudes individuales mediante la captura y reproducción de grafos CUDA, que reducen la sobrecarga de lanzamiento, y la optimización de kernels, incluida la fusión, con soporte nativo para FP8/FP4. Versiones anteriores, como v1.2.0, permitían compilar por adelantado un motor TensorRT. La guía de migración actual de NVIDIA establece PyTorch como único backend: su API LLM y trtllm-serve cargan directamente un checkpoint de Hugging Face, sin compilar un motor. Sus cifras publicadas corresponden a hardware y modelos concretos, y solo funciona en GPUs NVIDIA.
TGI se archivó el 21 de marzo de 2026 y su repositorio es de solo lectura. Su README recomienda vLLM, SGLang, llama.cpp o MLX para nuevos despliegues.
Ollama da prioridad a un flujo de trabajo local sencillo con modelos.
llama.cpp es un runtime portable en C/C++ con rutas para ARM, x86, Metal, CUDA, ROCm y Vulkan. GGUF admite varios niveles de cuantización. El rendimiento varía mucho según el modelo, la cuantización, el contexto y el backend.
35. Selección de GPU para inferencia
La tabla compara características de hardware publicadas. Que un fabricante admita una precisión no hace que las cifras de cómputo máximo sean directamente comparables entre formatos, así que elige primero según si el modelo cabe en memoria y haz benchmark de la carga de trabajo objetivo. Consulta por separado los precios actuales de la nube, porque varían según el proveedor, la región, el compromiso y la disponibilidad.
| GPU | Memoria | Ancho de banda | Baja precisión nativa | NVLink por GPU |
|---|---|---|---|---|
| B200 SXM | 180 GB HBM3e | Hasta 8 TB/s | FP4, FP8 | 1,8 TB/s |
| H200 SXM | 141 GB HBM3e | 4,8 TB/s | FP8 | 900 GB/s |
| H100 SXM | 80 GB HBM3 | 3,35 TB/s | FP8 | 900 GB/s |
| A100 80 GB SXM | 80 GB HBM2e | 2,039 TB/s | INT8 (sin FP8) | 600 GB/s |
| L40S | 48 GB GDDR6 | 864 GB/s | FP8 | Ninguno |
| A10G (AWS G5) | 24 GB GDDR6 | 600 GB/s | INT8 (sin FP8) | Ninguno |
| RTX 4090 | 24 GB GDDR6X | ~1 TB/s | FP8 | Ninguno |
La fila de A10G usa la especificación de A10 de NVIDIA como aproximación del ancho de banda; la especificación enlazada de AWS G5 no establece el ancho de banda exacto de A10G. La cifra de la RTX 4090 (1.008 GB/s) procede del informe de arquitectura Ada.
Los 141 GB de capacidad de la H200 pueden simplificar algunos despliegues de modelos grandes. Las tarjetas GDDR de las filas inferiores tienen un tercio o menos del ancho de banda de la H100 y no tienen NVLink, así que encajan mejor con modelos cuantizados que caben en una sola GPU que con modelos que necesitan paralelismo tensorial.
AWQ y GPTQ sirven modelos de 4 bits descuantizando las operaciones matriciales admitidas a un formato de cómputo como FP16 o BF16. La compatibilidad y la velocidad siguen dependiendo de la arquitectura del modelo, del formato de cuantización, del backend de serving, del kernel y de la GPU, así que consulta la matriz de soporte del backend y haz benchmark del artefacto exacto. Todas las GPUs de la lista admiten operaciones matriciales INT8.
El decode de un LLM suele estar limitado por el ancho de banda de memoria, así que la capacidad y el ancho de banda de la HBM pueden importar más que los TFLOPS máximos en las cargas de serving. Compara las GPUs manteniendo constantes el modelo, la precisión, la distribución del batch, la longitud del contexto y el objetivo de latencia.
36. Model cascading y routing
El routing de modelos elige qué LLM atiende cada consulta según la complejidad o capacidad prevista. RouteLLM (LMSYS/UC Berkeley, ICLR 2025) informa en la tabla 6 de una relación de costes de 3,66x con el 95 % de la puntuación de referencia de GPT-4-Turbo en MT-Bench. Esto equivale a un coste modelizado aproximadamente un 73 % menor con los precios, el modelo débil y la evaluación de ese experimento. Que el routing compense depende de los precios actuales, de la mezcla de tráfico, de los errores del router y de la calidad mínima exigida.
Los routers van desde clasificadores ligeros hasta jueces basados en LLM. El cascading es la variante secuencial: una consulta empieza con un modelo más barato y escala cuando una función de puntuación rechaza la respuesta. FrugalGPT informa de hasta un 98 % menos de coste o de hasta un 4 % más de precisión en el conjunto de modelos que evaluó. Una cascada en producción necesita criterios de escalado calibrados y monitorización de las consultas que el modelo barato acepta por error. La figura muestra dónde toma su decisión cada enfoque y dónde falla cada uno.
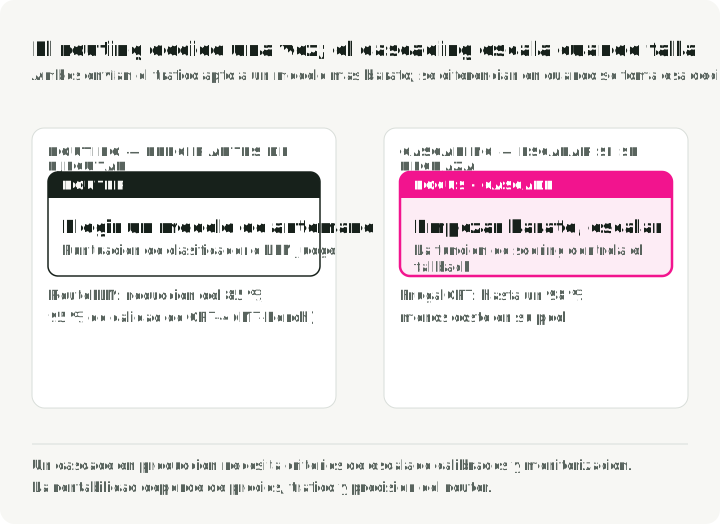
Parte VII — Aplicaciones
Las aplicaciones fallan en lugares que el stack de serving no ve. El retrieval puede fallar antes de que empiece la generación, los agentes pueden elegir una acción no válida y un cambio en el prompt puede mejorar una tarea mientras rompe otra.
37. Modelos de embedding frente a modelos generativos
Los modelos de embeddings codifican texto en vectores de dimensión fija que capturan el significado semántico. Los modelos de un solo vector comparados abajo producen un vector denso por entrada, normalmente con unos cientos a varios miles de dimensiones. Otras arquitecturas de recuperación pueden conservar varios vectores a nivel de token; la comparación de almacenamiento siguiente se refiere a embeddings de un solo vector. Sus arquitecturas base incluyen transformers encoder-only bidireccionales y modelos derivados de decoders adaptados al aprendizaje de representaciones. Una capa de pooling suele reducir las representaciones de cada token a un vector mediante mean pooling, un token de clasificación especial o un método de último token específico del modelo. El fine-tuning contrastivo acerca después los textos semánticamente similares y aleja los diferentes.
Los modelos de embedding actuales se diferencian en las propiedades que fijan el coste de almacenamiento y la elección del índice: dimensiones de salida, tipos de entrada admitidos, despliegue y precisión de la salida.
| Modelo | Dimensiones máximas | Entrada | Pesos | Precisión nativa de salida |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 4,096 (32–4,096 mediante MRL) | Texto | Abiertos (Apache 2.0) | Float |
| Gemini Embedding 2 | 3,072 (128–3,072) | Texto, imagen, vídeo, audio, PDF | API | No indicada |
| pplx-embed-v1-4B | 2,560 (MRL) | Texto | Abiertos (MIT) | INT8 y binaria |
| OpenAI text-embedding-3-large | 3,072 (acortables con dimensions) | Texto | API | Float |
Son ejemplos, no un ranking. Evalúa el idioma, la modalidad, la tarea, la dimensión y el coste de serving sobre un mismo conjunto de retrieval.
Matryoshka Representation Learning (MRL, Kusupati et al., NeurIPS 2022) hace flexibles las dimensiones de los embeddings. Su nombre viene de las muñecas rusas anidadas: MRL entrena determinados prefijos del embedding para que conserven información útil. Sus experimentos comparan esos prefijos con representaciones más pequeñas entrenadas por separado; igualar su calidad es un resultado empírico, no una garantía para todas las tareas. Durante el entrenamiento, MRL agrega las pérdidas sobre un conjunto de dimensiones de prefijo elegidas, normalmente reducciones sucesivas a la mitad; el ejemplo de 2048 dimensiones del artículo usa . La pérdida agregada empuja a las primeras dimensiones a llevar la información semántica gruesa, y las siguientes añaden detalle más fino.
Tras el entrenamiento, un embedding MRL puede truncarse a una dimensión de prefijo admitida. OpenAI informa de que text-embedding-3-large con 256 dimensiones supera a text-embedding-ada-002 con 1.536 dimensiones en su comparación citada de MTEB. Eso supone una reducción de 6 veces en el almacenamiento bruto de vectores; la latencia de búsqueda y el coste de la base de datos dependen además del índice, de los metadatos, del filtrado y del hardware.
El modelo de embedding es un componente importante de una pipeline de RAG, junto con el parsing, el chunking, la búsqueda, el reranking y la generación. Si no se recupera la evidencia relevante, un generador más potente no puede recuperarla de forma fiable.
38. Arquitectura RAG en producción
La Retrieval-Augmented Generation proporciona a un LLM documentos recuperados en el momento de la consulta. Puede aportar evidencia actual o privada que no está en los pesos del modelo, pero recuperar no garantiza que la respuesta use esa evidencia correctamente. Un sistema RAG en producción es una pipeline de varias etapas cuyas etapas necesitan evaluaciones independientes. La figura muestra la ruta de ingesta offline, la ruta por consulta y dónde ocurren los tres modos de fallo que se listan abajo.
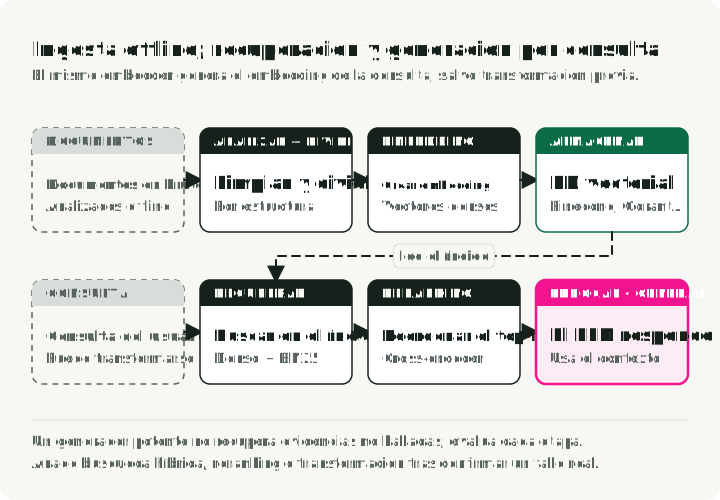
La pipeline de ingesta se ejecuta offline. Los documentos sin procesar (PDFs, HTML, Markdown, bases de datos) se parsean primero a texto limpio. El parsing de PDFs puede perder tablas, encabezados y formato. Después el texto se divide en chunks, de los que se calculan los embeddings y que se indexan de forma independiente.
El chunking afecta tanto al recall del retrieval como al contexto disponible para el generador. Los tamaños útiles dependen de la estructura de los documentos, de la granularidad de las consultas, de los límites del modelo de embedding y de los del reranker. Los enfoques habituales son el tamaño fijo con solapamiento, la división recursiva siguiendo los límites del documento y el chunking semántico según la similitud entre embeddings. Compáralos con etiquetas de relevancia a nivel de página o de sección en lugar de adoptar un único rango de tokens para todo.
Después se calcula el embedding de cada chunk con un modelo como los de la Sección 37 y se guarda en un índice vectorial. pgvector mantiene los vectores en una base de datos Postgres que ya tengas en marcha. Un almacén dedicado como Qdrant, Weaviate o Pinecone añade búsqueda híbrida integrada y escala el índice por separado de la base de datos de la aplicación.
La pipeline de retrieval se ejecuta en el momento de la consulta. Empieza con una línea base medible y añade etapas cuando el análisis de errores muestre que resuelven un fallo real:
- La búsqueda híbrida combina el retrieval vectorial denso con un retrieval disperso como BM25, a menudo fusionados mediante Reciprocal Rank Fusion (RRF). La búsqueda densa maneja las paráfrasis semánticas; la dispersa detecta identificadores exactos, códigos de error y acrónimos. Los benchmarks de los proveedores informan de mejoras sobre las bases solo vectoriales, pero su magnitud depende del corpus y de las etiquetas de relevancia.
- El reranking pasa los candidatos recuperados por un modelo que puntúa juntos la consulta y el documento. Esto puede mejorar la relevancia fina a costa de otra llamada a un modelo. El número de candidatos, el número de los retenidos y la latencia deben ajustarse juntos. Traté la pipeline completa de varias etapas en Building a Modern Search Ranking Stack.
- Transformación de consultas reformula la consulta del usuario antes de la recuperación para mejorar el recall. HyDE (Hypothetical Document Embeddings) hace que el LLM genere un documento hipotético, que se convierte en embedding y se usa para recuperar documentos reales. El texto generado es una representación de búsqueda, no evidencia verificada para la respuesta. Expansión multiconsulta genera varias formulaciones de la misma pregunta. Step-back prompting plantea primero una pregunta más general para recuperar información o razonar a partir de principios de nivel superior.
Los modos de fallo habituales:
- Fallo de retrieval: el documento correcto existe pero no se recupera. Prueba el chunking, la transformación de consultas, la búsqueda híbrida y el filtrado por metadatos frente al fallo.
- Envenenamiento del contexto: los chunks recuperados que no son relevantes inducen a error al LLM. Prueba el reranking, los filtros de contexto y conjuntos retenidos más pequeños.
- Lost-in-the-middle: en los entornos de pregunta-respuesta con varios documentos y de recuperación de clave-valor que probaron, Liu et al. observaron que el rendimiento de las respuestas era en general mayor cuando la información relevante aparecía al principio o al final de la entrada, y menor cuando aparecía en el medio.
GraphRAG (Microsoft, 2024) extrae entidades y relaciones, detecta comunidades del grafo y crea resúmenes de esas comunidades. Su método de búsqueda global responde a preguntas sobre todo el corpus a partir de esos resúmenes; no es simplemente recuperación vectorial con un grafo añadido. El compromiso es un trabajo adicional de extracción, indexación, almacenamiento y evaluación.
Las guías de profesionales publican rangos de latencia para el embedding, la búsqueda, el reranking y la generación, pero esas cifras varían según la región, el corpus, el hardware y el modelo. Mide cada etapa en las trazas y evalúa el cambio de calidad antes de aceptar la latencia adicional.
39. Arquitecturas de agentes y tool calling
Los agentes de LLM usan modelos para seleccionar y ordenar tool calls alrededor de un estado cambiante. Tres patrones de orquestación útiles son:
- ReAct: intercala la selección de acciones con observaciones. Puede adaptarse después de cada tool result, pero un historial creciente aumenta el coste en tokens y en latencia.
- ReWOO — planifica tool calls con marcadores y dependencias explícitas de resultados; después ejecuta el plan y sintetiza. Solo las llamadas independientes pueden ejecutarse en paralelo; una llamada que se refiere a un resultado anterior debe esperarlo. Su artículo informa de ahorro de tokens frente a ReAct, pero el plan fijo necesita una ruta explícita de recuperación cuando falla una herramienta.
- Planner-executor: separa la planificación de la ejecución y puede añadir una política de replanificación tras un fallo. Permite usar un modelo distinto para cada rol, pero añade estado del plan y una segunda llamada a un modelo que puede fallar.
| Patrón | Trabajo repetido del modelo | Adaptabilidad | Punto de partida útil |
|---|---|---|---|
| ReAct | Lee observaciones antes de la siguiente acción | Se actualiza tras las observaciones | Tool use incierto o exploratorio |
| ReWOO | Reutiliza un plan con dependencias explícitas | Plan fijo salvo que se amplíe | Trabajo que puede planificarse antes de los tool results |
| Planner-executor | Planifica, ejecuta y puede volver a planificar | Puede revisar el plan explícito | Tareas largas que se benefician del control |
La figura dibuja los tres patrones para que veas dónde planifica cada uno y si tiene un camino de vuelta tras un tool result.
El function calling es un mecanismo habitual para invocar herramientas. Las APIs exponen definiciones de herramientas y devuelven argumentos estructurados, lo que reduce la necesidad de parsear texto libre. Unos argumentos válidos según el esquema pueden aun así seleccionar la herramienta equivocada o contener valores no válidos. El function calling en paralelo puede reducir los viajes de ida y vuelta cuando las operaciones son independientes.
El structured output y el constrained decoding imponen un esquema restringiendo los tokens disponibles en cada paso de generación. Motores como xgrammar, usado en vLLM y SGLang, pueden eliminar muchos fallos de sintaxis y de parsing con poca sobrecarga en las configuraciones admitidas. No garantizan que los valores extraídos o las decisiones sean correctos. Schema-Guided Reasoning (SGR) usa el orden de los campos y la estructura del esquema para que el estado intermedio se pueda inspeccionar antes de la decisión final. Sus tres patrones son Cascade (pasos secuenciales), Routing (tipos unión como conmutadores semánticos) y Cycle (listas acotadas).
Un conjunto mayor de herramientas y una secuencia de acciones más profunda pueden reducir la calidad de selección y aumentar la latencia o el coste de tokens. Mide esas curvas con las descripciones reales de herramientas y la distribución de fallos. Frameworks como LangGraph pueden explicitar el estado y las rutas de recuperación, pero no eliminan la necesidad de evaluación.
40. Prompt engineering para producción
El prompting en producción es un problema de evaluación: cambia una parte del prompt o del contexto y mide después la calidad de la tarea y los modos de fallo. Las técnicas siguientes son puntos de partida habituales, no un orden universal.
Los ejemplos few-shot suelen ser eficaces para controlar el formato de salida. Empieza con 3–5 ejemplos que cubran entradas vacías, consultas ambiguas y respuestas de varias partes, y mide después el resultado en un conjunto reservado. Los ejemplos deben abarcar la distribución real de las entradas y no solo el camino feliz. Más ejemplos consumen contexto y no garantizan más mejoras.
El prompting con chain-of-thought (CoT) pide al modelo que exponga el razonamiento intermedio antes de responder. Kojima et al. (2022) informaron de mejoras con el sufijo «Let’s think step by step» en las tareas de razonamiento que probaron, pero el efecto varía según el modelo y las APIs de razonamiento más recientes pueden no exponer las trazas ocultas. En producción, es preferible una descomposición inspeccionable de la tarea o una justificación concisa cuando resulte útil para el evaluador. La autoconsistencia (Wang et al., 2023) muestrea varias rutas de razonamiento y agrega las respuestas, a cambio de un coste de inferencia adicional, para ganar robustez en las tareas adecuadas.
El structured output con esquemas JSON explícitos (Sección 39) elimina muchos fallos de parsing. Los motores de constrained decoding como xgrammar pueden imponer la gramática admitida durante la generación; la exactitud factual y la validez semántica siguen necesitando evaluación, y las funciones del esquema no admitidas pueden requerir un tratamiento aparte.
El prompt chaining divide una tarea en etapas concretas, por ejemplo clasificar la intención → recuperar contexto → generar la respuesta → validar la salida. Puede localizar los fallos, permitir un modelo distinto en cada etapa y exponer estado intermedio que se pueda cachear. También añade interfaces y latencia, así que compáralo con una línea base de una sola llamada.
La temperatura cambia la distribución de muestreo. Los valores bajos son un punto de partida razonable para la clasificación o la extracción; los valores más altos pueden aumentar la diversidad en la generación de ideas. El comportamiento exacto difiere entre las APIs de modelos e interactúa con top_p, top_k y los valores por defecto de cada proveedor, así que barre los ajustes admitidos en la tarea en lugar de copiar un único rango.
La separación entre mensaje de sistema y mensaje de usuario mantiene la política persistente aparte del contenido de cada petición. Las plantillas de chat y el instruction tuning dan a estos roles prioridades distintas, pero no convierten el mensaje de sistema en una frontera de cumplimiento. Pon el comportamiento estable en el mensaje de sistema, mantén los datos no fiables en el contenido de usuario o de herramientas, e impón también fuera del modelo las restricciones estrictas, como la eliminación de PII.
La context engineering amplía el trabajo de prompts al ensamblado de los documentos recuperados, los tool results, el historial de la conversación y los ejemplos. Liu et al. encontraron un efecto lost-in-the-middle en los modelos de contexto largo que probaron, así que la posición debe formar parte de la evaluación y no darse por irrelevante. Traté el flujo de trabajo más amplio en Context Engineering for AI Agents.
Parte VIII — Operaciones en producción
Las operaciones en producción convierten los conceptos anteriores en límites de admisión, pruebas de carga, alertas y decisiones de capacidad con tráfico real.
41. Rate limiting para peticiones de coste variable
La limitación tradicional por solicitudes por segundo supone un coste aproximadamente igual por solicitud. Los LLMs incumplen esa premisa. Un prompt de clasificación de 10 tokens y un análisis documental de 100K tokens llegan al mismo endpoint de API, pero su longitud de entrada difiere por un factor de 10.000. El coste total también depende de la longitud de salida, del modelo, del cache y de los precios. Limitar por RPS deja pasar peticiones caras sin control o restringe innecesariamente las baratas.
Los sistemas en producción necesitan rate limiting basado en tokens en varias dimensiones. OpenAI documenta límites de peticiones y de tokens por nivel de uso. Anthropic separa los límites de tokens de entrada y de tokens de salida. Las cuotas y los algoritmos exactos pueden cambiar, así que trata la documentación del proveedor como la fuente de verdad; el punto de arquitectura es presupuestar por separado las peticiones y los tokens.
Una implementación a nivel de aplicación es una jerarquía multidimensional de límites (usuario → aplicación → organización → global), con niveles de prioridad para el acceso premium. En cada solicitud, reserva tokens al admitirla: estima el total (entrada + max_tokens), descuenta la estimación del depósito y devuelve la parte no utilizada cuando termina la solicitud, según el consumo real. Esto impide que una ráfaga de solicitudes con generaciones largas agote la capacidad antes de producir salida. Una solicitud con 2000 tokens de entrada y max_tokens = 1000 reserva 3000. Si la respuesta usa 200 tokens de salida, el consumo real es de 2200 y se devuelven 800. Es una política local de admisión; los algoritmos de cuotas del proveedor pueden usar otras estimaciones y presupuestos independientes de entrada y salida. Si quedan menos de 3000 en el depósito, devuelve un 429 o pon la solicitud en cola.
En los despliegues autoalojados, el equivalente es el throughput aprovisionado: reservar capacidad de GPU dedicada para unas tasas de tokens objetivo. En los despliegues de vLLM, eso significa configurar el control de admisión en torno a los slots de decode activos y a la presión sobre el KV cache, y no solo al número de peticiones. Como explica la Sección 5, tanto el throughput como la admisión necesitan límites que tengan en cuenta los tokens.
42. Modos de fallo frente a los que diseñar
El serving de LLM añade modos de fallo ligados a la longitud variable de las secuencias, a la memoria del KV y al trabajo de decode de larga duración. Diseña y prueba con carga las defensas antes de que el tráfico de producción dependa de ellas.
Out-of-Memory (OOM) es un fallo habitual. Un modelo de 70B en FP16 necesita unos 140 GB solo para los pesos, y el KV cache de una sola secuencia de 128K de contexto de Llama 3.1 70B puede añadir unos 40 GiB con los supuestos de la Sección 6. La diferencia entre «cabe en memoria» y «OOM bajo carga» es menor de lo que parece, porque un batch de peticiones de contexto largo puede consumir más memoria de KV de la esperada. La prevención combina una reserva de memoria medida con la cuantización y la asignación paginada del KV. En vLLM, --gpu-memory-utilization fija la fracción de memoria de la GPU que el motor puede usar para pesos, activaciones y KV cache; el resto es la reserva. En las cargas con mucha presión sobre el KV, LMCache puede descargar datos de KV a la memoria de la CPU o a disco; usa sus resultados publicados como punto de partida y haz benchmark de la jerarquía de memoria local.
La preemption ocurre cuando la presión sobre el KV cache obliga al planificador a expulsar o recalcular trabajo. La estrategia exacta depende de la versión y de la configuración de serving. Desde el lado del usuario, el síntoma es una latencia de extremo a extremo mayor sin un error evidente de la aplicación. Vigila el número de preemptions y correlaciónalo con el uso de KV, la profundidad de la cola y las longitudes de las peticiones.
La latencia de percentiles altos puede dispararse cuando los prefills grandes retrasan el trabajo de decode. El chunked prefill (Sección 7) y la planificación que tiene en cuenta la longitud atacan esta interferencia. El planificador Learning-to-Rank (Fu et al., 2024) y los artículos de CascadeInfer informan de mejoras sobre sus referencias en las cargas que evaluaron, pero el resultado exacto depende de la distribución de longitudes de las peticiones y de la configuración del planificador.
Los fallos en cascada pueden empezar cuando las peticiones lentas hacen crecer la cola, los clientes de origen agotan el tiempo de espera y los reintentos añaden más carga. Las defensas incluyen el control de admisión, los límites de concurrencia por tenant, los límites de salida, los presupuestos de reintentos y los circuit breakers en el gateway. Los pools de prefill y de decode desagregados pueden ayudar cuando las pruebas de carga muestran una interferencia persistente entre fases. La figura muestra el bucle y la defensa de cada arista.
43. Monitorización de sistemas LLM
La monitorización de LLM se diferencia de la de una API en tres aspectos: cada petición tiene un coste distinto, cada petición tiene dos fases con cuellos de botella diferentes, y su huella de memoria depende de la longitud tanto de la entrada como de la salida. La latencia de las peticiones y la tasa de errores no muestran por sí solas ninguno de ellos.
El goodput es el número de peticiones por segundo que cumplen todos los umbrales de SLO definidos, como TTFT, TPOT y latencia total. Es una medida combinada útil porque el throughput bruto puede parecer sano mientras fallan los SLO de latencia: un sistema que procesa 100 peticiones por segundo pero incumple sus umbrales en el 40 % de ellas tiene un goodput de 60 peticiones por segundo. Optimizar el goodput mantiene visible la distribución del rendimiento en lugar de informar solo de la media.
vLLM expone un endpoint de Prometheus en /metrics con las peticiones en ejecución y en espera, el uso del KV cache, las distribuciones de longitud de generación y las estadísticas de la caché de prefijos. Los nombres de las métricas pueden cambiar entre versiones, así que vincula los dashboards a la versión desplegada. Un stack típico usa Prometheus para las métricas, Grafana para la visualización y trazas compatibles con OpenTelemetry entre los componentes de la aplicación y del serving.
Estos son patrones de alerta útiles. Deriva sus umbrales de las pruebas de carga en lugar de copiar estos ejemplos sin cambios:
- Picos en el número de preemptions: el runtime está haciendo swapping o recalculando trabajo, lo que añade latencia sin un error de la aplicación.
- Uso del KV cache cerca de la región de preemption probada: añade capacidad o descarta carga antes de que las expulsiones se encadenen.
- Profundidad de la cola de forma persistente por encima del rango de batch probado: el control de admisión debería empezar a rechazar o a despriorizar.
- El TTFT sube mientras el TPOT se mantiene estable: esta divergencia apunta primero a la cola, a la admisión, a la red o a la presión del prefill, y no al throughput del decode. Usa las trazas y las métricas de la cola para distinguirlos.
En vLLM, las tres primeras alertas se corresponden con vllm:num_preemptions_total, vllm:kv_cache_usage_perc y vllm:num_requests_waiting (métricas de vLLM).
44. Optimización de costes: una estrategia acumulativa
Los precios de los proveedores y las relaciones entre el precio de entrada y el de salida cambian. Consulta las tarifas actuales antes de tomar una decisión de compra; el nivel del modelo y la longitud de la salida pueden dominar la factura incluso antes de las optimizaciones de infraestructura.
OpenAI, Anthropic y Google cobran los tokens de salida de sus modelos principales varias veces más caros que los de entrada. Por separado, la división entre prefill y decode explica por qué entrada y salida tienen costes de ejecución distintos: el prefill procesa juntos los tokens del prompt, mientras que el decode ordinario genera tokens secuencialmente. Ese mecanismo por sí solo no demuestra cómo un proveedor fija sus precios comerciales. Reducir la salida innecesaria (un max_tokens ajustado, structured output, no repetir la entrada) suele ahorrar más que eliminar el mismo número de tokens de entrada.
Se pueden combinar varios enfoques, pero solo después de medir cuáles se aplican a la carga de trabajo:
- La cuantización de FP16 a INT4 reduce el almacenamiento bruto de valores de pesos un 75 %, antes de escalas y otros metadatos. Que eso reduzca la factura depende de la velocidad del kernel, del tamaño del batch y de la utilización del hardware (Sección 9).
- El model routing envía el tráfico apto a modelos más baratos. Mide la tasa de falsos aceptados del router y la calidad de extremo a extremo antes de aumentar la proporción que atiende el modelo más barato (Sección 36).
- El prompt caching reduce el trabajo de los prefijos repetidos. Los descuentos de los proveedores y el tratamiento de los límites de tasa cambian con el tiempo, así que combina la tasa de aciertos medida con las condiciones actuales (Sección 16).
- Las APIs de batch pueden descontar el trabajo que no es en tiempo real, como las evaluaciones, la generación de datos sintéticos y la clasificación masiva. Comprueba los precios actuales y los plazos de finalización.
- El autoalojamiento puede salir ganando con una utilización sostenida, pero no hay un punto de equilibrio universal en volumen de tokens. Incluye los costes de ingeniería, de orquestación, de observabilidad, de holgura de capacidad y de guardias, además del alquiler de GPU.
No multipliques mejoras de optimización independientes como si todas las peticiones se beneficiaran por separado: la cuantización cambia el throughput, el routing cambia la mezcla de calidad, y el cache y el batching solo se aplican al tráfico apto. Construye la estimación con proporciones de tráfico medidas y valídala frente a la factura.
45. Planificación de capacidad y autoscaling
La planificación de capacidad para el serving de LLM debe tener en cuenta el coste variable de las peticiones, el trabajo de decode de larga duración y la memoria que depende de la secuencia. Según la carga de trabajo, el recurso limitante puede ser la memoria del KV, el ancho de banda de memoria, el cómputo o la interconexión.
El límite teórico de memoria para solicitudes concurrentes procede del presupuesto de KV cache:
Para hacer la aritmética de capacidad, supón que el runtime expone un presupuesto de KV de 40 GiB para Llama 3.1 70B con un KV cache en FP16. Cada secuencia de 4K usa unos 1,25 GiB y cada secuencia de 128K unos 40 GiB. Por tanto, ese presupuesto admite como máximo unas 32 secuencias de 4K o una de 128K antes de contar la sobrecarga del allocator, del runtime, de la variación de la carga y del SLO. La función kv_cache_bytes de la Sección 6 repite este cálculo con otro modelo o presupuesto. Por eso la selección de GPU y la optimización del KV cache determinan directamente el plan de capacidad.
La fórmula de capacidad para dimensionar la flota:
Convierte ambas tasas a la misma unidad temporal antes de dividir. Usa el throughput por GPU medido en el SLO objetivo, no el throughput máximo. Un multiplicador de 1,3 provisiona un 30 % más de throughput que la demanda prevista, lo que deja aproximadamente un 23 % de la capacidad provisionada sin usar a esa demanda. Redondea hacia arriba a réplicas de serving completas; una réplica TP/PP necesita todo su grupo de GPUs. Las tasas por GPU solo son útiles para una topología de réplica fija y medida. Elige el multiplicador según las ráfagas, los fallos y el tiempo de recuperación medidos. El throughput máximo de tokens y el que cumple el SLO pueden diferir mucho cuando aumenta la concurrencia. Haz el benchmark con la distribución real de longitudes de prompt y salida en los umbrales requeridos de TTFT y TPOT, en lugar de usar un máximo teórico.
La utilización de la GPU no basta como única señal de autoscaling, porque puede mantenerse alta tanto durante un procesamiento sano como durante una sobrecarga. Combínala con la profundidad de la cola, la utilización del KV cache y la degradación del goodput. Ajusta los umbrales a partir de pruebas de carga; valores como un 80 % de utilización del KV son puntos de partida, no límites universales. Estas métricas se presentan en la Sección 43.
El scale-to-zero puede encajar en entornos de desarrollo y de staging con largos periodos de inactividad. Las plataformas de inferencia serverless y los autoscalers basados en Kubernetes, como KEDA, pueden eliminar la capacidad ociosa, pero el ahorro y el tiempo de arranque en frío dependen del tamaño del modelo, de la caché de imágenes y de pesos y de la infraestructura. Mide el tiempo de arranque antes de usar la misma política con tráfico de producción sensible a la latencia.
Cómo se conectan los conceptos de inferencia
Las partes I a III relacionan la capacidad de memoria con el rendimiento del serving. El tamaño KV por secuencia (Sección 6) da un límite bruto de secuencias residentes. Los batches de decode mayores pueden mejorar la reutilización de pesos y la intensidad aritmética (Sección 1), pero el tráfico de atención, la planificación y la comunicación también afectan a TPOT y throughput. GQA y el almacenamiento KV de menor precisión reducen los datos del cache; PagedAttention reduce el desperdicio de asignación. Con la disposición indicada de Llama 3.1 70B, un KV cache FP16 y un presupuesto de 40 GiB, el límite bruto es de 32 secuencias de 4K tokens o una de 128K, antes de la sobrecarga del runtime y las restricciones de latencia. El control de admisión puede encolar o rechazar trabajo antes de alcanzar ese límite. Bajo presión KV, el runtime puede suspender peticiones; las asignaciones sin control pueden causar OOM (Sección 42).
El routing, el caching, la cuantización y la elección del hardware se acumulan solo cuando cada uno se evalúa frente al mismo objetivo de calidad y de latencia. Elige un síntoma de la tabla del principio, establece esa línea base y haz que el siguiente cambio sea fácil de revertir.
Lecturas adicionales
Artículos relacionados de este blog, organizados por tema:
- Guía de fine-tuning de LLM — cuándo hacer fine-tuning, cuándo usar RAG y cuándo prompt engineering
- Open-Source LLM Variants and File Formats — cómo ajustar las variantes de modelos y los formatos cuantizados al hardware
- Guía de LoRAX Serving — servir miles de adaptadores LoRA en producción
- Scaling Large Language Models — estrategias multi-GPU y multinodo
- Local LLMs on macOS — configuración práctica con llama.cpp y Ollama
- AI Agent Reasoning Loops in 2026 — análisis en profundidad de los bucles ReAct, ReWOO y planner-executor
- AI Agent Memory Architecture in 2026 — checkpoints, almacenes de vectores y memoria de documentos para agentes con estado
Referencias
Organizadas por área temática.
Inferencia y atención
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness - Dao et al., NeurIPS 2022
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning - Dao, 2023
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision - Shah et al., NeurIPS 2024
- Flash-Decoding for long-context inference - Dao et al., 2023
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022
- GQA: Training Generalized Multi-Query Attention - Ainslie et al., 2023
- Triton: an intermediate language and compiler for neural network computations - Tillet et al., MAPL 2019
- FlashNorm: Fast Normalization for LLMs - 2024
- Deep Kernel Fusion for Transformers - DeepFusionKernel, 2026
Speculative decoding
- Accelerating Large Language Model Decoding with Speculative Sampling - Chen et al., 2023
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models - Li et al., NeurIPS 2025
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - ICML 2024
Cuantización
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration - MLSys 2024 Best Paper
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers - Frantar et al., ICLR 2023
- Marlin: Mixed-Precision (FP16xINT4) LLM Inference Kernel - Frantar et al., 2024
Entrenamiento y fine-tuning
- LoRA: Low-Rank Adaptation of Large Language Models - Hu et al., ICLR 2022
- QLoRA: Efficient Finetuning of Quantized LLMs - Dettmers et al., NeurIPS 2023
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models - Rajbhandari et al., SC20
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning - Rajbhandari et al., 2021
- Self-Instruct: Aligning Language Models with Self-Generated Instructions - Wang et al., ACL 2023
- WizardLM: Empowering Large Language Models to Follow Complex Instructions - Xu et al., ICLR 2024
- Phi-4 Technical Report - Microsoft, 2024
- Training Deep Nets with Sublinear Memory Cost - Chen et al., 2016 (gradient checkpointing)
- AI models collapse when trained on recursively generated data - Shumailov et al., Nature 2024
Alineamiento
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model - Rafailov et al., NeurIPS 2023
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models - Introdujo GRPO
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning - DeepSeek, 2025
Escalado y arquitectura
- The Llama 3 Herd of Models - Meta, 2024
- LLaMA: Open and Efficient Foundation Language Models - Touvron et al. (Meta), 2023
- Llama 2: Open Foundation and Fine-Tuned Chat Models - Touvron et al. (Meta), 2023
- Qwen3 Technical Report - Qwen Team (Alibaba), 2025
- Training Compute-Optimal Large Language Models - Hoffmann et al. (Chinchilla), NeurIPS 2022
- RoFormer: Enhanced Transformer with Rotary Position Embedding - Su et al., 2021
- YaRN: Efficient Context Window Extension of Large Language Models - Peng et al., ICLR 2024
- SGLang: Efficient Execution of Structured Language Model Programs - Zheng et al., NeurIPS 2024
- Mixtral of Experts - Jiang et al. (Mistral AI), 2024
Embeddings
- Matryoshka Representation Learning - Kusupati et al., NeurIPS 2022
- pplx-embed-v1: Diffusion-Pretrained Dense and Contextual Embeddings - Perplexity AI, 2026
Arquitecturas de agentes
- ReAct: Synergizing Reasoning and Acting in Language Models - Yao et al., ICLR 2023
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models - Xu et al., 2023
Prompting
- Large Language Models are Zero-Shot Reasoners - Kojima et al., NeurIPS 2022
- Self-Consistency Improves Chain of Thought Reasoning in Language Models - Wang et al., ICLR 2023
Routing
- RouteLLM: Learning to Route LLMs with Preference Data - Ong et al., ICLR 2025
Benchmarks
- MLPerf Inference v5.0 Results - MLCommons, abril de 2025
Arquitecturas de serving
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve - Agrawal et al., OSDI 2024 (chunked prefill)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting - Patel et al., ISCA 2024 (serving desagregado)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving - Zhong et al., OSDI 2024 (serving desagregado)
Frameworks de serving
- vLLM - motor de serving basado en PagedAttention
- SGLang - RadixAttention y generación estructurada
- TensorRT-LLM - inferencia optimizada de NVIDIA
- llama.cpp - inferencia portable en C/C++
- DeepSpeed - biblioteca de entrenamiento distribuido de Microsoft
- Ollama - ejecutor local de LLM
Operaciones
- Efficient LLM Scheduling by Learning to Rank - Fu et al., NeurIPS 2024 (vLLM-LTR)
- CascadeInfer: Length-Aware Scheduling of LLM Serving with Low Latency and Load Balancing - Yuan et al., 2025
- Goodput metric as measure of ML productivity - Google Cloud, 2024
- vLLM Optimization and Tuning - documentación de vLLM
- vLLM Metrics - documentación de vLLM
- LMCache: KV Cache Management for LLM Serving - descarga del KV cache
- OpenAI Rate Limits - documentación de la API de OpenAI
- Anthropic Rate Limits - documentación de la API de Anthropic