Guia de Engenharia de LLM: 45 conceitos para sistemas de produção

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Esta é uma referência para engenheiros que já conhecem os conceitos básicos de ML e de sistemas e precisam de ligar um sintoma em produção à parte relevante da stack. Cobre 45 conceitos de hardware, inferência, treino, deployment, aplicações e operações. Cada entrada apresenta o mecanismo, o que ele muda num sistema em execução e a condição em que o resultado citado se verifica. Se partir de um sintoma, como um primeiro token lento ou OOM sob carga, use a tabela de sintomas abaixo para encontrar as entradas a ler.
Para uma pergunta específica, consulte as respostas rápidas sobre engenharia de LLM. Cada tema tem uma resposta própria e liga à secção correspondente deste guia.
| Parte | Tópicos | Secções |
|---|---|---|
| I — Fundamentos do hardware | Modelo roofline, memória da GPU, glossário de hardware | 1–3 |
| II — Fundamentos da inferência | Latência, throughput, KV cache, attention, quantização | 4–9 |
| III — Otimizações de inferência | Kernels CUDA, FlashAttention, batching, PagedAttention, descodificação especulativa | 10–17 |
| IV — Arquitetura do modelo | Componentes internos do Transformer, decoder-only, MoE, tokenização, janelas de contexto | 18–22 |
| V — Treino e alinhamento | Pretraining, LoRA, precisão mista, ZeRO, leis de escala, RLHF/DPO/GRPO, distillation | 23–32 |
| VI — Escalonamento e deployment | Paralelismo, frameworks de serving, seleção de GPUs, routing | 33–36 |
| VII — Aplicações | Embeddings, RAG, agentes, prompt engineering | 37–40 |
| VIII — Operações em produção | Rate limiting, modos de falha, monitorização, custo, planeamento de capacidade | 41–45 |
Comece por um sintoma
Cada linha indica as entradas a ler primeiro e o que medir antes de alterar a stack.
| Sintoma ou decisão | Comece por | Meça antes de alterar a stack |
|---|---|---|
| O primeiro token é lento | Prefill e decode, TTFT | Tempo em fila, comprimento do prompt, tempo de prefill e TTFT P99 |
| Os tokens chegam devagar | Roofline, TPOT | TPOT por concorrência, largura de banda de memória e forma do batch |
| Contextos longos causam preempção ou OOM | KV cache, PagedAttention | Uso de KV, comprimentos dos pedidos, desperdício do alocador e número de preempções |
| Um modelo não cabe no orçamento | Quantização, Seleção de GPUs | Qualidade, throughput dos kernels, reserva de memória e goodput no SLO alvo |
| Escolher um runtime de serving | Frameworks de serving, Paralelismo | Throughput e latência P99 no SLO alvo, com os seus próprios prompts |
| Os pedidos expiram sob carga | Modos de falha, Rate limiting | Profundidade da fila, preempções, taxa de retries e comprimentos das respostas |
| Um treino não cabe | LoRA e QLoRA, ZeRO, FSDP | Memória do estado do modelo, comunicação, throughput e qualidade num conjunto de validação |
| O custo está a subir | Routing, otimização de custos | Elegibilidade do tráfego, erros de qualidade, taxa de acertos da cache e dados da fatura |
Guias mais aprofundados por decisão
| Se está a decidir… | Comece por | Depois leia |
|---|---|---|
| Como servir muitos adaptadores fine-tuned | Fundamentos da inferência e deployment | Guia de serving com LoRAX |
| Se deve quantizar | Quantização | Guia de quantização de modelos |
| Como dividir um modelo por várias GPUs | Paralelismo | Escalar modelos de linguagem grandes |
| Se deve fazer fine-tuning | Treino e alinhamento | Guia de fine-tuning de LLM |
| Como a recuperação se encaixa numa aplicação | Embeddings e RAG | Métricas de avaliação de RAG |
| Como funcionam os sistemas de agentes | Agentes e prompt engineering | Reasoning loops de agentes AI |
| Como ordenar resultados de pesquisa | Embeddings e reranking | Stack de ranking de pesquisa |
Parte I — Fundamentos do hardware
A intensidade aritmética, a hierarquia de memória da GPU e os termos de hardware desta parte explicam muitas das escolhas feitas mais adiante no guia.
1. Memory-bound vs compute-bound e o modelo roofline
O ponto de partida para o desempenho de um LLM é a intensidade aritmética: por cada byte de dados que a GPU carrega da memória, quantos cálculos úteis realiza? Essa razão decide se uma operação é compute-bound (à espera do processador) ou memory-bound (à espera de que os dados sejam carregados).
Cada GPU tem uma intensidade “crítica”, o limiar em que o pico de computação iguala a largura de banda de memória. Para uma NVIDIA H100 SXM com Tensor Cores BF16 ou FP16 densos (989 TFLOPS; a especificação de 1979 TFLOPS pressupõe sparsity estruturada):
O gráfico roofline abaixo representa a computação atingível em função da intensidade aritmética. A linha inclinada é a região memory-bound, onde a largura de banda define o limite; a linha horizontal é o throughput máximo de computação; o ponto de encontro das duas é o limiar de 295 FLOPs/byte.
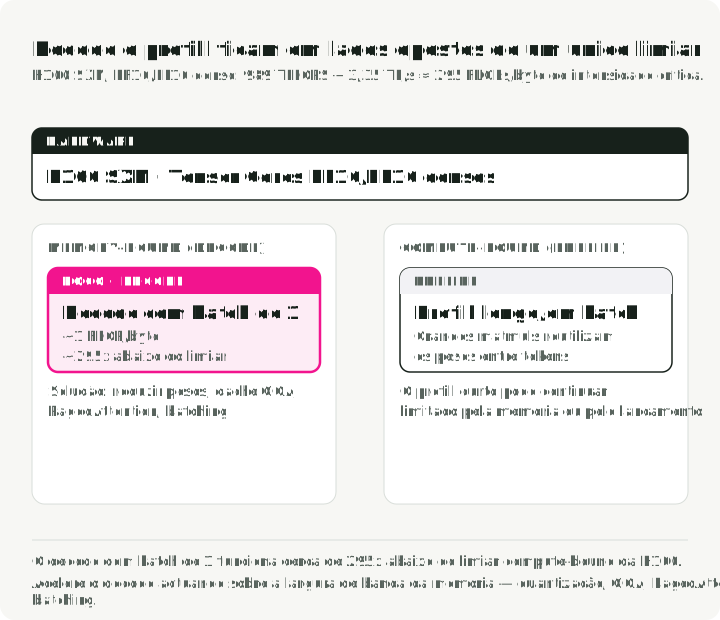
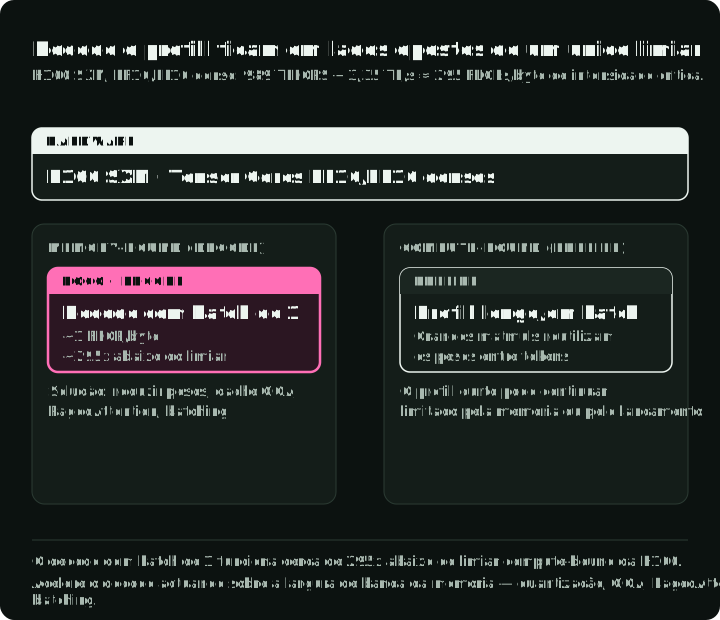
O decode com batch de um e o prefill longo ou suficientemente agrupado em batches ficam, geralmente, em lados opostos deste limiar:
- O decode é memory-bound. Gerar tokens um a um obriga a carregar da memória a matriz de pesos, com vários gigabytes, para a multiplicar por um único token novo. Numa análise simplificada de um modelo denso de 16 bits com batch de um, a operação tem cerca de 1 FLOP/byte, aproximadamente 295x abaixo do limiar roofline da H100. Esta diferença explica por que razão o decode não consegue aproximar-se do pico de computação neste regime.
- O prefill longo ou suficientemente agrupado em batches é muitas vezes compute-bound. Processar muitos tokens do prompt reutiliza os pesos em grandes multiplicações de matrizes, o que pode elevar a intensidade aritmética acima do limiar roofline. Prompts curtos e batches pequenos podem, em vez disso, ficar limitados pelo tráfego de memória ou pelo overhead de lançamento de kernels.
Assim, para acelerar o decode, trabalhe a largura de banda de memória: reduza os pesos com quantização, reduza o overhead de memória do KV com GQA e PagedAttention, e aumente a intensidade com batching. Para prefills longos ou bem agrupados em batches, uma computação matricial mais rápida e computação de menor precisão podem ajudar; analise separadamente, com profiling, as cargas de prefill curto.
2. Hierarquia de memória da GPU
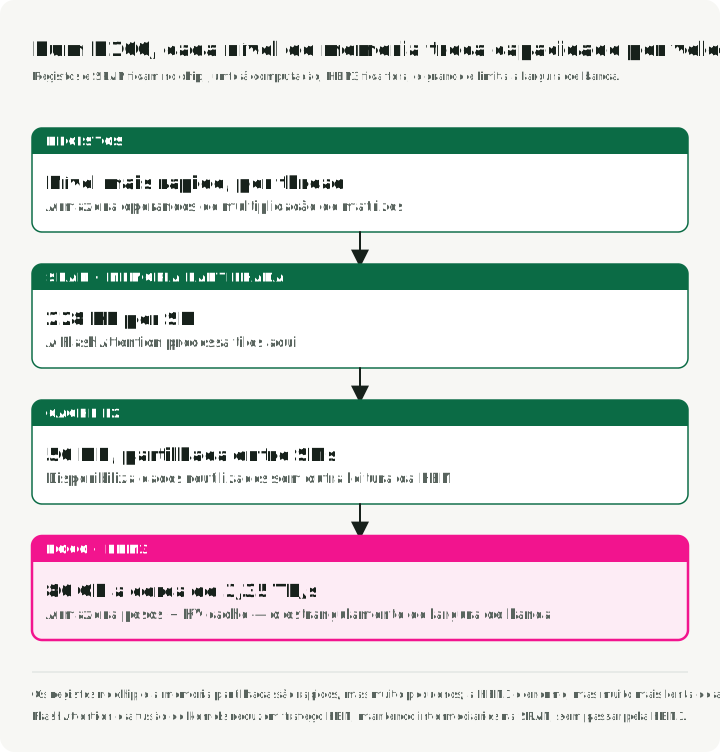
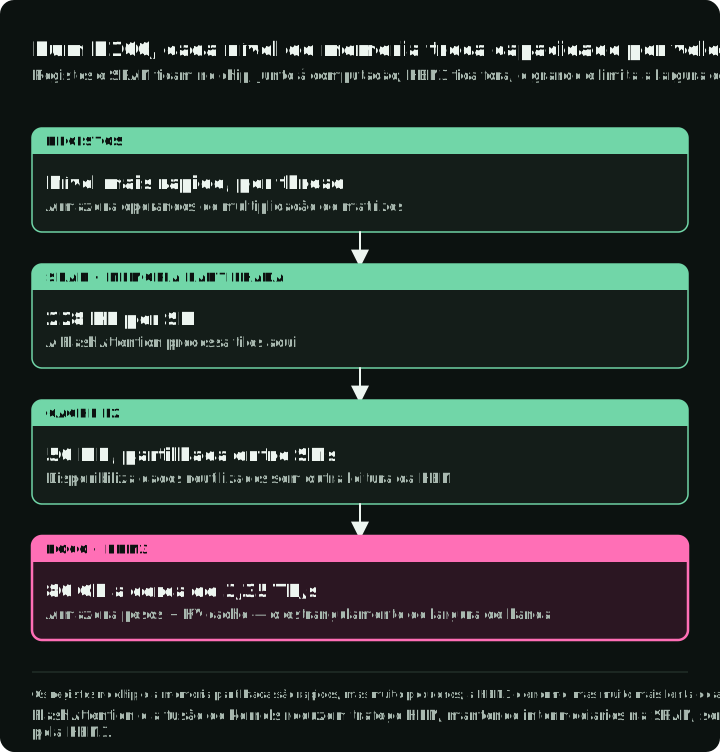
Uma GPU tem quatro camadas de memória com capacidades e velocidades de acesso diferentes. Os registos são pequenos e rápidos; a HBM guarda muito mais dados, mas o acesso é mais demorado. Mover dados entre estas camadas é uma restrição importante de desempenho. A figura mostra uma H100 SXM: registos e memória partilhada dentro de cada SM, a L2 no die e 80 GB de HBM3 em pilhas ao lado.
Do mais rápido para o mais lento numa H100 SXM:
- Os registos são a memória mais rápida e estão ligados diretamente às threads de processamento. No WGMMA da Hopper, a matriz A pode vir dos registos ou da memória partilhada, enquanto a matriz B vem da memória partilhada.
- A SRAM (memória partilhada) é uma memória de trabalho rápida, no chip, local a cada SM.
- A cache L2 é uma camada partilhada de 50 MB. Pode fornecer dados reutilizados entre SMs sem nova leitura da HBM.
- A HBM3 é a memória principal de 80 GB que guarda os pesos do modelo e a KV cache, com ~3,35 TB/s de largura de banda.
A diferença entre os níveis no chip e fora do chip é grande. Numa A100, o artigo do FlashAttention estima a largura de banda da SRAM no chip em cerca de 19 TB/s, contra 1,5–2,0 TB/s da HBM (Dao et al., 2022), ou seja, uma diferença de aproximadamente 10x. O FlashAttention e a fusão de kernels reduzem o tráfego para a HBM ao reter ou combinar trabalho intermédio no chip. O PagedAttention ataca outro problema: mapeia blocos lógicos da KV cache para blocos físicos não contíguos da memória da GPU, o que reduz a fragmentação e permite a partilha de blocos.
3. Glossário do hardware de GPU
Os termos abaixo aparecem ao longo do resto do guia.
HBM (High Bandwidth Memory) empilha dies de DRAM ligados por through-silicon vias (TSVs) junto ao die da GPU. As gerações incluem HBM2e (A100, 2 TB/s), HBM3 (H100, 3,35 TB/s) e HBM3e (H200/B200, 4,8–8 TB/s). A largura de banda da HBM é uma restrição direta do TPOT nos regimes de decode memory-bound.
GDDR (Graphics DDR) é a memória gráfica tradicional usada em GPUs de consumo e de workstation, como a RTX 4090 e a L40S. Estas placas têm menos largura de banda de memória do que a H100 SXM. A GDDR6X da RTX 4090 oferece 1008 GB/s segundo o whitepaper da arquitetura Ada da NVIDIA, contra os 3,35 TB/s de HBM3 da H100 SXM.
Um SM (Streaming Multiprocessor) é o bloco básico de computação de uma GPU NVIDIA. Cada SM contém CUDA cores, Tensor Cores, memória partilhada e um warp scheduler. A H100 SXM tem 132 SMs; a H100 PCIe tem 114. A A100 tem 108.
Os Tensor Cores são unidades especializadas de multiplicação e acumulação de matrizes dentro de cada SM. Aceleram as multiplicações de matrizes de precisão mista que dominam a computação dos transformers. Os Tensor Cores da H100 SXM oferecem 494,5 TFLOPS TF32 densos ou 989 esparsos; inclua sempre a precisão e o modo de sparsity ao comparar este valor.
Os CUDA Cores são unidades de uso geral de vírgula flutuante e de inteiros. Tratam das operações elemento a elemento, das funções de ativação e de outro trabalho que não é matricial, enquanto os Tensor Cores executam as operações matriciais suportadas.
Um warp é um grupo de 32 threads num SM. As threads podem divergir, e as GPUs Volta e posteriores suportam escalonamento independente de threads. A especialização de warps atribui warps diferentes ao movimento de dados e à computação, para que as tarefas se sobreponham.
O NVLink é a interligação de alta velocidade entre GPUs da NVIDIA dentro de um nó. O NVLink 4.0 da H100 oferece 900 GB/s de largura de banda bidirecional; o NVLink 5.0 da B200 chega a 1,8 TB/s. Esta largura de banda é importante para o paralelismo de tensores, porque as GPUs trocam resultados parciais em cada camada do transformer.
A InfiniBand é uma rede de alta velocidade para comunicação entre nós. Os adaptadores InfiniBand da classe ConnectX fornecem a rede entre nós para o tráfego de pipeline paralelo ou de treino distribuído; a largura de banda depende do adaptador e da configuração das portas.
O RDMA (Remote Direct Memory Access) permite que um dispositivo aceda à memória de outra máquina sem que o caminho dos dados passe por qualquer um dos CPUs. O GPUDirect RDMA suporta transferências diretas de GPU para GPU entre nós, incluindo transferências de KV cache em serving desagregado.
O NVMe (Non-Volatile Memory Express) é a interface de SSD usada para o offloading da KV cache e para o offloading de parâmetros do ZeRO-Infinity quando a memória da GPU e do CPU é insuficiente. A largura de banda sequencial depende do disco e da carga de trabalho, e continua muito abaixo da largura de banda da HBM.
TFLOPS e PFLOPS são biliões e mil biliões de operações de vírgula flutuante por segundo. Um TFLOPS equivale a FLOPS. A H100 chega a 989 TFLOPS TF32 esparsos nos tensor cores, enquanto o FlashAttention-3 reporta cerca de 1,2 PFLOPS em FP8; estes valores usam formatos diferentes e não devem ser comparados como se fossem a mesma métrica.
Parte II — Fundamentos da inferência
A inferência transforma um modelo num serviço visível para o utilizador. Os conceitos seguintes separam o trabalho que atrasa o primeiro token do trabalho que atrasa todos os tokens seguintes, e mostram os limites de memória por trás de ambos.
4. Latência: TTFT, TPOT e percentis
O Time to First Token (TTFT) é o atraso de ponta a ponta desde o envio do pedido até ao primeiro token de saída. Inclui fila, tokenização, escalonamento, a passagem de prefill que produz o primeiro token e a entrega pela rede. Os motores de serving mais comuns amostram o primeiro token de saída a partir dos logits da passagem forward do prefill, pelo que nenhum passo de decode separado corre antes dele. Prompts mais longos aumentam normalmente a componente de prefill, mas qualquer uma destas fases pode dominar. Os objetivos dependem do produto; o MLPerf Inference v5.0 usa um limite de TTFT P99 de 450 ms no seu cenário interativo com Llama 2 70B.
O Time Per Output Token (TPOT) é o intervalo médio entre tokens consecutivos depois do primeiro. Corresponde à fase de decode. O decode com batch de um ou de baixa intensidade é normalmente limitado pela largura de banda de memória, enquanto batches suficientemente grandes podem tornar-se compute-bound:
Esta definição requer pelo menos dois tokens de saída; o TPOT não está definido para uma resposta com um único token. Nesta equação, a latência E2E termina no último token de saída. Um temporizador que mede até à conclusão do HTTP pode incluir metadados posteriores ou o encerramento da ligação; registe esse tempo separadamente.
Uma estimativa da velocidade de leitura em inglês dá uma referência aproximada para o streaming. A velocidade média de leitura silenciosa de um adulto em inglês é de cerca de 238 palavras por minuto para não ficção (Brysbaert, 2019), ou seja, cerca de 4 palavras por segundo. Se um token corresponder, em média, a três quartos de uma palavra, isso dá cerca de 5 tokens por segundo, ou 200 ms por token. Esta estimativa não é um limiar de usabilidade: a língua, o tokenizador, a tarefa e o buffering do cliente alteram o resultado. O cenário interativo do MLPerf usa um limite de TPOT P99 muito mais apertado, de 40 ms. Defina o seu próprio objetivo com testes de produto.
A latência P50 vs P99 é relevante porque a mediana esconde a cauda. Um sistema com bom P50 e mau P99 pode ter problemas de batching, preempção, filas ou enviesamento da carga; são necessários traces para os distinguir.
5. Throughput: tokens por segundo e o compromisso com a latência
O throughput mede-se em tokens de saída por segundo entre pedidos concorrentes. Os pedidos por segundo, por si sós, dizem menos, porque uma resposta de 10 tokens e uma de 1000 tokens têm custos muito diferentes. Os números de benchmarks publicados variam com o modelo, a precisão, o hardware, os comprimentos do prompt e da saída, a concorrência e o SLO. Compare vLLM, SGLang e TensorRT-LLM com um único harness, em vez de combinar os resultados de destaque de cada um.
Aumentar um batch pequeno de decode pode elevar o throughput ao partilhar as leituras dos pesos. Batches maiores ou uma carga oferecida mais elevada acabam por aumentar a latência ou atingir limites de memória, computação ou comunicação. Meça essa curva em vez de assumir uma escala linear. O goodput, a taxa de pedidos por segundo que cumprem os objetivos do SLO, liga o throughput bruto àquilo que os utilizadores realmente sentem.
6. KV cache: memória que cresce a cada token
Durante a geração autorregressiva com attention completa, cada novo token atende ao token atual e aos anteriores. A KV cache guarda as projeções Key e Value para que a geração não recalcule as projeções dos tokens anteriores em cada passo. O decode com attention completa continua a ler um histórico crescente; o trabalho total de attention numa sequência gerada continua a ser quadrático no seu comprimento.
Numa cache convencional de MHA ou GQA com attention completa, a memória cresce linearmente com o comprimento da sequência, o tamanho do batch e o número de camadas. A fórmula seguinte não se aplica sem alterações a arquiteturas MLA, de janela deslizante, recorrentes ou híbridas:
em que:
- = número de camadas
- = número de KV heads
- = dimensão da head
- = comprimento da sequência
- = tamanho do batch
- = bytes por elemento em cache, definidos pela precisão da KV cache
Exemplos concretos com FP16 e batch de 1: o Llama 3.1 8B com 8192 tokens usa ~1,07 GB (1 GiB) de KV cache; com 128K tokens, 16 GiB. O Llama 3.1 70B com 128K tokens precisa de 40 GiB (cerca de 43 GB) para uma única sequência, aproximadamente metade dos 80 GB de uma H100. Com alta concorrência ou contexto longo, a KV cache pode exceder a memória dos pesos do modelo; o resultado depende do comprimento da sequência, do tamanho do batch ativo, da precisão da KV e do número de KV heads. A avaliação original do vLLM em 2023 reportou 60–80% de desperdício por fragmentação e pré-alocação nos sistemas que comparou.
As principais otimizações são o GQA (menos KV heads), a quantização da KV cache (FP8/INT8), o PagedAttention (alocação por blocos) e o offloading de dados KV reutilizáveis para CPU ou NVMe. Os benefícios dependem da carga de trabalho e da implementação.
Para responder a “quantas sequências cabem no meu orçamento de KV?” para outro modelo, leia três números do seu config.json: num_hidden_layers, num_key_value_heads e head_dim, quando existir. Nos exemplos Llama, a dimensão da head é hidden_size / num_attention_heads. A memória por dispositivo também depende do sharding da cache e de eventual replicação das KV heads. A função abaixo aplica a fórmula; os asserts reproduzem os números acima e o exemplo de capacidade da Secção 45.
def kv_cache_bytes(layers, kv_heads, head_dim, seq_len, batch=1, bytes_per_elem=2):
    """Bytes of KV cache: a key and a value per layer, KV head, and token."""
    return 2 * layers * kv_heads * head_dim * seq_len * batch * bytes_per_elem

GiB = 2**30

# Llama 3.1 8B: 32 layers, 8 KV heads, head dimension 128, FP16 cache.
llama_8b = kv_cache_bytes(32, 8, 128, seq_len=8_192)
print(f"8B at 8K tokens: {llama_8b / 1e9:.2f} GB")  # 1.07 GB
assert llama_8b == 1 * GiB

# Llama 3.1 70B: 80 layers, 8 KV heads, head dimension 128.
assert kv_cache_bytes(80, 8, 128, seq_len=131_072) == 40 * GiB

# How many 4K-token sequences fit in a 40 GiB KV budget?
per_4k = kv_cache_bytes(80, 8, 128, seq_len=4_096)
print(f"70B at 4K tokens: {per_4k / GiB:.2f} GiB per sequence")  # 1.25 GiB
print("4K sequences in 40 GiB:", 40 * GiB // per_4k)  # 32
assert 40 * GiB // per_4k == 32

# An FP8 KV cache halves the size per sequence and doubles the count.
assert 40 * GiB // kv_cache_bytes(80, 8, 128, 4_096, bytes_per_elem=1) == 64
O resultado é um limite superior. O runtime também precisa de memória para ativações, overhead do alocador e margem para a variação do comprimento dos pedidos.
7. Prefill vs decode: duas fases, dois bottlenecks
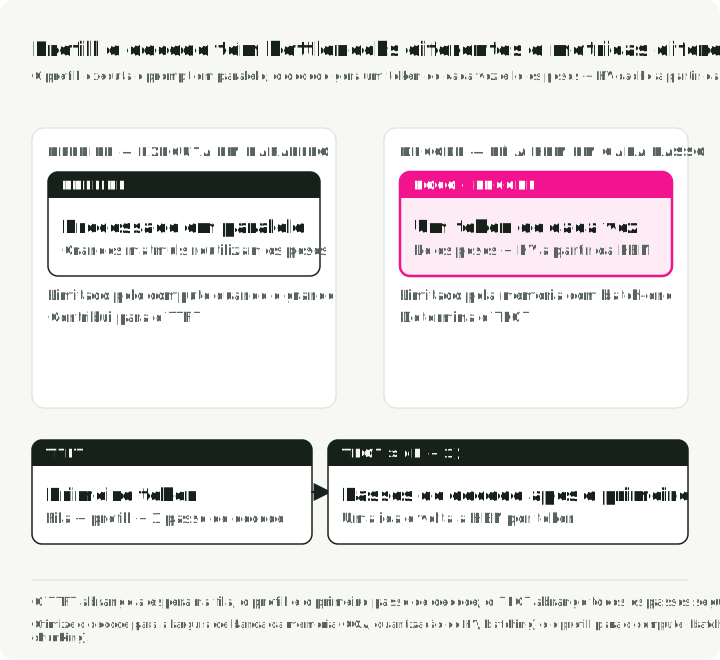
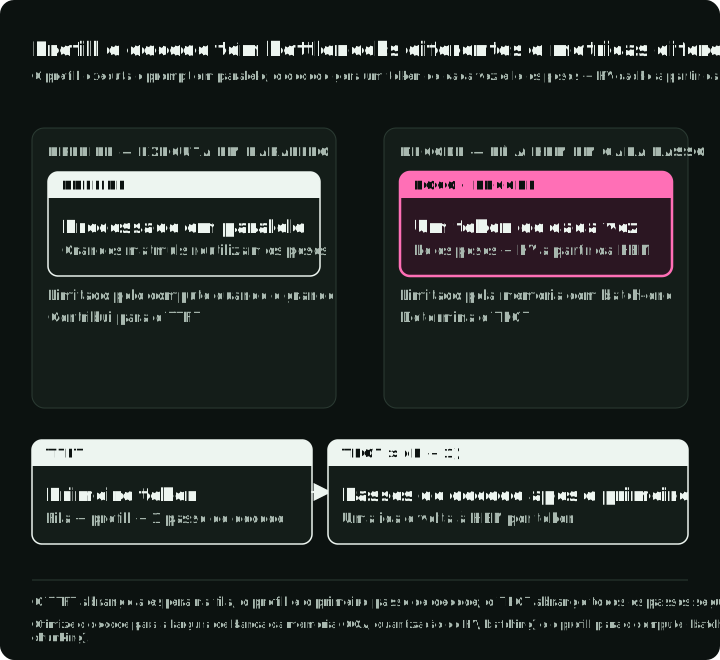
A fase de prefill processa o prompt de entrada em paralelo e preenche a KV cache. Os prefills longos ou suficientemente agrupados em batches tornam-se muitas vezes compute-bound porque usam grandes multiplicações de matrizes; os prefills curtos podem continuar limitados pelo tráfego de memória ou pelo overhead de lançamento de kernels. O prefill contribui para o time to first token (TTFT), a par da fila, da tokenização, do escalonamento e da entrega pela rede; a sua passagem forward também produz o primeiro token de saída. A fase de decode gera um token de cada vez. Cada passo lê os pesos do modelo e a KV cache da HBM, o que torna o decode com batch de um limitado pela largura de banda de memória e o principal responsável pelo time per output token (TPOT).
A figura acompanha um pedido: o prefill reutiliza os pesos entre os tokens do prompt e termina com o primeiro token, dentro do TTFT; cada passo posterior de descodificação volta a ler os pesos e o KV cache para um token e contribui para o TPOT.
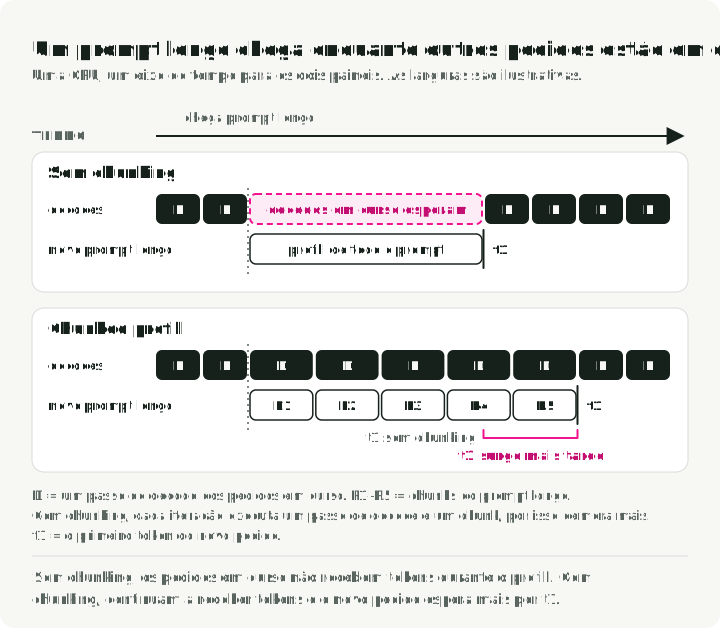
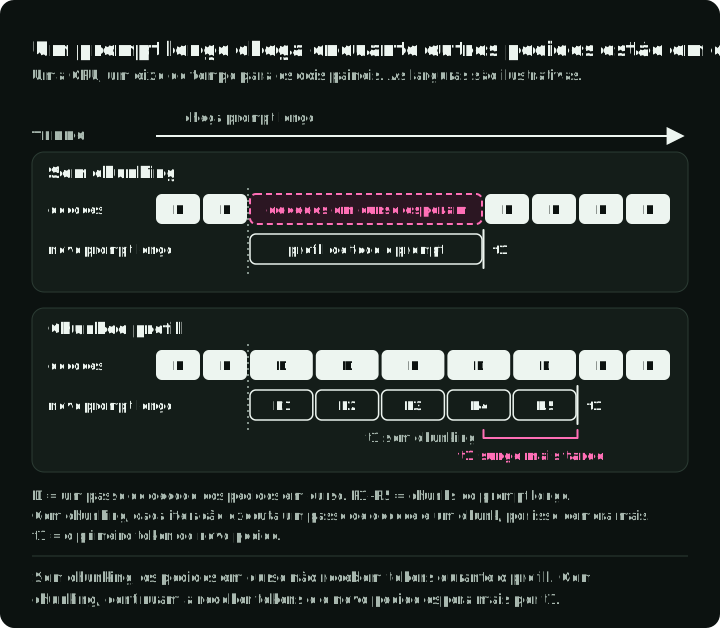
O chunked prefill divide um prompt longo em chunks e escalona-os juntamente com os decodes em curso. O tamanho efetivo dos chunks pode variar com o orçamento de tokens disponível na iteração. No Sarathi-Serve (secção 4.2) e no vLLM, o scheduler coloca primeiro os decodes em curso no batch e preenche o resto de um orçamento de tokens por iteração com tokens de prefill. Assim, um prompt longo deixa de impedir os outros pedidos de receberem tokens. O novo pedido paga por isto: o seu prefill estende-se por várias iterações e cada chunk volta a ler a KV cache dos chunks anteriores. O Sarathi-Serve mediu cerca de 25% de tempo de prefill adicional com o Yi-34B, paralelismo de tensores de grau dois e chunks de 512 tokens (secção 5.4.1), e a documentação do vLLM indica que um orçamento de tokens menor dá melhor latência entre tokens e pior TTFT. O Sarathi-Serve reporta melhores compromissos entre throughput e latência nas cargas testadas, mas o ganho depende do modelo, do hardware, da distribuição de comprimentos dos pedidos, do tamanho do chunk e da base de comparação.
O serving desagregado coloca o prefill e o decode em pools de GPUs separados, o que permite que cada pool ataque um bottleneck diferente. O Splitwise e o DistServe descrevem o padrão. O pool de prefill envia a KV cache de cada pedido para o pool de decode. O DistServe usa NVLink dentro de um nó e InfiniBand entre nós; o Splitwise usa InfiniBand, que suporta RDMA. O custo da transferência passa a fazer parte do desenho.
A figura põe os dois escalonamentos no mesmo eixo de tempo: um prompt longo chega enquanto outros pedidos estão em decode. O chunking mantém a chegada dos tokens dos outros pedidos e adia o primeiro token do novo pedido.
8. GQA e MQA: reduzir a KV cache
A Multi-Head Attention (MHA) padrão dá a cada query head a sua própria head K e V. A Multi-Query Attention (MQA) partilha uma única KV head por todas as query heads, uma redução extrema. A Grouped-Query Attention (GQA) é o meio-termo prático: grupos de query heads partilham uma KV head. A figura desenha oito query heads e as KV heads que cada variante mantém; a KV cache diminui na proporção do número de KV heads.
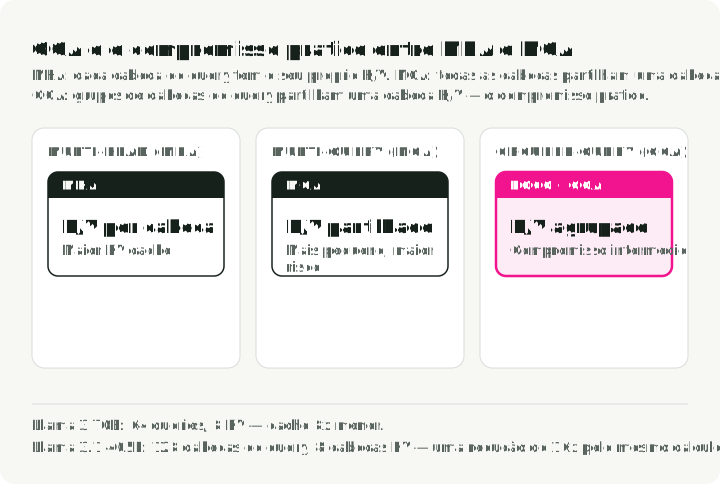
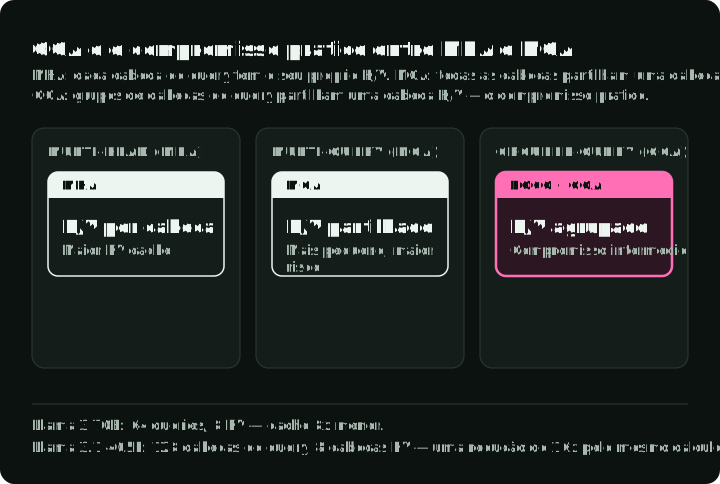
O Llama 3 70B usa 64 query heads mas apenas 8 KV heads, uma redução de 8x da KV cache face à mesma arquitetura com uma KV head por query head. O Llama 3.1 405B usa 128 query heads e 8 KV heads, uma redução de 16x pelo mesmo cálculo (Meta, 2024). Ainslie et al. reportam uma qualidade da GQA próxima da MHA nos modelos que testaram, aproximando-se da velocidade da MQA. Uma KV cache mais pequena permite batches maiores, mas o ganho real de latência e de throughput continua a depender do kernel e da carga.
9. Quantização: trocar bits por velocidade e memória
A quantização reduz a precisão dos pesos e/ou das ativações do modelo. Os compromissos principais:
| Formato | Bits | Memória dos pesos (modelo de 7B) | Nota sobre a qualidade |
|---|---|---|---|
| FP16/BF16 | 16 | ~14 GB | Referência para comparação |
| FP8 | 8 | ~7 GB | Nativo em hardware na Hopper; avalie o modelo |
| INT8 | 8 | ~7 GB | Depende da calibração e do kernel |
| INT4 | 4 | ~3,5 GB | Compressão mais elevada; avalie com cuidado |
O AWQ (Activation-Aware Weight Quantization) identifica canais de pesos relevantes a partir das magnitudes das ativações e aplica uma escala por canal para os proteger. As necessidades de calibração dependem do modelo e da configuração; numa comparação OPT-6.7B INT3-g128, o AWQ usou 16 sequências de calibração enquanto o GPTQ usou 192. Numa configuração reprodutível, indique tanto o número de sequências como o seu comprimento. O GPTQ usa informação aproximada de segunda ordem para quantização camada a camada. O bitsandbytes pode quantizar durante o carregamento do modelo, sem uma passagem separada de pré-processamento; o seu formato NF4 sustenta o fine-tuning com QLoRA. O FP8 em hardware da classe Hopper reduz para metade a memória dos pesos em relação ao FP16/BF16, mas a qualidade e a velocidade continuam a depender do modelo, da calibração e do kernel.
A tabela associa cada método à tarefa a que normalmente se adequa. O guia de quantização de modelos trata cada método em profundidade.
| Método | Dados de calibração | Uso típico |
|---|---|---|
| AWQ ou GPTQ (INT4 só pesos) | Sim, uma pequena amostra | Servir um modelo grande em GPUs com pouca memória, através de um kernel INT4 suportado |
| bitsandbytes NF4 | Não | Fine-tuning com QLoRA e experiências rápidas |
| FP8 | Pequena amostra ou escala dinâmica | Servir em GPUs Hopper ou mais recentes, com verificação de qualidade na tarefa alvo |
| INT8 (W8A8) | Sim, para as escalas das ativações | GPUs sem FP8, como a A100 ou a A10G, quando o kernel de serving o suporta |
O kernel de serving pode ser tão importante como o algoritmo de quantização. A Secção 10 apresenta um resultado delimitado do Marlin e explica por que razão o ganho depende da configuração de serving.
Parte III — Otimizações de inferência
As otimizações desta parte resolvem restrições diferentes. O FlashAttention reduz o tráfego de HBM da attention; o PagedAttention melhora a alocação da KV; o batching contínuo impede que sequências terminadas ocupem capacidade do batch.
10. Kernels CUDA e fusão de kernels
Um kernel CUDA é uma função escrita para a GPU que corre em paralelo em milhares de threads. Quando o CPU chama um kernel, a GPU distribui o trabalho pelos seus SMs: cada SM executa vários warps de 32 threads e cada thread processa uma fatia dos dados. Uma implementação de serving em CUDA executa o trabalho da GPU através de kernels. O número de lançamentos depende do grafo do modelo, do compilador, do runtime e da fusão. A implementação do kernel pode decidir se o sistema cumpre o seu SLO de latência.
As principais categorias de kernels no serving de LLMs:
- Kernels GEMM para a multiplicação de matrizes, que dominam a computação tanto do prefill como do decode.
- Kernels de attention, como o FlashAttention, que dividem a computação em tiles para ficarem na SRAM em vez de transbordarem para a HBM.
- Kernels fundidos que combinam várias operações (como add + layer norm ou a projeção QKV) num único lançamento, para evitar as idas e voltas intermédias à HBM.
- Kernels de amostragem que convertem logits em IDs de tokens por amostragem top-k, top-p ou com temperature.
A qualidade do kernel pode determinar se os pesos comprimidos se traduzem em ganho de velocidade. O artigo do Marlin reporta um speedup de ponta a ponta até 2,8x sobre a sua referência FP16 em configurações de vLLM testadas com INT4 só de pesos. Esse resultado é específico dos modelos, GPUs, tamanhos de batch e configuração de serving do artigo, pelo que não é um ganho universal do INT4.
O Triton baixa a barreira à escrita de kernels personalizados ao expor a programação de GPUs através de Python em vez de CUDA C++ puro, o que coloca a otimização ao nível do kernel ao alcance dos engenheiros de ML e não apenas dos especialistas em GPUs. A maioria das otimizações mais adiante nesta parte (FlashAttention, kernels fundidos, PagedAttention) são melhores kernels ou formas mais inteligentes de orquestrar lançamentos de kernels.
A fusão de kernels combina operações sequenciais num único kernel de GPU e evita escritas intermédias na HBM. As fusões comuns incluem a projeção QKV, attention mais softmax, adição residual mais RMSNorm. O FlashNorm combina, em vez disso, o reescalamento RMSNorm com a projeção linear seguinte e adia a normalização. O DeepFusionKernel funde um MLP SwiGLU completo, incluindo as multiplicações de matrizes. Os ganhos exatos em número de lançamentos e em utilização dependem do grafo do modelo, do compilador, da GPU e do framework de serving, por isso faça profiling da stack em produção em vez de confiar numa percentagem universal.
11. FlashAttention: dividir a attention em tiles para viver na SRAM
A attention padrão materializa a matriz de attention completa na HBM, o que custa de memória e gera muito tráfego de memória. A ideia do FlashAttention é nunca materializar essa matriz. Divide as matrizes Q, K, V em blocos que cabem na SRAM, calcula a attention parcial dentro de cada tile e junta os resultados com um softmax online (que acompanha de forma incremental o máximo e a soma correntes ao longo dos blocos). O armazenamento intermédio desce de para , com menos leituras e escritas na HBM nas formas testadas no artigo. A aritmética da attention densa continua a ser quadrática no comprimento da sequência.
Cada versão ataca o bottleneck da sua geração de GPU:
- O FlashAttention v1 (A100, 2022) provou que a ideia de tiling com softmax online funciona. O artigo reportou um speedup de 2–4x sobre a attention padrão, mas apenas 25–40% de utilização da GPU. O artigo do FA2 atribui isso ao trabalho que não é multiplicação de matrizes, à comunicação pela memória partilhada e ao paralelismo limitado.
- O FlashAttention v2 (A100, 2023) reformulou o paralelismo para dividir ao longo da dimensão da sequência bem como do batch e das heads. Atingiu 50–73% de utilização na A100, cerca de 2x mais rápido do que a v1.
- O FlashAttention v3 (H100 Hopper, 2024) acrescentou a especialização de warps (warps separados para movimento de dados e para cálculo) e o pipelining GEMM-softmax para sobrepor os carregamentos de memória à computação. O artigo reporta até 740 TFLOPS em FP16 (75% de utilização) e perto de 1,2 PFLOPS em FP8 na H100.
- O FlashAttention v4 (B200 Blackwell, 2026) ataca um novo bottleneck: na Blackwell, o throughput dos tensor cores cresce tão depressa que as operações que não são multiplicações de matrizes (exponenciais do softmax, reescalonamento) passam a ser o limite. O FA4 emula por software a exponencial com aproximações polinomiais em unidades FMA, usa reescalonamento condicional para reduzir o overhead e guarda os valores intermédios na memória dedicada de tensores da Blackwell (TMEM) em vez de nos registos. O artigo reporta cerca de 1,6 PFLOPS na B200 em BF16, 1,3x mais rápido do que o cuDNN 9.13 e 2,7x mais rápido do que o Triton nos seus testes.
12. FlashDecoding: paralelizar o bottleneck do decode
O FlashAttention padrão mantém a GPU ocupada dividindo o trabalho pelo tamanho do batch e pelo comprimento da query. Durante o decode, o modelo gera exatamente 1 token de cada vez (comprimento da query = 1). Se o tamanho do batch vezes o número de attention heads for muito inferior ao número de SMs da GPU (108 numa A100), muitos SMs podem ficar inativos enquanto os restantes processam o histórico de tokens.
O FlashDecoding resolve isto acrescentando uma nova dimensão de paralelização: o próprio comprimento da sequência de KV. Divide a KV cache em chunks mais pequenos e distribui-os por todos os processadores da GPU que de outro modo estariam inativos, para os avaliar em paralelo, e depois junta os cálculos parciais com uma redução log-sum-exp.
No benchmark do Stanford com o CodeLlama-34B e batch de um, em quatro GPUs A100, com comprimentos de sequência de 512 a 64K tokens, o FlashDecoding atingiu um speedup de ponta a ponta até 8x sobre as referências testadas e melhorou a escalabilidade da attention nos contextos longos testados. O resultado está limitado a esse hardware e a esse benchmark, e não é uma garantia geral para o decode.
13. Batching contínuo vs batching estático
O batching estático espera que todas as sequências de um batch terminem antes de começar o seguinte, pelo que as sequências curtas desperdiçam ciclos de GPU em espera depois de atingirem o fim de sequência. O batching contínuo (introduzido pelo artigo do Orca, OSDI 2022) opera com granularidade ao nível da iteração: em cada passo de decode, as sequências concluídas são removidas e inseridas novas. A figura mostra quatro slots de batch ao longo de dez passos de decode em cada política.
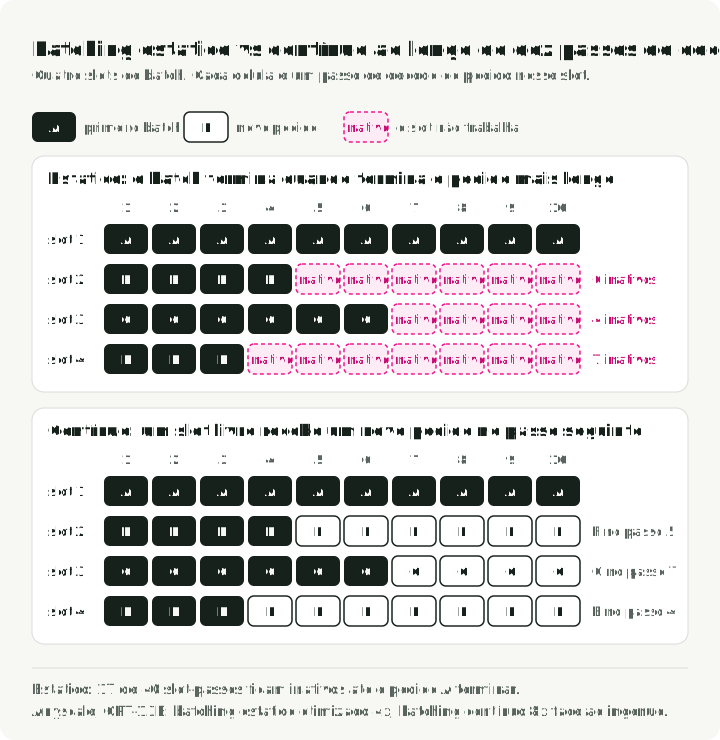
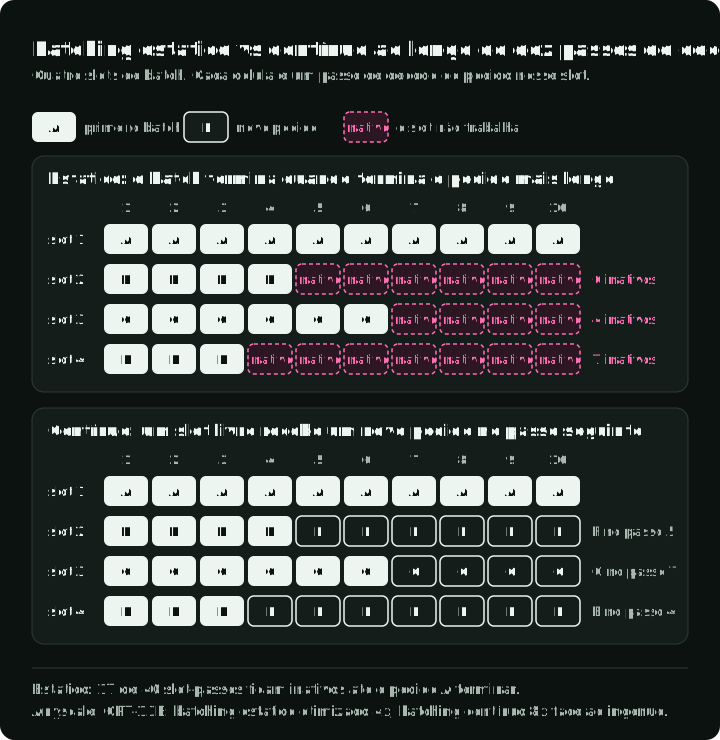
No benchmark OPT-13B de 2023 da Anyscale numa A100-40GB, com 1000 pedidos, prompts de 512 tokens e saídas com uma média de 128 tokens, o batching estático otimizado atingiu 4x a sua referência ingénua, o batching contínuo atingiu 8x e o vLLM com batching contínuo mais PagedAttention atingiu 23x (Anyscale, 2023). O batching contínuo também aumenta a pressão sobre a alocação da KV, razão pela qual é habitualmente combinado com gestão de memória paginada.
14. PagedAttention: memória virtual para a KV cache
O PagedAttention do vLLM aplica à gestão da KV cache a ideia de memória virtual dos sistemas operativos. A KV cache é dividida em blocos de tamanho fixo (16 tokens nesta ilustração; o tamanho dos blocos varia entre runtimes), os blocos são alocados a pedido à medida que os tokens são gerados e as posições lógicas (sequenciais) são mapeadas para localizações físicas (dispersas) da memória através de block tables. Vários pedidos que partilham um prefixo (system prompts, beam search) podem apontar para os mesmos blocos físicos. A reutilização de prefixos também exige chaves de cache compatíveis e uma política de consulta da cache. A figura mostra uma block table para dois pedidos que partilham um system prompt.
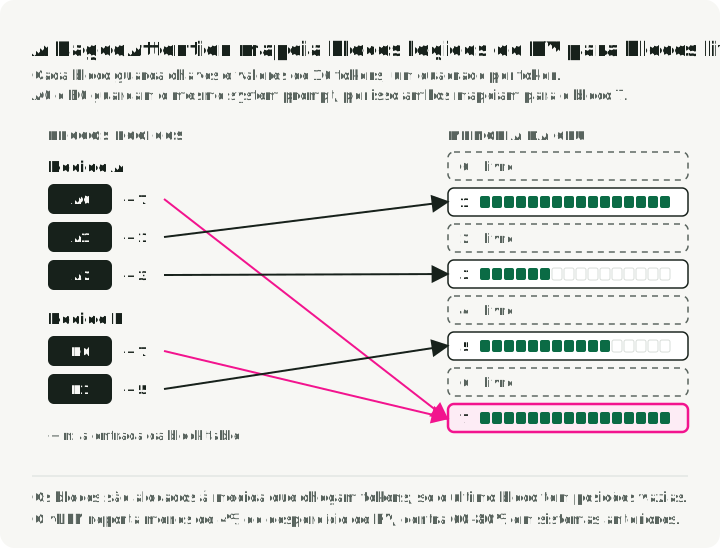
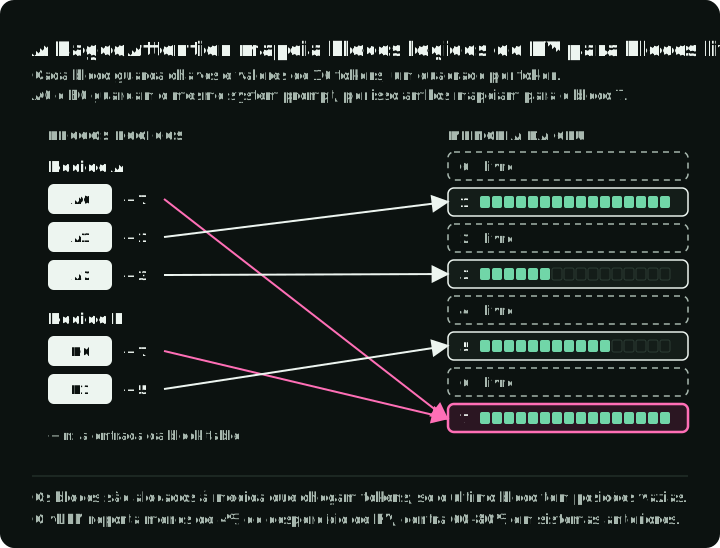
A avaliação do vLLM de junho de 2023 reportou 60–80% de desperdício de memória KV nos sistemas anteriores testados e menos de 4% no seu alocador paginado. Reportou um throughput 2–4x superior ao TGI e até 24x superior ao Hugging Face Transformers em determinadas cargas de trabalho. São comparações históricas de ponta a ponta entre sistemas de serving, e não um speedup ou um limite de desperdício universal do PagedAttention. Um último bloco parcialmente preenchido pode desperdiçar uma proporção maior em sequências curtas.
15. Descodificação especulativa: vários tokens por passagem forward
Na descodificação especulativa, um modelo draft pequeno gera tokens candidatos e depois o modelo alvo grande avalia as posições numa única passagem forward. O decoder aceita os tokens do draft da esquerda para a direita, com probabilidades derivadas das distribuições do alvo e do draft. Após a primeira rejeição, amostra uma correção a partir da distribuição residual do alvo e descarta os restantes tokens do draft. Este passo modificado de amostragem por rejeição preserva a distribuição de saída do modelo alvo, dentro da numérica do hardware; a correspondência exata de tokens, por si só, não o faz. A figura percorre uma ronda com quatro tokens de draft.
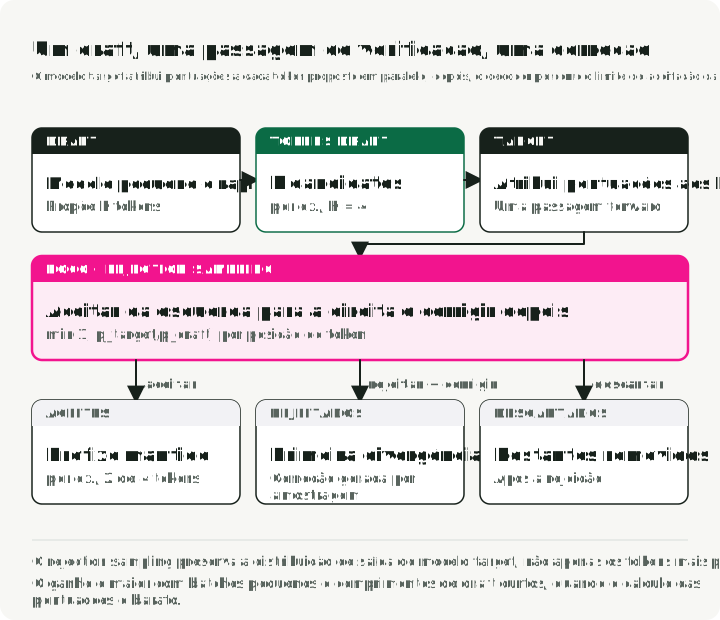
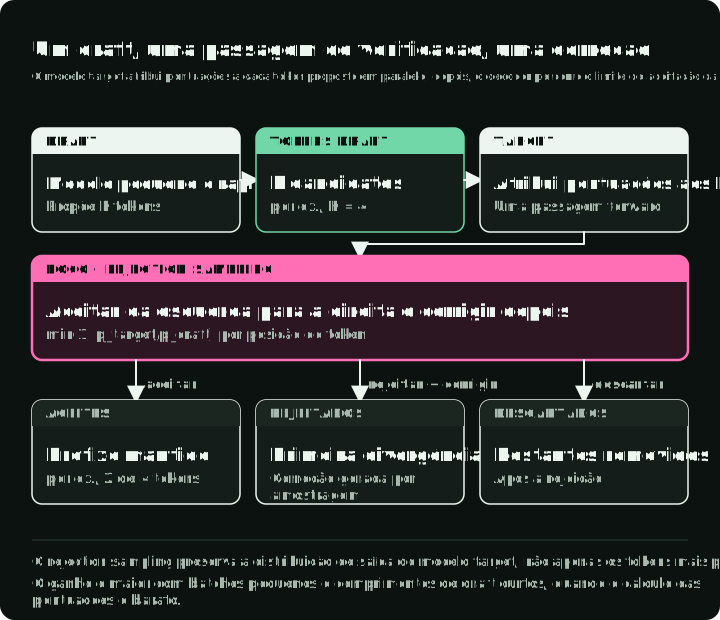
O ganho é mais plausível com batches de serving pequenos e drafts curtos, quando a avaliação do draft é dominada pelo tráfego de pesos, de KV cache ou de comunicação e não pela computação dos tokens adicionais. O artigo original de speculative sampling reportou um speedup de descodificação de 2–2,5x na sua configuração testada com o Chinchilla de 70B; o EAGLE-3 v3 reportou até 6,5x nos seus testes. As variantes incluem o Medusa (heads de predição adicionais, sem modelo separado), o prompt lookup decoding (correspondência de n-gramas com a entrada, sem uma passagem forward de um modelo draft separado) e o EAGLE. O EAGLE original extrapola features; o EAGLE-3 combina vários níveis de features e prevê tokens diretamente.
Com batches grandes, o trabalho adicional de draft e verificação pode anular o ganho. A descodificação especulativa é mais promissora quando o batch de serving é suficientemente pequeno e a aceitação do draft é elevada; faça benchmark do ciclo de serving completo e não apenas do kernel de verificação.
16. Cache de prefixos e reutilização da KV cache
Em vez de deitar fora a KV cache quando um pedido termina, o prefix caching mantém-na para reutilização em novos pedidos que partilham os mesmos tokens de prefixo. Isso reduz o prefill redundante de system prompts, exemplos few-shot, contexto de RAG e histórico de conversas com vários turnos.
A Automatic Prefix Caching do vLLM calcula o hash dos blocos de KV e usa uma tabela de hash global para consulta. O RadixAttention do SGLang mantém uma árvore radix de tensores KV em cache com granularidade ao nível do token. Ambos exigem prefixos com tokens idênticos e chaves de cache compatíveis. A identidade do modelo ou adaptador, as entradas multimodais e as definições de isolamento também podem afetar a reutilização. Reporte a taxa de acertos juntamente com a latência ou o throughput.
17. Streaming na prática
O streaming envia os tokens ao cliente à medida que são gerados, em vez de esperar pela resposta completa. Muitos frameworks de serving expõem-no por Server-Sent Events: o cliente abre uma ligação HTTP de longa duração e o servidor envia cada token, ou grupo de tokens, como um evento data:. O TTFT determina quando o utilizador vê pela primeira vez a saída; o TPOT ajuda a determinar a fluidez da experiência. Defina o objetivo através de testes de produto e do modelo de interação escolhido.
Do lado do cliente, o streaming obriga a decisões de buffering. Renderizar token a token pode causar tremor visual, sobretudo com markdown ou blocos de código que precisam de contexto de vários tokens para serem formatados corretamente. Os padrões comuns são o buffering ao nível da palavra (acumular tokens até uma fronteira de espaço em branco), o buffering ao nível da linha (esperar por uma nova linha antes de renderizar) e o buffering adaptativo (renderizar de imediato para prosa e fazer buffer para blocos de código). Na API Chat Completions da OpenAI, stream_options: {"include_usage": true} acrescenta um chunk final de utilização antes da mensagem data: [DONE]. Os streams interrompidos da OpenAI podem omitir o chunk final de utilização. Os servidores compatíveis com a OpenAI podem diferir, por isso verifique a implementação escolhida.
O chunked prefill é uma forma de impedir que prefills longos bloqueiem a entrega de tokens a utilizadores concorrentes. O escalonamento com prioridade ao decode pode proteger os pedidos em curso, enquanto o serving desagregado isola o prefill e o decode em pools de GPUs separados.
Parte IV — Arquitetura do modelo
A arquitetura define a pegada de memória, o comportamento da attention e a dinâmica de treino em torno dos quais as secções de serving e de treino trabalham.
18. Fundamentos da arquitetura Transformer
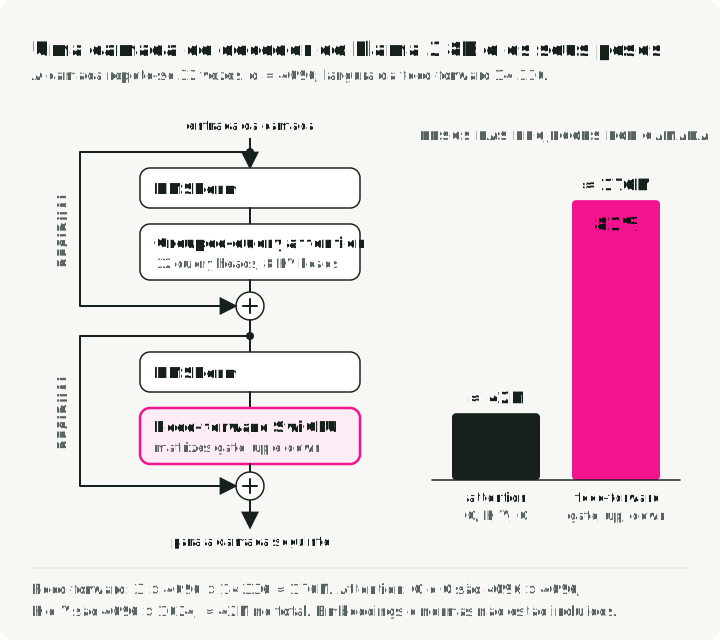
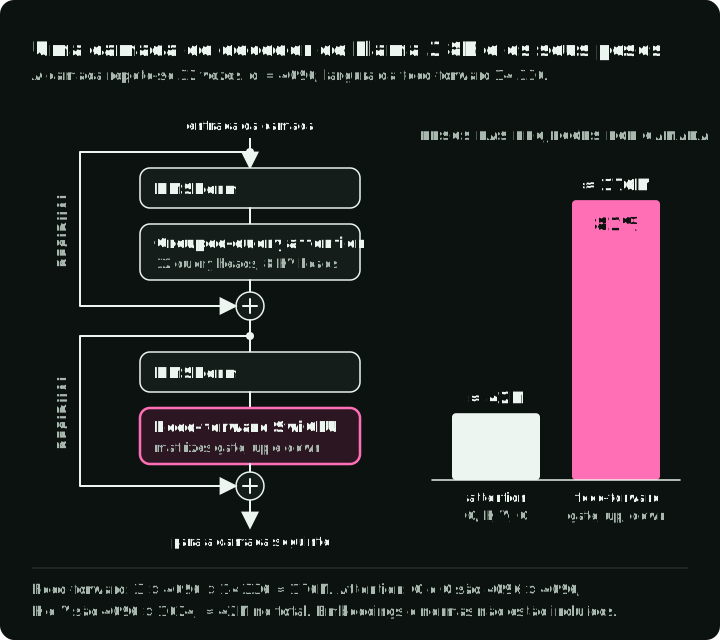
Um transformer decoder-only moderno (GPT, Llama) é uma pilha de camadas idênticas, cada uma com dois sub-blocos: attention e feed-forward. Cada sub-bloco é envolvido por uma ligação residual e por normalização. A figura mostra uma camada ao estilo Llama, incluindo os dois caminhos que saltam um sub-bloco, e como os pesos das projeções se dividem entre a attention e a rede feed-forward; os componentes são descritos abaixo.
Os componentes principais:
A Multi-Head Attention permite que cada token pondere a informação dos tokens visíveis sob a máscara de attention. A entrada é projetada em três matrizes: Queries (o que procuro?), Keys (o que contenho?) e Values (que informação transporto?). As pontuações de attention são depois calculadas como:
O produto escalar mede a similaridade entre todos os pares de tokens. Dividir por impede que os produtos escalares cresçam demasiado (o que empurraria o softmax para regiões com gradientes que desaparecem). O softmax converte as pontuações em probabilidades e a multiplicação por produz uma combinação ponderada dos vetores de valores. Executar isto em várias heads em paralelo permite ao modelo atender a relações diferentes em simultâneo (as heads podem aprender relações diferentes; os seus papéis não são fixos).
A Feed-Forward Network (FFN) transforma cada representação de token de forma independente depois de a attention misturar informação entre tokens. Os LLMs modernos usam muitas vezes SwiGLU em vez da FFN original de duas matrizes com ReLU:
O SwiGLU tem três matrizes de pesos, contra duas numa FFN com ReLU, e usa o Swish, que é suave. O Llama, o Mistral e o Qwen usam-no; o Gemma usa uma GeGLU aproximada. A conhecida regra dos dois terços aplica-se a um bloco convencional com MHA completa e : as suas duas matrizes da FFN contribuem com cerca de parâmetros, contra cerca de da attention. Não é uma estimativa geral para arquiteturas SwiGLU/GQA. No Llama 3 8B, , e oito key/value heads fazem com que a FFN tenha M parâmetros por camada, contra cerca de 42M parâmetros de projeção da attention: cerca de 81% desses pesos de projeção, antes dos embeddings e da normalização.
As ligações residuais somam a saída de cada sub-bloco à sua entrada: . O caminho de salto melhora a propagação do sinal e dos gradientes em pilhas profundas.
O RMSNorm é comum nas famílias modernas de LLMs. O LayerNorm recentra subtraindo a média e reescala pelo desvio-padrão. O RMSNorm dispensa a subtração da média e apenas reescala; o seu artigo reporta reduções de 7–64% no tempo de execução nos modelos e frameworks testados, sem reduzir o desempenho medido nas tarefas. A colocação pre-norm, que normaliza antes da attention ou da FFN, também é comum porque melhora a estabilidade dos gradientes.
A estimativa do número de parâmetros de um decoder convencional com MHA completa, uma FFN de duas matrizes com largura e embeddings de entrada e saída partilhados:
em que é o tamanho do vocabulário, é a dimensão oculta e é o número de camadas. O termo é a matriz de embeddings de entrada; o termo aproxima os pesos da attention e da FFN em cada camada. Para o Llama 3 8B (, , ), a estimativa é de cerca de parâmetros. O total publicado de 8,03B é superior porque a aproximação omite detalhes arquiteturais, como a largura exata da FFN e a projeção de saída separada.
19. Modelos decoder-only para geração de uso geral
O Transformer original (2017) tinha um encoder e um decoder. Desde então, a área dividiu-se em três famílias arquiteturais, e uma tornou-se a predefinição para a AI generativa.
| Família | Attention | Objetivo de treino | Usada hoje para | Exemplos |
|---|---|---|---|---|
| Encoder-only | Bidirecional | Predição de tokens mascarados | Embeddings, rerankers, classificadores | BERT, RoBERTa |
| Encoder-decoder | Encoder bidirecional; decoder causal com cross-attention | Sequência para sequência (span corruption, T5) | Tradução, reconhecimento de fala | T5, BART, Whisper |
| Decoder-only | Causal | Predição do token seguinte | Geração de texto geral, chat, código | GPT, Llama |
Os modelos encoder-only usam attention bidirecional: cada token atende a todos os outros nas duas direções. Isso produz representações para tarefas de compreensão. Os modelos encoder-only padrão não são normalmente usados como decoders autorregressivos; fornecem habitualmente a arquitetura de base para modelos de embeddings, rerankers e classificadores leves (por exemplo, os routers baseados em BERT do RouteLLM).
Os modelos encoder-decoder separam a compreensão da geração. O encoder processa toda a entrada com attention bidirecional e depois o decoder gera a saída de forma autorregressiva, atendendo às representações do encoder através de cross-attention. Isto adequa-se a tarefas em que a entrada e a saída são sequências diferentes, como a tradução e o reconhecimento de fala.
Os modelos decoder-only, como GPT, Llama e Mistral, usam attention causal: cada token atende a si próprio e aos tokens anteriores. Quatro propriedades úteis para a geração são:
- Reutilização da KV cache. Com attention causal, os tokens anteriores nunca atendem aos posteriores, pelo que as suas keys e values continuam válidas à medida que se geram novos tokens. Uma cache por sequência cresce por acréscimo (Secção 6). Um encoder-decoder mantém também o estado de cross-attention sobre a saída do encoder.
- Treino com texto em bruto. A predição do token seguinte não precisa de pares de entrada e saída, pelo que qualquer corpus de texto serve de dados de treino.
- Um bloco repetido. O modelo é uma pilha de camadas de decoder idênticas, sem pilha de encoder separada nem caminho de cross-attention para construir, fazer sharding e otimizar.
- In-context learning. As instruções, os exemplos few-shot e a consulta são todos tokens num único prefixo, pelo que um só modelo pode assumir uma nova tarefa a partir do prompt.
20. Mixture of experts
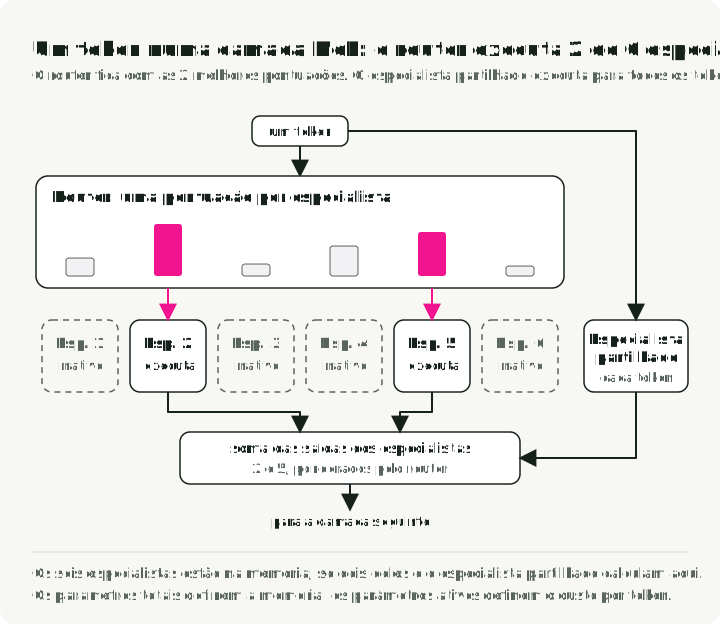
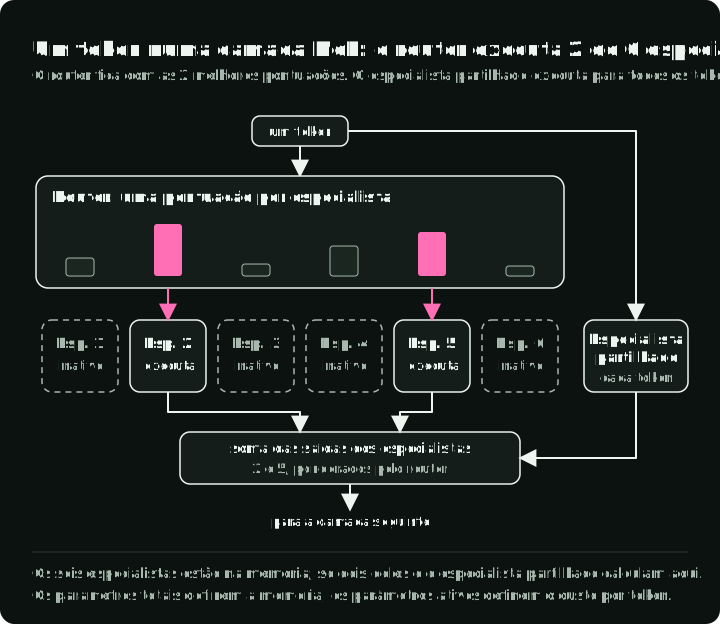
O MoE substitui determinadas FFNs densas por várias FFNs de especialistas, mais um router de gating leve. O router calcula uma pontuação para cada especialista (tipicamente um softmax sobre projeções lineares aprendidas) e seleciona os top- especialistas por token. Apenas os especialistas ativados fazem computação, pelo que um modelo pode ter uma capacidade total enorme mantendo baixo o custo por token. Trata-se de computação condicional esparsa. Os parâmetros ativos aproximam a aritmética por token, mas todos os pesos dos especialistas precisam de armazenamento. A comunicação, o routing, a ocupação do batch e a memória KV também afetam o custo de execução. A figura segue um token através de uma camada MoE com seis especialistas encaminhados e um especialista partilhado.
| Modelo | Parâmetros totais | Parâmetros ativos | Especialistas (encaminhados + partilhados) | Top- |
|---|---|---|---|---|
| Mixtral 8x7B | 47B | ~13B | 8 + 0 | 2 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 | 8 |
O especialista partilhado do DeepSeek-V3 é ativado para todos os tokens. Fornece uma representação de base sobre a qual os especialistas encaminhados se podem especializar.
O treino de MoE tem três problemas recorrentes: desequilíbrio de carga, colapso de especialistas e overhead de comunicação para o paralelismo de especialistas. Os modelos MoE tradicionais acrescentam uma perda auxiliar para penalizar o encaminhamento desequilibrado, mas essa perda pode competir com o objetivo principal. O DeepSeek-V3 usa principalmente uma estratégia ao nível do batch, sem perda auxiliar: termos de bias fora da retropropagação baixam a pontuação dos especialistas sobrecarregados e aumentam a dos subutilizados. Aplica também uma perda complementar de equilíbrio ao nível da sequência, extremamente pequena, para evitar um desequilíbrio extremo dentro de uma sequência. O artigo reporta um melhor equilíbrio do encaminhamento sem o compromisso principal da perda auxiliar na sua configuração.
21. Tokenização: BPE, SentencePiece e tiktoken
Os LLMs não veem texto. Veem sequências de IDs inteiros de tokens. Um tokenizer divide o texto em bruto em tokens (fragmentos de subpalavras) e mapeia cada um para um ID. A escolha do tokenizer afeta a qualidade do modelo, a velocidade de inferência e a equidade multilingue.
O Byte Pair Encoding (BPE) é o algoritmo comum. Funde iterativamente os pares adjacentes mais frequentes no corpus de treino. Um exemplo simplificado:
- Começar com um vocabulário ao nível do carácter:
[l, o, w, e, r, _] - O par mais frequente é
(l, o)→ fundir emlo→ vocabulário:[l, o, w, e, r, _, lo] - O par mais frequente seguinte é
(lo, w)→ fundir emlow→ o vocabulário passa a incluirlow - Continuar até o vocabulário atingir o tamanho alvo (por exemplo, 128K tokens)
Palavras comuns como “the” tornam-se tokens únicos, enquanto palavras raras como “defenestration” são divididas em fragmentos de subpalavras como ["def", "en", "est", "ration"] numa ilustração inventada. A divisão real depende do tokenizador e da versão. O compromisso é entre o tamanho do vocabulário e o comprimento da sequência.
Três implementações de tokenizers cobrem a maior parte do uso em produção:
- O SentencePiece treina diretamente sobre texto Unicode em bruto, sem um pré-tokenizer específico de cada língua. Preserva os espaços em branco com o meta-símbolo
▁e pode, opcionalmente, recorrer a tokens de bytes UTF-8. Suporta modelos BPE e unigram e é usado pelo Llama 1/2, T5 e pelos primeiros tokenizadores Mistral. Os tokenizadores Mistral Tekken mais recentes usam BPE ao estilo tiktoken. - O tiktoken é o tokenizer da OpenAI, escrito em Rust, que usa BPE ao nível do byte. No seu benchmark publicado com o GPT-2, correu 3–6x mais depressa do que a configuração testada de
GPT2TokenizerFast. O Llama 3 passou do SentencePiece para o algoritmo do tiktoken. - Os Hugging Face Tokenizers são uma biblioteca amplamente usada, escrita em Rust, que suporta BPE, WordPiece e Unigram.
O tamanho do vocabulário varia muito entre famílias de modelos:
| Modelo | Tokenizer | Tamanho do vocabulário |
|---|---|---|
| GPT-2 | BPE ao nível do byte | 50,257 |
| Llama 2 | SentencePiece BPE | 32,000 |
| Llama 3 | BPE ao estilo tiktoken | 128,256 |
| GPT-4o | tiktoken o200k_base | ~200K |
Numa configuração comparável de treino de tokenizadores, um vocabulário maior pode significar menos tokens para o mesmo texto, mas uma matriz de embeddings maior (o termo da Secção 18).
A fertilidade mede quantos tokens um tokenizer produz por palavra ou por outra unidade de texto escolhida. Varia com o tokenizer exato, a língua, a escrita, a normalização, o domínio e a amostra. Meça-a em tráfego representativo em vez de extrapolar a partir de um único tokenizer ou língua.
22. Janelas de contexto e codificações posicionais
A janela de contexto limita a sequência de tokens disponível para um pedido de geração. O chunked prefill e o decode com cache processam apenas parte dessa sequência numa passagem. As APIs também podem definir limites separados para a entrada e a saída. Os limites publicados incluem:
| Modelo | Limite de tokens publicado | Ano |
|---|---|---|
| Llama 1 | 2,048 | 2023 |
| Llama 3.1 | 128K | 2024 |
| GPT-4.1 | 1,047,576 | 2025 |
| Gemini 2.5 Pro | 1,048,576 de entrada | 2025 |
O GPT-4.1 também limita a saída a 32 768 tokens; o Gemini 2.5 Pro limita-a a 65 536. A linha do Gemini indica um limite de entrada, enquanto o GPT-4.1 indica uma janela de contexto, pelo que estes campos não são idênticos.
A attention compara todos os pares de tokens visíveis, mas nada nessa comparação diz a que distância estão. Sem informação posicional, a self-attention completa não distingue ordens diferentes das palavras do mesmo conjunto de tokens; os estados por token seguem a permutação da entrada. A máscara causal de um decoder dá algum sinal de ordem, porque cada token vê apenas o seu prefixo, mas não fornece posições relativas explícitas. As codificações posicionais acrescentam explicitamente a posição e a distância relativa.
Três abordagens comuns:
-
O RoPE (Rotary Position Embeddings) roda os vetores de query e de key por ângulos que dependem da posição, de modo que o seu produto escalar depende da posição relativa. O conteúdo do token continua a determinar a pontuação de attention; o RoPE acrescenta informação de posição sem embeddings de posição absoluta aprendidos. É usado por famílias de modelos abertos, incluindo o Llama, o Mistral e o Qwen.
-
O ALiBi (Attention with Linear Biases) dispensa modificações dos embeddings e soma uma penalização diretamente às pontuações de attention: quanto mais afastados estão dois tokens, maior é o bias negativo. Não tem parâmetros posicionais aprendidos. No artigo original, um modelo de 1,3B treinado com sequências de 1024 tokens teve, aos 2048 tokens, um desempenho comparável ao de um modelo de posições sinusoidais treinado a 2048. O comportamento para além dos modelos e comprimentos testados no artigo depende do modelo.
-
O YaRN (Yet another RoPE extensioN) estende um modelo RoPE para além do seu contexto de treino. Agrupa as dimensões de frequência em três categorias e escala cada uma de forma diferente. Na comparação do artigo com a mesma configuração com interpolação de posições, o YaRN usou 400 em vez de 1000 passos de treino (Apêndice B.2). A afirmação mais ampla do resumo sobre 10x menos dados usa uma comparação diferente.
Parte V — Treino e alinhamento
Esta parte distingue o objetivo que cria capacidades, as técnicas que fazem o treino caber no hardware disponível e os métodos que moldam o comportamento de um modelo depois disso.
23. Pretraining, fine-tuning e alinhamento
O pretraining de um LLM autorregressivo usa a predição autossupervisionada do token seguinte sobre um grande corpus. Os modelos de encoder podem usar outros objetivos, como a predição de tokens mascarados. A sua computação abrange muitas ordens de grandeza; o Llama 3 405B, por exemplo, usou FLOPs. O fine-tuning supervisionado (SFT) adapta o modelo pré-treinado a dados rotulados específicos de uma tarefa. O RLHF / RLAIF usa dados de preferências para moldar o comportamento: um pipeline RLHF convencional recolhe comparações, treina um modelo de recompensa e depois otimiza a política. O RLAIF substitui alguns juízos humanos por feedback gerado por AI. A Secção 31 trata da distillation, um caminho separado em que um professor alinhado gera dados de treino para um aluno mais pequeno.
A computação depende do tamanho do modelo, do comprimento da sequência, do volume de dados, do optimizer e do método. O PPO também carrega mais estado do modelo do que o SFT, porque uma configuração típica inclui modelos de política, de referência, de recompensa e crítico. Tratei o framework completo de decisão sobre fine-tuning no Guia de fine-tuning de LLM.
24. LoRA e QLoRA: fine-tuning eficiente em parâmetros
O LoRA congela os pesos pré-treinados e injeta matrizes de baixo rank treináveis () e (), de modo que o peso atualizado é . O artigo do LoRA reduziu o GPT-3 175B para cerca de 18 milhões de parâmetros treináveis na sua configuração. O rank é um parâmetro de ajuste e não uma regra de complexidade da tarefa; escolha-o com uma varredura de qualidade e memória. Os adaptadores LoRA podem ser fundidos nos pesos base depois do treino, para evitar um caminho de adaptador separado na inferência.
O QLoRA carrega o modelo base com quantização NF4 de 4 bits enquanto treina adaptadores LoRA em BF16. O NormalFloat4 coloca mais níveis de quantização perto de zero, onde a densidade dos pesos é mais elevada. O artigo fez fine-tuning de um modelo de 65B numa única GPU de 48 GB e reportou resultados próximos das suas referências de 16 bits. Os compromissos de runtime e de memória são específicos da stack testada.
25. Treino com precisão mista
Todos os formatos de vírgula flutuante distribuem os seus bits por três campos: sinal (sempre 1 bit), expoente (define o intervalo dinâmico) e mantissa (define a precisão). Mais bits de expoente significam um intervalo mais largo de magnitudes representáveis; mais bits de mantissa significam distinções mais finas entre valores próximos. Os formatos inteiros não têm expoente e representam apenas números inteiros uniformemente espaçados dentro de um intervalo fixo.
| Formato | Bits | Layout (S / E / M) | Intervalo | Precisão | Uso comum |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ~7 dígitos decimais | Pesos mestre, estados do optimizer (momento e variância do Adam) | |
| BF16 | 16 | 1 / 8 / 7 | ~2 dígitos decimais | Formato de treino preferido; mesmo intervalo do FP32 e, normalmente, sem loss scaling | |
| FP16 | 16 | 1 / 5 / 10 | ~3 dígitos decimais | Treino com loss scaling (GPUs mais antigas); inferência em hardware anterior à Hopper | |
| FP8 E4M3 | 8 | 1 / 4 / 3 | ~1 dígito decimal | Passagem forward na Hopper (H100) — mais precisão para pesos e ativações | |
| FP8 E5M2 | 8 | 1 / 5 / 2 | ~0,6 dígitos decimais | Passagem backward na Hopper — intervalo mais largo para os gradientes | |
| INT8 | 8 | inteiro com sinal | a | Inteiros exatos | Quantização de pesos pós-treino para inferência (W8A8); quantização da KV cache |
| INT4 | 4 | inteiro com sinal | a | Inteiros exatos | Quantização agressiva só de pesos (AWQ, GPTQ) para inferência em hardware com pouca memória |
O BF16 tem o mesmo intervalo do FP32 porque o intervalo é definido pelo campo do expoente, e o BF16 mantém os 8 bits de expoente do FP32. Cede, em vez disso, bits de mantissa (7 contra 23), trocando precisão por uma redução de 2x na memória e evitando muitos dos problemas de intervalo que afetam o treino em FP16. O FP16 tem apenas 5 bits de expoente, o que limita o seu intervalo finito a cerca de 65K. Muitos gradientes são, pelo contrário, demasiado pequenos para o FP16 e sofrem underflow para zero. O loss scaling multiplica a loss antes da retropropagação para que esses gradientes continuem representáveis e depois desfaz a escala antes do passo do optimizer; o scaling dinâmico reduz o fator se ocorrer overflow. O intervalo de expoente mais largo do BF16 evita normalmente este requisito.
Os formatos inteiros são pouco comuns na aritmética principal do treino porque a retropropagação precisa de um intervalo dinâmico largo. São muito usados na inferência, onde os pesos congelados podem ser mapeados para escalas calibradas. A quantização de pesos em INT4 reduz um modelo de 7B de cerca de 14 GB para 3,5 GB antes do overhead do runtime; a qualidade tem de ser medida para o modelo e o método escolhidos.
O treino em FP8 na H100 através do Transformer Engine usa E4M3 onde a precisão importa e E5M2 onde importa um intervalo mais largo. O artigo do FP8-LM reporta que o seu framework de precisão mista treinou o GPT-175B 75% mais depressa do que a sua referência BF16 com Megatron-LM e 37% mais depressa do que o NVIDIA Transformer Engine na configuração H100 testada. O DeepSeek-V3 usou precisão mista FP8 e reportou cerca de $5.6 milhões em computação equivalente ao aluguer para a sua execução final de treino, excluindo I&D e infraestrutura.
26. Gradient checkpointing
Cada camada da passagem forward produz uma saída intermédia chamada ativação:
Normalmente todas as ativações têm de ficar em memória porque a retropropagação precisa delas para calcular os gradientes. Num transformer profundo, as ativações guardadas podem ocupar mais memória do que os próprios pesos do modelo.
O gradient checkpointing troca computação por memória, descartando a maioria dessas ativações e recalculando-as em tempo real durante o backprop. A estratégia padrão (Chen et al., 2016) divide uma rede de camadas em segmentos uniformemente espaçados e guarda apenas a ativação de fronteira de cada segmento. Essas fronteiras guardadas são os “checkpoints”. Todas as ativações intermédias dentro de um segmento são descartadas de imediato.
Quando a passagem backward chega a uma camada dentro de um segmento, as suas ativações são recalculadas a partir do checkpoint mais próximo. Na estratégia de segmentos uniformes, a memória de ativações guardadas desce de para . Cada segmento é recalculado uma vez, o que custa cerca de uma passagem forward adicional por passo de treino (Chen et al., 2016). A poupança real de memória e o overhead de recomputação dependem do modelo, das fronteiras dos checkpoints, do comprimento da sequência, do framework e da implementação, por isso meça ambos na execução de treino alvo. O FlashAttention aplica o mesmo princípio dentro da attention, ao não materializar a matriz de attention completa. Nas execuções normais do Hugging Face Trainer, ative-o com gradient_checkpointing=True. Com FSDP, use a integração de activation checkpointing do framework, quando suportada; a opção genérica pode causar all-gathers redundantes na passagem backward.
27. Fases do DeepSpeed ZeRO
No paralelismo de dados padrão, cada GPU guarda uma cópia completa dos pesos do modelo, dos gradientes e dos estados do optimizer. No Adam, cada parâmetro ocupa 2 bytes para o peso FP16 + 4 bytes para o peso mestre FP32 + 4 bytes para o momento + 4 bytes para a variância + 2 bytes para o gradiente, ou seja, 16 bytes por parâmetro. Um modelo de 7,5B parâmetros precisa de ~120 GB por GPU, e todas as GPUs guardam o mesmo. Com 64 GPUs, são 64 cópias idênticas de 120 GB.
O DeepSpeed ZeRO (Zero Redundancy Optimizer) elimina esta duplicação fazendo sharding destes componentes entre as GPUs em vez de os replicar:
- Fase 1 — particionar os estados do optimizer. Cada GPU guarda apenas 1/N dos estados do optimizer (os pesos mestre FP32 mais o primeiro e o segundo momentos do Adam, 12 bytes/parâmetro). Quando uma GPU precisa de atualizar um peso, atualiza apenas a sua fatia e difunde o resultado. Sob os pressupostos abaixo, a memória desce de ~120 GB para ~41,3 GB por GPU.
- Fase 2 — particionar também os gradientes. Os gradientes (2 bytes/parâmetro) deixam de sofrer all-reduce para todas as GPUs. Cada GPU recebe apenas a fatia de gradiente de que precisa através de reduce-scatter. Sob os mesmos pressupostos, a memória desce para ~28,1 GB por GPU.
- Fase 3 — particionar também os pesos do modelo. Cada GPU guarda apenas 1/N dos pesos FP16. Antes da passagem forward ou backward de cada camada, a GPU chama all-gather para reconstruir temporariamente os pesos completos da camada a partir de todas as outras GPUs, calcula e descarta os pesos reunidos. Sob os mesmos pressupostos, a memória desce para ~15,0 GB por GPU.
A figura desenha, à escala, o estado do modelo por GPU em cada fase, com o custo de comunicação de cada fase.
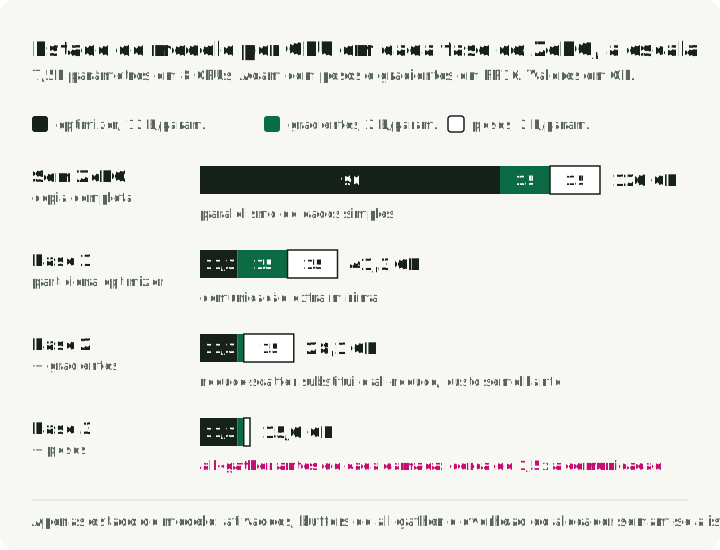
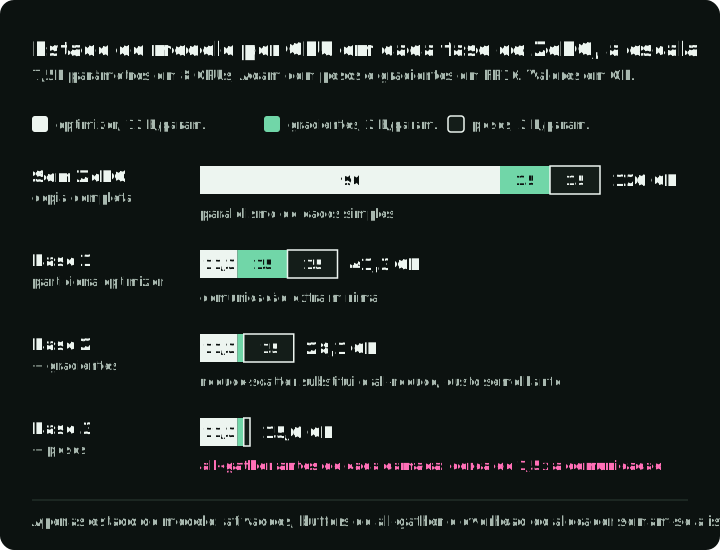
Estes são valores aproximados de estado do modelo para um modelo de 7,5B parâmetros em 8 GPUs (world size ), com pesos e gradientes em FP16 e pesos mestre, momento e variância do Adam em FP32. Excluem ativações, buffers temporários de all-gather, fragmentação do alocador e overhead do framework/runtime. O limite do cálculo é bytes por parâmetro, com cada estado dividido por apenas nas fases que o particionam.
Para repetir o cálculo com outro tamanho de modelo ou número de GPUs:
def zero_model_state_gb(params_b, n_gpus, stage):
    """Model-state GB per GPU for Adam with FP16 weights and gradients.

    Optimizer states (FP32 master weights, momentum, variance) take 12 bytes
    per parameter, gradients 2, and weights 2. Stage 1 shards the optimizer
    states, stage 2 also the gradients, and stage 3 also the weights.
    """
    optimizer, gradients, weights = 12, 2, 2
    if stage >= 1:
        optimizer /= n_gpus
    if stage >= 2:
        gradients /= n_gpus
    if stage >= 3:
        weights /= n_gpus
    return params_b * (optimizer + gradients + weights)

for stage in range(4):
    print(f"stage {stage}: {zero_model_state_gb(7.5, 8, stage):g} GB per GPU")

assert [zero_model_state_gb(7.5, 8, s) for s in range(4)] == [120.0, 41.25, 28.125, 15.0]
# 70B parameters: Stage 3 on 8 GPUs still needs 140 GB of model state per GPU;
# 16 GPUs bring it to 70 GB, before activations.
assert zero_model_state_gb(70, 8, 3) == 140.0
assert zero_model_state_gb(70, 16, 3) == 70.0
O compromisso é a comunicação. A Fase 1 acrescenta um overhead mínimo e a Fase 2 substitui o all-reduce por reduce-scatter com custo semelhante. A Fase 3 precisa de chamadas all-gather antes de cada camada, tanto na passagem forward como na backward, o que dá aproximadamente 1,5x o volume de comunicação do paralelismo de dados padrão.
O ZeRO-Infinity estende a Fase 3 com o offloading dos estados particionados para a RAM do CPU e até para SSDs NVMe, o que pode tornar possível treinar modelos com biliões de parâmetros em clusters de GPUs limitados. O offload para armazenamento acrescenta custo de PCIe e de transferência de armazenamento; o seu impacto medido depende do disco, da topologia PCIe, do particionamento, do prefetch, da sobreposição das transferências e da carga de trabalho. Use-o para satisfazer requisitos de capacidade em vez de assumir uma lentidão fixa, e faça profiling da configuração alvo.
28. FSDP: sharding nativo do PyTorch
O Fully Sharded Data Parallel (FSDP) é a resposta incorporada do PyTorch ao DeepSpeed ZeRO-3. Faz sharding dos parâmetros, dos gradientes e dos estados do optimizer entre as GPUs, com a mesma ideia central. Com sharding completo e resharding ativados, as operações para cada unidade envolvida são:
- All-gather dos parâmetros completos de todas as GPUs (reconstruir temporariamente a camada completa).
- Calcular a passagem forward ou backward dessa camada.
- Libertar de imediato os parâmetros reunidos. Cada GPU guarda apenas o seu próprio shard.
- Reduce-scatter dos gradientes para que cada GPU receba apenas a fatia de gradiente que lhe foi atribuída.
Como o FSDP é nativo do PyTorch, integra-se diretamente com as ferramentas de debugging e os profilers do PyTorch e com o torch.compile. O desempenho relativamente ao DeepSpeed ZeRO-3 depende da política de wrapping, da topologia de comunicação, das definições de offload e do tamanho do modelo, por isso compare-os no mesmo cluster.
| Critério | FSDP (PyTorch) | DeepSpeed ZeRO |
|---|---|---|
| Estilo de controlo | Sharding completo através das APIs do PyTorch | Fases do ZeRO selecionáveis |
| Offloading | Offloading para CPU | CPU + NVMe com ZeRO-Infinity |
| Integração com o framework | PyTorch nativo, caminhos torch.compile | Biblioteca e sistema de configuração separados |
| Teste de seleção | Faça profiling da carga PyTorch alvo | Faça profiling das funcionalidades e do offload necessários |
O FSDP2 (2024–2025) é uma reescrita que melhora a integração com o torch.compile para uma melhor fusão de kernels, acrescenta suporte a treino em FP8 através do TorchAO e simplifica a API. Tanto o FSDP como o DeepSpeed são acessíveis através do Hugging Face Accelerate, que suporta ambos através de configuração para scripts de treino compatíveis e preparados. As definições necessárias de wrapping, checkpointing e offloading continuam a ser diferentes.
29. Leis de escala e custo de inferência
O scaling Chinchilla (DeepMind, 2022) encontrou uma alocação ótima de computação perto de 20 tokens de treino por parâmetro, sob os seus pressupostos. Esse objetivo não inclui o custo de serving a jusante. Se um modelo mais pequeno treinado com mais dados atingir a qualidade exigida, pode custar menos ao longo de um ciclo de vida de inferência de alto volume.
Uma estratégia de custo do ciclo de vida é treinar um modelo mais pequeno com muito mais dados:
| Modelo | Parâmetros | Tokens de treino | Tokens/parâmetro | Tokens/parâmetro ÷ 20 (derivado) |
|---|---|---|---|---|
| Chinchilla | 70B | 1.4T | 20:1 | 1× |
| Llama 1 | 65B | 1.4T | 22:1 | 1× |
| Llama 2 | 70B | 2.0T | 29:1 | 1.4× |
| Llama 3 8B | 8B | 15T | 1,875:1 | 94× |
| Qwen3-0.6B | 0.6B | 36T | 60,000:1 | 3,000× |
Este é o rácio de tokens por parâmetro apresentado, dividido pelo ponto aproximado de 20 tokens por parâmetro do artigo do Chinchilla. É um rácio descritivo, não um multiplicador medido de qualidade ou de custo.
Para um modelo servido em grande volume, gastar mais computação de treino num modelo mais pequeno pode reduzir o custo do ciclo de vida. O Llama 3 8B ilustra a estratégia, mas saber se compensa depende da qualidade exigida e do volume de inferência previsto. “Chinchilla-optimal” refere-se à eficiência da computação de treino, que é um objetivo diferente do custo do ciclo de vida.
30. RLHF, DPO, GRPO e o panorama do alinhamento
O alinhamento orienta um modelo pré-treinado para as instruções, preferências e políticas de segurança desejadas. Por si só, não garante veracidade nem comportamento seguro. Os métodos abaixo trocam complexidade de implementação, requisitos de dados, exploração e estabilidade do treino.
O pipeline RLHF clássico: SFT → recolher pares de preferências humanas → treinar um modelo de recompensa com esses pares → fazer fine-tuning da política com PPO (Proximal Policy Optimization). Uma configuração convencional de PPO tem quatro papéis de modelos: política, referência, crítico/modelo de valor e modelo de recompensa. O seu uso de memória depende da partilha, do sharding, da precisão, do offloading e da colocação; quatro papéis não implicam quatro cópias completas residentes na GPU. O PPO também é sensível aos hiperparâmetros. Também é propenso a reward hacking, em que o modelo explora peculiaridades do modelo de recompensa, como respostas verbosas e com ar confiante, em vez de melhorar genuinamente a qualidade.
O DPO (Direct Preference Optimization) dispensa o modelo de recompensa aprendido e o ciclo de RL online, otimizando diretamente uma loss sobre pares de preferências. Isto simplifica o pipeline de treino. O DPO padrão é offline: treina com um dataset fixo e não explora novas respostas durante o ciclo de atualização. Saber se essa limitação importa depende da tarefa e da cobertura dos dados.
O GRPO (Group Relative Policy Optimization, DeepSeek) remove o crítico aprendido do PPO, gerando várias completions por prompt e usando as recompensas relativas ao grupo como referência. Isto reduz o peso do estado do modelo face a uma configuração típica de PPO. Ao contrário do DPO, o GRPO é on-policy: o modelo gera respostas novas durante o treino. O DeepSeek-R1 combina o GRPO com RLVR (reinforcement learning from verifiable rewards), usando verificações como respostas a problemas de matemática, compilação de código e testes unitários. Estas recompensas são mais fáceis de auditar do que uma pontuação de preferência aprendida, mas testes incompletos e objetivos proxy continuam a poder ser explorados.
| Método | Papéis dos modelos numa configuração convencional | Sinal de recompensa | Online/offline | Limitação principal |
|---|---|---|---|---|
| PPO | Política, referência, crítico, recompensa | Modelo de recompensa aprendido | Online | Reward hacking, ajuste complexo |
| DPO | Política e pontuações de referência, que podem ser pré-calculadas | Implícito (pares de preferências) | Offline | Sem exploração, dados fixos |
| GRPO | Política; referência opcional para KL e modelo de recompensa aprendido opcional | Explícito (regras/verificador ou aprendido) | Online | Depende da qualidade da recompensa e de variação informativa dentro do grupo |
A política de referência no GRPO depende da implementação. Por exemplo, o TRL GRPOTrainer não carrega um modelo de referência quando o seu coeficiente KL beta é zero. Inclua a colocação dos modelos e a precisão ao comparar a memória de treino.
31. Distillation: comprimir conhecimento entre modelos
A distillation de conhecimento transfere capacidades de um professor grande para um aluno mais pequeno. A distillation baseada em logits treina o aluno para reproduzir a distribuição de saída do professor. A distillation baseada em dados faz o professor gerar exemplos com os quais o aluno é afinado. Os métodos baseados em dados são comuns em LLMs porque podem funcionar entre arquiteturas diferentes e com professores acessíveis só por API, mas o seu valor é limitado pela qualidade do professor, pela cobertura dos dados, pela filtragem e pelo custo de geração.
O DeepSeek-R1 selecionou uma mistura de aproximadamente 800 000 exemplos — cerca de 600 000 amostras relacionadas com raciocínio e 200 000 sem raciocínio — e usou-a para fazer distillation de modelos Qwen2.5 e Llama 3 de 1,5B a 70B parâmetros. Na avaliação do artigo:
- O DeepSeek-R1-Distill-Qwen-32B obtém 72,6% no AIME 2024 e 94,3% no MATH-500, acima dos números do OpenAI o1-mini reportados pelo artigo.
- O DeepSeek-R1-Distill-Qwen-7B obtém 55,5% no AIME 2024, acima do resultado do QwQ-32B-Preview reportado pelo artigo, com um modelo mais pequeno.
Nas experiências com modelos pequenos do DeepSeek-R1, a distillation superou o GRPO direto nos modelos base testados. Esse resultado apoia a distillation nesta configuração; não estabelece uma classificação universal entre distillation e RL.
32. Geração de dados sintéticos
Os dados de treino gerados por LLMs são usados em vários padrões recorrentes:
- O Self-Instruct parte de um pequeno conjunto de sementes de instruções escritas por humanos: o LLM gera novas instruções, entradas e saídas, que são filtradas e devolvidas ao conjunto. O projeto Alpaca usou 52 000 exemplos gerados a partir de 175 sementes. A Stanford reportou uma geração de dados abaixo de $500 e um fine-tuning abaixo de $100, o que põe o custo da reprodução inicial abaixo de $600; a comparação com o GPT-3.5 foi uma avaliação limitada do projeto, não uma equivalência ampla.
- O Evol-Instruct (WizardLM) pega em instruções existentes e evolui-as iterativamente ao longo de eixos de complexidade (acrescentando restrições, aprofundando o raciocínio, tornando os problemas mais concretos) para produzir exemplos de treino progressivamente mais difíceis.
- O Phi-4 (14B) da Microsoft usou dados sintéticos para grande parte do pretraining, incluindo geração, crítica, autorrevisão e inversão de instruções. O seu relatório técnico compara o desempenho resultante em STEM e em programação com o de modelos maiores nos benchmarks selecionados.
Um dos riscos é o colapso do modelo quando os dados reais são substituídos recursivamente por dados gerados. Nas configurações estudadas, as partes raras da distribuição original desaparecem progressivamente (Shumailov et al., publicado na Nature em 2024). Este não é um resultado inevitável de todo o uso de dados sintéticos. Um estudo de acumulação separado encontrou um comportamento diferente quando os dados reais e gerados eram mantidos entre gerações. Um estudo de classificador da Ahrefs recolheu uma página inglesa recém-detetada por domínio, de entre 900 000 páginas em abril de 2025, e classificou 74,2% como contendo algum texto gerado por AI. Esse estudo de um fornecedor não é um censo da web. A mitigação começa por misturar dados sintéticos e reais, filtrar e rastrear a linhagem, para que o material gerado recursivamente possa ser medido.
Parte VI — Escalonamento e deployment
Quando uma carga de trabalho deixa de caber, ou de cumprir o seu SLO, num único dispositivo, as escolhas são como dividir o trabalho, que runtime expõe os controlos necessários e se todos os pedidos precisam do mesmo modelo.
33. Quatro formas de paralelismo
As quatro formas diferem na parte do modelo que cada GPU guarda e no que atravessa a ligação entre GPUs. A figura mostra cada uma em duas GPUs.
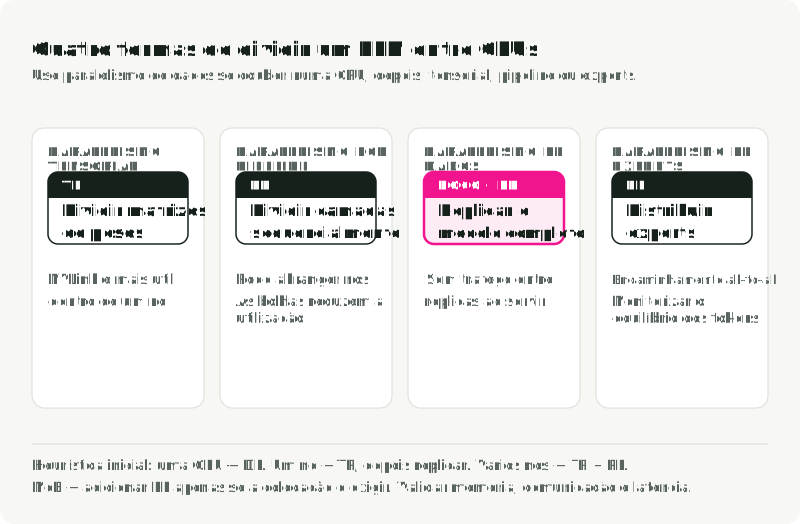
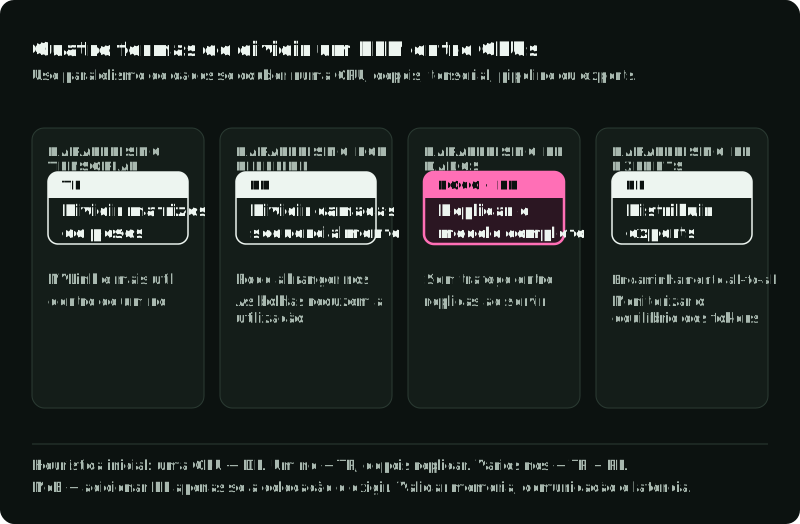
O Paralelismo de Tensores (TP) divide matrizes de pesos individuais entre GPUs e comunica normalmente após cada camada. Ligações rápidas dentro do nó, como o NVLink, tornam-no mais prático dentro de um nó. Mais shards reduzem a memória e a computação por dispositivo, mas aumentam a comunicação, por isso escolha o grau com um benchmark de latência.
O Paralelismo de Pipeline (PP) divide as camadas sequencialmente entre GPUs, passando ativações entre fases. O seu padrão de comunicação pode funcionar entre nós, mas as bolhas do pipeline e os tempos desiguais das fases reduzem a utilização. As implementações grandes combinam muitas vezes TP dentro de um nó e PP entre nós.
O Paralelismo de Dados (DP) replica o modelo de serving, de modo que cada réplica trata pedidos independentes sem comunicação entre réplicas por pedido. É eficiente quando o modelo cabe e o tráfego pode ser equilibrado. No treino, o DP é habitualmente combinado com ZeRO ou FSDP para fazer sharding do estado.
O Paralelismo de Especialistas (EP) distribui os especialistas do MoE pelas GPUs, usando comunicação all-to-all para o encaminhamento de tokens. O seu desempenho depende do equilíbrio de tokens, da colocação dos especialistas e da topologia da interligação; o tráfego all-to-all pode tornar-se o bottleneck dominante.
Uma heurística inicial de paralelismo:
- O modelo cabe numa GPU: comece com réplicas independentes e meça o escalonamento do DP.
- O modelo cabe num nó: teste TP dentro do nó e depois replique o grupo se o tráfego o exigir.
- O modelo abrange vários nós: teste uma combinação de TP e PP face à interligação e ao objetivo de latência.
- Mixture of experts: acrescente EP apenas quando a colocação dos especialistas o exigir.
34. Comparação de frameworks de serving
O runtime decide quais das otimizações da Parte III obtém sem escrever kernels. Use a tabela para escolher o primeiro a testar e depois compare-o com uma alternativa nos mesmos prompts, comprimentos de saída, hardware e SLO.
| Runtime | Use-o quando | Verifique primeiro |
|---|---|---|
| vLLM | Serving geral em GPU com uma API compatível com a OpenAI | O modelo e a GPU alvo na matriz de compatibilidade atual |
| SGLang | O tráfego partilha prefixos longos (system prompts, chat com vários turnos, agentes) ou precisa de structured output | A taxa de acertos da prefix cache no seu próprio tráfego |
| TensorRT-LLM | A frota é só NVIDIA e a latência mais baixa importa mais do que a portabilidade | Suporte para o seu modelo e precisão (FP8, FP4) |
| llama.cpp | CPU, Apple silicon ou uma única GPU de consumo, com modelos quantizados em GGUF | Tokens por segundo da sua ferramenta de benchmark na máquina alvo |
| Ollama | Desenvolvimento local e demos | Passe para um runtime de serving antes de trabalhar com alta concorrência ou SLOs |
Os mesmos pontos de partida para benchmarks, numa lista ordenada:
- Uma máquina local ou uma GPU de consumo: comece com o llama.cpp, ou o Ollama para desenvolvimento.
- Só NVIDIA e a latência é a prioridade: inclua o TensorRT-LLM no benchmark.
- Prefixos partilhados longos ou structured output: SGLang.
- Caso contrário: vLLM.
Faça o benchmark da primeira escolha com os seus prompts, comprimentos de saída, hardware e SLO.
O vLLM oferece alocação paginada da KV, batching contínuo, uma API compatível com a OpenAI e vários modos de paralelismo. O suporte a modelos e hardware muda com frequência.
O SGLang combina o RadixAttention para reutilização de prefixos, um scheduler personalizado e structured output. Os ganhos de throughput que publica dependem da carga de trabalho e da configuração.
TensorRT-LLM visa baixa latência por pedido através da captura e reprodução de grafos CUDA, que reduzem o overhead de lançamento, e da otimização de kernels, incluindo fusão, com suporte nativo para FP8/FP4. Versões anteriores, como a v1.2.0, permitiam construir antecipadamente um motor TensorRT. O guia de migração atual da NVIDIA define PyTorch como único backend: a API LLM e trtllm-serve carregam diretamente um checkpoint Hugging Face, sem construir um motor. Os números publicados são específicos do hardware e do modelo, e o TensorRT-LLM funciona apenas em GPUs NVIDIA.
O TGI foi arquivado em 21 de março de 2026 e o seu repositório é apenas de leitura. O seu README recomenda o vLLM, o SGLang, o llama.cpp ou o MLX para novas implementações.
O Ollama dá ênfase a um fluxo de trabalho local simples com modelos.
O llama.cpp é um runtime portátil em C/C++ com caminhos para ARM, x86, Metal, CUDA, ROCm e Vulkan. O GGUF suporta vários níveis de quantização. O desempenho varia muito com o modelo, a quantização, o contexto e o backend.
35. Seleção de GPUs para inferência
A tabela compara características de hardware publicadas. O suporte de precisão do fornecedor não torna os valores de pico de computação diretamente comparáveis entre formatos, por isso escolha primeiro pelo ajuste da memória e faça benchmark da carga alvo. Verifique separadamente os preços atuais da cloud, porque variam com o fornecedor, a região, o compromisso e a disponibilidade.
| GPU | Memória | Largura de banda | Baixa precisão nativa | NVLink por GPU |
|---|---|---|---|---|
| B200 SXM | 180 GB HBM3e | Até 8 TB/s | FP4, FP8 | 1,8 TB/s |
| H200 SXM | 141 GB HBM3e | 4,8 TB/s | FP8 | 900 GB/s |
| H100 SXM | 80 GB HBM3 | 3,35 TB/s | FP8 | 900 GB/s |
| A100 80 GB SXM | 80 GB HBM2e | 2,039 TB/s | INT8 (sem FP8) | 600 GB/s |
| L40S | 48 GB GDDR6 | 864 GB/s | FP8 | Nenhum |
| A10G (AWS G5) | 24 GB GDDR6 | 600 GB/s | INT8 (sem FP8) | Nenhum |
| RTX 4090 | 24 GB GDDR6X | ~1 TB/s | FP8 | Nenhum |
A linha da A10G usa a especificação da A10 da NVIDIA como aproximação da largura de banda; a especificação AWS G5 ligada não estabelece a largura de banda exata da A10G. O valor da RTX 4090 (1008 GB/s) vem do whitepaper da arquitetura Ada.
A capacidade de 141 GB da H200 pode simplificar algumas implementações de modelos grandes. As placas GDDR das linhas inferiores têm um terço ou menos da largura de banda da H100 e não têm NVLink, pelo que se adequam melhor a modelos quantizados que cabem numa única GPU do que a modelos que precisam de paralelismo de tensores.
O AWQ e o GPTQ servem modelos de 4 bits desquantizando operações matriciais suportadas para um formato de computação como o FP16 ou o BF16. A compatibilidade e a velocidade continuam a depender da arquitetura do modelo, do formato de quantização, do backend de serving, do kernel e da GPU, por isso consulte a matriz de suporte do backend e faça benchmark do artefacto exato. Todas as GPUs listadas suportam operações matriciais INT8.
O decode de LLMs é muitas vezes limitado pela largura de banda de memória, pelo que a capacidade e a largura de banda da HBM podem importar mais do que o pico de TFLOPS nas cargas de serving. Compare as GPUs mantendo constantes o modelo, a precisão, a distribuição dos batches, o comprimento do contexto e o objetivo de latência.
36. Cascading e routing de modelos
O routing de modelos escolhe que LLM trata cada consulta com base na complexidade ou capacidade prevista. O RouteLLM (LMSYS/UC Berkeley, ICLR 2025) reporta uma razão de custos de 3,66x a 95% da pontuação de referência do GPT-4-Turbo no MT-Bench, na Tabela 6. Isto corresponde a um custo modelado cerca de 73% inferior com os preços, o modelo fraco e a configuração de pontuação dessa experiência. Saber se o routing compensa depende dos preços atuais, da mistura de tráfego, dos erros do router e do nível mínimo de qualidade.
Os routers vão de classificadores leves a juízes baseados em LLMs. O cascading é a variante sequencial: uma consulta começa com um modelo mais barato e escala quando uma função de pontuação rejeita a resposta. O FrugalGPT reporta até 98% menos custo ou até 4% mais exatidão no seu conjunto de modelos avaliado. Uma cascata em produção precisa de critérios de escalada calibrados e de monitorização das consultas que o modelo barato aceita incorretamente. A figura mostra onde cada abordagem faz a sua escolha e onde cada uma falha.
Parte VII — Aplicações
As aplicações falham em locais que a stack de serving não vê. A recuperação pode falhar antes de a geração começar, os agentes podem escolher uma ação inválida e uma alteração a um prompt pode melhorar uma tarefa e estragar outra.
37. Modelos de embeddings vs modelos generativos
Os modelos de embeddings codificam texto em vetores de dimensão fixa que captam o significado semântico. Os modelos de vetor único comparados abaixo produzem um vetor denso por entrada, normalmente com algumas centenas a vários milhares de dimensões. Outras arquiteturas de recuperação podem guardar vários vetores ao nível do token; a comparação de armazenamento seguinte refere-se a embeddings de vetor único. As suas bases incluem transformers encoder-only bidirecionais e modelos derivados de decoders adaptados à aprendizagem de representações. Uma camada de pooling reduz muitas vezes as representações por token a um único vetor, através de mean pooling, de um token especial de classificação ou de um método específico do modelo baseado no último token. O fine-tuning contrastivo aproxima depois os textos semanticamente semelhantes e afasta os dissimilares.
Os modelos de embeddings atuais diferem nas propriedades que determinam o custo de armazenamento e a escolha do índice: dimensões de saída, tipos de entrada aceites, forma de disponibilização e precisão de saída.
| Modelo | Dimensões máximas | Entrada | Pesos | Precisão de saída nativa |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 4,096 (32–4,096 via MRL) | Texto | Abertos (Apache 2.0) | Vírgula flutuante |
| Gemini Embedding 2 | 3,072 (128–3,072) | Texto, imagem, vídeo, áudio, PDF | API | Não indicada |
| pplx-embed-v1-4B | 2,560 (MRL) | Texto | Abertos (MIT) | INT8 e binária |
| OpenAI text-embedding-3-large | 3,072 (reduzidas via dimensions) | Texto | API | Vírgula flutuante |
Estes são exemplos, não uma classificação. Avalie língua, modalidade, tarefa, dimensão e custo de serving num único conjunto de recuperação.
O Matryoshka Representation Learning (MRL, Kusupati et al., NeurIPS 2022) torna flexíveis as dimensões dos embeddings. Com o nome das bonecas russas encaixáveis, o MRL treina prefixos selecionados dos embeddings para reter informação útil. As experiências comparam esses prefixos com representações mais pequenas treinadas separadamente; igualar a sua qualidade é um resultado empírico, não uma garantia para todas as tarefas. Durante o treino, o MRL agrega as losses sobre um conjunto escolhido de dimensões de prefixo, normalmente reduções sucessivas a metade; o exemplo de 2048 dimensões do artigo usa . A loss agregada leva as primeiras dimensões a transportar informação semântica grosseira, com as dimensões seguintes a acrescentarem detalhe mais fino.
Depois do treino, um embedding MRL pode ser truncado para uma dimensão de prefixo suportada. A OpenAI reporta que o text-embedding-3-large com 256 dimensões supera o text-embedding-ada-002 com 1536 dimensões na comparação MTEB que cita. Isso dá uma redução de 6x no armazenamento bruto dos vetores; a latência da pesquisa e o custo da base de dados dependem também do índice, dos metadados, da filtragem e do hardware.
O modelo de embeddings é um componente importante de um pipeline de RAG, a par do parsing, do chunking, da pesquisa, do reranking e da geração. Se a evidência relevante não for recuperada, um gerador mais forte não consegue recuperá-la de forma fiável.
38. Arquitetura de RAG em produção
A Retrieval-Augmented Generation fornece a um LLM documentos recuperados no momento da consulta. Pode fornecer evidência atual ou privada que está ausente dos pesos do modelo, mas a recuperação não garante que a resposta use essa evidência corretamente. Um sistema RAG em produção é um pipeline com várias fases, que precisam de avaliação separada. A figura mostra o caminho de ingestão offline, o caminho por consulta e onde ocorrem os três modos de falha listados abaixo.
O pipeline de ingestão corre offline. Os documentos em bruto (PDFs, HTML, Markdown, bases de dados) são primeiro convertidos em texto limpo. O parsing de PDFs pode perder tabelas, cabeçalhos e formatação. O texto é depois dividido em chunks, cujos embeddings são gerados e indexados de forma independente.
O chunking afeta tanto o recall da recuperação como o contexto disponível para o gerador. Os tamanhos úteis dependem da estrutura do documento, da granularidade das consultas, dos limites do modelo de embeddings e dos limites do reranker. As abordagens comuns são tamanho fixo com sobreposição, divisão recursiva ao longo das fronteiras do documento e chunking semântico por similaridade de embeddings. Compare-as com etiquetas de relevância ao nível da página ou da secção em vez de adotar universalmente um único intervalo de tokens.
Cada chunk tem depois o seu embedding gerado com um modelo como os da Secção 37 e é guardado num índice vetorial. O pgvector mantém os vetores numa base de dados Postgres que já tenha em execução. Um armazenamento dedicado, como o Qdrant, o Weaviate ou o Pinecone, acrescenta pesquisa híbrida integrada e escala o índice separadamente da base de dados da aplicação.
O pipeline de recuperação corre no momento da consulta. Comece com uma baseline mensurável e acrescente fases quando a análise de erros mostrar que respondem a uma falha real:
- A pesquisa híbrida combina a recuperação vetorial densa com uma recuperação esparsa como o BM25, muitas vezes fundidas por Reciprocal Rank Fusion (RRF). A pesquisa densa trata das paráfrases semânticas; a esparsa apanha identificadores exatos, códigos de erro e acrónimos. Os benchmarks de fornecedores reportam ganhos face às baselines só vetoriais, mas a dimensão depende do corpus e das etiquetas de relevância.
- O reranking passa os candidatos recuperados por um modelo que pontua em conjunto a consulta e o documento. Isto pode melhorar a relevância fina ao custo de mais uma chamada a um modelo. O número de candidatos, o número retido e a latência devem ser ajustados em conjunto. Tratei o pipeline completo de várias fases em Construir uma stack moderna de ranking de pesquisa.
- A transformação da consulta reescreve a consulta do utilizador antes da recuperação para melhorar o recall. O HyDE (Hypothetical Document Embeddings) faz o LLM gerar um documento hipotético, cujo embedding é usado para recuperar documentos reais. O texto gerado é uma representação para pesquisa, não evidência verificada para a resposta. A multi-query expansion gera várias formulações da mesma pergunta. O step-back prompting faz primeiro uma pergunta mais geral para recuperar informação ou raciocinar a partir de princípios mais gerais.
Os modos de falha comuns:
- Falha de recuperação — o documento correto existe, mas não é recuperado. Teste chunking, transformação da consulta, pesquisa híbrida e filtragem por metadados face à falha.
- Context poisoning — chunks recuperados irrelevantes induzem o LLM em erro. Teste reranking, filtros de contexto e conjuntos retidos mais pequenos.
- Lost-in-the-middle — nos cenários testados de perguntas e respostas sobre vários documentos e de recuperação chave-valor, Liu et al. verificaram que o desempenho das respostas era geralmente mais alto quando a informação relevante aparecia perto do início ou do fim da entrada e mais baixo quando aparecia no meio.
O GraphRAG (Microsoft, 2024) extrai entidades e relações, deteta comunidades no grafo e cria resumos dessas comunidades. O seu método de pesquisa global responde a perguntas ao nível do corpus a partir desses resumos; não é simplesmente recuperação vetorial com um grafo acrescentado. O compromisso é o trabalho adicional de extração, indexação, armazenamento e avaliação.
Os guias de profissionais publicam intervalos de latência para embeddings, pesquisa, reranking e geração, mas esses valores variam com a região, o corpus, o hardware e o modelo. Meça cada fase em traces e avalie a alteração de qualidade antes de aceitar a latência adicional.
39. Arquiteturas de agentes e tool calling
Os agentes LLM usam modelos para selecionar e sequenciar tool calls em torno de um estado em evolução. Três padrões úteis de orquestração são:
- ReAct — intercala a seleção de ações com observações. Consegue adaptar-se após cada tool result, mas um histórico crescente aumenta o custo em tokens e em latência.
- ReWOO — planeia as tool calls com marcadores de posição e dependências explícitas entre resultados, executa o plano e depois sintetiza. Só as chamadas independentes podem correr em paralelo; uma chamada que refere um resultado anterior tem de esperar por ele. O seu artigo reporta poupanças de tokens face ao ReAct, mas o plano fixo precisa de um caminho de recuperação explícito quando uma ferramenta falha.
- Planner-executor — separa o planeamento da execução e pode acrescentar uma política de replaneamento após uma falha. Permite um modelo diferente para cada papel, mas acrescenta estado do plano e uma segunda chamada a um modelo que pode falhar.
| Padrão | Trabalho repetido do modelo | Adaptabilidade | Ponto de partida útil |
|---|---|---|---|
| ReAct | Lê as observações antes da ação seguinte | Atualiza após as observações | Tool use incerto ou exploratório |
| ReWOO | Reutiliza um plano com dependências explícitas | Plano fixo, salvo se for estendido | Trabalho que pode ser planeado antes dos tool results |
| Planner-executor | Planeia, executa e pode voltar a planear | Pode rever o plano explícito | Tarefas mais longas que beneficiam de controlo |
A figura desenha os três padrões, para que se veja onde cada um planeia e se tem um caminho de volta após um tool result.
O function calling é um mecanismo comum de invocação de ferramentas. As APIs expõem definições de ferramentas e devolvem argumentos estruturados, o que reduz a necessidade de fazer parsing de texto livre. Argumentos válidos segundo o schema podem ainda selecionar a ferramenta errada ou conter valores inválidos. O function calling paralelo pode reduzir as idas e voltas quando as operações são independentes.
O structured output e o constrained decoding impõem um schema restringindo os tokens disponíveis em cada passo de geração. Motores como o xgrammar, usado no vLLM e no SGLang, conseguem eliminar muitas falhas de sintaxe e de parsing com baixo overhead em configurações suportadas. Não garantem que os valores extraídos ou as decisões estejam corretos. O Schema-Guided Reasoning (SGR) usa a ordem dos campos e a estrutura do schema para tornar inspecionável o estado intermédio antes da decisão final. Os seus três padrões são Cascade (passos sequenciais), Routing (union types como comutadores semânticos) e Cycle (listas limitadas).
Um conjunto de ferramentas maior e uma sequência de ações mais profunda podem reduzir a qualidade da seleção e aumentar a latência ou o custo em tokens. Meça essas curvas com as descrições reais das ferramentas e a distribuição real de falhas. Frameworks como o LangGraph podem tornar explícitos o estado e os caminhos de recuperação, mas não eliminam o encargo da avaliação.
40. Prompt engineering para produção
O prompting em produção é um problema de avaliação: altere uma parte do prompt ou do contexto e meça depois a qualidade da tarefa e os modos de falha. As técnicas abaixo são pontos de partida comuns, não uma ordem universal.
Os exemplos few-shot são muitas vezes eficazes para controlar o formato da saída. Comece com 3–5 exemplos que cubram entradas vazias, consultas ambíguas e respostas com várias partes e meça depois o resultado num conjunto de validação separado. Os exemplos devem abranger a distribuição real das entradas e não apenas o caminho feliz. Mais exemplos consomem contexto e não garantem mais ganhos.
O prompting com chain-of-thought (CoT) pede a um modelo que exponha o raciocínio intermédio antes de responder. Kojima et al. (2022) reportaram ganhos com o sufixo “Let’s think step by step” nas suas tarefas de raciocínio testadas, mas o efeito varia com o modelo e as APIs de raciocínio mais recentes podem não expor os traces ocultos. Em produção, prefira uma decomposição inspecionável da tarefa ou uma justificação concisa quando for útil ao avaliador. A self-consistency (Wang et al., 2023) amostra vários caminhos de raciocínio e agrega as respostas, trocando custo adicional de inferência por robustez em tarefas adequadas.
O structured output com JSON Schema explícitos (Secção 39) elimina muitas falhas de parsing. Motores de constrained decoding como o xgrammar conseguem impor a gramática suportada durante a geração; a exatidão factual e a validade semântica continuam a exigir avaliação, e funcionalidades de schema não suportadas podem ainda precisar de tratamento.
O prompt chaining divide uma tarefa em fases focadas, por exemplo classificar a intenção → recuperar contexto → gerar a resposta → validar a saída. Pode localizar falhas, permitir modelos diferentes por fase e expor estado intermédio que pode ser colocado em cache. Também acrescenta interfaces e latência, por isso compare-o com uma baseline de chamada única.
A temperature altera a distribuição de amostragem. Valores baixos são um ponto de partida razoável para classificação ou extração; valores mais altos podem aumentar a diversidade na geração de ideias. O comportamento exato difere entre as APIs de modelos e interage com top_p, top_k e as predefinições do fornecedor, por isso varra as definições suportadas na tarefa em vez de copiar um único intervalo.
A separação entre mensagens de system e de user mantém a política persistente à parte do conteúdo de cada pedido. Os chat templates e o instruction tuning dão a estes papéis prioridades diferentes, mas não fazem da mensagem de system uma fronteira de imposição. Coloque o comportamento estável na mensagem de system, mantenha os dados não confiáveis em conteúdo de user ou de ferramentas e imponha também fora do modelo as restrições rígidas, como a remoção de PII.
O context engineering alarga o trabalho de prompting à montagem de documentos recuperados, tool results, histórico de conversa e exemplos. Liu et al. encontraram um efeito lost-in-the-middle nos modelos de contexto longo que testaram, pelo que a posição deve fazer parte da avaliação e não ser assumida como irrelevante. Tratei o fluxo de trabalho mais amplo em Context engineering para agentes AI.
Parte VIII — Operações em produção
As operações em produção transformam os conceitos anteriores em limites de admissão, testes de carga, alertas e decisões de capacidade sob tráfego real.
41. Rate limiting para pedidos com custo variável
O rate limiting tradicional por pedidos por segundo assume um custo aproximadamente igual por pedido. Os LLMs quebram esse pressuposto. Um prompt de classificação de 10 tokens e uma análise de documentos de 100K tokens atingem o mesmo endpoint da API mas diferem no comprimento da entrada por um fator de 10 000. O custo total também depende do comprimento da saída, do modelo, da cache e dos preços. Limitar por RPS ou deixa passar pedidos caros sem controlo ou deixa à míngua, sem necessidade, os pedidos baratos.
Os sistemas de produção precisam de rate limiting baseado em tokens em várias dimensões. A OpenAI documenta limites de pedidos e de tokens por escalão de utilização. A Anthropic separa os limites de tokens de entrada e de saída. As quotas e os algoritmos exatos podem mudar, por isso trate a documentação do fornecedor como a fonte de verdade; o ponto arquitetural é orçamentar pedidos e tokens de forma independente.
Uma implementação ao nível da aplicação é uma hierarquia multidimensional de limites (utilizador → aplicação → organização → global), com níveis de prioridade para acesso premium. Em cada pedido, reserve tokens na admissão: estime o total (entrada + max_tokens), desconte a estimativa da reserva e devolva a parte não utilizada quando o pedido terminar, de acordo com o consumo real. Isto impede que uma rajada de pedidos com gerações longas esgote a capacidade antes de produzir saída. Um pedido com 2000 tokens de entrada e max_tokens = 1000 reserva 3000. Se a resposta utilizar 200 tokens de saída, o consumo real é de 2200 e são devolvidos 800. Esta é uma política local de admissão; os algoritmos de quotas dos fornecedores podem usar estimativas diferentes e orçamentos separados para entrada e saída. Se a reserva tiver menos de 3000, devolva um 429 ou coloque o pedido em fila.
Em implementações self-hosted, o equivalente é o throughput provisionado: reservar capacidade de GPU dedicada para taxas de tokens alvo. Em implementações de vLLM, isso significa configurar o controlo de admissão em torno dos slots de decode ativos e da pressão sobre a KV cache e não apenas do número de pedidos. Como explica a Secção 5, o throughput e a admissão precisam ambos de limites sensíveis a tokens.
42. Modos de falha a considerar
O serving de LLMs acrescenta modos de falha ligados ao comprimento variável das sequências, à memória de KV e ao trabalho de decode de longa duração. Desenhe e teste sob carga as defesas antes de o tráfego de produção depender delas.
O Out-of-Memory (OOM) é uma falha comum. Um modelo de 70B em FP16 precisa de cerca de 140 GB só para os pesos, e a KV cache de uma única sequência do Llama 3.1 70B com contexto de 128K pode acrescentar cerca de 40 GiB, sob os pressupostos da Secção 6. A diferença entre “cabe na memória” e “OOM sob carga” é menor do que parece, porque um batch de pedidos de contexto longo pode consumir mais memória de KV do que o esperado. A prevenção combina uma reserva de memória medida com quantização e alocação paginada da KV. No vLLM, --gpu-memory-utilization define a fração da memória da GPU que o motor pode usar para pesos, ativações e KV cache; o resto é a reserva. Para cargas com alta pressão sobre a KV, o LMCache pode fazer offload de dados de KV para a memória do CPU ou para disco; use os resultados que publica como ponto de partida e faça benchmark da hierarquia de memória local.
A preempção acontece quando a pressão sobre a KV cache obriga o scheduler a despejar ou recalcular trabalho. A estratégia exata depende da versão e da configuração do serving. Do lado do utilizador, o sintoma é uma latência de ponta a ponta mais alta sem um erro evidente da aplicação. Observe o número de preempções e correlacione-o com o uso de KV, a profundidade da fila e os comprimentos dos pedidos.
A latência de cauda pode disparar quando prefills grandes atrasam o trabalho de decode. O chunked prefill (Secção 7) e o escalonamento atento ao comprimento visam esta interferência. Os artigos do scheduler Learning-to-Rank (Fu et al., 2024) e do CascadeInfer reportam melhorias face às suas baselines nas cargas avaliadas, mas o resultado exato depende da distribuição de comprimentos dos pedidos e da configuração do scheduler.
As falhas em cascata podem começar quando pedidos lentos fazem crescer a fila, os clientes a montante expiram e os retries acrescentam mais carga. As defesas incluem controlo de admissão, limites de concorrência por tenant, limites máximos de saída, orçamentos de retries e circuit breakers no gateway. Pools de prefill e decode desagregados podem ajudar quando os testes de carga mostram interferência persistente entre fases. A figura mostra o ciclo e a defesa em cada aresta.
43. Monitorização de sistemas LLM
A monitorização de LLMs difere da monitorização de APIs em três aspetos: cada pedido tem um custo diferente, cada pedido tem duas fases com bottlenecks diferentes e a sua pegada de memória depende do comprimento tanto da entrada como da saída. A latência dos pedidos e a taxa de erros, por si sós, não mostram nenhum destes aspetos.
O goodput é o número de pedidos por segundo que cumprem todos os limiares de SLO definidos, como o TTFT, o TPOT e a latência total. É uma medida combinada útil porque o throughput bruto pode parecer saudável enquanto os SLOs de latência falham: um sistema que processa 100 pedidos por segundo mas falha os seus limiares em 40% deles tem um goodput de 60 pedidos por segundo. Otimizar o goodput mantém visível a distribuição do desempenho, em vez de reportar apenas a média.
O vLLM expõe um endpoint Prometheus em /metrics com pedidos em execução e em espera, uso da KV cache, distribuições do comprimento de geração e estatísticas da prefix cache. Os nomes das métricas podem mudar entre versões, por isso associe os dashboards à versão em produção. Uma stack típica usa o Prometheus para métricas, o Grafana para visualização e traces compatíveis com OpenTelemetry entre os componentes da aplicação e do serving.
Padrões de alerta úteis incluem os seguintes. Derive os seus limiares a partir de testes de carga em vez de copiar estes exemplos sem alterações:
- Picos na contagem de preempções — o runtime está a trocar ou a recalcular trabalho, o que acrescenta latência sem um erro da aplicação.
- Utilização da KV cache a aproximar-se da região de preempção testada — acrescente capacidade ou descarte carga antes de os despejos se propagarem em cascata.
- Profundidade da fila persistentemente acima do envelope de batch testado — o controlo de admissão deve começar a rejeitar ou a despriorizar.
- TTFT a subir enquanto o TPOT se mantém estável — esta divergência aponta primeiro para pressão de fila, de admissão, de rede ou de prefill e não para o throughput do decode. Use traces e métricas de fila para as distinguir.
No vLLM, os três primeiros alertas correspondem a vllm:num_preemptions_total, vllm:kv_cache_usage_perc e vllm:num_requests_waiting (métricas do vLLM).
44. Otimização de custos: uma estratégia cumulativa
Os preços dos fornecedores e os rácios de preço entre entrada e saída mudam. Consulte as tarifas atuais antes de uma decisão de compra; o escalão do modelo e o comprimento da saída podem dominar a fatura mesmo antes das otimizações de infraestrutura.
A OpenAI, a Anthropic e a Google cobram todas os tokens de saída a vários múltiplos do preço dos tokens de entrada nos seus modelos de topo. Separadamente, a divisão entre prefill e decode explica por que razão a entrada e a saída têm custos de execução diferentes: o prefill processa os tokens do prompt em conjunto, enquanto o decode normal gera os tokens sequencialmente. Este mecanismo, por si só, não estabelece como um fornecedor define os preços comerciais. Cortar saída desnecessária (um max_tokens apertado, structured output, sem repetir a entrada) costuma poupar mais do que cortar o mesmo número de tokens de entrada.
Várias abordagens podem ser combinadas, mas só depois de medir quais se aplicam à carga de trabalho:
- A quantização de FP16 para INT4 corta o armazenamento dos valores brutos dos pesos em 75%, antes das escalas e de outros metadados. Saber se isso reduz a fatura depende da velocidade do kernel, do tamanho do batch e da utilização do hardware (Secção 9).
- O routing de modelos envia o tráfego elegível para modelos mais baratos. Meça a taxa de falsas aceitações do router e a qualidade de ponta a ponta antes de aumentar a quota tratada pelo modelo mais barato (Secção 36).
- O prompt caching reduz o trabalho de prefixos repetidos. Os descontos dos fornecedores e o tratamento dos rate limits mudam ao longo do tempo, por isso combine a taxa de acertos medida com os termos atuais (Secção 16).
- As batch APIs podem dar desconto em trabalho não em tempo real, como avaliações, geração de dados sintéticos e classificação em massa. Verifique os preços atuais e as janelas de conclusão.
- O self-hosting pode compensar com utilização sustentada, mas não há um ponto de equilíbrio universal em volume de tokens. Inclua os custos de engenharia, orquestração, observabilidade, folga de capacidade e on-call, além do aluguer de GPUs.
Não multiplique ganhos separados de otimização como se todos os pedidos beneficiassem deles de forma independente: a quantização altera o débito, o encaminhamento altera a distribuição de qualidade, e a cache e o processamento por lotes só se aplicam ao tráfego elegível. Construa a estimativa a partir das proporções de tráfego medidas e valide-a face à fatura.
45. Planeamento de capacidade e autoscaling
O planeamento de capacidade do serving de LLMs tem de ter em conta o custo variável dos pedidos, o trabalho de decode de longa duração e a memória que depende da sequência. Consoante a carga de trabalho, o recurso limitante pode ser a memória de KV, a largura de banda de memória, a computação ou a interligação.
O limite teórico de memória para pedidos concorrentes vem do orçamento da KV cache:
Para a aritmética de capacidade, suponha que o runtime expõe um orçamento de KV de 40 GiB para o Llama 3.1 70B com uma KV cache em FP16. Cada sequência de 4K usa cerca de 1,25 GiB e cada sequência de 128K cerca de 40 GiB. Esse orçamento comporta, portanto, no máximo cerca de 32 sequências de 4K ou uma sequência de 128K, antes do overhead do alocador, do runtime, da variância da carga e do SLO. A função kv_cache_bytes da Secção 6 repete este cálculo para outro modelo ou orçamento. É por isso que a seleção de GPUs e a otimização da KV cache determinam diretamente o plano de capacidade.
A fórmula de capacidade para dimensionar a frota:
Converta ambas as taxas para a mesma unidade de tempo antes de dividir. Use o throughput por GPU medido no SLO alvo, não o throughput de pico. Um multiplicador de 1,3 disponibiliza 30% mais throughput do que a procura prevista, o que deixa cerca de 23% da capacidade disponibilizada por usar nessa procura. Arredonde por excesso para réplicas completas de serving; uma réplica TP/PP precisa do seu grupo completo de GPUs. As taxas por GPU só são úteis para uma topologia de réplicas fixa e medida. Escolha o multiplicador a partir da variabilidade das rajadas, das falhas e do tempo de recuperação medidos. O throughput de pico de tokens e o throughput que cumpre o SLO podem diferir muito à medida que a concorrência sobe. Faça benchmark com a distribuição real de prompts e de comprimentos de saída nos limiares exigidos de TTFT e TPOT, em vez de usar um máximo teórico.
A utilização da GPU é insuficiente como único sinal de autoscaling porque pode manter-se alta tanto durante um processamento saudável como numa sobrecarga. Combine-a com a profundidade da fila, a utilização da KV cache e a degradação do goodput. Ajuste os limiares a partir de testes de carga; valores como 80% de utilização de KV são pontos de partida, não limites universais. Estas métricas são apresentadas na Secção 43.
O scale-to-zero pode adequar-se a ambientes de desenvolvimento e de staging com longos períodos de inatividade. As plataformas de inferência serverless e os autoscalers baseados em Kubernetes, como o KEDA, conseguem remover capacidade inativa, mas a poupança e o tempo de cold start dependem do tamanho do modelo, da cache de imagens e de pesos e da infraestrutura. Meça o tempo de arranque antes de usar a mesma política para tráfego de produção sensível à latência.
Como os conceitos de inferência se ligam
As Partes I a III ligam a capacidade de memória ao desempenho de serving. O tamanho da KV por sequência (Secção 6) dá um limite bruto ao número de sequências residentes. Batches de decode maiores podem melhorar a reutilização dos pesos e a intensidade aritmética (Secção 1), mas o tráfego de attention, o escalonamento e a comunicação também afetam o TPOT e o throughput. O GQA e o armazenamento KV de menor precisão reduzem o volume da cache; o PagedAttention reduz o desperdício de alocação. Com a configuração indicada do Llama 3.1 70B, uma KV cache em FP16 e um orçamento de 40 GiB, o limite bruto é de 32 sequências de 4K tokens ou uma de 128K, antes do overhead do runtime e das restrições de latência. O controlo de admissão pode colocar trabalho em fila ou rejeitá-lo antes de esse limite ser atingido. Sob pressão da KV, o runtime pode fazer preempção de pedidos; alocações sem controlo podem causar OOM (Secção 42).
O routing, o caching, a quantização e a escolha de hardware só se acumulam quando cada um é avaliado face ao mesmo objetivo de qualidade e de latência. Escolha um sintoma da tabela no início, estabeleça essa baseline e faça com que a alteração seguinte seja fácil de reverter.
Leitura adicional
Artigos relacionados deste blogue, organizados por tema:
- Guia de fine-tuning de LLM — quando fazer fine-tuning vs. RAG vs. prompt engineering
- Variantes de LLM open-source e formatos de ficheiros — adequar variantes de modelos e formatos quantizados ao hardware
- Guia de serving com LoRAX — servir milhares de adaptadores LoRA em produção
- Escalar modelos de linguagem grandes — estratégias multi-GPU e multi-nó
- LLMs locais no macOS — configuração prática com llama.cpp e Ollama
- Reasoning loops de agentes AI em 2026 — análise aprofundada dos loops ReAct, ReWOO e planner-executor
- Arquitetura de memória de agentes AI em 2026 — checkpoints, vector stores e memória de documentos para agentes com estado
Referências
Organizadas por área temática.
Inferência e attention
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness - Dao et al., NeurIPS 2022
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning - Dao, 2023
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision - Shah et al., NeurIPS 2024
- Flash-Decoding for long-context inference - Dao et al., 2023
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022
- GQA: Training Generalized Multi-Query Attention - Ainslie et al., 2023
- Triton: an intermediate language and compiler for neural network computations - Tillet et al., MAPL 2019
- FlashNorm: Fast Normalization for LLMs - 2024
- Deep Kernel Fusion for Transformers - DeepFusionKernel, 2026
Descodificação especulativa
- Accelerating Large Language Model Decoding with Speculative Sampling - Chen et al., 2023
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models - Li et al., NeurIPS 2025
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - ICML 2024
Quantização
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration - MLSys 2024 Best Paper
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers - Frantar et al., ICLR 2023
- Marlin: Mixed-Precision (FP16xINT4) LLM Inference Kernel - Frantar et al., 2024
Treino e fine-tuning
- LoRA: Low-Rank Adaptation of Large Language Models - Hu et al., ICLR 2022
- QLoRA: Efficient Finetuning of Quantized LLMs - Dettmers et al., NeurIPS 2023
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models - Rajbhandari et al., SC20
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning - Rajbhandari et al., 2021
- Self-Instruct: Aligning Language Models with Self-Generated Instructions - Wang et al., ACL 2023
- WizardLM: Empowering Large Language Models to Follow Complex Instructions - Xu et al., ICLR 2024
- Phi-4 Technical Report - Microsoft, 2024
- Training Deep Nets with Sublinear Memory Cost - Chen et al., 2016 (gradient checkpointing)
- AI models collapse when trained on recursively generated data - Shumailov et al., Nature 2024
Alinhamento
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model - Rafailov et al., NeurIPS 2023
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models - Introduziu o GRPO
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning - DeepSeek, 2025
Escala e arquitetura
- The Llama 3 Herd of Models - Meta, 2024
- LLaMA: Open and Efficient Foundation Language Models - Touvron et al. (Meta), 2023
- Llama 2: Open Foundation and Fine-Tuned Chat Models - Touvron et al. (Meta), 2023
- Qwen3 Technical Report - Qwen Team (Alibaba), 2025
- Training Compute-Optimal Large Language Models - Hoffmann et al. (Chinchilla), NeurIPS 2022
- RoFormer: Enhanced Transformer with Rotary Position Embedding - Su et al., 2021
- YaRN: Efficient Context Window Extension of Large Language Models - Peng et al., ICLR 2024
- SGLang: Efficient Execution of Structured Language Model Programs - Zheng et al., NeurIPS 2024
- Mixtral of Experts - Jiang et al. (Mistral AI), 2024
Embeddings
- Matryoshka Representation Learning - Kusupati et al., NeurIPS 2022
- pplx-embed-v1: Diffusion-Pretrained Dense and Contextual Embeddings - Perplexity AI, 2026
Arquiteturas de agentes
- ReAct: Synergizing Reasoning and Acting in Language Models - Yao et al., ICLR 2023
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models - Xu et al., 2023
Prompting
- Large Language Models are Zero-Shot Reasoners - Kojima et al., NeurIPS 2022
- Self-Consistency Improves Chain of Thought Reasoning in Language Models - Wang et al., ICLR 2023
Routing
- RouteLLM: Learning to Route LLMs with Preference Data - Ong et al., ICLR 2025
Benchmarks
- MLPerf Inference v5.0 Results - MLCommons, abril de 2025
Arquiteturas de serving
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve - Agrawal et al., OSDI 2024 (chunked prefill)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting - Patel et al., ISCA 2024 (serving desagregado)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving - Zhong et al., OSDI 2024 (serving desagregado)
Frameworks de serving
- vLLM - motor de serving baseado em PagedAttention
- SGLang - RadixAttention e structured output
- TensorRT-LLM - inferência otimizada da NVIDIA
- llama.cpp - inferência portátil em C/C++
- DeepSpeed - biblioteca de treino distribuído da Microsoft
- Ollama - executor local de LLMs
Operações
- Efficient LLM Scheduling by Learning to Rank - Fu et al., NeurIPS 2024 (vLLM-LTR)
- CascadeInfer: Length-Aware Scheduling of LLM Serving with Low Latency and Load Balancing - Yuan et al., 2025
- Goodput metric as measure of ML productivity - Google Cloud, 2024
- vLLM Optimization and Tuning - documentação do vLLM
- vLLM Metrics - documentação do vLLM
- LMCache: KV Cache Management for LLM Serving - offloading da KV cache
- OpenAI Rate Limits - documentação da API da OpenAI
- Anthropic Rate Limits - documentação da API da Anthropic