Przewodnik po inżynierii LLM: 45 pojęć dla systemów produkcyjnych

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
To materiał referencyjny dla inżynierów, którzy znają podstawy ML i systemów, a chcą powiązać objaw w produkcji z odpowiednią częścią stosu. Obejmuje 45 pojęć z zakresu sprzętu, inferencji, treningu, wdrażania, aplikacji i operacji. Każdy wpis opisuje mechanizm, jego wpływ na działający system oraz warunek, w którym przytoczony wynik jest prawdziwy. Jeśli zaczynasz od objawu, na przykład wolnego pierwszego tokena albo OOM pod obciążeniem, skorzystaj z poniższej tabeli objawów, aby znaleźć wpisy do przeczytania.
Na konkretne pytanie skorzystaj z krótkich odpowiedzi o inżynierii LLM. Każdy temat ma osobną odpowiedź i odsyła do odpowiedniej sekcji przewodnika.
| Część | Tematy | Sekcje |
|---|---|---|
| I — Podstawy sprzętowe | Model roofline, pamięć GPU, słownik pojęć sprzętowych | 1–3 |
| II — Podstawy inferencji | Opóźnienie, przepustowość, KV cache, attention, kwantyzacja | 4–9 |
| III — Optymalizacje inferencji | Kernele CUDA, FlashAttention, batching, PagedAttention, speculative decoding | 10–17 |
| IV — Architektura modelu | Budowa transformera, modele decoder-only, MoE, tokenizacja, okna kontekstu | 18–22 |
| V — Trening i alignment | Pretraining, LoRA, trening mieszanej precyzji, ZeRO, prawa skalowania, RLHF/DPO/GRPO, destylacja | 23–32 |
| VI — Skalowanie i wdrażanie | Parallelism, frameworki serwujące, wybór GPU, routing | 33–36 |
| VII — Aplikacje | Embeddings, RAG, agenci, inżynieria promptów | 37–40 |
| VIII — Operacje produkcyjne | Rate limiting, tryby awarii, monitorowanie, koszty, planowanie pojemności | 41–45 |
Zacznij od objawu
Każdy wiersz wskazuje wpisy do przeczytania najpierw oraz to, co zmierzyć, zanim zmienisz stos.
| Objaw lub decyzja | Zacznij od | Co zmierzyć przed zmianą stosu |
|---|---|---|
| Pierwszy token pojawia się wolno | Prefill i decode, TTFT | Czas w kolejce, długość promptu, czas prefill i P99 TTFT |
| Tokeny napływają wolno | Roofline, TPOT | TPOT w zależności od współbieżności, przepustowość pamięci i kształt batcha |
| Długie konteksty powodują wywłaszczanie lub OOM | KV cache, PagedAttention | Zajętość KV, długości żądań, straty alokatora i liczba wywłaszczeń |
| Model nie mieści się w budżecie | Kwantyzacja, Wybór GPU | Jakość, przepustowość kernela, rezerwa pamięci i goodput przy docelowym SLO |
| Wybór środowiska serwującego | Frameworki serwujące, Parallelism | Przepustowość i opóźnienie P99 przy docelowym SLO na własnych promptach |
| Żądania przekraczają limit czasu pod obciążeniem | Tryby awarii, Rate limiting | Głębokość kolejki, wywłaszczenia, częstość ponowień i długości odpowiedzi |
| Trening się nie mieści | LoRA i QLoRA, ZeRO, FSDP | Pamięć stanu modelu, komunikacja, przepustowość i jakość na zbiorze wydzielonym |
| Koszty rosną | Routing, optymalizacja kosztów | Kwalifikowalność ruchu, błędy jakości, współczynnik trafień cache i dane z faktur |
Dalsze przewodniki według decyzji
| Jeśli decydujesz… | Zacznij od | Następnie przeczytaj |
|---|---|---|
| Jak serwować wiele dostrojonych adapterów | Podstawy inferencji i wdrażanie | Przewodnik po serwowaniu LoRAX |
| Czy kwantyzować | Kwantyzacja | Przewodnik po kwantyzacji modeli |
| Jak podzielić model między GPU | Parallelism | Skalowanie dużych modeli językowych |
| Czy robić fine-tuning | Trening i alignment | Przewodnik po fine-tuningu LLM |
| Jak wyszukiwanie wpisuje się w aplikację | Embeddings i RAG | Metryki ewaluacji RAG |
| Jak działają systemy agentowe | Agenci i inżynieria promptów | Pętle rozumowania agentów AI |
| Jak rankingować wyniki wyszukiwania | Embeddings i reranking | Stos rankingu wyszukiwania |
Część I — Podstawy sprzętowe
Intensywność arytmetyczna, hierarchia pamięci GPU i pojęcia sprzętowe z tej części wyjaśniają wiele wyborów w dalszej części przewodnika.
1. Ograniczenie pamięcią a ograniczenie obliczeniami oraz model roofline
Punktem wyjścia dla wydajności LLM jest intensywność arytmetyczna: ile użytecznych obliczeń GPU wykonuje na każdy bajt danych wczytany z pamięci? Ten stosunek decyduje, czy operacja jest ograniczona obliczeniami (czeka na jednostki obliczeniowe), czy ograniczona pamięcią (czeka na wczytanie danych).
Każde GPU ma „krytyczną intensywność”, przy której jego szczytowa wydajność obliczeniowa równa się przepustowości pamięci. Dla NVIDIA H100 SXM z gęstymi rdzeniami Tensor w BF16 lub FP16 (989 TFLOPS; specyfikacja 1979 TFLOPS zakłada rzadkość strukturalną):
Poniższy wykres roofline pokazuje osiągalną wydajność obliczeniową w funkcji intensywności arytmetycznej. Nachylona linia to obszar ograniczony pamięcią, w którym limit wyznacza przepustowość; pozioma linia to maksymalna przepustowość obliczeniowa; punkt przecięcia to próg 295 FLOPs/byte.
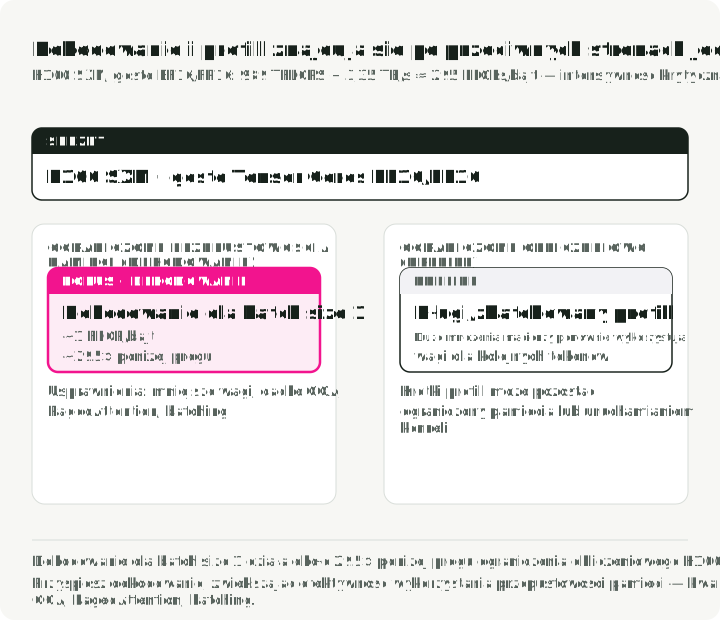
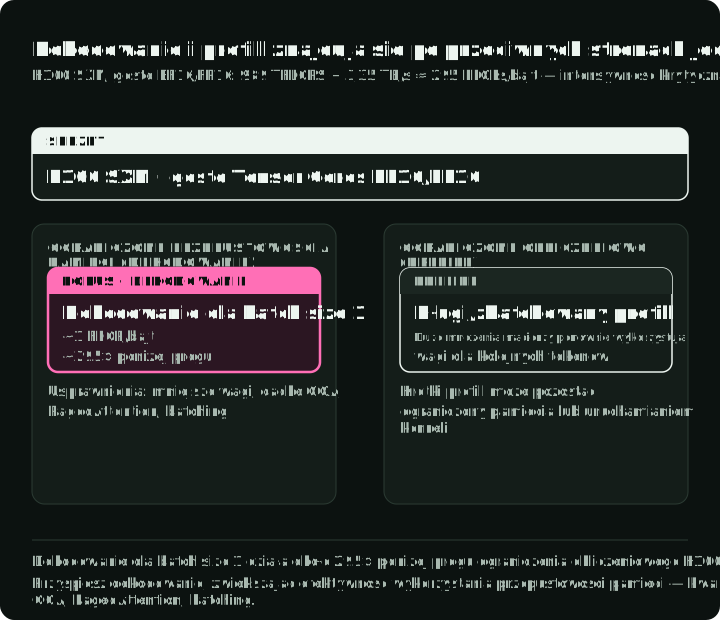
Decode przy batchu o rozmiarze jeden oraz długi lub dostatecznie zbatchowany prefill zwykle leżą po przeciwnych stronach tego progu:
- Decode jest ograniczony pamięcią. Generowanie tokenów jeden po drugim oznacza wczytywanie z pamięci wielogigabajtowej macierzy wag, aby pomnożyć ją przez jeden nowy token. W uproszczonej analizie dla gęstego modelu 16-bitowego i batcha o rozmiarze jeden operacja ma około 1 FLOP/byte, czyli mniej więcej 295 razy poniżej progu roofline H100. Ta różnica wyjaśnia, dlaczego w tym reżimie decode nie może zbliżyć się do szczytowej wydajności obliczeniowej.
- Długi lub dostatecznie zbatchowany prefill jest często ograniczony obliczeniami. Przetwarzanie wielu tokenów promptu ponownie wykorzystuje wagi w dużych mnożeniach macierzy, co może podnieść intensywność arytmetyczną powyżej progu roofline. Krótkie prompty i małe batche mogą być natomiast ograniczone ruchem pamięci lub narzutem uruchamiania kerneli.
Aby więc przyspieszyć decode, popracuj nad przepustowością pamięci: zmniejsz wagi przez kwantyzację, zmniejsz narzut pamięci KV dzięki GQA i PagedAttention, a intensywność podnieś przez batching. W długich lub dobrze zbatchowanych prefillach pomóc może szybsze mnożenie macierzy i obliczenia w niższej precyzji; obciążenia z krótkim prefillem profiluj osobno.
2. Hierarchia pamięci GPU
GPU ma cztery warstwy pamięci o różnych pojemnościach i szybkościach dostępu. Rejestry są małe i szybkie; HBM mieści znacznie więcej danych, ale dostęp do niej trwa dłużej. Przenoszenie danych między tymi warstwami to jedno z głównych ograniczeń wydajności. Rysunek pokazuje H100 SXM: rejestry i pamięć współdzieloną wewnątrz każdego SM, L2 na układzie oraz 80 GB HBM3 w stosach obok niego.
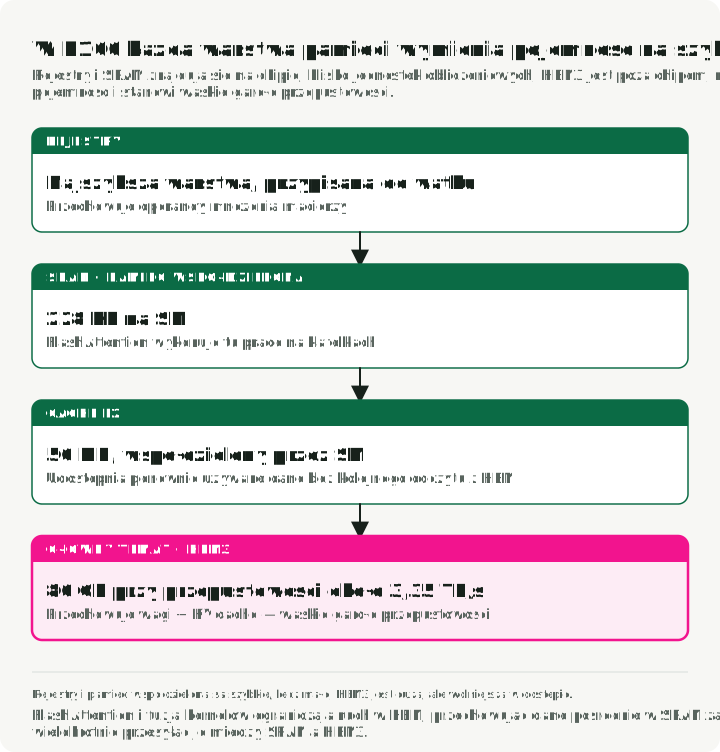
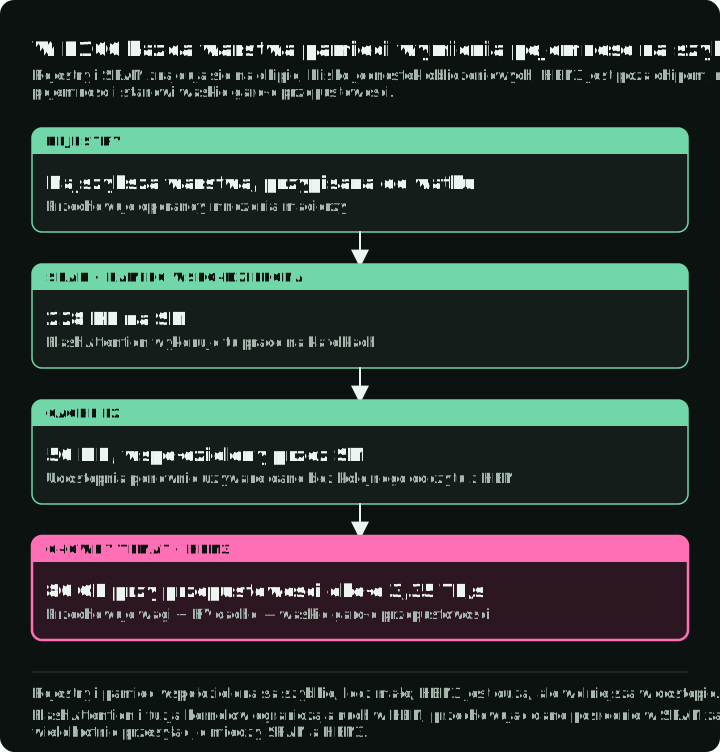
Od najszybszej do najwolniejszej w H100 SXM:
- Rejestry to najszybsza pamięć, podłączona bezpośrednio do wątków obliczeniowych. W instrukcji WGMMA architektury Hopper macierz A może pochodzić z rejestrów lub pamięci współdzielonej, a macierz B pochodzi z pamięci współdzielonej.
- SRAM (pamięć współdzielona) to szybka pamięć robocza na chipie, lokalna dla każdego SM.
- Pamięć podręczna L2 to 50 MB warstwa współdzielona. Może udostępniać dane wykorzystywane ponownie przez wiele SM bez kolejnego pobrania z HBM.
- HBM3 to 80 GB pamięci głównej, która przechowuje wagi modelu i KV cache, z przepustowością ~3,35 TB/s.
Różnica między poziomami na chipie i poza nim jest duża. W A100 artykuł o FlashAttention szacuje przepustowość SRAM na chipie na około 19 TB/s, wobec 1,5–2,0 TB/s dla HBM (Dao et al., 2022), czyli mniej więcej 10-krotną różnicę. FlashAttention i fuzja kerneli zmniejszają ruch do HBM, ponieważ zachowują lub łączą pośrednie wyniki na chipie. PagedAttention rozwiązuje inny problem: mapuje logiczne bloki KV na nieciągłe fizyczne bloki pamięci GPU, co zmniejsza fragmentację i umożliwia współdzielenie bloków.
3. Słownik pojęć sprzętowych GPU
Poniższe pojęcia pojawiają się w całej reszcie przewodnika.
HBM (High Bandwidth Memory) układa w stos warstwy DRAM połączone przelotkami krzemowymi (TSV) obok układu GPU. Generacje to HBM2e (A100, 2 TB/s), HBM3 (H100, 3,35 TB/s) i HBM3e (H200/B200, 4,8–8 TB/s). Przepustowość HBM bezpośrednio ogranicza TPOT w reżimach decode ograniczonych pamięcią.
GDDR (Graphics DDR) to tradycyjna pamięć graficzna stosowana w GPU konsumenckich i stacjach roboczych, takich jak RTX 4090 i L40S. Te karty mają mniejszą przepustowość pamięci niż H100 SXM. Według białej księgi architektury Ada NVIDIA GDDR6X w RTX 4090 zapewnia 1008 GB/s wobec 3,35 TB/s HBM3 w H100 SXM.
SM (Streaming Multiprocessor) to podstawowy blok obliczeniowy GPU NVIDIA. Każdy SM zawiera rdzenie CUDA, rdzenie Tensor, pamięć współdzieloną i planistę warpów. H100 SXM ma 132 SM; H100 PCIe ma ich 114. A100 ma ich 108.
Rdzenie Tensor to wyspecjalizowane jednostki mnożenia i akumulacji macierzy wewnątrz każdego SM. Przyspieszają mnożenia macierzy o mieszanej precyzji, które dominują w obliczeniach transformera. Rdzenie Tensor H100 SXM zapewniają 494,5 TFLOPS TF32 w trybie gęstym lub 989 w rzadkim; porównując tę wartość, zawsze podawaj precyzję i tryb rzadkości.
Rdzenie CUDA to uniwersalne jednostki zmiennoprzecinkowe i całkowitoliczbowe. Obsługują operacje element po elemencie, funkcje aktywacji i inne obliczenia niemacierzowe, podczas gdy rdzenie Tensor wykonują obsługiwane operacje macierzowe.
Warp to grupa 32 wątków na SM. Wątki mogą wykonywać różne ścieżki, a GPU od generacji Volta obsługują niezależne szeregowanie wątków. Specjalizacja warpów przypisuje różne warpy do przesyłania danych i obliczeń, aby te zadania mogły się nakładać.
NVLink to szybkie połączenie NVIDIA między GPU w obrębie węzła. NVLink 4.0 w H100 zapewnia dwukierunkową przepustowość 900 GB/s; NVLink 5.0 w B200 osiąga 1,8 TB/s. Ta przepustowość ma znaczenie dla tensor parallelism, ponieważ GPU wymieniają częściowe wyniki w każdej warstwie transformera.
InfiniBand to szybka sieć do komunikacji między węzłami. Karty InfiniBand klasy ConnectX stanowią sieć międzywęzłową dla ruchu pipeline parallelism lub treningu rozproszonego; przepustowość zależy od karty i konfiguracji portów.
RDMA (Remote Direct Memory Access) pozwala urządzeniu uzyskać dostęp do pamięci innej maszyny bez kierowania ścieżki danych przez którykolwiek z CPU. GPUDirect RDMA obsługuje bezpośrednie transfery między GPU w różnych węzłach, w tym transfery KV cache w serwowaniu zdezagregowanym.
NVMe (Non-Volatile Memory Express) to interfejs SSD używany do odciążania KV cache oraz parametrów w ZeRO-Infinity, gdy pamięci GPU i CPU nie wystarczają. Przepustowość sekwencyjna zależy od dysku i obciążenia i pozostaje daleko poniżej przepustowości HBM.
TFLOPS i PFLOPS to biliony i biliardy operacji zmiennoprzecinkowych na sekundę. Jeden TFLOPS to FLOPS. H100 osiąga 989 TFLOPS TF32 w trybie rzadkim, a FlashAttention-3 raportuje około 1,2 PFLOPS w FP8; te wartości dotyczą różnych formatów i nie należy ich porównywać jak jednej metryki.
Część II — Podstawy inferencji
Inferencja zmienia model w usługę widoczną dla użytkownika. Poniższe pojęcia rozdzielają pracę opóźniającą pierwszy token od pracy spowalniającej każdy kolejny token i pokazują limity pamięci stojące za oboma.
4. Opóźnienie: TTFT, TPOT i percentyle
Time to First Token (TTFT) to opóźnienie od wysłania żądania do pierwszego tokena wyjściowego, mierzone end-to-end. Obejmuje kolejkowanie, tokenizację, szeregowanie, przebieg prefill, który tworzy pierwszy token, oraz dostarczenie przez sieć. Popularne silniki serwujące próbkują pierwszy token wyjściowy z logitów przebiegu forward w prefill, więc przed nim nie działa osobny krok decode. Dłuższe prompty zwykle zwiększają składnik prefill, ale dowolny z tych etapów może dominować. Cele zależą od produktu; MLPerf Inference v5.0 stosuje limit P99 TTFT 450 ms w scenariuszu interaktywnym dla Llama 2 70B.
Time Per Output Token (TPOT) to średni odstęp między kolejnymi tokenami po pierwszym. Odpowiada fazie decode. Decode przy batchu o rozmiarze jeden lub o niskiej intensywności jest zwykle ograniczony przepustowością pamięci, natomiast dostatecznie duże batche mogą stać się ograniczone obliczeniami:
Ta definicja wymaga co najmniej dwóch tokenów wyjściowych; dla odpowiedzi jednotokenowej TPOT jest niezdefiniowany. W tym równaniu opóźnienie E2E kończy się na ostatnim tokenie wyjściowym. Pomiar do zakończenia HTTP może obejmować też późniejsze metadane lub zamykanie połączenia; zapisuj go osobno.
Szacunek szybkości czytania po angielsku daje orientacyjny punkt odniesienia dla strumieniowania. Przeciętna szybkość cichego czytania dorosłych po angielsku to około 238 słów na minutę dla tekstów niefabularnych (Brysbaert, 2019), czyli około 4 słów na sekundę. Jeśli token ma średnio trzy czwarte słowa, daje to około 5 tokenów na sekundę, czyli 200 ms na token. Ten szacunek nie jest progiem użyteczności: język, tokenizer, zadanie i buforowanie klienta zmieniają wynik. Interaktywny scenariusz MLPerf stosuje znacznie ostrzejszy limit P99 TPOT 40 ms. Własny cel ustal na podstawie testów produktu.
Opóźnienie P50 a P99 ma znaczenie, ponieważ mediana ukrywa ogon. System z dobrym P50 i złym P99 może mieć problemy z batchingiem, wywłaszczaniem, kolejkowaniem lub nierównym rozkładem obciążenia; do ich rozróżnienia potrzebne są ślady (traces).
5. Przepustowość: tokeny na sekundę i kompromis z opóźnieniem
Przepustowość mierzy się w tokenach wyjściowych na sekundę dla równoległych żądań. Same żądania na sekundę to słabsza miara, ponieważ odpowiedź 10-tokenowa i 1000-tokenowa mają bardzo różne koszty. Publikowane wyniki benchmarków zależą od modelu, precyzji, sprzętu, długości promptów i odpowiedzi, współbieżności oraz SLO. vLLM, SGLang i TensorRT-LLM porównuj jednym zestawem testowym, zamiast zestawiać ich nagłówkowe wyniki.
Zwiększenie małego batcha decode może podnieść przepustowość dzięki współdzieleniu odczytów wag. Większe batche lub wyższe obciążenie w końcu zwiększają opóźnienie albo osiągają limity pamięci, obliczeń lub komunikacji. Zmierz tę zależność, zamiast zakładać skalowanie liniowe. Goodput, czyli liczba żądań na sekundę spełniających cele SLO, łączy surową przepustowość z tym, czego faktycznie doświadczają użytkownicy.
6. KV cache: pamięć rosnąca z każdym tokenem
Podczas generowania autoregresyjnego z pełnym attention każdy nowy token odwołuje się do bieżącego i poprzednich tokenów. KV cache przechowuje projekcje Key i Value, dzięki czemu generowanie nie przelicza projekcji wcześniejszych tokenów w każdym kroku. Decode z pełnym attention nadal odczytuje rosnącą historię; łączna praca attention nad generowaną sekwencją pozostaje kwadratowa względem jej długości.
W konwencjonalnym cache MHA lub GQA z pełnym attention pamięć rośnie liniowo wraz z długością sekwencji, rozmiarem batcha i liczbą warstw. Poniższy wzór nie stosuje się bez zmian do architektur MLA, z oknem przesuwnym, rekurencyjnych ani hybrydowych:
gdzie:
- = liczba warstw
- = liczba głowic KV
- = wymiar głowicy
- = długość sekwencji
- = rozmiar batcha
- = liczba bajtów na przechowywany element, wyznaczona przez precyzję KV cache
Konkretne przykłady dla FP16 i batcha o rozmiarze 1: Llama 3.1 8B przy 8192 tokenach zużywa ~1,07 GB (1 GiB) KV cache; przy 128K tokenów to 16 GiB. Llama 3.1 70B przy 128K tokenów potrzebuje 40 GiB (około 43 GB) dla jednej sekwencji, czyli około połowy 80 GB H100. Przy wysokiej współbieżności lub długim kontekście KV cache może przekroczyć pamięć wag modelu; wynik zależy od długości sekwencji, liczby aktywnych sekwencji w batchu, precyzji KV i liczby głowic KV. Pierwotna ewaluacja vLLM z 2023 roku wykazała 60–80% strat wskutek fragmentacji i prealokacji w porównywanych systemach.
Główne optymalizacje to GQA (mniej głowic KV), kwantyzacja KV cache (FP8/INT8), PagedAttention (alokacja blokowa) oraz przenoszenie danych KV nadających się do ponownego użycia do CPU lub NVMe. Korzyści zależą od obciążenia i implementacji.
Aby odpowiedzieć na pytanie „ile sekwencji mieści się w moim budżecie KV?” dla innego modelu, odczytaj z jego config.json trzy liczby: num_hidden_layers, num_key_value_heads i head_dim, jeśli występuje. W przykładach Llama wymiar głowicy to hidden_size / num_attention_heads. Pamięć na urządzenie zależy też od podziału cache i ewentualnego powielania głowic KV. Poniższa funkcja stosuje ten wzór; asercje odtwarzają powyższe liczby oraz przykład pojemności w sekcji 45.
def kv_cache_bytes(layers, kv_heads, head_dim, seq_len, batch=1, bytes_per_elem=2):
    """Bytes of KV cache: a key and a value per layer, KV head, and token."""
    return 2 * layers * kv_heads * head_dim * seq_len * batch * bytes_per_elem

GiB = 2**30

# Llama 3.1 8B: 32 layers, 8 KV heads, head dimension 128, FP16 cache.
llama_8b = kv_cache_bytes(32, 8, 128, seq_len=8_192)
print(f"8B at 8K tokens: {llama_8b / 1e9:.2f} GB")  # 1.07 GB
assert llama_8b == 1 * GiB

# Llama 3.1 70B: 80 layers, 8 KV heads, head dimension 128.
assert kv_cache_bytes(80, 8, 128, seq_len=131_072) == 40 * GiB

# How many 4K-token sequences fit in a 40 GiB KV budget?
per_4k = kv_cache_bytes(80, 8, 128, seq_len=4_096)
print(f"70B at 4K tokens: {per_4k / GiB:.2f} GiB per sequence")  # 1.25 GiB
print("4K sequences in 40 GiB:", 40 * GiB // per_4k)  # 32
assert 40 * GiB // per_4k == 32

# An FP8 KV cache halves the size per sequence and doubles the count.
assert 40 * GiB // kv_cache_bytes(80, 8, 128, 4_096, bytes_per_elem=1) == 64
Wynik jest górną granicą. Środowisko uruchomieniowe potrzebuje też pamięci na aktywacje, narzut alokatora i zapas na zmienność długości żądań.
7. Prefill a decode: dwie fazy, dwa wąskie gardła
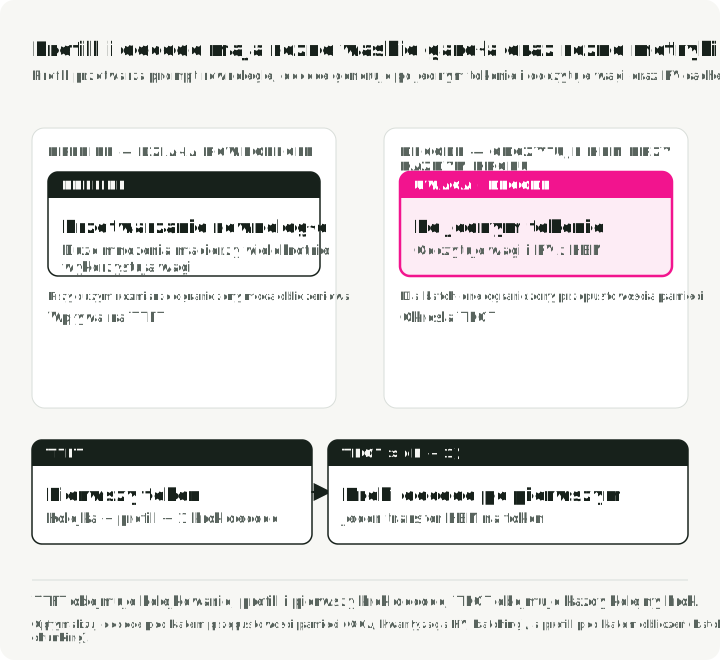
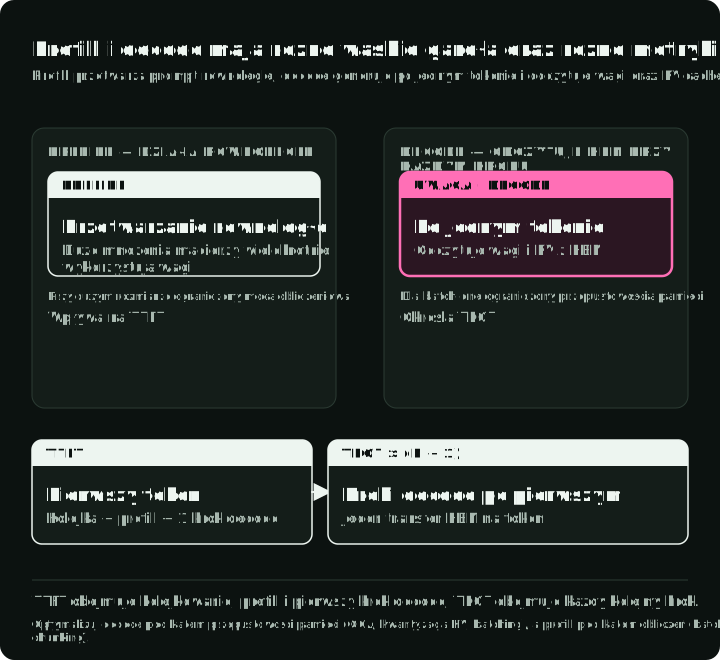
Faza prefill przetwarza prompt wejściowy równolegle i wypełnia KV cache. Długie lub dostatecznie zbatchowane prefille często stają się ograniczone obliczeniami, ponieważ używają dużych mnożeń macierzy; krótkie prefille mogą pozostać ograniczone ruchem pamięci lub narzutem uruchamiania kerneli. Prefill składa się na czas do pierwszego tokena (TTFT) obok kolejkowania, tokenizacji, szeregowania i dostarczenia przez sieć; jego przebieg forward tworzy też pierwszy token wyjściowy. Faza decode generuje po jednym tokenie. Każdy krok wczytuje wagi modelu i KV cache z HBM, przez co decode przy batchu o rozmiarze jeden jest ograniczony przepustowością pamięci i jest głównym czynnikiem czasu na token wyjściowy (TPOT).
Rysunek pokazuje jedno żądanie: prefill ponownie wykorzystuje wagi dla kolejnych tokenów promptu i kończy się pierwszym tokenem, w ramach TTFT; każdy późniejszy krok dekodowania ponownie odczytuje wagi i KV cache dla jednego tokena i wpływa na TPOT.
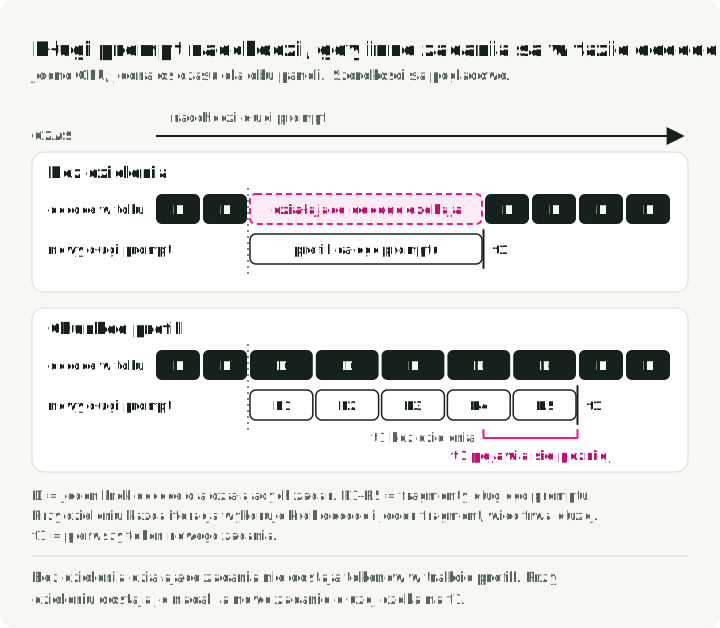
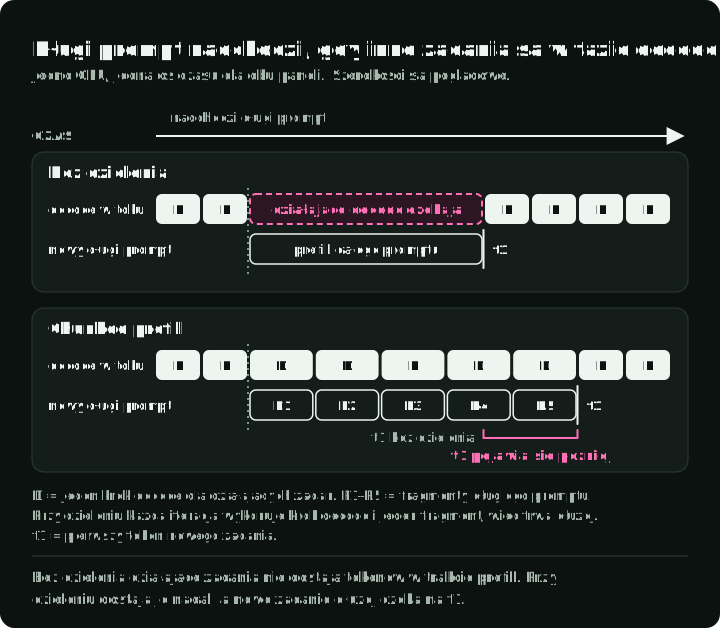
Chunked prefill dzieli długi prompt na fragmenty i szereguje je razem z działającymi decode. Rzeczywisty rozmiar fragmentów może zmieniać się zależnie od dostępnego budżetu tokenów w iteracji. W Sarathi-Serve (sekcja 4.2) i w vLLM planista najpierw wkłada do batcha działające decode, a resztę budżetu tokenów na iterację wypełnia tokenami prefill. Długi prompt nie powstrzymuje już pozostałych żądań przed otrzymywaniem tokenów. Płaci za to nowe żądanie: jego prefill trwa kilka iteracji, a każdy fragment ponownie czyta KV cache wcześniejszych fragmentów. Sarathi-Serve zmierzył około 25% dodatkowego czasu prefill dla Yi-34B z tensor parallelism o stopniu dwa i fragmentami po 512 tokenów (sekcja 5.4.1), a dokumentacja vLLM podaje, że mniejszy budżet tokenów daje lepsze opóźnienie między tokenami i gorszy TTFT. Sarathi-Serve raportuje lepsze kompromisy między przepustowością a opóźnieniem w testowanych obciążeniach, ale zysk zależy od modelu, sprzętu, rozkładu długości żądań, rozmiaru fragmentu i punktu odniesienia.
Serwowanie zdezagregowane umieszcza prefill i decode w osobnych pulach GPU, dzięki czemu każda pula może celować w inne wąskie gardło. Wzorzec opisują Splitwise i DistServe. Pula prefill wysyła KV cache każdego żądania do puli decode. DistServe używa NVLink wewnątrz węzła i InfiniBand między węzłami; Splitwise używa InfiniBand, który obsługuje RDMA. Koszt transferu staje się częścią projektu.
Rysunek umieszcza oba harmonogramy na jednej osi czasu: jeden długi prompt nadchodzi, gdy inne żądania są w fazie decode. Dzielenie utrzymuje dopływ tokenów innych żądań i przesuwa pierwszy token nowego żądania na później.
8. GQA i MQA: zmniejszanie KV cache
Standardowy Multi-Head Attention (MHA) daje każdej głowicy zapytań własne głowice K i V. Multi-Query Attention (MQA) współdzieli jedną głowicę KV między wszystkie głowice zapytań, co jest redukcją skrajną. Grouped-Query Attention (GQA) to praktyczny kompromis: grupy głowic zapytań współdzielą jedną głowicę KV. Rysunek przedstawia osiem głowic zapytań i głowice KV, które zachowuje każdy wariant; KV cache maleje proporcjonalnie do liczby głowic KV.
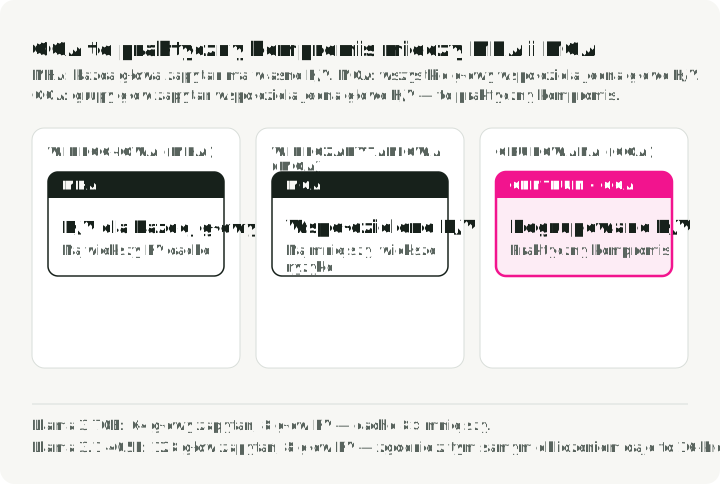
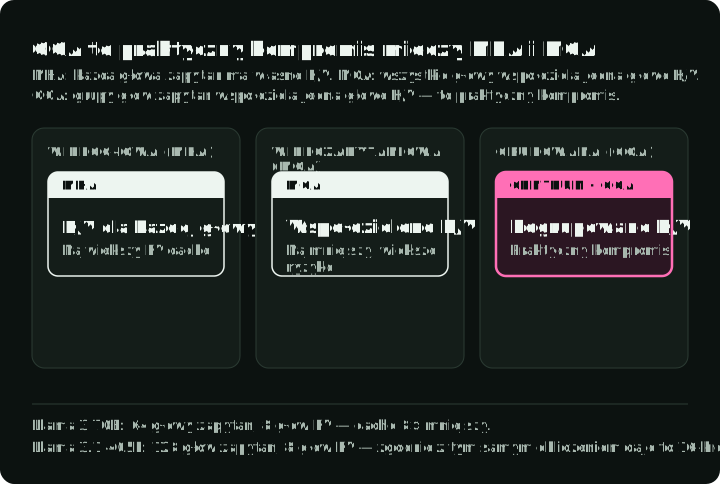
Llama 3 70B używa 64 głowic zapytań, ale tylko 8 głowic KV, co daje 8-krotne zmniejszenie KV cache w porównaniu z tą samą architekturą z jedną głowicą KV na głowicę zapytań. Llama 3.1 405B używa 128 głowic zapytań i 8 głowic KV, czyli 16-krotnej redukcji według tego samego rachunku (Meta, 2024). Ainslie et al. raportują jakość GQA zbliżoną do MHA w testowanych modelach przy szybkości zbliżonej do MQA. Mniejszy KV cache może obsłużyć większe batche, ale rzeczywisty zysk w opóźnieniu i przepustowości nadal zależy od kernela i obciążenia.
9. Kwantyzacja: wymiana bitów na szybkość i pamięć
Kwantyzacja zmniejsza precyzję wag i/lub aktywacji modelu. Podstawowe kompromisy:
| Format | Bity | Pamięć wag (model 7B) | Uwaga o jakości |
|---|---|---|---|
| FP16/BF16 | 16 | ~14 GB | Punkt odniesienia do porównań |
| FP8 | 8 | ~7 GB | Natywny sprzętowo na Hopper; oceń model |
| INT8 | 8 | ~7 GB | Zależy od kalibracji i kernela |
| INT4 | 4 | ~3,5 GB | Większa kompresja; oceniaj ostrożnie |
AWQ (Activation-Aware Weight Quantization) wskazuje istotne kanały wag na podstawie wielkości aktywacji i stosuje skalowanie na kanał, aby je chronić. Wymagania kalibracyjne zależą od modelu i konfiguracji; w jednym porównaniu OPT-6.7B INT3-g128 AWQ użył 16 sekwencji kalibracyjnych, a GPTQ 192. W powtarzalnej konfiguracji podawaj zarówno liczbę sekwencji, jak i ich długość. GPTQ wykorzystuje przybliżone informacje drugiego rzędu do kwantyzacji warstwa po warstwie. bitsandbytes potrafi kwantyzować podczas ładowania modelu, bez osobnego przebiegu przygotowawczego; jego format NF4 napędza fine-tuning QLoRA. FP8 na sprzęcie klasy Hopper zmniejsza o połowę pamięć wag względem FP16/BF16, ale jakość i szybkość nadal zależą od modelu, kalibracji i kernela.
Tabela przypisuje każdą metodę do zadania, do którego zwykle pasuje. Przewodnik po kwantyzacji modeli opisuje każdą metodę dogłębnie.
| Metoda | Dane kalibracyjne | Typowe zastosowanie |
|---|---|---|
| AWQ lub GPTQ (INT4 tylko wagi) | Tak, mała próbka | Serwowanie dużego modelu na GPU z ograniczoną pamięcią przez obsługiwany kernel INT4 |
| bitsandbytes NF4 | Nie | Fine-tuning QLoRA i szybkie eksperymenty |
| FP8 | Mała próbka lub skalowanie dynamiczne | Serwowanie na GPU Hopper lub nowszych, z kontrolą jakości na zadaniu docelowym |
| INT8 (W8A8) | Tak, dla skal aktywacji | GPU bez FP8, takie jak A100 lub A10G, gdy kernel serwujący to obsługuje |
Kernel serwujący może mieć takie samo znaczenie jak algorytm kwantyzacji. Sekcja 10 podaje ograniczony wynik dla Marlin i wyjaśnia, dlaczego zysk zależy od konfiguracji serwowania.
Część III — Optymalizacje inferencji
Optymalizacje z tej części rozwiązują różne ograniczenia. FlashAttention zmniejsza ruch attention do HBM; PagedAttention poprawia alokację KV; continuous batching zapobiega zajmowaniu pojemności batcha przez zakończone sekwencje.
10. Kernele CUDA i fuzja kerneli
Kernel CUDA to funkcja napisana dla GPU, wykonywana równolegle na tysiącach wątków. Gdy CPU wywołuje kernel, GPU rozdziela pracę między swoje SM: każdy SM uruchamia wiele warpów po 32 wątki, a każdy wątek przetwarza fragment danych. Implementacja serwowania oparta na CUDA wykonuje pracę GPU przez kernele. Liczba uruchomień zależy od grafu modelu, kompilatora, środowiska uruchomieniowego i fuzji. Implementacja kernela może przesądzić, czy system spełni swoje SLO opóźnienia.
Główne kategorie kerneli w serwowaniu LLM:
- Kernele GEMM do mnożenia macierzy, które dominują w obliczeniach zarówno prefill, jak i decode.
- Kernele attention, takie jak FlashAttention, które dzielą obliczenia na kafelki, aby pozostać w SRAM zamiast przelewać dane do HBM.
- Kernele fuzyjne, które łączą wiele operacji (na przykład add + layer norm lub projekcję QKV) w jedno uruchomienie, aby pominąć pośrednie przejścia przez HBM.
- Kernele próbkowania, które zamieniają logity na identyfikatory tokenów przez próbkowanie top-k, top-p lub z temperaturą.
Jakość kernela może przesądzić, czy skompresowane wagi dają przyspieszenie. Artykuł o Marlin raportuje do 2,8-krotnego przyspieszenia end-to-end względem bazowego FP16 dla testowanych konfiguracji vLLM z kwantyzacją INT4 samych wag. Wynik dotyczy modeli, GPU, rozmiarów batcha i konfiguracji serwowania z artykułu, więc nie jest uniwersalnym zyskiem z INT4.
Triton obniża próg wejścia w pisanie własnych kerneli, udostępniając programowanie GPU przez Pythona zamiast surowego CUDA C++, dzięki czemu optymalizacja na poziomie kerneli staje się osiągalna dla inżynierów ML, a nie tylko dla specjalistów od GPU. Większość optymalizacji z dalszej części tego rozdziału (FlashAttention, kernele fuzyjne, PagedAttention) to albo lepsze kernele, albo mądrzejsze sposoby orkiestracji ich uruchamiania.
Fuzja kerneli łączy kolejne operacje w jeden kernel GPU i pomija pośrednie zapisy do HBM. Typowe fuzje to projekcja QKV, attention z softmaxem oraz dodawanie rezydualne z RMSNorm. FlashNorm łączy natomiast skalowanie RMSNorm z następną projekcją liniową i odkłada normalizację. DeepFusionKernel łączy kompletny MLP SwiGLU, w tym mnożenia macierzy. Dokładne zyski w liczbie uruchomień i wykorzystaniu zależą od grafu modelu, kompilatora, GPU i frameworka serwującego, więc profiluj wdrożony stos zamiast opierać się na uniwersalnym procencie.
11. FlashAttention: attention dzielone na kafelki, aby mieściło się w SRAM
Standardowe attention materializuje w HBM pełną macierz attention , co kosztuje pamięć i generuje duży ruch pamięci. Pomysł FlashAttention polega na tym, aby tej macierzy w ogóle nie materializować. Dzieli macierze Q, K, V na bloki mieszczące się w SRAM, liczy częściowe attention wewnątrz każdego kafelka i scala wyniki za pomocą softmaxu online (przyrostowo śledzi bieżące maksimum i sumę między blokami). Pamięć wyników pośrednich spada z do , z mniejszą liczbą odczytów i zapisów HBM dla kształtów testowanych w artykule. Arytmetyka gęstego attention pozostaje kwadratowa względem długości sekwencji.
Każda wersja celuje w wąskie gardło swojej generacji GPU:
- FlashAttention v1 (A100, 2022) udowodnił, że idea kafelkowania z softmaxem online działa. Artykuł raportował 2–4-krotne przyspieszenie względem standardowego attention, ale tylko 25–40% wykorzystania GPU. Artykuł o FA2 przypisuje to operacjom niemacierzowym, komunikacji przez pamięć współdzieloną i ograniczonej równoległości.
- FlashAttention v2 (A100, 2023) przebudował równoległość tak, aby dzielić pracę po wymiarze sekwencji oraz po batchu i głowicach. Osiągnął 50–73% wykorzystania na A100, czyli mniej więcej 2 razy szybciej niż v1.
- FlashAttention v3 (H100 Hopper, 2024) dodał specjalizację warpów (osobne warpy do przesyłania danych i do obliczeń) oraz potokowanie GEMM i softmaxu, aby nakładać wczytywanie z pamięci na obliczenia. Artykuł raportuje do 740 TFLOPS w FP16 (75% wykorzystania) i blisko 1,2 PFLOPS w FP8 na H100.
- FlashAttention v4 (B200 Blackwell, 2026) adresuje nowe wąskie gardło: na Blackwell przepustowość rdzeni tensor rośnie tak szybko, że ograniczeniem stają się operacje niemacierzowe (wykładnicze w softmaxie, przeskalowania). FA4 programowo emuluje wykładniczą za pomocą aproksymacji wielomianowych na jednostkach FMA, stosuje warunkowe przeskalowanie, by zmniejszyć narzut, i przechowuje wyniki pośrednie w dedykowanej pamięci tensorowej Blackwell (TMEM) zamiast w rejestrach. Artykuł raportuje około 1,6 PFLOPS na B200 w BF16, 1,3 raza szybciej niż cuDNN 9.13 i 2,7 raza szybciej niż Triton w jego testach.
12. FlashDecoding: zrównoleglenie wąskiego gardła decode
Standardowy FlashAttention utrzymuje zajętość GPU, dzieląc pracę po rozmiarze batcha i długości zapytania. Podczas decode model generuje dokładnie 1 token naraz (długość zapytania = 1). Jeśli rozmiar batcha pomnożony przez liczbę głowic attention jest znacznie mniejszy niż liczba SM w GPU (108 w A100), wiele SM może pozostawać bezczynnych, podczas gdy aktywne przetwarzają historię tokenów.
FlashDecoding rozwiązuje to, dodając nowy wymiar zrównoleglenia: samą długość sekwencji KV. Tnie KV cache na mniejsze fragmenty i rozdziela je między wszystkie bezczynne procesory GPU, by liczyć je równolegle, a następnie scala ich częściowe wyniki redukcją log-sum-exp.
W benchmarku Stanforda dla CodeLlama-34B przy batchu o rozmiarze jeden, na czterech GPU A100, z długościami sekwencji od 512 do 64K tokenów, FlashDecoding osiągnął do 8-krotnego przyspieszenia end-to-end względem testowanych punktów odniesienia i poprawił skalowanie attention w testowanych długich kontekstach. Wynik jest ograniczony do tego sprzętu i benchmarku, a nie jest ogólną gwarancją dla decode.
13. Continuous batching a static batching
Static batching czeka, aż skończą się wszystkie sekwencje w batchu, zanim zacznie następny, więc krótkie sekwencje marnują cykle GPU, bezczynnie czekając po osiągnięciu końca sekwencji. Continuous batching (wprowadzony w artykule o Orca, OSDI 2022) działa z ziarnistością pojedynczej iteracji: w każdym kroku decode zakończone sekwencje są usuwane, a nowe wstawiane. Rysunek pokazuje cztery sloty batcha w dziesięciu krokach decode przy każdej z polityk.
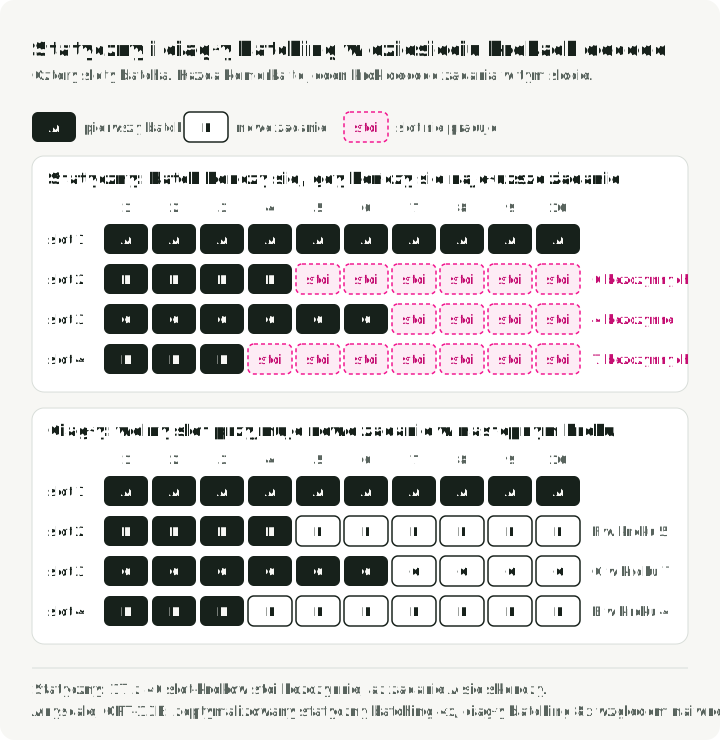
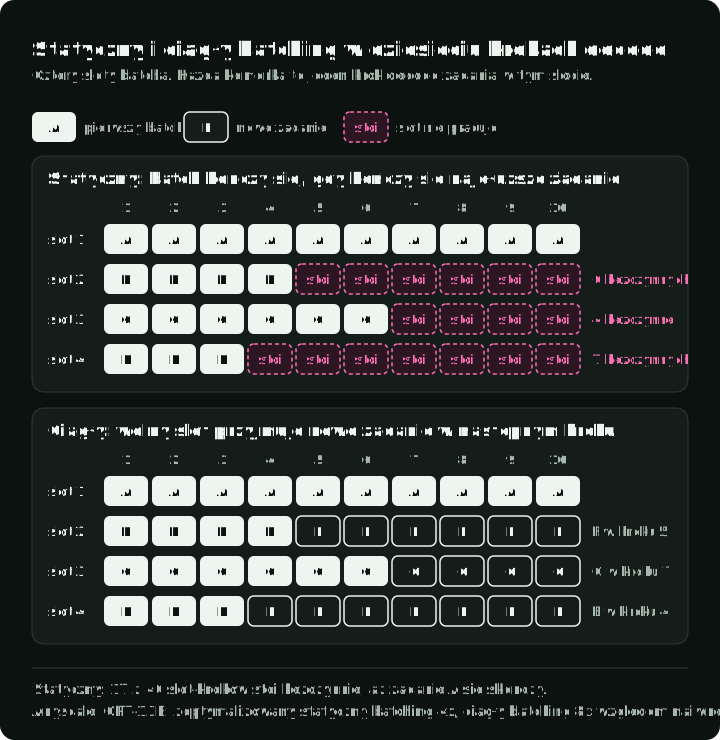
W benchmarku Anyscale z 2023 roku dla OPT-13B na A100-40GB, z 1000 żądaniami, promptami po 512 tokenów i odpowiedziami o średniej długości 128 tokenów, zoptymalizowany static batching osiągnął 4-krotność naiwnego punktu odniesienia, continuous batching 8-krotność, a vLLM z continuous batching i PagedAttention 23-krotność (Anyscale, 2023). Continuous batching zwiększa też presję na alokację KV, dlatego często łączy się go z zarządzaniem pamięcią stronicowaną.
14. PagedAttention: pamięć wirtualna dla KV cache
PagedAttention z vLLM stosuje do zarządzania KV cache ideę pamięci wirtualnej z systemów operacyjnych. KV cache dzieli się na bloki stałego rozmiaru (16 tokenów na tym rysunku; rozmiary bloków zależą od środowiska), bloki są przydzielane na żądanie w miarę generowania tokenów, a pozycje logiczne (sekwencyjne) są mapowane na fizyczne (rozproszone) miejsca w pamięci przez tablice bloków. Wiele żądań ze wspólnym prefiksem (prompty systemowe, beam search) może wskazywać te same bloki fizyczne. Ponowne użycie prefiksu wymaga też zgodnych kluczy cache i polityki wyszukiwania w cache. Rysunek pokazuje tablicę bloków dla dwóch żądań ze wspólnym promptem systemowym.
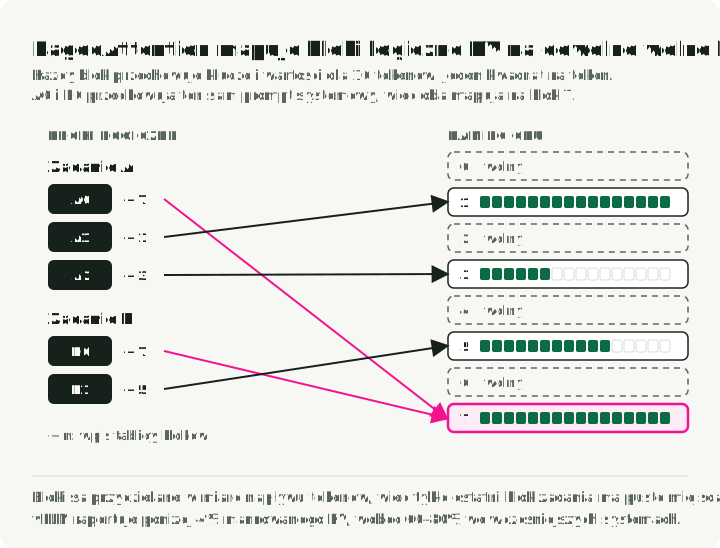
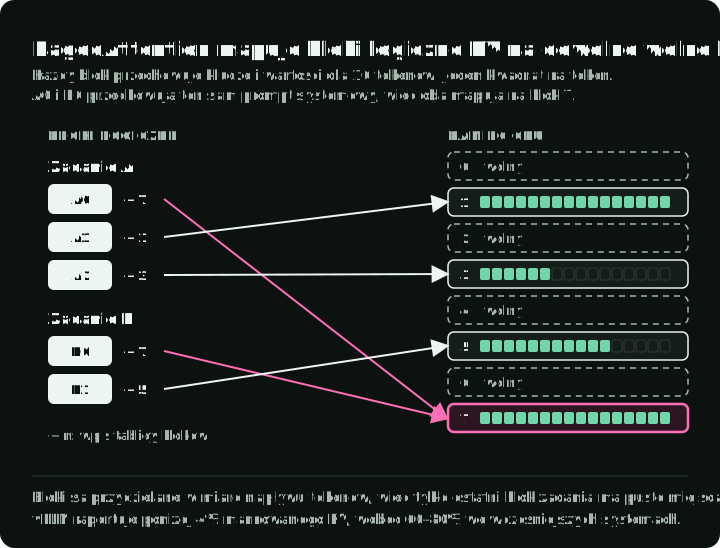
Ewaluacja vLLM z czerwca 2023 roku wykazała 60–80% strat pamięci KV w testowanych wcześniejszych systemach oraz poniżej 4% w swoim alokatorze stronicowanym. Raportowała 2–4 razy wyższą przepustowość niż TGI i do 24 razy wyższą niż Hugging Face Transformers w wybranych obciążeniach. To historyczne porównania end-to-end systemów serwujących, a nie uniwersalne przyspieszenie PagedAttention czy granica strat. Przy krótkich sekwencjach częściowo zapełniony ostatni blok może powodować większy udział strat.
15. Speculative decoding: wiele tokenów w jednym przebiegu forward
W speculative decoding mały model szkicowy (draft) generuje tokenów-kandydatów, a następnie duży model docelowy ocenia wszystkie pozycji w jednym przebiegu forward. Dekoder akceptuje tokeny szkicu od lewej do prawej z prawdopodobieństwami wyprowadzonymi z rozkładów modelu docelowego i szkicowego. Po pierwszym odrzuceniu próbkuje korektę z rozkładu rezydualnego modelu docelowego i odrzuca pozostałe tokeny szkicu. Ten zmodyfikowany krok próbkowania z odrzucaniem zachowuje rozkład wyjściowy modelu docelowego z dokładnością do numeryki sprzętu; samo dokładne dopasowanie tokenów tego nie zapewnia. Rysunek rozpisuje jedną rundę z czterema tokenami szkicu.
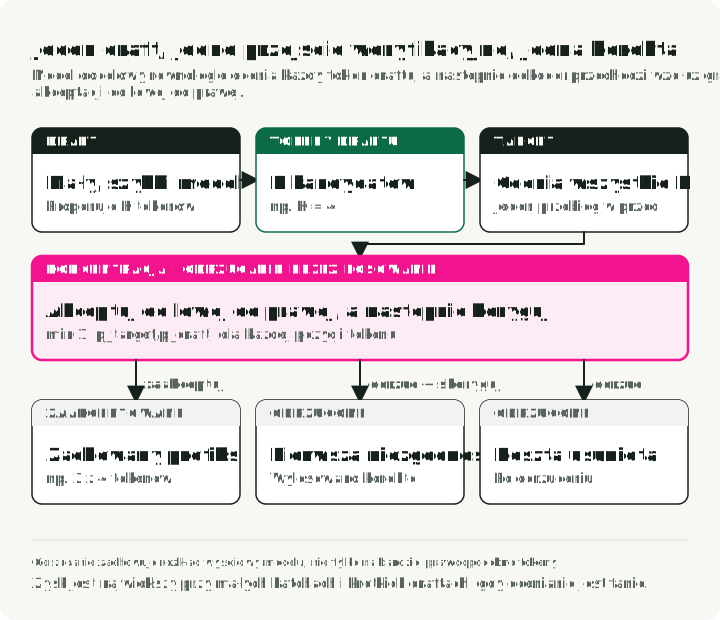
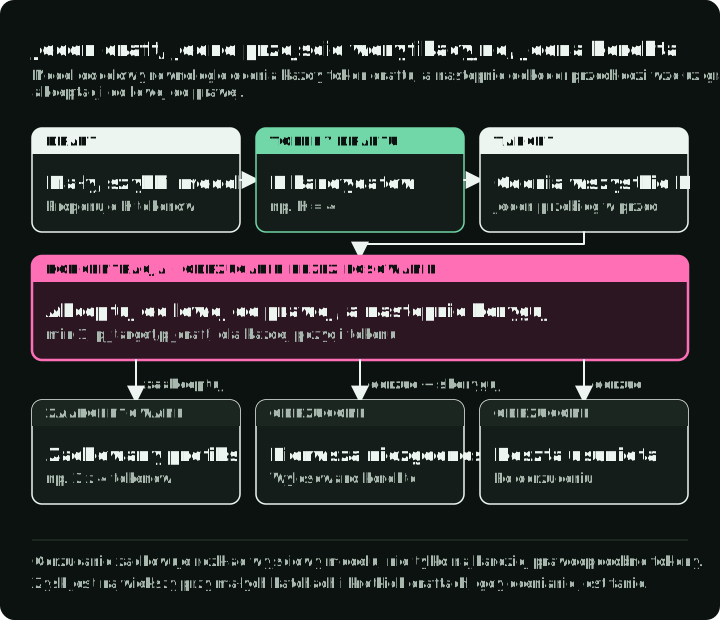
Zysk jest najbardziej prawdopodobny przy małych batchach serwowania i krótkich szkicach, gdy ocena szkicu jest zdominowana ruchem wag, KV cache lub komunikacji, a nie obliczeniami dodatkowego tokena. Oryginalny artykuł o speculative sampling raportował 2–2,5-krotne przyspieszenie dekodowania dla testowanej konfiguracji Chinchilla 70B; EAGLE-3 v3 raportował do 6,5 raza w swoich testach. Warianty to m.in. Medusa (dodatkowe głowice predykcji, bez osobnego modelu), prompt lookup decoding (dopasowywanie n-gramów do wejścia bez osobnego przebiegu forward modelu szkicowego) i EAGLE. Pierwotny EAGLE ekstrapoluje cechy; EAGLE-3 łączy kilka poziomów cech i bezpośrednio przewiduje tokeny.
Przy dużych batchach dodatkowa praca szkicowania i weryfikacji może zniwelować zysk. Speculative decoding jest najbardziej obiecujący, gdy batch serwowania jest dość mały, a akceptacja szkicu wysoka; benchmarkuj całą pętlę serwowania, a nie samą weryfikację w kernelu.
16. Prefix caching i ponowne użycie KV cache
Zamiast wyrzucać KV cache po zakończeniu żądania, prefix caching zachowuje go do ponownego użycia dla nowych żądań o tych samych tokenach prefiksu. Zmniejsza to zbędny prefill dla promptów systemowych, przykładów few-shot, kontekstu RAG i historii rozmów wieloturowych.
Automatic Prefix Caching w vLLM haszuje bloki KV i używa globalnej tablicy haszy do wyszukiwania. RadixAttention w SGLang utrzymuje drzewo radix zbuforowanych tensorów KV z ziarnistością na poziomie tokena. Oba rozwiązania wymagają prefiksów identycznych co do tokenów i zgodnych kluczy cache. Tożsamość modelu lub adaptera, wejścia multimodalne i ustawienia izolacji również mogą wpływać na ponowne użycie. Obok opóźnienia lub przepustowości raportuj współczynnik trafień.
17. Streaming w praktyce
Streaming wysyła tokeny do klienta w miarę ich generowania, zamiast czekać na całą odpowiedź. Wiele frameworków serwujących udostępnia go przez Server-Sent Events: klient otwiera długotrwałe połączenie HTTP, a serwer wypycha każdy token lub paczkę tokenów jako zdarzenie data:. TTFT określa, kiedy użytkownik po raz pierwszy widzi wynik; TPOT współdecyduje o tym, jak płynnie to wygląda. Cel ustal na podstawie testów produktu i wybranego modelu interakcji.
Po stronie klienta streaming wymusza decyzje o buforowaniu. Renderowanie token po tokenie może powodować drgania obrazu, zwłaszcza przy markdownie lub blokach kodu, które do poprawnego formatowania potrzebują kontekstu wielu tokenów. Typowe wzorce to buforowanie na poziomie słów (akumulacja tokenów do granicy białego znaku), buforowanie na poziomie linii (czekanie na znak nowej linii przed renderowaniem) i buforowanie adaptacyjne (natychmiastowe renderowanie prozy, buforowanie bloków kodu). W OpenAI Chat Completions API opcja stream_options: {"include_usage": true} dodaje końcowy fragment z użyciem tokenów przed komunikatem data: [DONE]. Przerwane strumienie OpenAI mogą nie zawierać końcowego fragmentu ze zużyciem. Serwery zgodne z OpenAI mogą się różnić, więc zweryfikuj wybraną implementację.
Chunked prefill to jeden ze sposobów, by długie prefille nie wstrzymywały dostarczania tokenów współbieżnym użytkownikom. Szeregowanie z priorytetem dla decode może chronić żądania w toku, a serwowanie zdezagregowane izoluje prefill i decode w osobnych pulach GPU.
Część IV — Architektura modelu
Architektura wyznacza zapotrzebowanie na pamięć, zachowanie attention i dynamikę treningu, wokół których pracują sekcje o serwowaniu i treningu.
18. Podstawy architektury transformera
Nowoczesny transformer decoder-only (GPT, Llama) to stos identycznych warstw, z których każda ma dwa podbloki: attention i feed-forward. Każdy podblok jest opleciony połączeniem rezydualnym i normalizacją. Rysunek pokazuje jedną warstwę w stylu Llama, w tym dwie ścieżki omijające podblok oraz podział wag projekcji między attention a sieć feed-forward; komponenty opisano pod nim.
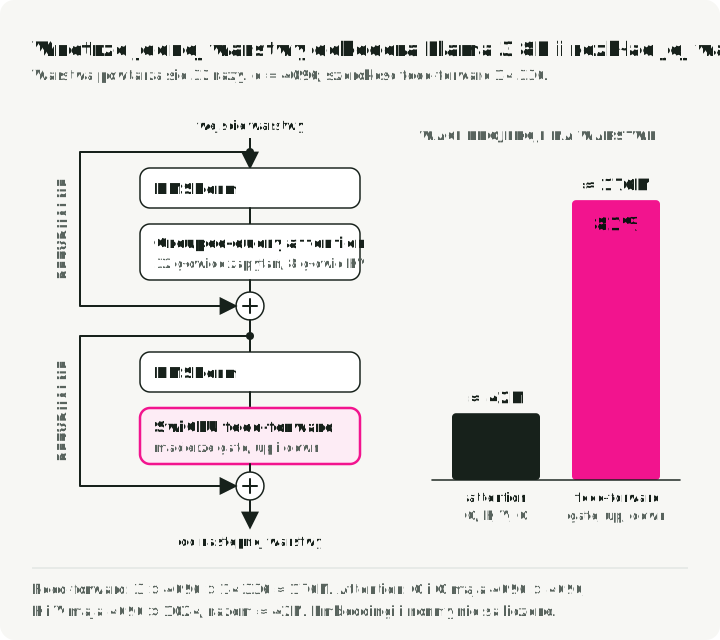
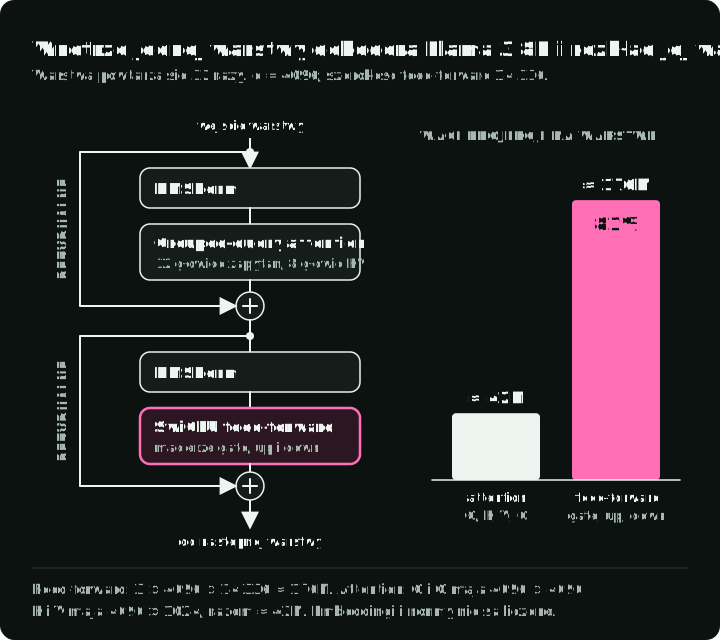
Kluczowe komponenty:
Multi-Head Attention pozwala każdemu tokenowi ważyć informacje z tokenów widocznych w masce attention. Wejście jest rzutowane na trzy macierze: Queries (czego szukam?), Keys (co zawieram?) i Values (jaką informację niosę?). Wyniki attention oblicza się następnie jako:
Iloczyn skalarny mierzy podobieństwo każdej pary tokenów. Dzielenie przez zapobiega zbytniemu wzrostowi iloczynów skalarnych (co wepchnęłoby softmax w obszary o zanikających gradientach). Softmax zamienia wyniki na prawdopodobieństwa, a mnożenie przez daje ważoną kombinację wektorów wartości. Równoległe wykonanie tego w wielu głowicach pozwala modelowi zwracać uwagę na różne zależności jednocześnie (głowice mogą uczyć się różnych zależności; ich role nie są ustalone).
Sieć feed-forward (FFN) przekształca reprezentację każdego tokena niezależnie, po tym jak attention wymieszało informacje między tokenami. Nowoczesne LLM często używają SwiGLU zamiast pierwotnej dwumacierzowej FFN z ReLU:
SwiGLU ma trzy macierze wag, wobec dwóch w FFN z ReLU, i używa gładkiej funkcji Swish. Korzystają z niego Llama, Mistral i Qwen; Gemma używa przybliżonego GeGLU. Znana reguła dwóch trzecich dotyczy konwencjonalnego bloku z pełnym MHA przy : jego dwie macierze FFN wnoszą około parametrów, wobec około dla attention. Nie jest to ogólne oszacowanie dla architektur SwiGLU/GQA. W Llama 3 8B , , a osiem głowic key/value sprawia, że FFN ma M parametrów na warstwę, wobec około 42M parametrów projekcji attention: około 81% tych wag projekcji, nie licząc embeddings i normalizacji.
Połączenia rezydualne dodają wyjście każdego podbloku z powrotem do jego wejścia: . Ścieżka pomijająca poprawia propagację sygnału i gradientu przez głębokie stosy.
RMSNorm jest powszechny w nowoczesnych rodzinach LLM. LayerNorm centruje przez odjęcie średniej i skaluje przez odchylenie standardowe. RMSNorm pomija odejmowanie średniej i tylko skaluje; jego artykuł raportuje 7–64% skrócenia czasu działania w testowanych modelach i frameworkach, bez obniżenia zmierzonej skuteczności na zadaniach. Umieszczenie pre-norm, czyli normalizacja przed attention lub FFN, jest również powszechne, ponieważ poprawia stabilność gradientów.
Szacowanie liczby parametrów konwencjonalnego dekodera z pełnym MHA, dwumacierzową FFN o szerokości oraz współdzielonymi wejściowymi i wyjściowymi embeddings:
gdzie to rozmiar słownika, to wymiar ukryty, a to liczba warstw. Składnik to macierz wejściowych embeddings; składnik przybliża wagi attention i FFN w każdej warstwie. Dla Llama 3 8B (, , ) oszacowanie wynosi około parametrów. Opublikowana łączna liczba 8,03B jest wyższa, ponieważ przybliżenie pomija szczegóły architektury, takie jak dokładna szerokość FFN i osobna projekcja wyjściowa.
19. Modele decoder-only do generowania ogólnego przeznaczenia
Oryginalny Transformer (2017) miał zarówno enkoder, jak i dekoder. Od tamtej pory dziedzina podzieliła się na trzy rodziny architektur, a jedna z nich stała się domyślną dla generatywnej AI.
| Rodzina | Attention | Cel treningu | Dziś używana do | Przykłady |
|---|---|---|---|---|
| Encoder-only | Dwukierunkowe | Przewidywanie zamaskowanych tokenów | Embeddings, rerankery, klasyfikatory | BERT, RoBERTa |
| Encoder-decoder | Dwukierunkowy enkoder; przyczynowy dekoder z cross-attention | Sekwencja na sekwencję (span corruption, T5) | Tłumaczenie, rozpoznawanie mowy | T5, BART, Whisper |
| Decoder-only | Przyczynowe | Przewidywanie następnego tokena | Generowanie tekstu ogólnego przeznaczenia, czat, kod | GPT, Llama |
Modele encoder-only używają dwukierunkowego attention: każdy token odwołuje się do każdego innego tokena w obu kierunkach. Daje to reprezentacje do zadań rozumienia. Standardowych modeli encoder-only zwykle nie używa się jako dekoderów autoregresyjnych; często stanowią architekturę bazową modeli embeddings, rerankerów i lekkich klasyfikatorów (na przykład routerów opartych na BERT w RouteLLM).
Modele encoder-decoder oddzielają rozumienie od generowania. Enkoder przetwarza całe wejście z dwukierunkowym attention, a dekoder generuje wyjście autoregresyjnie, odwołując się do reprezentacji enkodera przez cross-attention. Pasuje to do zadań, w których wejście i wyjście są różnymi sekwencjami, takich jak tłumaczenie i rozpoznawanie mowy.
Modele decoder-only, takie jak GPT, Llama i Mistral, używają przyczynowego attention: każdy token odwołuje się do siebie i poprzednich tokenów. Cztery użyteczne właściwości przy generowaniu to:
- Ponowne użycie KV cache. Przy przyczynowym attention wcześniejsze tokeny nigdy nie odwołują się do późniejszych, więc ich klucze i wartości pozostają ważne w miarę generowania nowych tokenów. Jeden cache na sekwencję rośnie przez dopisywanie (sekcja 6). Encoder-decoder przechowuje dodatkowo stan cross-attention nad wyjściem enkodera.
- Trening na surowym tekście. Przewidywanie następnego tokena nie wymaga sparowanego wejścia i wyjścia, więc dowolny korpus tekstu jest danymi treningowymi.
- Jeden powtarzany blok. Model to stos identycznych warstw dekodera, bez osobnego stosu enkodera ani ścieżki cross-attention do zbudowania, podzielenia i zoptymalizowania.
- Uczenie w kontekście. Instrukcje, przykłady few-shot i zapytanie są tokenami w jednym prefiksie, więc jeden model może przejąć nowe zadanie z samego promptu.
20. Mixture of experts
MoE zastępuje wybrane gęste FFN wieloma ekspertami FFN oraz lekkim routerem bramkującym. Router oblicza wynik dla każdego eksperta (zwykle softmax po wyuczonych projekcjach liniowych) i wybiera top- ekspertów na token. Obliczenia wykonują tylko aktywowani eksperci, więc model może mieć ogromną całkowitą pojemność przy niskim koszcie na token. To rzadkie obliczenia warunkowe. Aktywne parametry przybliżają koszt arytmetyki na token, ale wagi wszystkich ekspertów trzeba przechowywać. Na koszt działania wpływają też komunikacja, routing, zapełnienie batcha i pamięć KV. Rysunek śledzi jeden token w warstwie MoE z sześcioma ekspertami routowanymi i współdzielonym ekspertem.
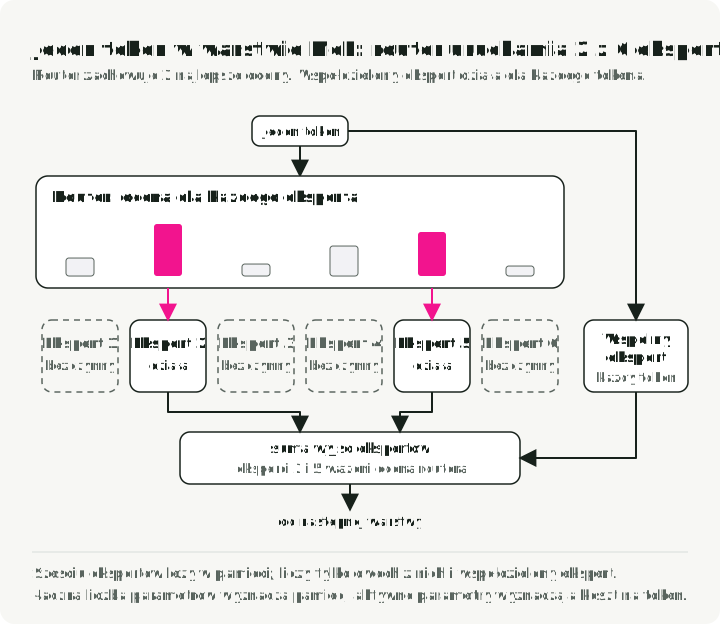
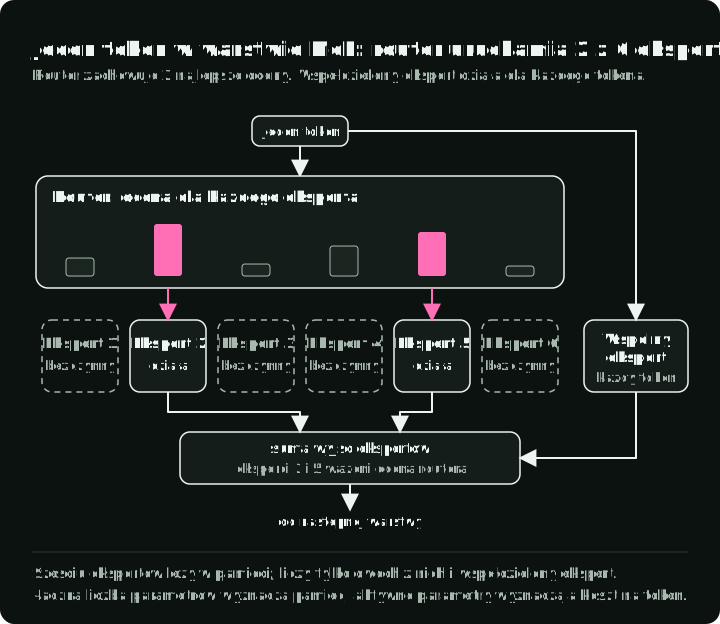
| Model | Parametry łącznie | Parametry aktywne | Eksperci (routowani + współdzieleni) | Top- |
|---|---|---|---|---|
| Mixtral 8x7B | 47B | ~13B | 8 + 0 | 2 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 | 8 |
Współdzielony ekspert w DeepSeek-V3 jest aktywowany dla każdego tokena. Dostarcza bazową reprezentację, na której mogą się specjalizować eksperci routowani.
Trening MoE ma trzy powtarzające się problemy: nierównomierne obciążenie, zapadanie się ekspertów (expert collapse) i narzut komunikacji dla expert parallelism. Tradycyjne modele MoE dodają pomocniczą stratę karzącą niezrównoważony routing, ale ta strata może konkurować z głównym celem. DeepSeek-V3 stosuje przede wszystkim strategię na poziomie batcha, bez pomocniczej straty: człony przesunięcia poza propagacją wsteczną obniżają wynik przeciążonych ekspertów i podnoszą wynik tych niedociążonych. Dodaje też niezwykle małą uzupełniającą stratę równoważenia na poziomie sekwencji, aby zapobiec skrajnej nierównowadze w obrębie sekwencji. Artykuł raportuje lepsze zrównoważenie routingu bez głównego kompromisu związanego ze stratą pomocniczą w jego konfiguracji.
21. Tokenizacja: BPE, SentencePiece i tiktoken
LLM nie widzą tekstu. Widzą sekwencje całkowitoliczbowych identyfikatorów tokenów. Tokenizer dzieli surowy tekst na tokeny (fragmenty podsłów) i mapuje każdy na identyfikator. Wybór tokenizera wpływa na jakość modelu, szybkość inferencji i sprawiedliwość wielojęzyczną.
Byte Pair Encoding (BPE) to popularny algorytm. Iteracyjnie scala najczęstsze sąsiadujące pary w korpusie treningowym. Uproszczony przykład:
- Zacznij od słownika na poziomie znaków:
[l, o, w, e, r, _] - Najczęstsza para to
(l, o)→ scal wlo→ słownik:[l, o, w, e, r, _, lo] - Następna najczęstsza para to
(lo, w)→ scal wlow→ słownik zyskujelow - Kontynuuj, aż słownik osiągnie docelowy rozmiar (np. 128K tokenów)
Częste słowa, takie jak „the”, stają się pojedynczymi tokenami, a rzadkie, takie jak „defenestration”, są dzielone na fragmenty podsłów, np. ["def", "en", "est", "ration"] w wymyślonym przykładzie. Rzeczywisty podział zależy od tokenizera i jego wersji. Kompromis dotyczy rozmiaru słownika względem długości sekwencji.
Trzy implementacje tokenizerów obejmują większość zastosowań produkcyjnych:
- SentencePiece trenuje bezpośrednio na surowym tekście Unicode, bez pretokenizera specyficznego dla języka. Zachowuje białe znaki za pomocą metasymbolu
▁i opcjonalnie może się cofnąć do tokenów bajtowych UTF-8. Obsługuje modele BPE i unigram i jest używany przez Llama 1/2, T5 i wczesne tokenizery Mistral. Nowsze tokenizery Mistral Tekken używają BPE w stylu tiktoken. - tiktoken to tokenizer OpenAI napisany w Rust, używający BPE na poziomie bajtów. W opublikowanym benchmarku GPT-2 działał 3–6 razy szybciej niż testowana konfiguracja
GPT2TokenizerFast. Llama 3 przeszła z SentencePiece na algorytm tiktoken. - Hugging Face Tokenizers to szeroko używana biblioteka napisana w Rust, obsługująca BPE, WordPiece i Unigram.
Rozmiar słownika bardzo się różni między rodzinami modeli:
| Model | Tokenizer | Rozmiar słownika |
|---|---|---|
| GPT-2 | Byte-level BPE | 50,257 |
| Llama 2 | SentencePiece BPE | 32,000 |
| Llama 3 | BPE w stylu tiktoken | 128,256 |
| GPT-4o | tiktoken o200k_base | ~200K |
W porównywalnej konfiguracji treningu tokenizera większy słownik może oznaczać mniej tokenów dla tego samego tekstu, ale większą macierz embeddings (składnik w sekcji 18).
Fertility mierzy, ile tokenów tokenizer tworzy na słowo lub inną wybraną jednostkę tekstu. Zależy od konkretnego tokenizera, języka, pisma, normalizacji, domeny i próbki. Mierz ją na reprezentatywnym ruchu, zamiast ekstrapolować z jednego tokenizera lub języka.
22. Okna kontekstu i kodowania pozycyjne
Okno kontekstu ogranicza sekwencję tokenów dostępną dla żądania generowania. Chunked prefill i decode z cache przetwarzają w jednym przebiegu tylko część tej sekwencji. API mogą też ustalać osobne limity wejścia i wyjścia. Publikowane limity obejmują:
| Model | Publikowany limit tokenów | Rok |
|---|---|---|
| Llama 1 | 2,048 | 2023 |
| Llama 3.1 | 128K | 2024 |
| GPT-4.1 | 1,047,576 | 2025 |
| Gemini 2.5 Pro | 1,048,576 wejście | 2025 |
GPT-4.1 ogranicza też wyjście do 32 768 tokenów, a Gemini 2.5 Pro do 65 536. Wiersz Gemini podaje limit wejścia, a GPT-4.1 okno kontekstu, więc te pola nie są identyczne.
Attention porównuje każdą parę widocznych tokenów, ale nic w tym porównaniu nie mówi, jak daleko od siebie leżą. Bez informacji o pozycji pełne self-attention nie rozróżnia różnych kolejności słów z tego samego zestawu tokenów; stany poszczególnych tokenów podążają za permutacją wejścia. Maska przyczynowa dekodera daje pewien sygnał kolejności, ponieważ każdy token widzi tylko swój prefiks, ale nie dostarcza jawnych pozycji względnych. Kodowania pozycyjne dodają pozycję i względną odległość jawnie.
Trzy popularne podejścia to:
-
RoPE (Rotary Position Embeddings) obraca wektory zapytań i kluczy o kąty zależne od pozycji, tak aby ich iloczyn skalarny zależał od pozycji względnej. O wyniku attention nadal decyduje treść tokena; RoPE dodaje informację o pozycji bez wyuczonych bezwzględnych embeddings pozycji. Używają go otwarte rodziny modeli, w tym Llama, Mistral i Qwen.
-
ALiBi (Attention with Linear Biases) pomija modyfikacje embeddings i dodaje karę bezpośrednio do wyników attention: im dalej od siebie leżą dwa tokeny, tym większe ujemne przesunięcie. Nie ma wyuczonych parametrów pozycyjnych. W oryginalnym artykule model 1,3B trenowany na sekwencjach 1024-tokenowych osiągał przy 2048 tokenach wyniki porównywalne z modelem z pozycjami sinusoidalnymi trenowanym na 2048. Zachowanie poza modelami i długościami testowanymi w artykule zależy od modelu.
-
YaRN (Yet another RoPE extensioN) rozszerza model RoPE poza jego kontekst treningowy. Grupuje wymiary częstotliwości w trzy kategorie i skaluje każdą inaczej. W porównaniu z interpolacją pozycji przy tej samej procedurze YaRN użył 400 zamiast 1000 kroków treningu (dodatek B.2). Szersze twierdzenie z abstraktu o dziesięciokrotnie mniejszej ilości danych dotyczy innego porównania.
Część V — Trening i alignment
Ta część rozróżnia cel, który tworzy zdolności, techniki pozwalające treningowi zmieścić się w dostępnym sprzęcie oraz metody kształtujące zachowanie modelu po treningu.
23. Pretraining, fine-tuning i alignment
Pretraining autoregresyjnego LLM używa samonadzorowanego przewidywania następnego tokena na dużym korpusie. Modele enkoderowe mogą używać innych celów, takich jak przewidywanie zamaskowanych tokenów. Jego zapotrzebowanie na obliczenia obejmuje wiele rzędów wielkości; Llama 3 405B zużyła na przykład FLOPs. Nadzorowany fine-tuning (SFT) dostosowuje wstępnie wytrenowany model do etykietowanych danych specyficznych dla zadania. RLHF / RLAIF wykorzystuje dane o preferencjach do kształtowania zachowania: konwencjonalny potok RLHF zbiera porównania, trenuje model nagrody, a następnie optymalizuje politykę. RLAIF zastępuje część ocen ludzkich informacją zwrotną wygenerowaną przez AI. Sekcja 31 opisuje destylację, czyli osobną ścieżkę, w której wyrównany model-nauczyciel generuje dane treningowe dla mniejszego modelu-ucznia.
Zapotrzebowanie na obliczenia zależy od rozmiaru modelu, długości sekwencji, ilości danych, optymalizatora i metody. PPO wymaga też więcej stanu modelu niż SFT, ponieważ typowa konfiguracja obejmuje modele polityki, referencyjny, nagrody i krytyka. Pełne ramy decyzyjne dotyczące fine-tuningu opisałem w Przewodniku po fine-tuningu LLM.
24. LoRA i QLoRA: fine-tuning efektywny parametrowo
LoRA zamraża wstępnie wytrenowane wagi i wstrzykuje trenowalne macierze niskiego rzędu () i (), tak że zaktualizowana waga to . Artykuł o LoRA zredukował GPT-3 175B do około 18 milionów trenowalnych parametrów w swojej konfiguracji. Rząd to parametr strojenia, a nie reguła złożoności zadania; dobieraj go przeglądem jakości i pamięci. Adaptery LoRA można po treningu scalić z wagami bazowymi, aby uniknąć osobnej ścieżki adaptera w inferencji.
QLoRA ładuje model bazowy w 4-bitowej kwantyzacji NF4, a adaptery LoRA trenuje w BF16. NormalFloat4 umieszcza więcej poziomów kwantyzacji blisko zera, gdzie gęstość wag jest największa. W artykule dostrojono model 65B na jednym GPU 48 GB i zaraportowano wyniki zbliżone do swoich 16-bitowych punktów odniesienia. Kompromisy czasu działania i pamięci są specyficzne dla testowanego stosu.
25. Trening mieszanej precyzji
Każdy format zmiennoprzecinkowy dzieli swoje bity na trzy pola: znak (zawsze 1 bit), wykładnik (wyznacza zakres dynamiczny) i mantysa (wyznacza precyzję). Więcej bitów wykładnika oznacza szerszy zakres reprezentowalnych wielkości; więcej bitów mantysy oznacza dokładniejsze rozróżnianie bliskich wartości. Formaty całkowitoliczbowe nie mają wykładnika w ogóle i reprezentują tylko równomiernie rozmieszczone liczby całkowite w stałym zakresie.
| Format | Bity | Układ (S / E / M) | Zakres | Precyzja | Typowe zastosowanie |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ~7 cyfr dziesiętnych | Wagi główne (master), stany optymalizatora (momentum i wariancja Adama) | |
| BF16 | 16 | 1 / 8 / 7 | ~2 cyfry dziesiętne | Preferowany format treningu; ten sam zakres co FP32 i zwykle bez skalowania straty | |
| FP16 | 16 | 1 / 5 / 10 | ~3 cyfry dziesiętne | Trening ze skalowaniem straty (starsze GPU); inferencja na sprzęcie sprzed Hopper | |
| FP8 E4M3 | 8 | 1 / 4 / 3 | ~1 cyfra dziesiętna | Przebieg forward na Hopper (H100) — większa precyzja dla wag i aktywacji | |
| FP8 E5M2 | 8 | 1 / 5 / 2 | ~0,6 cyfry dziesiętnej | Przebieg wsteczny na Hopper — szerszy zakres dla gradientów | |
| INT8 | 8 | liczba całkowita ze znakiem | do | Dokładne liczby całkowite | Kwantyzacja wag po treningu do inferencji (W8A8); kwantyzacja KV cache |
| INT4 | 4 | liczba całkowita ze znakiem | do | Dokładne liczby całkowite | Agresywna kwantyzacja samych wag (AWQ, GPTQ) do inferencji na sprzęcie z ograniczoną pamięcią |
BF16 ma ten sam zakres co FP32, ponieważ zakres wyznacza pole wykładnika, a BF16 zachowuje wszystkie 8 bitów wykładnika z FP32. Zamiast tego rezygnuje z bitów mantysy (7 wobec 23), wymieniając precyzję na 2-krotne zmniejszenie pamięci, a jednocześnie unikając wielu problemów z zakresem, które dotykają trening w FP16. FP16 ma tylko 5 bitów wykładnika, co ogranicza jego skończony zakres do około 65K. Wiele gradientów jest natomiast zbyt małych dla FP16 i zanika do zera. Skalowanie straty (loss scaling) mnoży stratę przed propagacją wsteczną, aby te gradienty pozostały reprezentowalne, a następnie przed krokiem optymalizatora je odskalowuje; skalowanie dynamiczne obniża współczynnik, gdy wystąpi przepełnienie. Szerszy zakres wykładnika BF16 zwykle pozwala uniknąć tego wymogu.
Formaty całkowitoliczbowe są rzadko używane w głównej arytmetyce treningu, ponieważ propagacja wsteczna wymaga szerokiego zakresu dynamicznego. Są szeroko stosowane w inferencji, gdzie zamrożone wagi można odwzorować na skalibrowane skale. Kwantyzacja wag do INT4 zmniejsza model 7B z około 14 GB do 3,5 GB, jeszcze przed narzutem środowiska uruchomieniowego; jakość trzeba zmierzyć dla wybranego modelu i metody.
Trening w FP8 na H100 przez Transformer Engine używa E4M3 tam, gdzie liczy się precyzja, i E5M2 tam, gdzie liczy się szerszy zakres. Artykuł FP8-LM raportuje, że jego framework mieszanej precyzji wytrenował GPT-175B o 75% szybciej niż bazowy Megatron-LM w BF16 i o 37% szybciej niż NVIDIA Transformer Engine w testowanej konfiguracji H100. DeepSeek-V3 użył mieszanej precyzji FP8 i zaraportował około $5.6 mln w ekwiwalencie kosztu wynajmu mocy obliczeniowej za końcowy przebieg treningowy, bez B+R i infrastruktury.
26. Gradient checkpointing
Każda warstwa przebiegu forward produkuje wyjście pośrednie zwane aktywacją:
Normalnie wszystkie aktywacje muszą pozostać w pamięci, ponieważ propagacja wsteczna potrzebuje ich do obliczenia gradientów. W głębokim transformerze przechowywane aktywacje mogą zająć więcej pamięci niż same wagi modelu.
Gradient checkpointing wymienia obliczenia na pamięć: odrzuca większość tych aktywacji i oblicza je ponownie w locie podczas propagacji wstecznej. Standardowa strategia (Chen et al., 2016) dzieli sieć o warstwach na równomiernie rozmieszczonych segmentów i zapisuje tylko aktywację graniczną każdego segmentu. Te zapisane granice to „checkpointy”. Wszystkie aktywacje pośrednie wewnątrz segmentu są natychmiast odrzucane.
Gdy przebieg wsteczny dociera do warstwy wewnątrz segmentu, jej aktywacje są obliczane ponownie od najbliższego checkpointu. W strategii z równomiernym segmentowaniem zapisana pamięć aktywacji spada z do . Każdy segment jest przeliczany raz, co kosztuje około jednego dodatkowego przebiegu forward na krok treningu (Chen et al., 2016). Rzeczywiste oszczędności pamięci i narzut ponownego obliczania zależą od modelu, granic checkpointów, długości sekwencji, frameworka i implementacji, więc mierz oba na docelowym przebiegu treningowym. FlashAttention stosuje tę samą zasadę wewnątrz attention, nie materializując pełnej macierzy attention. W zwykłych przebiegach Hugging Face Trainer włącz to przez gradient_checkpointing=True. Z FSDP używaj integracji activation checkpointing danego frameworka, jeśli jest obsługiwana; opcja ogólna może powodować zbędne all-gather w przebiegu wstecznym.
27. Etapy DeepSpeed ZeRO
W standardowym data parallelism każde GPU przechowuje pełną kopię wag modelu, gradientów i stanów optymalizatora. Dla Adama każdy parametr zajmuje 2 bajty na wagę FP16 + 4 bajty na wagę główną FP32 + 4 bajty na momentum + 4 bajty na wariancję + 2 bajty na gradient, czyli 16 bajtów na parametr. Model z 7,5 mld parametrów potrzebuje ~120 GB na GPU, a każde GPU przechowuje to samo. Na 64 GPU to 64 identyczne kopie po 120 GB.
DeepSpeed ZeRO (Zero Redundancy Optimizer) usuwa to powielenie, dzieląc te składniki między GPU zamiast je replikować:
- Etap 1 — podział stanów optymalizatora. Każde GPU przechowuje tylko 1/N stanów optymalizatora (wagi główne FP32 oraz pierwszy i drugi moment Adama, 12 bajtów/parametr). Gdy GPU musi zaktualizować wagę, aktualizuje tylko swój fragment i rozsyła wynik. Przy poniższych założeniach pamięć spada z ~120 GB do ~41,3 GB na GPU.
- Etap 2 — dodatkowo podział gradientów. Gradienty (2 bajty/parametr) nie są już sumowane operacją all-reduce na każde GPU. Każde GPU otrzymuje tylko potrzebny mu fragment gradientu przez reduce-scatter. Przy tych samych założeniach pamięć spada do ~28,1 GB na GPU.
- Etap 3 — dodatkowo podział wag modelu. Każde GPU przechowuje tylko 1/N wag FP16. Przed przebiegiem forward lub wstecznym każdej warstwy GPU wywołuje all-gather, by tymczasowo odtworzyć pełne wagi warstwy z pozostałych GPU, wykonuje obliczenia i odrzuca zebrane wagi. Przy tych samych założeniach pamięć spada do ~15,0 GB na GPU.
Rysunek przedstawia w skali stan modelu na GPU na każdym etapie, wraz z kosztem komunikacji każdego etapu.
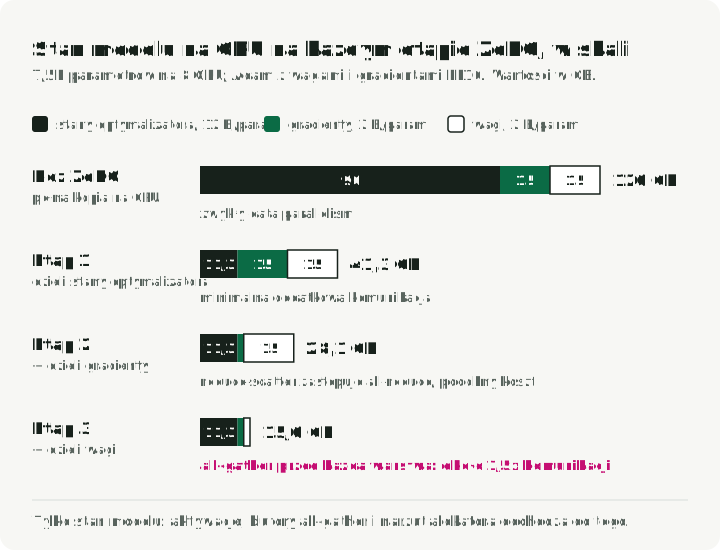
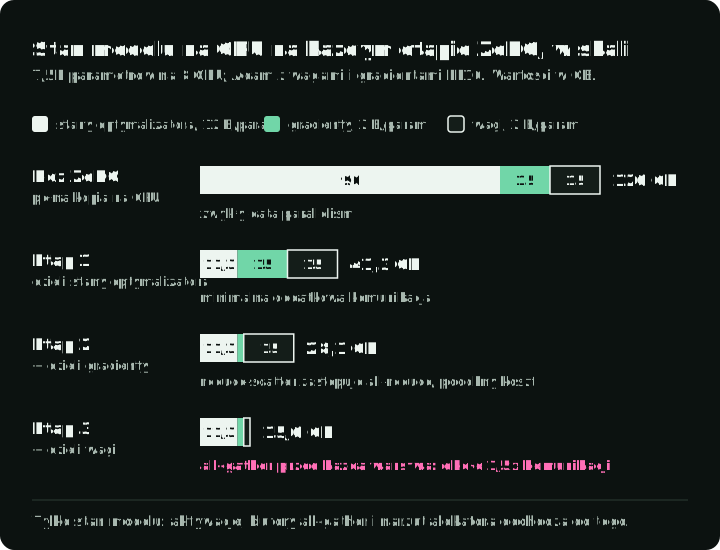
Są to przybliżone wartości stanu modelu dla modelu 7,5B parametrów na 8 GPU (rozmiar świata ), z wagami i gradientami FP16 oraz wagami głównymi, momentum i wariancją Adama w FP32. Nie obejmują aktywacji, tymczasowych buforów all-gather, fragmentacji alokatora ani narzutu frameworka i środowiska uruchomieniowego. Granicą obliczeń jest bajty na parametr, przy czym każdy stan jest dzielony przez tylko na etapach, które go dzielą.
Aby powtórzyć obliczenie dla innego rozmiaru modelu lub liczby GPU:
def zero_model_state_gb(params_b, n_gpus, stage):
    """Model-state GB per GPU for Adam with FP16 weights and gradients.

    Optimizer states (FP32 master weights, momentum, variance) take 12 bytes
    per parameter, gradients 2, and weights 2. Stage 1 shards the optimizer
    states, stage 2 also the gradients, and stage 3 also the weights.
    """
    optimizer, gradients, weights = 12, 2, 2
    if stage >= 1:
        optimizer /= n_gpus
    if stage >= 2:
        gradients /= n_gpus
    if stage >= 3:
        weights /= n_gpus
    return params_b * (optimizer + gradients + weights)

for stage in range(4):
    print(f"stage {stage}: {zero_model_state_gb(7.5, 8, stage):g} GB per GPU")

assert [zero_model_state_gb(7.5, 8, s) for s in range(4)] == [120.0, 41.25, 28.125, 15.0]
# 70B parameters: Stage 3 on 8 GPUs still needs 140 GB of model state per GPU;
# 16 GPUs bring it to 70 GB, before activations.
assert zero_model_state_gb(70, 8, 3) == 140.0
assert zero_model_state_gb(70, 16, 3) == 70.0
Kompromisem jest komunikacja. Etap 1 dodaje minimalny narzut, a etap 2 zastępuje all-reduce operacją reduce-scatter o podobnym koszcie. Etap 3 wymaga wywołań all-gather przed każdą warstwą zarówno w przebiegu forward, jak i wstecznym, co daje około 1,5 raza większą ilość przesyłanych danych niż standardowy data parallelism.
ZeRO-Infinity rozszerza etap 3, odciążając podzielone stany do pamięci RAM CPU, a nawet do dysków SSD NVMe, co może umożliwić trening modeli z bilionami parametrów na ograniczonych klastrach GPU. Odciążanie do pamięci masowej dodaje koszt PCIe i transferu z dysku; jego zmierzony wpływ zależy od dysku, topologii PCIe, podziału, prefetchingu, nakładania transferów i obciążenia. Używaj go, by spełnić wymagania pojemności, a nie zakładaj stałego spowolnienia, i profiluj docelową konfigurację.
28. FSDP: podział natywny dla PyTorch
Fully Sharded Data Parallel (FSDP) to wbudowana w PyTorch odpowiedź na DeepSpeed ZeRO-3. Dzieli parametry, gradienty i stany optymalizatora między GPU według tej samej podstawowej idei. Przy włączonym pełnym podziale i ponownym podziale operacje dla każdej jednostki objętej wrapperem są następujące:
- All-gather pełnych parametrów ze wszystkich GPU (tymczasowe odtworzenie kompletnej warstwy).
- Obliczenie przebiegu forward lub wstecznego dla tej warstwy.
- Zwolnienie zebranych parametrów natychmiast. Każde GPU zachowuje tylko swój fragment.
- Reduce-scatter gradientów, aby każde GPU otrzymało tylko przypisany mu fragment gradientu.
Ponieważ FSDP jest natywny dla PyTorch, integruje się bezpośrednio z narzędziami do debugowania, profilerami i torch.compile w PyTorch. Wydajność względem DeepSpeed ZeRO-3 zależy od polityki owijania, topologii komunikacji, ustawień odciążania i rozmiaru modelu, więc porównuj je na tym samym klastrze.
| Kryterium | FSDP (PyTorch) | DeepSpeed ZeRO |
|---|---|---|
| Styl kontroli | Pełny podział przez API PyTorch | Wybierane etapy ZeRO |
| Odciążanie | Odciążanie do CPU | CPU + NVMe przez ZeRO-Infinity |
| Integracja z frameworkiem | Natywny PyTorch, ścieżki torch.compile | Osobna biblioteka i system konfiguracji |
| Test wyboru | Profiluj docelowe obciążenie PyTorch | Profiluj wymagane funkcje i odciążanie |
FSDP2 (2024–2025) to przepisanie, które poprawia integrację z torch.compile dla lepszej fuzji kerneli, dodaje obsługę treningu FP8 przez TorchAO i upraszcza API. Zarówno FSDP, jak i DeepSpeed są dostępne przez Hugging Face Accelerate, który obsługuje oba przez konfigurację zgodnych, przygotowanych skryptów treningowych. Wymagane ustawienia wrapperów, checkpointingu i odciążania nadal się różnią.
29. Prawa skalowania i koszt inferencji
Skalowanie Chinchilla (DeepMind, 2022) wykazało przy swoich założeniach optymalną pod względem mocy obliczeniowej alokację na poziomie około 20 tokenów treningowych na parametr. Ten cel nie obejmuje kosztu późniejszego serwowania. Jeśli mniejszy model wytrenowany na większej ilości danych osiąga wymaganą jakość, może kosztować mniej w całym cyklu życia przy dużym wolumenie inferencji.
Jedna ze strategii kosztu w cyklu życia to trening mniejszego modelu na znacznie większej ilości danych:
| Model | Parametry | Tokeny treningowe | Tokeny/parametr | Tokeny/parametr ÷ 20 (wyliczone) |
|---|---|---|---|---|
| Chinchilla | 70B | 1.4T | 20:1 | 1× |
| Llama 1 | 65B | 1.4T | 22:1 | 1× |
| Llama 2 | 70B | 2.0T | 29:1 | 1.4× |
| Llama 3 8B | 8B | 15T | 1,875:1 | 94× |
| Qwen3-0.6B | 0.6B | 36T | 60,000:1 | 3,000× |
To wyświetlony stosunek tokenów do parametrów podzielony przez przybliżony punkt 20 tokenów na parametr z artykułu o Chinchilli. Jest to stosunek opisowy, a nie zmierzony mnożnik jakości lub kosztu.
Dla modelu serwowanego przy dużym wolumenie wydanie większej mocy obliczeniowej na trening mniejszego modelu może obniżyć koszt w cyklu życia. Llama 3 8B ilustruje tę strategię, ale to, czy się opłaca, zależy od wymaganej jakości i prognozowanego wolumenu inferencji. „Chinchilla-optymalny” odnosi się do efektywności mocy obliczeniowej treningu, czyli innego celu niż koszt w cyklu życia.
30. RLHF, DPO, GRPO i krajobraz metod alignmentu
Alignment kieruje wstępnie wytrenowany model ku pożądanym instrukcjom, preferencjom i politykom bezpieczeństwa. Sam z siebie nie gwarantuje prawdomówności ani bezpiecznego zachowania. Poniższe metody wymieniają ze sobą złożoność implementacji, wymagania dotyczące danych, eksplorację i stabilność treningu.
Klasyczny potok RLHF: SFT → zebranie ludzkich par preferencji → trening modelu nagrody na tych parach → fine-tuning polityki za pomocą PPO (Proximal Policy Optimization). Konwencjonalna konfiguracja PPO ma cztery role modeli: politykę, model referencyjny, krytyka/model wartości oraz model nagrody. Ich zużycie pamięci zależy od współdzielenia, podziału, precyzji, odciążania i rozmieszczenia; cztery role nie oznaczają czterech pełnych kopii w pamięci GPU. PPO jest też wrażliwe na hiperparametry. Jest też podatne na reward hacking, gdy model wykorzystuje dziwactwa modelu nagrody, takie jak rozwlekłe, pewnie brzmiące odpowiedzi, zamiast rzeczywiście poprawiać jakość.
DPO (Direct Preference Optimization) pomija wyuczony model nagrody i pętlę RL online, optymalizując bezpośrednio stratę na parach preferencji. To upraszcza potok treningowy. Standardowe DPO jest offline: trenuje na stałym zbiorze danych i nie eksploruje nowych odpowiedzi w pętli aktualizacji. To, czy to ograniczenie ma znaczenie, zależy od zadania i pokrycia danych.
GRPO (Group Relative Policy Optimization, DeepSeek) usuwa wyuczonego krytyka z PPO, generując wiele uzupełnień na prompt i używając nagród względem grupy jako punktu odniesienia. Zmniejsza to obciążenie stanem modelu w porównaniu z typową konfiguracją PPO. W przeciwieństwie do DPO, GRPO jest on-policy: model generuje świeże odpowiedzi w trakcie treningu. DeepSeek-R1 łączy GRPO z RLVR (uczenie ze wzmocnieniem z weryfikowalnych nagród), używając kontroli takich jak odpowiedzi matematyczne, kompilacja kodu i testy jednostkowe. Te nagrody łatwiej poddać audytowi niż wyuczony wynik preferencji, ale niepełne testy i cele zastępcze nadal można wykorzystać.
| Metoda | Role modeli w konwencjonalnej konfiguracji | Sygnał nagrody | Online/offline | Kluczowe ograniczenie |
|---|---|---|---|---|
| PPO | Polityka, model referencyjny, krytyk, model nagrody | Wyuczony model nagrody | Online | Reward hacking, złożone strojenie |
| DPO | Polityka i oceny referencyjne, które można obliczyć wcześniej | Niejawny (pary preferencji) | Offline | Brak eksploracji, stałe dane |
| GRPO | Polityka; opcjonalny model referencyjny do KL i opcjonalny wyuczony model nagrody | Jawny (reguła/weryfikator lub wyuczony) | Online | Zależy od jakości nagrody i informatywnej zmienności wewnątrz grupy |
Polityka referencyjna w GRPO zależy od implementacji. Na przykład TRL GRPOTrainer nie ładuje modelu referencyjnego, gdy współczynnik KL beta wynosi zero. Porównując pamięć treningu, uwzględnij rozmieszczenie modeli i precyzję.
31. Destylacja: kompresja wiedzy między modelami
Destylacja wiedzy przenosi zdolności z dużego nauczyciela na mniejszego ucznia. Destylacja oparta na logitach trenuje ucznia tak, by dopasował rozkład wyjściowy nauczyciela. Destylacja oparta na danych polega na tym, że nauczyciel generuje przykłady, na których uczeń jest dostrajany. Metody oparte na danych są popularne w LLM, ponieważ działają między architekturami i z nauczycielami dostępnymi tylko przez API, ale ich wartość jest ograniczona jakością nauczyciela, pokryciem danych, filtrowaniem i kosztem generowania.
DeepSeek-R1 wyselekcjonował mieszankę około 800 000 przykładów — około 600 000 próbek związanych z rozumowaniem i 200 000 bez rozumowania — i użył jej do destylacji modeli Qwen2.5 i Llama 3 od 1,5B do 70B parametrów. W ewaluacji z artykułu:
- DeepSeek-R1-Distill-Qwen-32B uzyskuje 72,6% na AIME 2024 i 94,3% na MATH-500, powyżej zaraportowanych w artykule wyników OpenAI o1-mini.
- DeepSeek-R1-Distill-Qwen-7B uzyskuje 55,5% na AIME 2024, powyżej wyniku QwQ-32B-Preview zaraportowanego w artykule, przy mniejszym modelu.
W eksperymentach DeepSeek-R1 z małymi modelami destylacja przewyższyła bezpośrednie GRPO na testowanych modelach bazowych. Wynik ten wspiera destylację w tej konfiguracji; nie ustanawia uniwersalnego rankingu między destylacją a RL.
32. Generowanie danych syntetycznych
Dane treningowe generowane przez LLM są używane w kilku powtarzających się wzorcach:
- Self-Instruct startuje od małego zbioru zalążkowego instrukcji napisanych przez ludzi: LLM generuje nowe instrukcje, wejścia i wyjścia, które są filtrowane i dodawane z powrotem do puli. Projekt Alpaca użył 52 000 przykładów wygenerowanych ze 175 zalążków. Stanford zaraportował koszt generowania danych poniżej $500 i fine-tuningu poniżej $100, co daje początkowy koszt odtworzenia poniżej $600; porównanie z GPT-3.5 było ograniczoną oceną projektu, a nie szeroką równoważnością.
- Evol-Instruct (WizardLM) bierze istniejące instrukcje i iteracyjnie rozwija je wzdłuż osi złożoności (dodawanie ograniczeń, pogłębianie rozumowania, konkretyzowanie problemów), aby tworzyć coraz trudniejsze przykłady treningowe.
- Phi-4 Microsoftu (14B) użył danych syntetycznych w dużej części pretrainingu, w tym generowania, krytyki, samodzielnej rewizji i odwracania instrukcji. Jego raport techniczny porównuje uzyskane wyniki w STEM i kodowaniu z większymi modelami na wybranych benchmarkach.
Jednym z zagrożeń jest zapadanie się modelu (model collapse) przy rekurencyjnym zastępowaniu rzeczywistych danych danymi generowanymi. W badanych konfiguracjach rzadkie części pierwotnego rozkładu stopniowo znikają (Shumailov et al., publikacja w Nature w 2024 roku). Nie jest to nieunikniony wynik każdego użycia danych syntetycznych. Odrębne badanie akumulacji wykazało inne zachowanie, gdy dane rzeczywiste i generowane zachowywano między generacjami. Odrębne badanie klasyfikatora Ahrefs pobrało w kwietniu 2025 jedną nowo wykrytą angielską stronę na domenę z 900 000 stron i zaklasyfikowało 74,2% jako zawierające jakiś tekst wygenerowany przez AI. To badanie dostawcy nie jest spisem całego internetu. Łagodzenie zaczyna się od mieszania danych syntetycznych z rzeczywistymi, filtrowania i śledzenia pochodzenia, tak aby rekurencyjnie wygenerowany materiał dało się zmierzyć.
Część VI — Skalowanie i wdrażanie
Gdy obciążenie przestaje mieścić się na jednym urządzeniu lub spełniać na nim swoje SLO, pozostają trzy wybory: jak podzielić pracę, które środowisko udostępnia potrzebne mechanizmy kontroli i czy każde żądanie wymaga tego samego modelu.
33. Cztery formy parallelism
Cztery formy różnią się tym, jaką część modelu przechowuje każde GPU, i tym, co przechodzi przez łącze między GPU. Rysunek pokazuje każdą z nich na dwóch GPU.
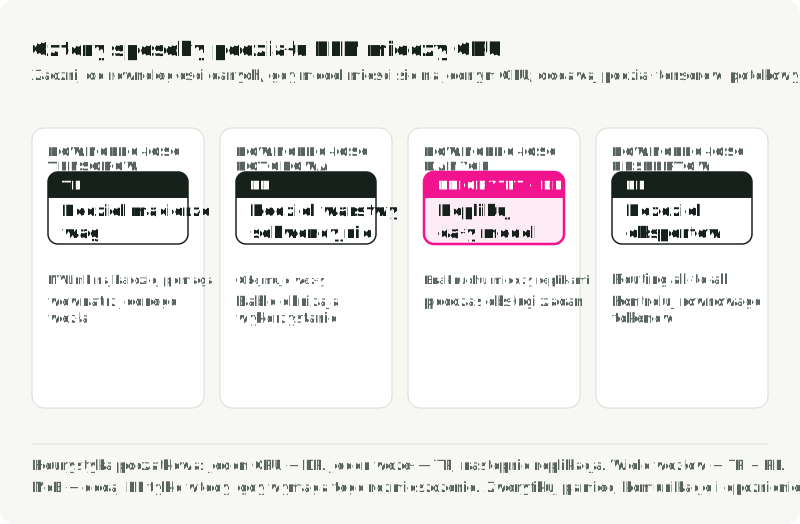
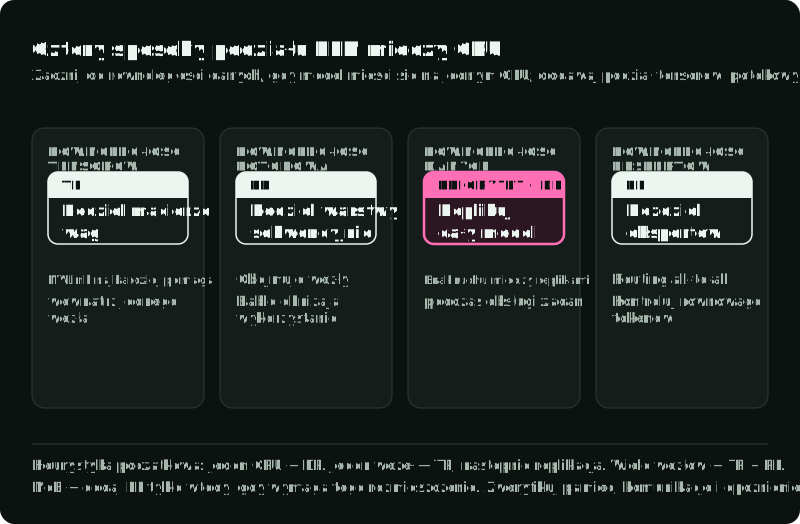
Tensor Parallelism (TP) dzieli poszczególne macierze wag między GPU i zwykle komunikuje się po każdej warstwie. Szybkie łącza wewnątrzwęzłowe, takie jak NVLink, czynią go najbardziej praktycznym w obrębie węzła. Więcej fragmentów zmniejsza pamięć i obliczenia na urządzenie, ale zwiększa komunikację, więc stopień podziału dobierz benchmarkiem opóźnienia.
Pipeline Parallelism (PP) dzieli warstwy sekwencyjnie między GPU, przekazując aktywacje między etapami. Jego wzorzec komunikacji może działać między węzłami, ale bąble w potoku i nierówne czasy etapów obniżają wykorzystanie. Duże wdrożenia często łączą TP w obrębie węzła z PP między węzłami.
Data Parallelism (DP) replikuje serwowany model, tak że każda replika obsługuje niezależne żądania bez komunikacji między replikami na żądanie. Jest wydajny, gdy model się mieści, a ruch można zrównoważyć. W treningu DP często łączy się z ZeRO lub FSDP, aby podzielić stan.
Expert Parallelism (EP) rozdziela ekspertów MoE między GPU, używając komunikacji all-to-all do routingu tokenów. Jego wydajność zależy od równowagi tokenów, rozmieszczenia ekspertów i topologii połączeń; ruch all-to-all może stać się dominującym wąskim gardłem.
Punkt wyjścia przy doborze parallelism:
- Model mieści się na jednym GPU: zacznij od niezależnych replik i zmierz skalowanie DP.
- Model mieści się w jednym węźle: przetestuj TP w obrębie węzła, a potem powiel grupę, jeśli ruch tego wymaga.
- Model obejmuje wiele węzłów: przetestuj kombinację TP i PP względem połączeń i celu opóźnienia.
- Mixture of experts: dodaj EP tylko wtedy, gdy rozmieszczenie ekspertów tego wymaga.
34. Porównanie frameworków serwujących
Środowisko uruchomieniowe decyduje, które z optymalizacji z części III dostajesz bez pisania kerneli. Użyj tabeli, aby wybrać pierwsze do benchmarku, a potem porównaj je z jedną alternatywą na tych samych promptach, długościach odpowiedzi, sprzęcie i SLO.
| Środowisko | Użyj, gdy | Sprawdź najpierw |
|---|---|---|
| vLLM | Ogólne serwowanie na GPU z API zgodnym z OpenAI | Docelowy model i GPU w aktualnej macierzy zgodności |
| SGLang | Ruch współdzieli długie prefiksy (prompty systemowe, czat wieloturowy, agenci) lub wymaga ustrukturyzowanych danych wyjściowych | Współczynnik trafień cache prefiksów na własnym ruchu |
| TensorRT-LLM | Flota jest wyłącznie NVIDIA, a najniższe opóźnienie ważniejsze od przenośności | Obsługa Twojego modelu i precyzji (FP8, FP4) |
| llama.cpp | CPU, Apple silicon lub pojedyncze GPU konsumenckie, z modelami skwantyzowanymi w GGUF | Tokeny na sekundę z jego narzędzia do benchmarków na docelowej maszynie |
| Ollama | Lokalny development i demonstracje | Przejdź na środowisko serwujące przed dużą współbieżnością lub pracą nad SLO |
Te same punkty wyjścia do benchmarku jako uporządkowana lista:
- Jedna maszyna lokalna lub jedno GPU konsumenckie: zacznij od llama.cpp, a do developmentu od Ollama.
- Wyłącznie NVIDIA i priorytetem jest opóźnienie: uwzględnij TensorRT-LLM w benchmarku.
- Długie wspólne prefiksy lub ustrukturyzowane dane wyjściowe: SGLang.
- W pozostałych przypadkach: vLLM.
Przetestuj pierwszy wybór na własnych promptach, długościach wyjścia, sprzęcie i SLO.
vLLM zapewnia stronicowaną alokację KV, continuous batching, API zgodne z OpenAI i kilka trybów parallelism. Jego obsługa modeli i sprzętu często się zmienia.
SGLang łączy RadixAttention do ponownego użycia prefiksów, własny scheduler i generowanie strukturalne. Jego publikowane zyski przepustowości zależą od obciążenia i konfiguracji.
TensorRT-LLM dąży do niskiego opóźnienia pojedynczych żądań dzięki przechwytywaniu i odtwarzaniu grafów CUDA, które zmniejszają narzut uruchamiania, oraz optymalizacji kerneli, w tym fuzji, z natywną obsługą FP8/FP4. Wcześniejsze wersje, takie jak v1.2.0, pozwalały z wyprzedzeniem zbudować silnik TensorRT. Aktualny przewodnik migracji NVIDIA wskazuje PyTorch jako jedyny backend: API LLM i trtllm-serve bezpośrednio wczytują checkpoint Hugging Face, bez budowania silnika. Opublikowane wyniki dotyczą konkretnych modeli i sprzętu, a TensorRT-LLM działa wyłącznie na GPU NVIDIA.
TGI został zarchiwizowany 21 marca 2026 roku, a jego repozytorium jest tylko do odczytu. Jego README zaleca vLLM, SGLang, llama.cpp lub MLX dla nowych wdrożeń.
Ollama stawia na prosty lokalny przepływ pracy z modelami.
llama.cpp to przenośne środowisko C/C++ ze ścieżkami ARM, x86, Metal, CUDA, ROCm i Vulkan. GGUF obsługuje kilka poziomów kwantyzacji. Wydajność mocno zależy od modelu, kwantyzacji, kontekstu i backendu.
35. Wybór GPU do inferencji
Tabela porównuje publikowane charakterystyki sprzętu. Obsługa precyzji deklarowana przez producenta nie sprawia, że szczytowe wartości obliczeniowe są bezpośrednio porównywalne między formatami, więc wybieraj najpierw według dopasowania pamięci i benchmarkuj docelowe obciążenie. Aktualne ceny chmurowe sprawdzaj osobno, ponieważ zależą od dostawcy, regionu, zobowiązania i dostępności.
| GPU | Pamięć | Przepustowość | Natywna niska precyzja | NVLink na GPU |
|---|---|---|---|---|
| B200 SXM | 180 GB HBM3e | Do 8 TB/s | FP4, FP8 | 1,8 TB/s |
| H200 SXM | 141 GB HBM3e | 4,8 TB/s | FP8 | 900 GB/s |
| H100 SXM | 80 GB HBM3 | 3,35 TB/s | FP8 | 900 GB/s |
| A100 80 GB SXM | 80 GB HBM2e | 2,039 TB/s | INT8 (bez FP8) | 600 GB/s |
| L40S | 48 GB GDDR6 | 864 GB/s | FP8 | Brak |
| A10G (AWS G5) | 24 GB GDDR6 | 600 GB/s | INT8 (bez FP8) | Brak |
| RTX 4090 | 24 GB GDDR6X | ~1 TB/s | FP8 | Brak |
Wiersz A10G używa specyfikacji NVIDIA A10 jako przybliżenia przepustowości; podlinkowana specyfikacja AWS G5 nie ustala dokładnej przepustowości A10G. Wartość dla RTX 4090 (1008 GB/s) pochodzi z białej księgi architektury Ada.
Pojemność 141 GB w H200 może uprościć niektóre wdrożenia dużych modeli. Karty GDDR w dolnych wierszach mają jedną trzecią przepustowości H100 lub mniej i nie mają NVLink, więc lepiej nadają się do modeli skwantyzowanych, które mieszczą się na jednym GPU, niż do modeli wymagających tensor parallelism.
AWQ i GPTQ serwują modele 4-bitowe, dekwantyzując obsługiwane operacje macierzowe do formatu obliczeniowego, takiego jak FP16 lub BF16. Zgodność i szybkość nadal zależą od architektury modelu, formatu kwantyzacji, backendu serwującego, kernela i GPU, więc sprawdź macierz wsparcia backendu i zbenchmarkuj dokładnie ten artefakt. Wszystkie wymienione GPU obsługują operacje macierzowe INT8.
Decode LLM jest często ograniczony przepustowością pamięci, więc pojemność i przepustowość HBM mogą mieć w obciążeniach serwujących większe znaczenie niż szczytowe TFLOPS. Porównuj GPU przy stałym modelu, precyzji, rozkładzie batcha, długości kontekstu i celu opóźnienia.
36. Kaskadowanie modeli i routing
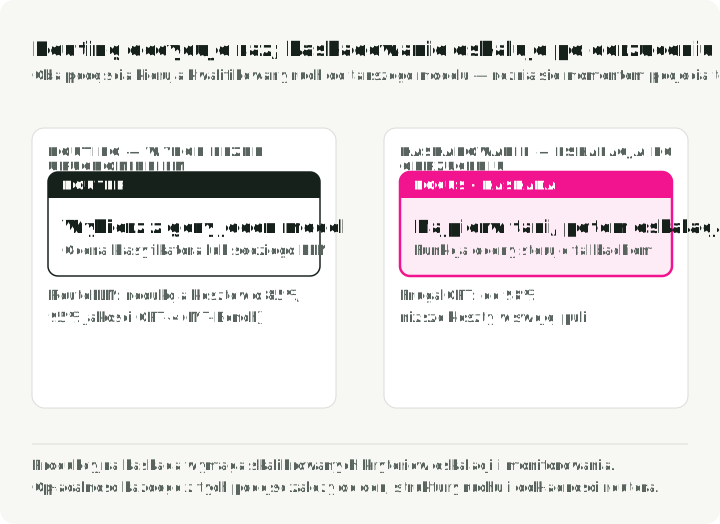
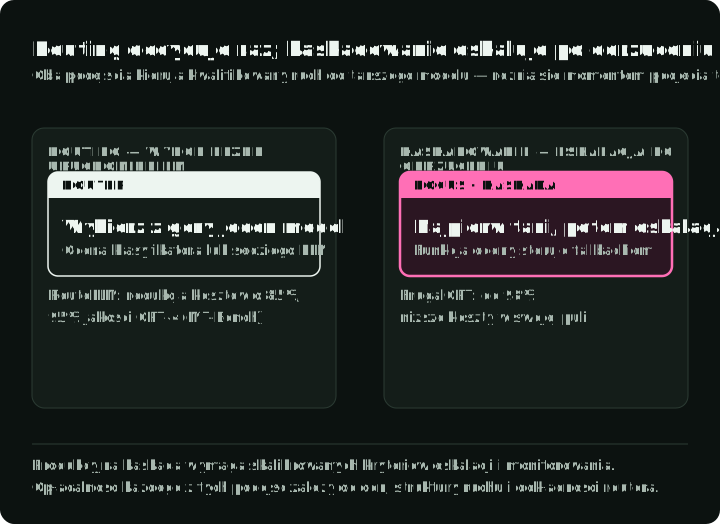
Routing modeli wybiera, który LLM obsłuży każde zapytanie, na podstawie przewidywanej złożoności lub zdolności. RouteLLM (LMSYS/UC Berkeley, ICLR 2025) raportuje stosunek kosztów 3,66x przy 95% bazowego wyniku GPT-4-Turbo na MT-Bench w tabeli 6. Odpowiada to około 73% niższemu modelowanemu kosztowi przy cenach, słabszym modelu i sposobie oceniania z tego eksperymentu. To, czy routing się opłaca, zależy od aktualnych cen, mieszanki ruchu, błędów routera i minimalnej akceptowalnej jakości.
Routery obejmują od lekkich klasyfikatorów po sędziów opartych na LLM. Kaskadowanie to wariant sekwencyjny: zapytanie zaczyna od tańszego modelu i przechodzi wyżej, gdy funkcja oceniająca odrzuci odpowiedź. FrugalGPT raportuje do 98% niższego kosztu lub do 4% wyższej dokładności w ocenianej puli modeli. Kaskada produkcyjna wymaga skalibrowanych kryteriów eskalacji i monitorowania zapytań, które tani model błędnie akceptuje. Rysunek pokazuje, gdzie każde z podejść dokonuje wyboru i gdzie każde z nich zawodzi.
Część VII — Aplikacje
Aplikacje zawodzą w miejscach, których stos serwujący nie widzi. Wyszukiwanie może zawieść, zanim zacznie się generowanie, agenci mogą wybrać niepoprawną akcję, a zmiana promptu może poprawić jedno zadanie i zepsuć inne.
37. Modele embeddings a modele generatywne
Modele embeddings kodują tekst w wektory o stałej liczbie wymiarów, które oddają znaczenie semantyczne. Porównywane poniżej modele jednowektorowe zwracają jeden gęsty wektor dla wejścia, zwykle o liczbie wymiarów od kilkuset do kilku tysięcy. Inne architektury wyszukiwania mogą zachowywać kilka wektorów na poziomie tokenów; poniższe porównanie przechowywania dotyczy jednowektorowych embeddings. Ich rdzeniem są dwukierunkowe transformery encoder-only oraz modele wywodzące się z dekoderów, dostosowane do uczenia reprezentacji. Warstwa poolingu często sprowadza reprezentacje poszczególnych tokenów do jednego wektora przez uśrednianie, specjalny token klasyfikacyjny lub metodę ostatniego tokena zależną od modelu. Kontrastowy fine-tuning przybliża następnie teksty podobne semantycznie i oddala niepodobne.
Obecne modele embeddings różnią się właściwościami, które wyznaczają koszt przechowywania i wybór indeksu: liczbą wymiarów wyjściowych, akceptowanymi typami wejścia, sposobem wdrożenia i precyzją wyjścia.
| Model | Maks. wymiarów | Wejście | Wagi | Natywna precyzja wyjścia |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 4,096 (32–4,096 przez MRL) | Tekst | Otwarte (Apache 2.0) | Float |
| Gemini Embedding 2 | 3,072 (128–3,072) | Tekst, obraz, wideo, audio, PDF | API | Nie podano |
| pplx-embed-v1-4B | 2,560 (MRL) | Tekst | Otwarte (MIT) | INT8 i binarna |
| OpenAI text-embedding-3-large | 3,072 (skracane przez dimensions) | Tekst | API | Float |
To przykłady, a nie ranking. Oceń język, modalność, zadanie, liczbę wymiarów i koszt serwowania na jednym zbiorze wyszukiwania.
Matryoshka Representation Learning (MRL, Kusupati et al., NeurIPS 2022) czyni wymiary embeddings elastycznymi. Nazwana od rosyjskich lalek matrioszek, MRL trenuje wybrane prefiksy embeddings tak, aby zachowywały użyteczne informacje. Eksperymenty porównują je z osobno trenowanymi mniejszymi reprezentacjami; dorównanie ich jakości jest wynikiem empirycznym, a nie gwarancją dla każdego zadania. Podczas treningu MRL agreguje straty po wybranym zbiorze wymiarów prefiksowych, zwykle kolejnych połowieniach; przykład 2048-wymiarowy z artykułu używa . Zagregowana strata skłania początkowe wymiary do niesienia zgrubnej informacji semantycznej, a późniejsze dodają drobniejsze szczegóły.
Po treningu embedding MRL można obciąć do obsługiwanego wymiaru prefiksowego. OpenAI raportuje, że text-embedding-3-large przy 256 wymiarach przewyższa text-embedding-ada-002 przy 1536 wymiarach w cytowanym porównaniu MTEB. Daje to 6-krotne zmniejszenie surowego miejsca na wektory; opóźnienie wyszukiwania i koszt bazy danych zależą też od indeksu, metadanych, filtrowania i sprzętu.
Model embeddings to jeden z ważnych komponentów potoku RAG, obok parsowania, dzielenia na fragmenty, wyszukiwania, rerankingu i generowania. Jeśli odpowiednie dowody nie zostaną pobrane, mocniejszy generator nie jest w stanie ich wiarygodnie odtworzyć.
38. Architektura RAG w produkcji
Retrieval-Augmented Generation dostarcza LLM dokumenty pobrane w czasie zapytania. Może zapewnić aktualne lub prywatne dowody, których nie ma w wagach modelu, ale samo wyszukiwanie nie gwarantuje, że odpowiedź użyje tych dowodów poprawnie. Produkcyjny system RAG to wieloetapowy potok, którego etapy wymagają osobnej ewaluacji. Rysunek pokazuje ścieżkę ingestii offline, ścieżkę wykonywaną dla każdego zapytania oraz miejsca, w których występują trzy wymienione niżej rodzaje awarii.
Potok ingestii działa offline. Surowe dokumenty (PDF, HTML, Markdown, bazy danych) są najpierw parsowane do czystego tekstu. Parsowanie PDF może gubić tabele, nagłówki i formatowanie. Tekst jest następnie dzielony na fragmenty (chunks), które są niezależnie embedowane i indeksowane.
Dzielenie na fragmenty wpływa zarówno na recall wyszukiwania, jak i na kontekst dostępny dla generatora. Użyteczne rozmiary zależą od struktury dokumentu, ziarnistości zapytań, limitów modelu embeddings i limitów rerankera. Typowe podejścia to stały rozmiar z nakładką, rekurencyjny podział wzdłuż granic dokumentu i chunking semantyczny według podobieństwa embeddings. Porównuj je na etykietach trafności na poziomie stron lub sekcji, zamiast przyjmować jeden zakres tokenów uniwersalnie.
Każdy fragment jest następnie embedowany modelem takim jak te z sekcji 37 i zapisywany w indeksie wektorowym. pgvector trzyma wektory w już działającej bazie Postgres. Dedykowany magazyn, taki jak Qdrant, Weaviate lub Pinecone, dodaje wbudowane wyszukiwanie hybrydowe i skaluje indeks niezależnie od bazy danych aplikacji.
Potok wyszukiwania działa w czasie zapytania. Zacznij od mierzalnej wersji bazowej, a potem dodawaj etapy, gdy analiza błędów pokaże, że rozwiązują realną lukę:
- Wyszukiwanie hybrydowe łączy gęste wyszukiwanie wektorowe z rzadkim, takim jak BM25, często scalane przez Reciprocal Rank Fusion (RRF). Wyszukiwanie gęste radzi sobie z parafrazami semantycznymi; rzadkie wyłapuje dokładne identyfikatory, kody błędów i akronimy. Benchmarki dostawców raportują zyski względem baz opartych tylko na wektorach, ale ich wielkość zależy od korpusu i etykiet trafności.
- Reranking przepuszcza pobranych kandydatów przez model, który ocenia zapytanie i dokument razem. Może to poprawić trafność w drobnych szczegółach kosztem kolejnego wywołania modelu. Liczbę kandydatów, liczbę zachowanych i opóźnienie należy stroić razem. Pełny wieloetapowy potok opisałem w Budowie nowoczesnego stosu rankingu wyszukiwania.
- Transformacja zapytania przeformułowuje zapytanie użytkownika przed wyszukiwaniem, aby poprawić recall. HyDE (Hypothetical Document Embeddings) każe LLM wygenerować hipotetyczny dokument, który jest embedowany i służy do wyszukiwania rzeczywistych dokumentów. Wygenerowany tekst jest reprezentacją wyszukiwania, a nie zweryfikowanym dowodem dla odpowiedzi. Rozszerzenie multi-query generuje wiele sformułowań tego samego pytania. Step-back prompting najpierw zadaje bardziej ogólne pytanie, aby wyszukiwać lub rozumować na podstawie ogólniejszych zasad.
Typowe tryby awarii:
- Porażka wyszukiwania — poprawny dokument istnieje, ale nie zostaje pobrany. Przetestuj dzielenie na fragmenty, transformację zapytania, wyszukiwanie hybrydowe i filtrowanie po metadanych pod kątem tej luki.
- Zatrucie kontekstu — nietrafne pobrane fragmenty wprowadzają LLM w błąd. Przetestuj reranking, filtry kontekstu i mniejsze zbiory zachowanych fragmentów.
- Lost-in-the-middle — w testowanych ustawieniach wielodokumentowego odpowiadania na pytania i wyszukiwania klucz-wartość Liu et al. stwierdzili, że skuteczność odpowiedzi była zazwyczaj najwyższa, gdy istotna informacja pojawiała się blisko początku lub końca wejścia, a niższa, gdy znajdowała się w środku.
GraphRAG (Microsoft, 2024) wyodrębnia encje i relacje, wykrywa społeczności grafu i tworzy ich podsumowania. Jego metoda globalnego wyszukiwania odpowiada na pytania dotyczące całego korpusu na podstawie tych podsumowań; nie jest to po prostu wyszukiwanie wektorowe z dodanym grafem. Kompromisem jest dodatkowa praca nad ekstrakcją, indeksowaniem, przechowywaniem i ewaluacją.
Poradniki praktyków podają zakresy opóźnień dla embeddingu, wyszukiwania, rerankingu i generowania, ale te wartości zależą od regionu, korpusu, sprzętu i modelu. Mierz każdy etap w śladach (traces) i oceń zmianę jakości, zanim zaakceptujesz dodatkowe opóźnienie.
39. Architektury agentów i wywoływanie narzędzi
Agenci LLM używają modeli do wyboru i układania w sekwencje wywołań narzędzi wokół zmieniającego się stanu. Trzy użyteczne wzorce orkiestracji to:
- ReAct — przeplata wybór akcji z obserwacjami. Może się dostosować po każdym wyniku narzędzia, ale rosnąca historia podnosi koszt tokenów i opóźnienie.
- ReWOO — planuje wywołania narzędzi z symbolami zastępczymi i jawnymi zależnościami wyników, a potem wykonuje plan i syntetyzuje wynik. Tylko niezależne wywołania mogą działać równolegle; wywołanie odwołujące się do wcześniejszego wyniku musi na niego poczekać. Jego artykuł raportuje oszczędności tokenów względem ReAct, ale stały plan wymaga jawnej ścieżki naprawczej, gdy narzędzie zawiedzie.
- Planner-executor — oddziela planowanie od wykonania i może dodać politykę ponownego planowania po awarii. Pozwala użyć innego modelu dla każdej roli, ale dodaje stan planu i drugie wywołanie modelu, które może zawieść.
| Wzorzec | Powtarzana praca modelu | Zdolność adaptacji | Użyteczny punkt wyjścia |
|---|---|---|---|
| ReAct | Czyta obserwacje przed następną akcją | Aktualizuje się po obserwacjach | Niepewne lub eksploracyjne użycie narzędzi |
| ReWOO | Ponownie używa planu z jawnymi zależnościami | Stały plan, chyba że rozszerzony | Praca, którą można zaplanować przed wynikami narzędzi |
| Planner-executor | Planuje, wykonuje i może planować ponownie | Może zmienić jawny plan | Dłuższe zadania, które zyskują na kontroli |
Rysunek przedstawia trzy wzorce, aby było widać, gdzie każdy z nich planuje i czy ma drogę powrotną po wyniku narzędzia.
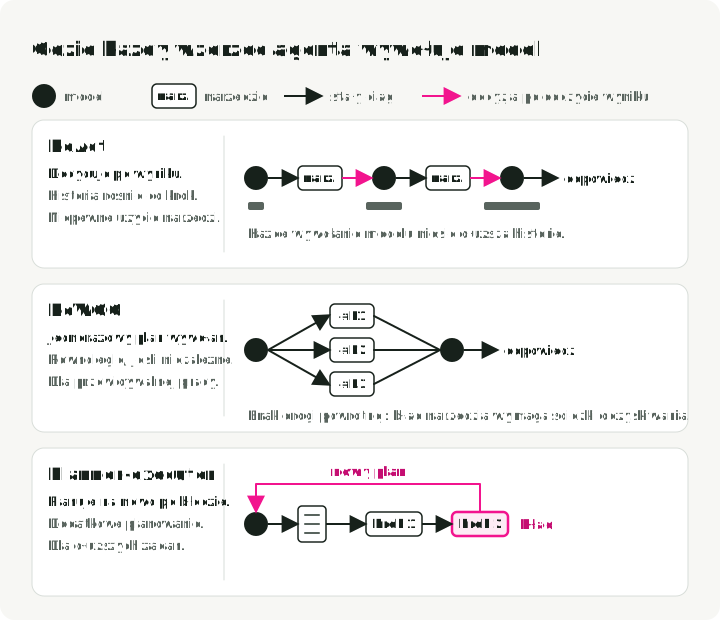
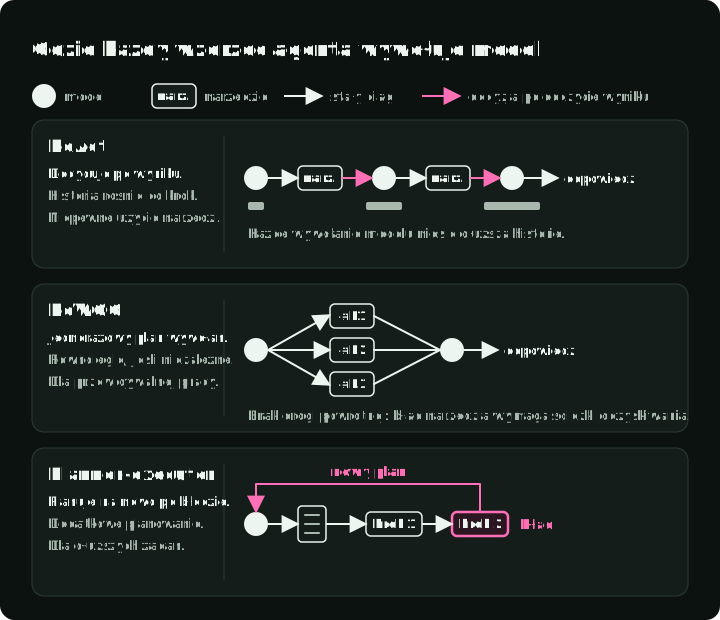
Function calling to częsty mechanizm wywoływania narzędzi. API udostępniają definicje narzędzi i zwracają ustrukturyzowane argumenty, co zmniejsza potrzebę parsowania swobodnego tekstu. Argumenty zgodne ze schematem nadal mogą wskazywać złe narzędzie lub zawierać niepoprawne wartości. Równoległe function calling może zmniejszyć liczbę rund komunikacji, gdy operacje są niezależne.
Ustrukturyzowane dane wyjściowe i constrained decoding wymuszają schemat, ograniczając tokeny dostępne w każdym kroku generowania. Silniki takie jak xgrammar, używany w vLLM i SGLang, mogą usunąć wiele błędów składni i parsowania przy niskim narzucie w obsługiwanych konfiguracjach. Nie gwarantują, że wyodrębnione wartości lub decyzje są poprawne. Schema-Guided Reasoning (SGR) wykorzystuje kolejność pól i strukturę schematu, aby stan pośredni można było sprawdzić przed decyzją końcową. Jego trzy wzorce to Cascade (kroki sekwencyjne), Routing (typy unijne jako semantyczne przełączniki) i Cycle (listy ograniczone).
Większy zbiór narzędzi i głębsza sekwencja akcji mogą obniżyć jakość doboru oraz zwiększyć opóźnienie lub koszt tokenów. Zmierz te krzywe na rzeczywistych opisach narzędzi i rozkładzie błędów. Frameworki takie jak LangGraph mogą uczynić stan i ścieżki naprawcze jawnymi, ale nie zdejmują z Ciebie ciężaru ewaluacji.
40. Inżynieria promptów w produkcji
Prompting w produkcji to problem ewaluacji: zmień jedną część promptu lub kontekstu, a potem zmierz jakość zadania i tryby awarii. Poniższe techniki to typowe punkty wyjścia, a nie uniwersalna kolejność.
Przykłady few-shot są często skuteczne w kontrolowaniu formatu wyjścia. Zacznij od 3–5 przykładów obejmujących puste wejścia, niejednoznaczne zapytania i odpowiedzi wieloczęściowe, a potem zmierz wynik na zbiorze wydzielonym. Przykłady powinny obejmować rzeczywisty rozkład wejść, a nie tylko szczęśliwą ścieżkę. Więcej przykładów zużywa kontekst i nie gwarantuje dalszych zysków.
Prompting chain-of-thought (CoT) prosi model o ujawnienie rozumowania pośredniego przed odpowiedzią. Kojima et al. (2022) zaraportowali zyski z przyrostka „Let’s think step by step” w testowanych zadaniach rozumowania, ale efekt zależy od modelu, a nowsze API rozumujące mogą nie ujawniać ukrytych śladów. W produkcji preferuj możliwy do sprawdzenia rozkład zadania lub zwięzłe uzasadnienie, gdy jest przydatne dla ewaluatora. Self-consistency (Wang et al., 2023) próbkuje kilka ścieżek rozumowania i agreguje odpowiedzi, wymieniając dodatkowy koszt inferencji na odporność w odpowiednich zadaniach.
Ustrukturyzowane dane wyjściowe z jawnymi schematami JSON (sekcja 39) usuwają wiele błędów parsowania. Silniki constrained decoding, takie jak xgrammar, mogą wymuszać obsługiwaną gramatykę podczas generowania; poprawność faktograficzna i semantyczna nadal wymagają ewaluacji, a nieobsługiwane cechy schematu mogą nadal wymagać obsługi.
Łańcuchowanie promptów dzieli zadanie na wyspecjalizowane etapy, na przykład klasyfikacja intencji → pobranie kontekstu → wygenerowanie odpowiedzi → walidacja wyniku. Może lokalizować błędy, pozwalać na różne modele w poszczególnych etapach i ujawniać stan pośredni nadający się do cache. Dodaje też interfejsy i opóźnienie, więc porównaj je z wersją bazową z jednym wywołaniem.
Temperatura zmienia rozkład próbkowania. Niskie wartości to rozsądny punkt wyjścia dla klasyfikacji lub ekstrakcji; wyższe mogą zwiększać różnorodność w generowaniu pomysłów. Dokładne zachowanie różni się między API modeli i oddziałuje z top_p, top_k i domyślnymi ustawieniami dostawcy, więc przetestuj obsługiwane ustawienia na zadaniu, zamiast kopiować jeden zakres.
Rozdzielenie wiadomości systemowej i użytkownika oddziela trwałą politykę od treści pojedynczego żądania. Szablony czatu i instruction tuning nadają tym rolom różny priorytet, ale nie czynią wiadomości systemowej granicą egzekwowania. Stabilne zachowanie umieść w wiadomości systemowej, niezaufane dane trzymaj w treści użytkownika lub narzędzia, a twarde ograniczenia, takie jak usuwanie PII, egzekwuj także poza modelem.
Inżynieria kontekstu rozszerza pracę nad promptem na składanie pobranych dokumentów, wyników narzędzi, historii rozmowy i przykładów. Liu et al. znaleźli efekt lost-in-the-middle w testowanych modelach długiego kontekstu, więc pozycja powinna być częścią ewaluacji, a nie zakładaną jako nieistotna. Szerszy przepływ pracy opisałem w Inżynierii kontekstu dla agentów AI.
Część VIII — Operacje produkcyjne
Operacje produkcyjne zamieniają wcześniejsze pojęcia w limity przyjmowania żądań, testy obciążeniowe, alerty i decyzje o pojemności pod rzeczywistym ruchem.
41. Rate limiting dla żądań o zmiennym koszcie
Tradycyjny rate limiting oparty na żądaniach na sekundę zakłada z grubsza równy koszt każdego żądania. LLM łamią to założenie. 10-tokenowy prompt klasyfikacyjny i 100K-tokenowa analiza dokumentu trafiają w ten sam endpoint API, ale różnią się długością wejścia 10 000 razy. Całkowity koszt zależy też od długości wyjścia, modelu, cache i cen. Limitowanie według RPS albo przepuszcza drogie żądania bez kontroli, albo niepotrzebnie głodzi tanie.
Systemy produkcyjne potrzebują rate limitingu opartego na tokenach w wielu wymiarach. OpenAI dokumentuje limity żądań i tokenów według poziomu użycia. Anthropic rozdziela limity tokenów wejściowych i wyjściowych. Dokładne kwoty i algorytmy mogą się zmieniać, więc traktuj dokumentację dostawcy jako źródło prawdy; sedno architektury to budżetowanie żądań i tokenów niezależnie.
Jedna z implementacji na poziomie aplikacji to wielowymiarowa hierarchia limitów (użytkownik → aplikacja → organizacja → globalnie), z priorytetami dla dostępu premium. Przy przyjmowaniu żądania rezerwuj tokeny: oszacuj całość (wejście + max_tokens), odejmij ją z puli, a po zakończeniu zwróć niewykorzystaną część na podstawie rzeczywistego zużycia. Zapobiega to wyczerpaniu pojemności przez serię długich generacji, zanim zaczną one zwracać dane. Żądanie z 2000 tokenami na wejściu i max_tokens = 1000 rezerwuje 3000. Jeśli odpowiedź wykorzysta 200 tokenów, rzeczywiste zużycie wynosi 2200, a 800 wraca do puli. To lokalna polityka przyjmowania; algorytmy limitów dostawców mogą stosować inne szacunki i osobne budżety wejścia i wyjścia. Jeśli pula zawiera mniej niż 3000, zwróć 429 lub umieść żądanie w kolejce.
We wdrożeniach self-hosted odpowiednikiem jest zarezerwowana przepustowość (provisioned throughput): rezerwowanie dedykowanej pojemności GPU dla docelowego tempa generowania tokenów. We wdrożeniach vLLM oznacza to konfigurację kontroli przyjęć wokół aktywnych slotów decode i presji na KV cache, a nie samej liczby żądań. Jak wyjaśnia sekcja 5, zarówno przepustowość, jak i przyjmowanie wymagają limitów uwzględniających tokeny.
42. Tryby awarii, na które trzeba projektować
Serwowanie LLM dodaje tryby awarii związane ze zmienną długością sekwencji, pamięcią KV i długotrwałą pracą decode. Zaprojektuj zabezpieczenia i przetestuj je obciążeniowo, zanim ruch produkcyjny zacznie od nich zależeć.
Brak pamięci (OOM) to częsta awaria. Model 70B w FP16 potrzebuje około 140 GB samych wag, a KV cache dla pojedynczej sekwencji Llama 3.1 70B z kontekstem 128K może dodać około 40 GiB przy założeniach z sekcji 6. Różnica między „mieści się w pamięci” a „OOM pod obciążeniem” jest mniejsza, niż się wydaje, ponieważ batch żądań z długim kontekstem może zużyć więcej pamięci KV, niż oczekiwano. Zapobieganie łączy zmierzoną rezerwę pamięci z kwantyzacją i stronicowaną alokacją KV. W vLLM --gpu-memory-utilization ustawia ułamek pamięci GPU, który silnik może wykorzystać na wagi, aktywacje i KV cache; reszta to rezerwa. Przy obciążeniach z wysoką presją na KV LMCache może odciążać dane KV do pamięci CPU lub na dysk; potraktuj jego publikowane wyniki jako punkt wyjścia i zbenchmarkuj lokalną hierarchię pamięci.
Wywłaszczanie (preemption) następuje, gdy presja na KV cache zmusza planistę do wyrzucenia lub ponownego obliczenia pracy. Dokładna strategia zależy od wersji i konfiguracji serwowania. Z perspektywy użytkownika objawem jest wyższe opóźnienie end-to-end bez oczywistego błędu aplikacji. Obserwuj liczbę wywłaszczeń i koreluj ją z zajętością KV, głębokością kolejki i długościami żądań.
Opóźnienie ogonowe może gwałtownie wzrosnąć, gdy duże prefille opóźniają pracę decode. Chunked prefill (sekcja 7) i szeregowanie uwzględniające długość celują w tę interferencję. Artykuły o planiście Learning-to-Rank (Fu et al., 2024) i CascadeInfer raportują poprawę względem swoich punktów odniesienia w ocenianych obciążeniach, ale dokładny wynik zależy od rozkładu długości żądań i konfiguracji planisty.
Awarie kaskadowe mogą się zacząć, gdy wolne żądania powiększają kolejkę, klienci upstream przekraczają limit czasu, a ponowienia dodają kolejne obciążenie. Zabezpieczenia to kontrola przyjęć, limity współbieżności na najemcę, limity długości wyjścia, budżety ponowień i bezpieczniki (circuit breakers) na bramce. Zdezagregowane pule prefill i decode mogą pomóc, gdy testy obciążeniowe pokazują trwałą interferencję faz. Rysunek pokazuje pętlę i zabezpieczenie na każdej krawędzi.
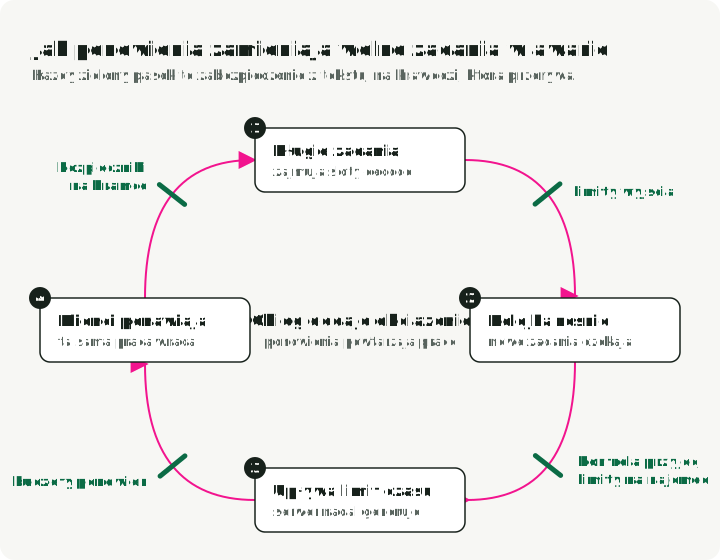
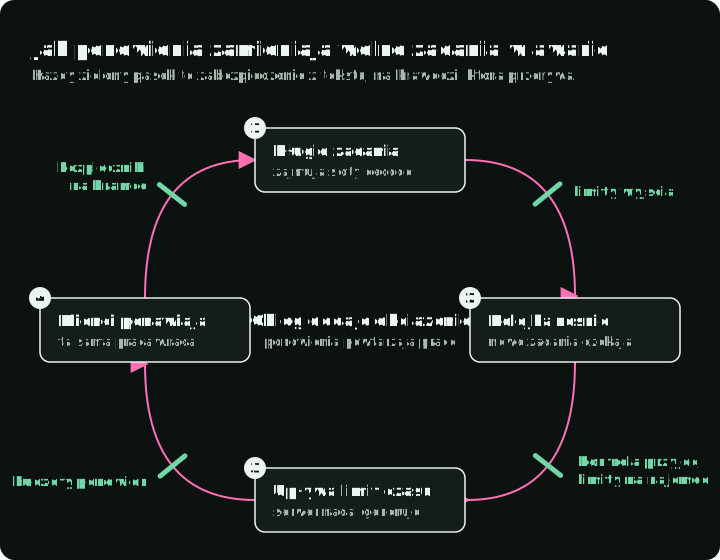
43. Monitorowanie systemów LLM
Monitorowanie LLM różni się od monitorowania API na trzy sposoby: każde żądanie ma inny koszt, każde żądanie ma dwie fazy z różnymi wąskimi gardłami, a jego ślad pamięciowy zależy zarówno od długości wejścia, jak i wyjścia. Samo opóźnienie żądania i wskaźnik błędów nie pokazują żadnego z tych elementów.
Goodput to liczba żądań na sekundę spełniających wszystkie zdefiniowane progi SLO, takie jak TTFT, TPOT i całkowite opóźnienie. To użyteczna miara łączna, ponieważ surowa przepustowość może wyglądać zdrowo, gdy SLO opóźnień zawodzą: system przetwarzający 100 żądań na sekundę, który na 40% z nich przekracza progi, ma goodput 60 żądań na sekundę. Optymalizacja pod goodput utrzymuje widoczny rozkład wydajności zamiast raportować samą średnią.
vLLM udostępnia endpoint Prometheus pod /metrics z liczbą żądań działających i oczekujących, zajętością KV cache, rozkładami długości generowania i statystykami prefix cache. Nazwy metryk mogą się zmieniać między wydaniami, więc powiąż dashboardy z wdrożoną wersją. Typowy stos używa Prometheusa do metryk, Grafany do wizualizacji i śladów zgodnych z OpenTelemetry w komponentach aplikacji i serwowania.
Użyteczne wzorce alertów obejmują poniższe. Progi wyprowadź z testów obciążeniowych, zamiast kopiować te przykłady bez zmian:
- Skoki liczby wywłaszczeń — środowisko wymienia lub ponownie oblicza pracę, co dodaje opóźnienie bez błędu aplikacji.
- Zajętość KV cache zbliżająca się do przetestowanego obszaru wywłaszczeń — dodaj pojemność lub odrzuć część ruchu, zanim wyrzucenia zaczną się kaskadować.
- Głębokość kolejki trwale powyżej przetestowanego zakresu batcha — kontrola przyjęć powinna zacząć odrzucać lub obniżać priorytet.
- TTFT rośnie, a TPOT pozostaje stały — ta rozbieżność wskazuje najpierw na kolejkowanie, przyjmowanie, sieć lub presję na prefill, a nie na przepustowość decode. Do rozróżnienia użyj śladów i metryk kolejki.
W vLLM pierwsze trzy alerty odpowiadają vllm:num_preemptions_total, vllm:kv_cache_usage_perc i vllm:num_requests_waiting (metryki vLLM).
44. Optymalizacja kosztów: strategia kumulująca się
Ceny dostawców i stosunki cen wejścia do wyjścia się zmieniają. Przed decyzją zakupową pobierz aktualne stawki; poziom modelu i długość wyjścia mogą zdominować rachunek jeszcze przed optymalizacjami infrastruktury.
OpenAI, Anthropic i Google wyceniają tokeny wyjściowe kilka razy drożej niż wejściowe w swoich flagowych modelach. Osobno podział na prefill i decode wyjaśnia, dlaczego wejście i wyjście mają różne koszty wykonania: prefill przetwarza tokeny promptu razem, a zwykły decode generuje tokeny sekwencyjnie. Sam ten mechanizm nie ustala, jak dostawca wyznacza swoje ceny handlowe. Ucięcie niepotrzebnego wyjścia (ciasne max_tokens, ustrukturyzowane dane wyjściowe, brak powtarzania wejścia) zwykle oszczędza więcej niż ucięcie tej samej liczby tokenów wejściowych.
Kilka podejść można łączyć, ale dopiero po zmierzeniu, które mają zastosowanie do obciążenia:
- Kwantyzacja z FP16 do INT4 zmniejsza pamięć surowych wartości wag o 75%, przed skalami i innymi metadanymi. To, czy obniży rachunek, zależy od szybkości kernela, rozmiaru batcha i wykorzystania sprzętu (sekcja 9).
- Routing modeli kieruje kwalifikujący się ruch do tańszych modeli. Zmierz odsetek błędnych akceptacji routera i jakość end-to-end, zanim zwiększysz udział obsługiwany przez tańszy model (sekcja 36).
- Prompt caching zmniejsza pracę nad powtarzającymi się prefiksami. Rabaty dostawców i traktowanie limitów szybkości zmieniają się w czasie, więc łącz zmierzony współczynnik trafień z aktualnymi warunkami (sekcja 16).
- API wsadowe mogą dawać rabat na pracę niewymagającą czasu rzeczywistego, taką jak ewaluacje, generowanie danych syntetycznych i klasyfikacja masowa. Sprawdź aktualne ceny i okna realizacji.
- Self-hosting może się opłacać przy stałym wykorzystaniu, ale nie ma uniwersalnego progu opłacalności w wolumenie tokenów. Oprócz wynajmu GPU uwzględnij koszty inżynierii, orkiestracji, observability, zapasu pojemności i dyżurów.
Nie mnoż oddzielnych zysków optymalizacji tak, jakby każde żądanie korzystało z nich niezależnie: kwantyzacja zmienia przepustowość, kierowanie żądań zmienia rozkład jakości, a buforowanie i przetwarzanie partiami dotyczą tylko kwalifikującego się ruchu. Oprzyj szacunek na zmierzonych udziałach ruchu i sprawdź go względem faktury.
45. Planowanie pojemności i autoskalowanie
Planowanie pojemności dla serwowania LLM musi uwzględniać zmienny koszt żądań, długotrwałą pracę decode i pamięć zależną od sekwencji. W zależności od obciążenia zasobem ograniczającym może być pamięć KV, przepustowość pamięci, moc obliczeniowa lub interkonekt.
Teoretyczny limit wynikający z pamięci dla liczby równoległych żądań wynika z budżetu KV cache:
Dla rachunku pojemności załóżmy, że środowisko udostępnia budżet KV 40 GiB dla Llama 3.1 70B z KV cache w FP16. Każda sekwencja 4K zajmuje około 1,25 GiB, a każda sekwencja 128K około 40 GiB. Taki budżet mieści więc co najwyżej około 32 sekwencje 4K albo jedną sekwencję 128K, zanim doliczy się narzut alokatora, środowiska, zmienności obciążenia i SLO. Funkcja kv_cache_bytes z sekcji 6 powtarza to obliczenie dla innego modelu lub budżetu. Dlatego wybór GPU i optymalizacja KV cache bezpośrednio wyznaczają plan pojemności.
Wzór pojemności do wymiarowania floty:
Przed dzieleniem przelicz oba tempa na tę samą jednostkę czasu. Użyj przepustowości na GPU zmierzonej przy docelowym SLO, a nie przepustowości szczytowej. Mnożnik 1,3 zapewnia przepustowość o 30% większą od oczekiwanego popytu, co pozostawia przy tym popycie około 23% przydzielonej pojemności niewykorzystanej. Zaokrąglaj w górę do pełnych replik serwujących; replika TP/PP potrzebuje całej swojej grupy GPU. Wartości na GPU są użyteczne tylko dla ustalonej, zmierzonej topologii replik. Dobierz mnożnik na podstawie zmierzonej zmienności ruchu, awarii i czasu odzyskiwania. Szczytowa przepustowość tokenów i przepustowość zgodna z SLO mogą się mocno różnić wraz ze wzrostem współbieżności. Benchmarkuj z rzeczywistym rozkładem długości promptów i odpowiedzi przy wymaganych progach TTFT i TPOT, zamiast używać teoretycznego maksimum.
Zajętość GPU jako jedyny sygnał autoskalowania nie wystarcza, ponieważ może pozostawać wysoka zarówno przy zdrowym przetwarzaniu, jak i przy przeciążeniu. Połącz ją z głębokością kolejki, zajętością KV cache i spadkiem goodputu. Progi dostrój w testach obciążeniowych; wartości takie jak 80% zajętości KV to punkty wyjścia, a nie uniwersalne limity. Te metryki wprowadza sekcja 43.
Scale-to-zero może pasować do środowisk deweloperskich i stagingowych z długimi okresami bezczynności. Platformy inferencji serverless i autoskalery oparte na Kubernetesie, takie jak KEDA, mogą usunąć bezczynną pojemność, ale oszczędności i czas zimnego startu zależą od rozmiaru modelu, cache obrazów i wag oraz infrastruktury. Zmierz czas uruchamiania, zanim zastosujesz tę samą politykę do ruchu produkcyjnego wrażliwego na opóźnienia.
Jak łączą się pojęcia dotyczące inferencji
Części I–III łączą pojemność pamięci z wydajnością serwowania. Rozmiar KV na sekwencję (sekcja 6) daje surową granicę liczby przechowywanych sekwencji. Większe batche decode mogą poprawić ponowne użycie wag i intensywność arytmetyczną (sekcja 1), ale ruch attention, szeregowanie i komunikacja również wpływają na TPOT i przepustowość. GQA i niższa precyzja przechowywania KV zmniejszają rozmiar cache; PagedAttention zmniejsza straty alokacji. Przy podanej strukturze Llama 3.1 70B, KV cache w FP16 i budżecie 40 GiB surowa granica wynosi 32 sekwencje po 4K tokenów lub jedną o długości 128K, przed narzutem środowiska i ograniczeniami opóźnienia. Kontrola przyjęć może kolejkować lub odrzucać pracę, zanim ta granica zostanie osiągnięta. Przy presji na KV środowisko może wywłaszczać żądania; niekontrolowane alokacje mogą powodować OOM (sekcja 42).
Routing, caching, kwantyzacja i wybór sprzętu kumulują się tylko wtedy, gdy każdy z nich oceniono względem tego samego celu jakości i opóźnienia. Wybierz jeden objaw z tabeli na górze, ustal wersję bazową i zadbaj, aby następną zmianę łatwo było cofnąć.
Dalsza lektura
Powiązane pogłębione artykuły z tego bloga, pogrupowane tematycznie:
- Przewodnik po fine-tuningu LLM — kiedy fine-tuning, a kiedy RAG lub inżynieria promptów
- Otwarte warianty LLM i formaty plików — dopasowanie wariantów modeli i skwantyzowanych formatów do sprzętu
- Przewodnik po serwowaniu LoRAX — serwowanie tysięcy adapterów LoRA w produkcji
- Skalowanie dużych modeli językowych — strategie dla wielu GPU i wielu węzłów
- Lokalne LLM na macOS — praktyczna konfiguracja z llama.cpp i Ollama
- Pętle rozumowania agentów AI w 2026 — pogłębione omówienie pętli ReAct, ReWOO i planner-executor
- Architektura pamięci agentów AI w 2026 — checkpointy, magazyny wektorowe i pamięć dokumentów dla agentów ze stanem
Bibliografia
Pogrupowana według obszaru tematycznego.
Inferencja i attention
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness - Dao et al., NeurIPS 2022
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning - Dao, 2023
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision - Shah et al., NeurIPS 2024
- Flash-Decoding for long-context inference - Dao et al., 2023
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022
- GQA: Training Generalized Multi-Query Attention - Ainslie et al., 2023
- Triton: an intermediate language and compiler for neural network computations - Tillet et al., MAPL 2019
- FlashNorm: Fast Normalization for LLMs - 2024
- Deep Kernel Fusion for Transformers - DeepFusionKernel, 2026
Speculative decoding
- Accelerating Large Language Model Decoding with Speculative Sampling - Chen et al., 2023
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models - Li et al., NeurIPS 2025
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - ICML 2024
Kwantyzacja
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration - MLSys 2024 Best Paper
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers - Frantar et al., ICLR 2023
- Marlin: Mixed-Precision (FP16xINT4) LLM Inference Kernel - Frantar et al., 2024
Trening i fine-tuning
- LoRA: Low-Rank Adaptation of Large Language Models - Hu et al., ICLR 2022
- QLoRA: Efficient Finetuning of Quantized LLMs - Dettmers et al., NeurIPS 2023
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models - Rajbhandari et al., SC20
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning - Rajbhandari et al., 2021
- Self-Instruct: Aligning Language Models with Self-Generated Instructions - Wang et al., ACL 2023
- WizardLM: Empowering Large Language Models to Follow Complex Instructions - Xu et al., ICLR 2024
- Phi-4 Technical Report - Microsoft, 2024
- Training Deep Nets with Sublinear Memory Cost - Chen et al., 2016 (gradient checkpointing)
- AI models collapse when trained on recursively generated data - Shumailov et al., Nature 2024
Alignment
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model - Rafailov et al., NeurIPS 2023
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models - Introduced GRPO
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning - DeepSeek, 2025
Skalowanie i architektura
- The Llama 3 Herd of Models - Meta, 2024
- LLaMA: Open and Efficient Foundation Language Models - Touvron et al. (Meta), 2023
- Llama 2: Open Foundation and Fine-Tuned Chat Models - Touvron et al. (Meta), 2023
- Qwen3 Technical Report - Qwen Team (Alibaba), 2025
- Training Compute-Optimal Large Language Models - Hoffmann et al. (Chinchilla), NeurIPS 2022
- RoFormer: Enhanced Transformer with Rotary Position Embedding - Su et al., 2021
- YaRN: Efficient Context Window Extension of Large Language Models - Peng et al., ICLR 2024
- SGLang: Efficient Execution of Structured Language Model Programs - Zheng et al., NeurIPS 2024
- Mixtral of Experts - Jiang et al. (Mistral AI), 2024
Embeddings
- Matryoshka Representation Learning - Kusupati et al., NeurIPS 2022
- pplx-embed-v1: Diffusion-Pretrained Dense and Contextual Embeddings - Perplexity AI, 2026
Architektury agentów
- ReAct: Synergizing Reasoning and Acting in Language Models - Yao et al., ICLR 2023
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models - Xu et al., 2023
Prompting
- Large Language Models are Zero-Shot Reasoners - Kojima et al., NeurIPS 2022
- Self-Consistency Improves Chain of Thought Reasoning in Language Models - Wang et al., ICLR 2023
Routing
- RouteLLM: Learning to Route LLMs with Preference Data - Ong et al., ICLR 2025
Benchmarki
- MLPerf Inference v5.0 Results - MLCommons, April 2025
Architektury serwowania
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve - Agrawal et al., OSDI 2024 (Chunked prefill)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting - Patel et al., ISCA 2024 (Disaggregated Serving)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving - Zhong et al., OSDI 2024 (Disaggregated Serving)
Frameworki serwujące
- vLLM - PagedAttention-based serving engine
- SGLang - RadixAttention and structured generation
- TensorRT-LLM - NVIDIA optimized inference
- llama.cpp - Portable C/C++ inference
- DeepSpeed - Microsoft distributed training library
- Ollama - Local LLM runner
Operacje
- Efficient LLM Scheduling by Learning to Rank - Fu et al., NeurIPS 2024 (vLLM-LTR)
- CascadeInfer: Length-Aware Scheduling of LLM Serving with Low Latency and Load Balancing - Yuan et al., 2025
- Goodput metric as measure of ML productivity - Google Cloud, 2024
- vLLM Optimization and Tuning - vLLM Documentation
- vLLM Metrics - vLLM Documentation
- LMCache: KV Cache Management for LLM Serving - KV cache offloading
- OpenAI Rate Limits - OpenAI API Documentation
- Anthropic Rate Limits - Anthropic API Documentation