LLM Engineering Guide: 45 concepten voor production systems

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit is een naslagwerk voor engineers die de basis van ML en systems al kennen en een symptoom uit productie willen koppelen aan het juiste onderdeel van de stack. Het behandelt 45 concepten rond hardware, inference, training, deployment, applicaties en operations. Elk onderdeel beschrijft het mechanisme, wat het verandert in een draaiend systeem en onder welke voorwaarde het genoemde resultaat geldt. Begin je bij een symptoom, zoals een trage eerste token of OOM onder load, gebruik dan de symptoomtabel hieronder om te zien welke onderdelen je moet lezen.
Gebruik voor een gerichte vraag de LLM-engineering Fast Answers. Elk onderwerp heeft een apart antwoord en verwijst naar het bijbehorende onderdeel van de gids.
| Deel | Onderwerpen | Secties |
|---|---|---|
| I — Hardwarefundamenten | Roofline-model, GPU-geheugen, hardwareglossarium | 1–3 |
| II — Inference-fundamenten | Latency, throughput, KV cache, attention, quantization | 4–9 |
| III — Inference-optimalisaties | CUDA-kernels, FlashAttention, batching, PagedAttention, speculative decoding | 10–17 |
| IV — Modelarchitectuur | Transformer-internals, decoder-only, MoE, tokenization, context windows | 18–22 |
| V — Training en alignment | Pretraining, LoRA, mixed precision, ZeRO, scaling laws, RLHF/DPO/GRPO, distillation | 23–32 |
| VI — Schalen en deployment | Parallelism, serving frameworks, GPU-keuze, routing | 33–36 |
| VII — Applicaties | Embeddings, RAG, agents, prompt engineering | 37–40 |
| VIII — Operations in productie | Rate limiting, faalmodi, monitoring, kosten, capaciteitsplanning | 41–45 |
Begin bij een symptoom
Elke rij noemt de onderdelen die je het eerst leest en wat je meet voordat je de stack aanpast.
| Symptoom of beslissing | Begin met | Meet voordat je de stack aanpast |
|---|---|---|
| De eerste token komt traag | Prefill en decode, TTFT | Wachttijd in de queue, promptlengte, prefill-tijd en P99 TTFT |
| Tokens streamen traag | Roofline, TPOT | TPOT per concurrency, memory bandwidth en batchvorm |
| Lange contexten veroorzaken preemption of OOM | KV cache, PagedAttention | KV-gebruik, requestlengtes, allocator-verspilling en aantal preemptions |
| Een model past niet in het budget | Quantization, GPU-keuze | Kwaliteit, kernel-throughput, geheugenreserve en goodput bij de doel-SLO |
| Een serving runtime kiezen | Serving frameworks, Parallelism | Throughput en P99-latency bij de doel-SLO op je eigen prompts |
| Requests lopen onder load in een timeout | Faalmodi, Rate limiting | Queue-diepte, preemptions, retry-percentage en outputlengtes |
| Een trainingsrun past niet | LoRA en QLoRA, ZeRO, FSDP | Geheugen voor model state, communicatie, throughput en kwaliteit op held-out data |
| De kosten stijgen | Routing, kostenoptimalisatie | Welk verkeer in aanmerking komt, kwaliteitsfouten, cache-hitrate en factuurdata |
Verdiepende guides per beslissing
| Als je beslist… | Begin met | Lees daarna |
|---|---|---|
| Hoe je veel fine-tuned adapters serveert | Inference-fundamenten en deployment | LoRAX Serving Guide |
| Of je moet quantizen | Quantization | Model quantization guide |
| Hoe je een model over GPUs verdeelt | Parallelism | Scaling Large Language Models |
| Of je moet fine-tunen | Training en alignment | LLM Fine-Tuning Guide |
| Hoe retrieval in een app past | Embeddings en RAG | RAG Evaluation Metrics |
| Hoe agent-systemen werken | Agents en prompt engineering | AI Agent Reasoning Loops |
| Hoe je zoekresultaten rangschikt | Embeddings en reranking | Search Ranking Stack |
Deel I — Hardwarefundamenten
Arithmetic intensity, de GPU-geheugenhiërarchie en de hardwaretermen in dit deel verklaren veel van de keuzes verderop in de guide.
1. Memory-bound versus compute-bound en het roofline-model
Het uitgangspunt voor LLM-performance is de arithmetic intensity: hoeveel nuttige berekeningen voert de GPU uit voor elke byte die hij uit het geheugen laadt? Die verhouding bepaalt of een bewerking compute-bound is (wachten op de processor) of memory-bound (wachten tot data is geladen).
Elke GPU heeft een “kritieke intensiteit”: de drempel waarbij de piek-rekenkracht gelijk is aan de memory bandwidth. Voor een NVIDIA H100 SXM met dense BF16- of FP16-Tensor Cores (989 TFLOPS; de specificatie van 1,979 TFLOPS gaat uit van structured sparsity):
De roofline-grafiek hieronder zet de haalbare rekenkracht uit tegen de arithmetic intensity. De schuine lijn is het memory-bound-gebied, waar de bandwidth de limiet bepaalt. De vlakke lijn is de maximale compute-throughput. Hun snijpunt ligt bij de drempel van 295 FLOPs/byte.
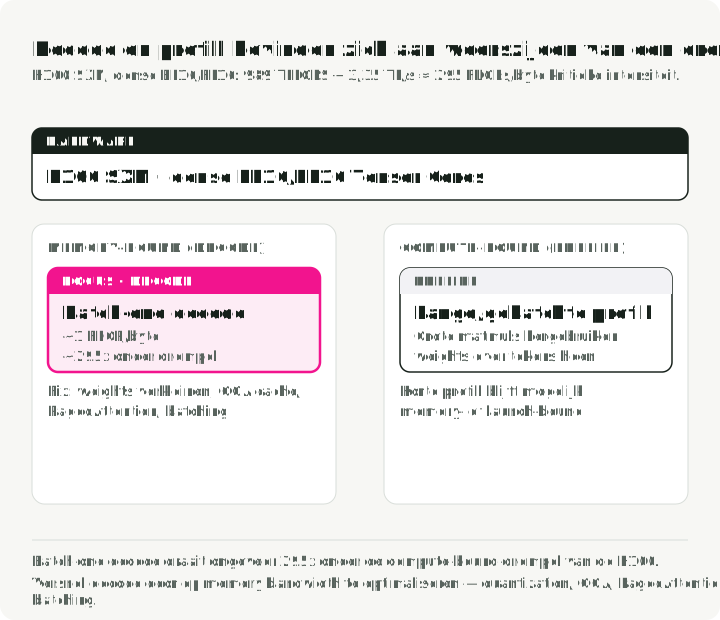
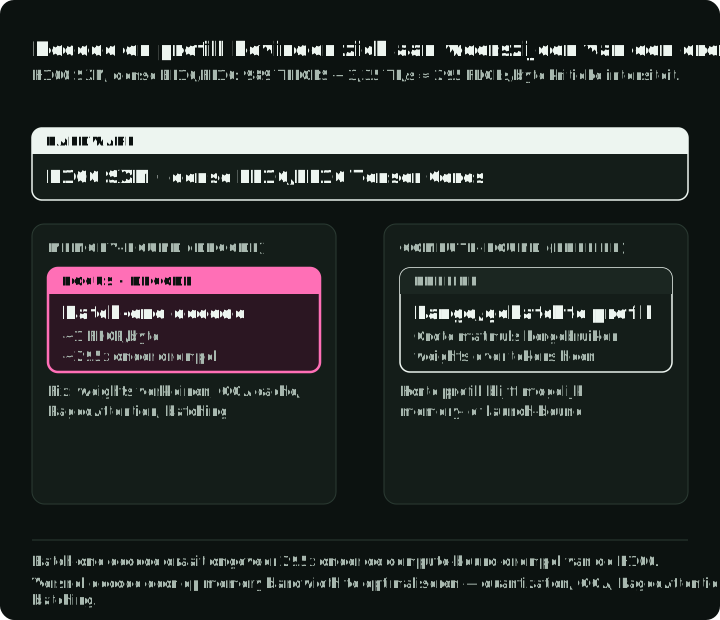
Decode met batchgrootte één en lange of voldoende gebatchte prefill zitten vaak aan weerszijden van deze drempel:
- Decode is memory-bound. Tokens één voor één genereren betekent dat je de weight-matrix van meerdere gigabytes uit het geheugen laadt om hem met één nieuwe token te vermenigvuldigen. In een vereenvoudigde analyse met dense 16-bit en batchgrootte één heeft de bewerking ongeveer 1 FLOP/byte, zo’n 295x onder de roofline-drempel van de H100. Dat gat verklaart waarom decode in dit regime de piek-rekenkracht niet kan benaderen.
- Lange of voldoende gebatchte prefill is vaak compute-bound. Veel prompt-tokens verwerken hergebruikt weights in grote matrixvermenigvuldigingen, en dat kan de arithmetic intensity boven de roofline-drempel brengen. Korte prompts en kleine batches worden daarentegen mogelijk beperkt door geheugenverkeer of kernel-launch-overhead.
Wil je decode versnellen, werk dan aan de memory bandwidth: verklein de weights met quantization, beperk het KV-geheugen met GQA en PagedAttention, en verhoog de intensity met batching. Voor lange of goed gebatchte prefills kunnen snellere matrixberekeningen en rekenen met lagere precisie helpen. Profileer workloads met korte prefills apart.
2. GPU-geheugenhiërarchie
Een GPU heeft vier geheugenlagen met verschillende capaciteiten en toegangssnelheden. Registers zijn klein en snel; HBM bevat veel meer data, maar de toegang duurt langer. Data verplaatsen tussen deze lagen is een belangrijke prestatiebeperking. De figuur toont een H100 SXM: registers en shared memory binnen elke SM, L2 op de die en 80 GB HBM3 in stacks ernaast.
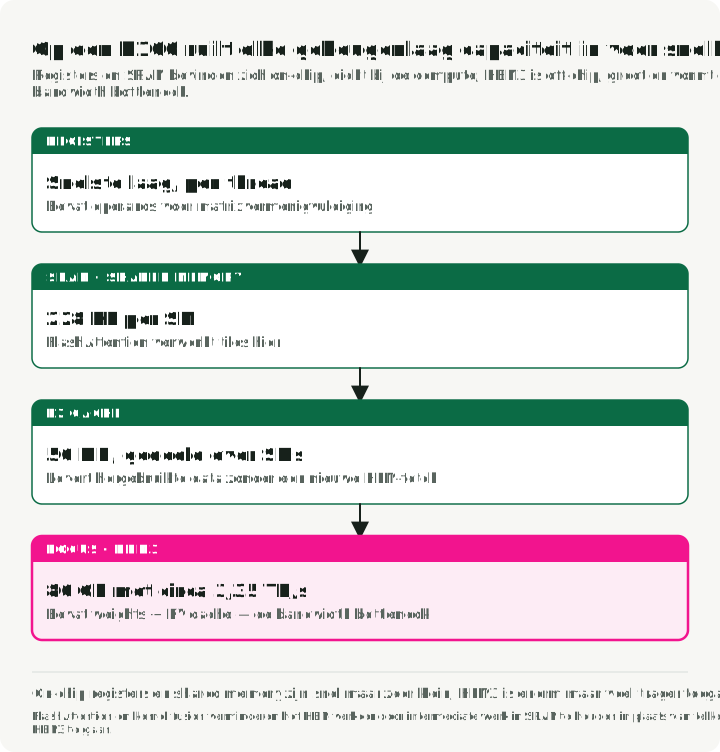
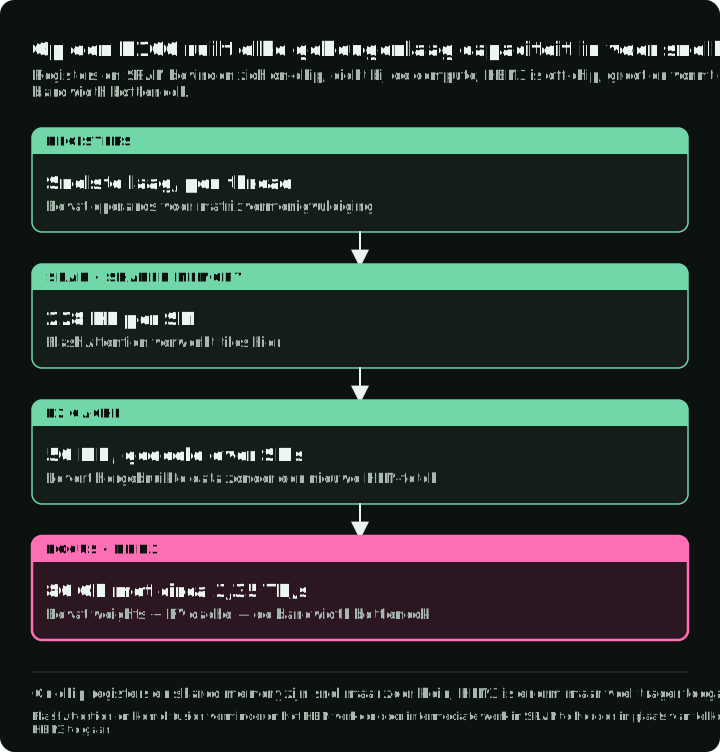
Van snelst naar traagst op een H100 SXM:
- Registers zijn het snelste geheugen en zitten direct aan de rekenthreads. Bij WGMMA op Hopper kan matrix A uit registers of shared memory komen, terwijl matrix B uit shared memory komt.
- SRAM (shared memory) is snel werkgeheugen op de chip, lokaal voor elke SM.
- L2-cache is een gedeelde laag van 50 MB. Hij kan data leveren die over SM’s heen wordt hergebruikt, zonder nieuwe HBM-fetch.
- HBM3 is het hoofdgeheugen van 80 GB met de model weights en de KV cache, met ~3.35 TB/s bandwidth.
Het verschil tussen de lagen op de chip en daarbuiten is groot. Op een A100 schat het FlashAttention-paper de bandwidth van SRAM op de chip op ongeveer 19 TB/s, tegen 1.5–2.0 TB/s voor HBM (Dao et al., 2022), een verschil van ruwweg 10x. FlashAttention en kernel fusion verminderen HBM-verkeer door tussenresultaten op de chip te houden of samen te voegen. PagedAttention pakt een ander probleem aan: het koppelt logische KV-blokken aan niet-aaneengesloten fysieke blokken in het GPU-geheugen, wat fragmentatie vermindert en het delen van blokken mogelijk maakt.
3. GPU-hardwareglossarium
De termen hieronder komen in de rest van de guide steeds terug.
HBM (High Bandwidth Memory) stapelt DRAM-dies die via through-silicon vias (TSV’s) naast de GPU-die zijn aangesloten. Generaties zijn onder meer HBM2e (A100, 2 TB/s), HBM3 (H100, 3.35 TB/s) en HBM3e (H200/B200, 4.8–8 TB/s). De HBM-bandwidth is een directe beperking voor TPOT in memory-bound decode-regimes.
GDDR (Graphics DDR) is traditioneel grafisch geheugen in consumenten- en workstation-GPU’s zoals de RTX 4090 en L40S. Die kaarten hebben lagere geheugenbandwidth dan de H100 SXM. GDDR6X op de RTX 4090 levert 1,008 GB/s volgens NVIDIA’s whitepaper over de Ada-architectuur, tegen 3.35 TB/s HBM3-bandwidth bij de H100 SXM.
Een SM (Streaming Multiprocessor) is het basisrekenblok in een NVIDIA-GPU. Elke SM bevat CUDA-cores, Tensor Cores, shared memory en een warp scheduler. De H100 SXM heeft 132 SM’s; de H100 PCIe heeft er 114; de A100 heeft er 108.
Tensor Cores zijn gespecialiseerde multiply-accumulate-eenheden voor matrices in elke SM. Ze versnellen de mixed-precision matmuls die de rekenlast van transformers domineren. Tensor Cores van de H100 SXM leveren 494.5 dense of 989 sparse TF32 TFLOPS; noem bij het vergelijken van dit getal altijd de precisie en de sparsity-modus.
CUDA Cores zijn algemene eenheden voor floating-point- en integerberekeningen. Ze verwerken element-wise bewerkingen, activation-functies en ander werk dat geen matrixwerk is, terwijl Tensor Cores ondersteunde matrixbewerkingen uitvoeren.
Een warp is een groep van 32 threads op een SM. Threads kunnen divergeren en GPU’s vanaf Volta ondersteunen onafhankelijke thread scheduling. Warp specialization wijst verschillende warps toe aan datatransport en berekening, zodat die taken kunnen overlappen.
NVLink is de snelle GPU-naar-GPU-interconnect van NVIDIA binnen één node. NVLink 4.0 op de H100 levert 900 GB/s bidirectionele bandwidth; NVLink 5.0 op de B200 haalt 1.8 TB/s. Die bandwidth is belangrijk voor tensor parallelism, omdat GPU’s in elke transformer-laag deelresultaten uitwisselen.
InfiniBand is een snel netwerk voor communicatie tussen nodes. InfiniBand-adapters uit de ConnectX-klasse vormen het netwerk tussen nodes voor pipeline-parallel of gedistribueerd trainingsverkeer; de bandwidth hangt af van de adapter en de poortconfiguratie.
RDMA (Remote Direct Memory Access) laat een apparaat het geheugen van een andere machine benaderen zonder dat het datapad via een van beide CPU’s loopt. GPUDirect RDMA ondersteunt directe GPU-naar-GPU-overdracht tussen nodes, inclusief overdracht van de KV cache bij disaggregated serving.
NVMe (Non-Volatile Memory Express) is de SSD-interface voor KV cache-offloading en voor parameter-offloading met ZeRO-Infinity wanneer GPU- en CPU-geheugen tekortschieten. De sequentiële bandwidth hangt af van de schijf en de workload en blijft ver onder die van HBM.
TFLOPS en PFLOPS zijn biljoenen en biljarden floating-point-bewerkingen per seconde. Eén TFLOPS is gelijk aan FLOPS. De H100 haalt 989 sparse TF32 tensor-TFLOPS, terwijl FlashAttention-3 ongeveer 1.2 PFLOPS in FP8 rapporteert; die waarden gebruiken verschillende formaten en moet je niet vergelijken alsof het één metriek is.
Deel II — Inference-fundamenten
Inference maakt van een model een service die gebruikers kunnen gebruiken. De volgende concepten scheiden het werk dat de eerste token vertraagt van het werk dat elke latere token vertraagt, en leggen de geheugenlimieten achter beide bloot.
4. Latency: TTFT, TPOT en percentielen
Time to First Token (TTFT) is de end-to-end vertraging tussen het indienen van een request en de eerste output-token. Daarin zitten queueing, tokenization, scheduling, de prefill-pass die de eerste token oplevert en de netwerklevering. Gangbare serving-engines samplen de eerste output-token uit de logits van de forward pass van de prefill, dus er draait geen aparte decode-stap vóór die token. Langere prompts verlengen meestal het prefill-deel, maar elk van deze fasen kan domineren. Doelen zijn productspecifiek; MLPerf Inference v5.0 hanteert voor het interactieve Llama 2 70B-scenario een P99 TTFT-limiet van 450 ms.
Time Per Output Token (TPOT) is het gemiddelde interval tussen opeenvolgende tokens na de eerste. Het komt overeen met de decode-fase. Decode met batchgrootte één of lage intensity wordt meestal beperkt door memory bandwidth, terwijl voldoende grote batches compute-bound kunnen worden:
Deze definitie vereist minstens twee output-tokens; voor een antwoord van één token is TPOT niet gedefinieerd. Voor deze vergelijking eindigt de E2E-latency bij de laatste output-token. Een timer voor HTTP-completion kan ook latere metadata of het sluiten van de verbinding meenemen; meet dat apart.
Een schatting van de Engelse leessnelheid geeft een ruwe referentie voor streaming. De gemiddelde stille leessnelheid van een volwassene voor Engelse non-fictie is ongeveer 238 woorden per minuut (Brysbaert, 2019), ongeveer 4 woorden per seconde. Als een token gemiddeld drie kwart woord bevat, komt dat neer op ongeveer 5 tokens per seconde, oftewel 200 ms per token. Deze schatting is geen usability-drempel: taal, tokenizer, taak en clientbuffering veranderen het resultaat. Het interactieve scenario van MLPerf hanteert een veel strengere P99 TPOT-limiet van 40 ms. Stel je eigen doel vast met producttests.
P50 versus P99 latency is belangrijk omdat de mediaan de staart verbergt. Een systeem met een goede P50 en een slechte P99 kan problemen hebben met batching, preemption, queueing of scheefgetrokken workloads; traces zijn nodig om die van elkaar te onderscheiden.
5. Throughput: tokens per seconde en de afweging met latency
Throughput meet je in output-tokens per seconde over gelijktijdige requests heen. Requests per seconde zegt op zichzelf minder, omdat een antwoord van 10 tokens en een antwoord van 1.000 tokens heel verschillende kosten hebben. Gepubliceerde benchmarkcijfers variëren met model, precisie, hardware, prompt- en outputlengtes, concurrency en SLO. Vergelijk vLLM, SGLang en TensorRT-LLM met één harness in plaats van hun headline-resultaten te combineren.
Een kleine decode-batch vergroten kan de throughput verhogen doordat weight-reads worden gedeeld. Grotere batches of een hogere aangeboden load verhogen uiteindelijk de latency of bereiken geheugen-, compute- of communicatielimieten. Meet die curve in plaats van lineaire schaling aan te nemen. Goodput, het aantal requests per seconde dat aan je SLO-doelen voldoet, verbindt de ruwe throughput met wat gebruikers werkelijk ervaren.
6. KV cache: geheugen dat met elke token groeit
Tijdens autoregressieve generatie met volledige attention kijkt elke nieuwe token naar de huidige en voorgaande tokens. De KV cache slaat Key- en Value-projecties op zodat generatie de projecties van eerdere tokens niet bij elke stap herberekent. Decode met volledige attention leest nog steeds een groeiende geschiedenis; het totale attention-werk over een gegenereerde sequentie blijft kwadratisch in de lengte.
Voor een conventionele MHA- of GQA-cache met volledige attention groeit het geheugen lineair met sequentielengte, batchgrootte en aantal lagen. De volgende formule geldt niet ongewijzigd voor MLA-, sliding-window-, recurrente of hybride architecturen:
waarbij:
- = aantal lagen
- = aantal KV-heads
- = head-dimensie
- = sequentielengte
- = batchgrootte
- = bytes per gecachet element, bepaald door de precisie van de KV cache
Concrete voorbeelden met FP16 en batchgrootte 1: Llama 3.1 8B gebruikt bij 8,192 tokens ~1.07 GB (1 GiB) aan KV cache; bij 128K tokens 16 GiB. Llama 3.1 70B heeft bij 128K tokens voor één enkele sequentie 40 GiB nodig (ongeveer 43 GB), bijna de helft van de 80 GB van een H100. Bij hoge concurrency of lange context kan de KV cache het geheugen van de model weights overschrijden; het resultaat hangt af van de sequentielengte, de actieve batchgrootte, de KV-precisie en het aantal KV-heads. De oorspronkelijke vLLM-evaluatie uit 2023 rapporteerde 60–80% verspilling door fragmentatie en pre-allocatie in de vergeleken systemen.
De belangrijkste optimalisaties zijn GQA (minder KV-heads), quantization van de KV cache (FP8/INT8), PagedAttention (blokgebaseerde allocatie) en het offloaden van herbruikbare KV-data naar CPU of NVMe. De voordelen hangen af van workload en implementatie.
Om voor een ander model de vraag “hoeveel sequenties passen in mijn KV-budget?” te beantwoorden, lees je drie getallen uit zijn config.json: num_hidden_layers, num_key_value_heads en head_dim als dat veld aanwezig is. Voor de Llama-voorbeelden is de head-dimensie hidden_size / num_attention_heads. Het geheugen per apparaat hangt ook af van cache-sharding en eventuele replicatie van KV-heads. De onderstaande functie past de formule toe; de asserts reproduceren de getallen hierboven en het capaciteitsvoorbeeld in Sectie 45.
def kv_cache_bytes(layers, kv_heads, head_dim, seq_len, batch=1, bytes_per_elem=2):
    """Bytes of KV cache: a key and a value per layer, KV head, and token."""
    return 2 * layers * kv_heads * head_dim * seq_len * batch * bytes_per_elem

GiB = 2**30

# Llama 3.1 8B: 32 layers, 8 KV heads, head dimension 128, FP16 cache.
llama_8b = kv_cache_bytes(32, 8, 128, seq_len=8_192)
print(f"8B at 8K tokens: {llama_8b / 1e9:.2f} GB")  # 1.07 GB
assert llama_8b == 1 * GiB

# Llama 3.1 70B: 80 layers, 8 KV heads, head dimension 128.
assert kv_cache_bytes(80, 8, 128, seq_len=131_072) == 40 * GiB

# How many 4K-token sequences fit in a 40 GiB KV budget?
per_4k = kv_cache_bytes(80, 8, 128, seq_len=4_096)
print(f"70B at 4K tokens: {per_4k / GiB:.2f} GiB per sequence")  # 1.25 GiB
print("4K sequences in 40 GiB:", 40 * GiB // per_4k)  # 32
assert 40 * GiB // per_4k == 32

# An FP8 KV cache halves the size per sequence and doubles the count.
assert 40 * GiB // kv_cache_bytes(80, 8, 128, 4_096, bytes_per_elem=1) == 64
Het resultaat is een bovengrens. De runtime heeft ook geheugen nodig voor activations, allocator-overhead en speling voor variatie in requestlengte.
7. Prefill versus decode: twee fasen, twee bottlenecks
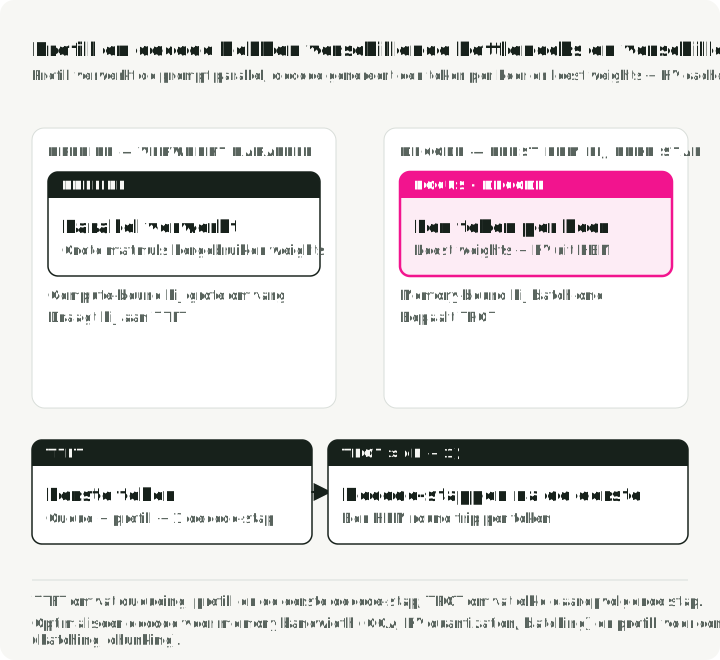
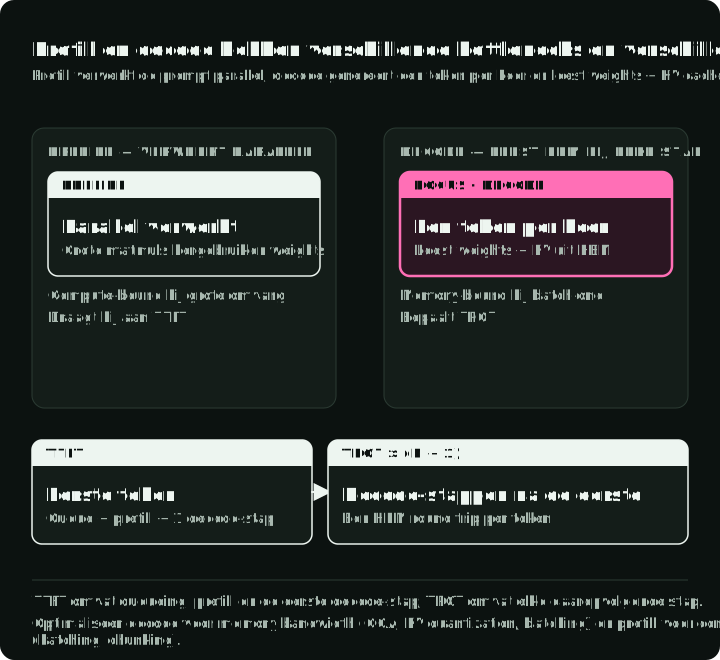
De prefill-fase verwerkt de invoerprompt parallel en vult de KV cache. Lange of voldoende gebatchte prefills worden vaak compute-bound doordat ze grote matrixvermenigvuldigingen gebruiken; korte prefills blijven mogelijk beperkt door geheugenverkeer of kernel-launch-overhead. Prefill draagt bij aan de time to first token (TTFT), naast queueing, tokenization, scheduling en netwerklevering; de forward pass levert ook de eerste output-token op. De decode-fase genereert één token per keer. Elke stap leest de model weights en de KV cache uit HBM, waardoor decode met batchgrootte één wordt beperkt door memory bandwidth en de belangrijkste drijver is van de time per output token (TPOT).
De figuur volgt één request: prefill hergebruikt weights voor verschillende prompt tokens en eindigt met de eerste token, binnen TTFT; elke latere decode-stap leest de weights en KV cache opnieuw voor één token en draagt bij aan TPOT.
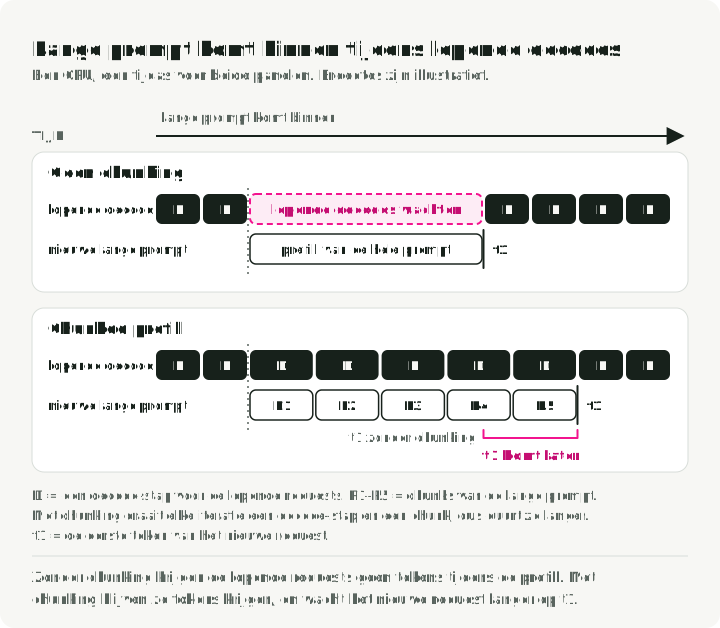
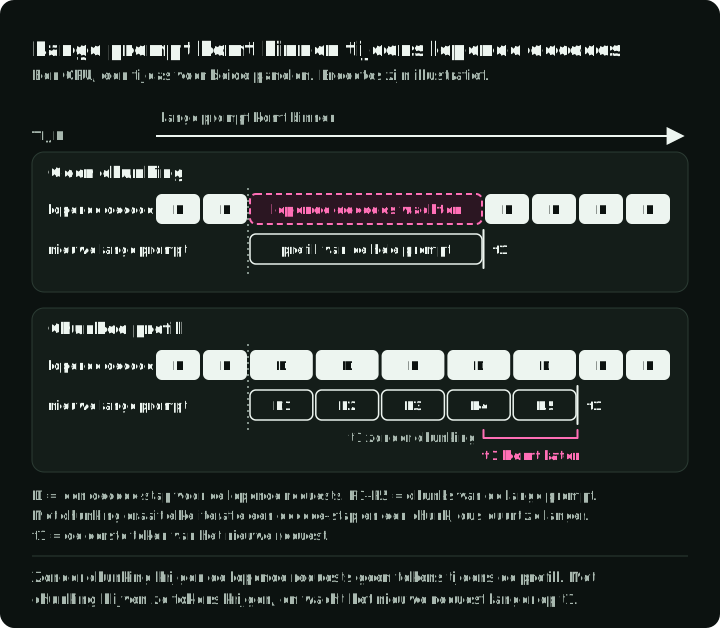
Chunked prefill splitst een lange prompt in chunks en plant ze naast lopende decodes. De werkelijke chunkgrootte kan variëren met het beschikbare token-budget van de iteratie. In Sarathi-Serve (sectie 4.2) en in vLLM zet de scheduler eerst de lopende decodes in de batch en vult de rest van een token-budget per iteratie met prefill-tokens. Een lange prompt houdt de andere requests dan niet meer tegen om tokens te krijgen. Het nieuwe request betaalt hiervoor: de prefill beslaat meerdere iteraties en elke chunk leest de KV cache van de eerdere chunks opnieuw. Sarathi-Serve mat ongeveer 25% extra prefilltijd voor Yi-34B met tensor parallelism van twee en chunks van 512 tokens (sectie 5.4.1), en de vLLM-documentatie stelt dat een kleiner token-budget een betere inter-token latency en een slechtere TTFT geeft. Sarathi-Serve rapporteert betere afwegingen tussen throughput en latency in de geteste workloads, maar de winst hangt af van model, hardware, verdeling van requestlengtes, chunkgrootte en de gekozen baseline.
Disaggregated serving plaatst prefill en decode op aparte GPU-pools, zodat elke pool een ander bottleneck kan aanpakken. Splitwise en DistServe beschrijven het patroon. De prefill-pool stuurt de KV cache van elk request naar de decode-pool. DistServe gebruikt NVLink binnen een node en InfiniBand tussen nodes; Splitwise gebruikt InfiniBand, dat RDMA ondersteunt. De overdrachtskosten worden onderdeel van het ontwerp.
De figuur zet beide schedules op één tijdas: één lange prompt komt binnen terwijl andere requests aan het decoderen zijn. Chunking laat de tokens van de andere requests blijven komen en schuift de eerste token van het nieuwe request later.
8. GQA en MQA: de KV cache verkleinen
Standaard Multi-Head Attention (MHA) geeft elke query-head zijn eigen K- en V-head. Multi-Query Attention (MQA) laat alle query-heads één KV-head delen, een extreme reductie. Grouped-Query Attention (GQA) is de praktische middenweg: groepen query-heads delen één KV-head. De figuur tekent acht query-heads en de KV-heads die elke variant bewaart; de KV cache krimpt evenredig met het aantal KV-heads.
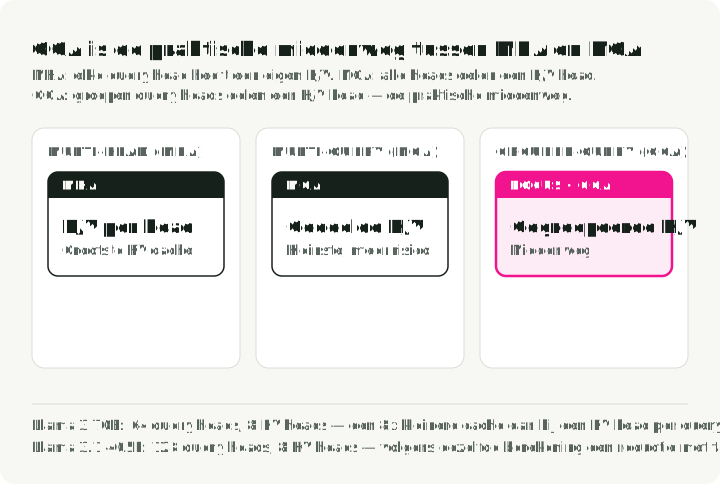
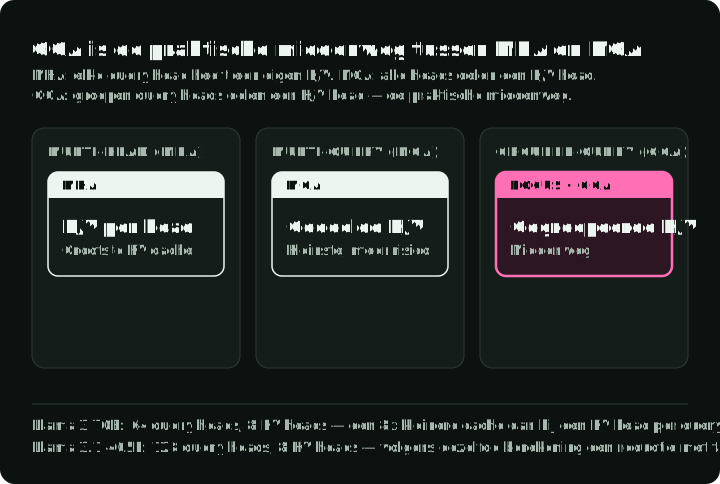
Llama 3 70B gebruikt 64 query-heads maar slechts 8 KV-heads, een 8x kleinere KV cache dan dezelfde architectuur met één KV-head per query-head. Llama 3.1 405B gebruikt 128 query-heads en 8 KV-heads, volgens dezelfde berekening een 16x reductie (Meta, 2024). Ainslie et al. rapporteren een GQA-kwaliteit die in hun geteste models dicht bij MHA ligt, terwijl de snelheid MQA benadert. Een kleinere KV cache kan grotere batches ondersteunen, maar de werkelijke winst in latency en throughput hangt nog steeds af van de kernel en de workload.
9. Quantization: bits inruilen voor snelheid en geheugen
Quantization verlaagt de precisie van model weights en/of activations. De kernafwegingen:
| Formaat | Bits | Weight-geheugen (7B-model) | Kwaliteitsnotitie |
|---|---|---|---|
| FP16/BF16 | 16 | ~14 GB | Baseline voor vergelijking |
| FP8 | 8 | ~7 GB | Hardware-native op Hopper; evalueer het model |
| INT8 | 8 | ~7 GB | Hangt af van calibration en kernel |
| INT4 | 4 | ~3.5 GB | Sterkere compressie; evalueer zorgvuldig |
AWQ (Activation-Aware Weight Quantization) bepaalt aan de hand van activation-groottes welke weight-kanalen belangrijk zijn en past per kanaal schaling toe om ze te beschermen. De calibration-behoefte hangt af van het model en de configuratie; in één OPT-6.7B INT3-g128-vergelijking gebruikte AWQ 16 calibration-sequenties en GPTQ 192. Rapporteer in een reproduceerbare opzet zowel het aantal sequenties als de sequentielengte. GPTQ gebruikt benaderde tweede-orde-informatie voor quantization per laag. bitsandbytes kan quantizen tijdens het laden van het model, zonder aparte preprocessing-stap; het NF4-formaat is de basis van QLoRA-fine-tuning. FP8 op hardware van de Hopper-klasse halveert het weight-geheugen ten opzichte van FP16/BF16, maar kwaliteit en snelheid hangen nog steeds af van het model, de calibration en de kernel.
De tabel koppelt elke methode aan het werk waarvoor ze meestal geschikt is. De guide over model quantization behandelt elke methode uitgebreid.
| Methode | Calibration-data | Typisch gebruik |
|---|---|---|
| AWQ of GPTQ (INT4 weight-only) | Ja, een kleine steekproef | Een groot model serveren op GPU’s met beperkt geheugen via een ondersteunde INT4-kernel |
| bitsandbytes NF4 | Nee | QLoRA-fine-tuning en snelle experimenten |
| FP8 | Kleine steekproef of dynamische schaling | Serving op Hopper of nieuwere GPU’s, met een kwaliteitscheck op de doeltaak |
| INT8 (W8A8) | Ja, voor activation-schalen | GPU’s zonder FP8, zoals A100 of A10G, als de serving-kernel het ondersteunt |
De serving-kernel kan net zo belangrijk zijn als het quantization-algoritme. Sectie 10 geeft een begrensd Marlin-resultaat en legt uit waarom de winst afhangt van de serving-configuratie.
Deel III — Inference-optimalisaties
De optimalisaties in dit deel lossen verschillende beperkingen op. FlashAttention verlaagt het HBM-verkeer van attention; PagedAttention verbetert de KV-allocatie; continuous batching voorkomt dat voltooide sequenties batchcapaciteit vasthouden.
10. CUDA-kernels en kernel fusion
Een CUDA-kernel is een functie die voor de GPU is geschreven en parallel over duizenden threads draait. Wanneer de CPU een kernel aanroept, verdeelt de GPU het werk over zijn SM’s: elke SM draait meerdere warps van 32 threads en elke thread verwerkt een deel van de data. Een CUDA-servingimplementatie voert GPU-werk uit via kernels. Het aantal launches hangt af van de modelgraaf, compiler, runtime en fusion. De kernelimplementatie kan bepalen of het systeem zijn latency-SLO haalt.
De belangrijkste kernelcategorieën in LLM-serving:
- GEMM-kernels voor matrixvermenigvuldiging, die de rekenlast van zowel prefill als decode domineren.
- Attention-kernels zoals FlashAttention, die berekeningen in tiles opdelen zodat ze in SRAM blijven in plaats van naar HBM uit te wijken.
- Fused kernels die meerdere bewerkingen (zoals add + layer norm of QKV-projectie) in één launch combineren, zodat de tussentijdse HBM-round-trips vervallen.
- Sampling-kernels die logits via top-k-, top-p- of temperature-sampling omzetten in token-ID’s.
De kwaliteit van de kernel kan bepalen of gecomprimeerde weights een versnelling opleveren. Het Marlin-paper rapporteert tot 2.8x end-to-end-versnelling ten opzichte van de FP16-baseline voor geteste vLLM-configuraties met weight-only INT4. Dat resultaat geldt voor de models, GPU’s, batchgroottes en serving-opzet van het paper en is dus geen universele INT4-winst.
Triton verlaagt de drempel voor het schrijven van eigen kernels door GPU-programmering via Python aan te bieden in plaats van via kale CUDA C++. Daardoor ligt optimalisatie op kernelniveau binnen bereik van ML-engineers en niet alleen van GPU-specialisten. De meeste optimalisaties verderop in dit deel (FlashAttention, fused kernels, PagedAttention) zijn ofwel betere kernels, ofwel slimmere manieren om kernel-launches te orkestreren.
Kernel fusion voegt opeenvolgende bewerkingen samen tot één GPU-kernel en slaat tussentijdse HBM-writes over. Gangbare fusies zijn QKV-projectie, attention plus softmax en residual addition plus RMSNorm. FlashNorm combineert daarentegen RMSNorm-schaling met de volgende lineaire projectie en stelt normalisatie uit. DeepFusionKernel fuseert een volledige SwiGLU-MLP, inclusief matrixvermenigvuldigingen. De winst in aantal launches en benutting hangt af van de modelgraaf, de compiler, de GPU en het serving framework. Profileer daarom de gedeployde stack in plaats van op een universeel percentage te vertrouwen.
11. FlashAttention: attention tilen zodat het in SRAM leeft
Standaard attention materialiseert de volledige attention-matrix in HBM, wat geheugen kost en veel geheugenverkeer veroorzaakt. Het idee achter FlashAttention is om die matrix nooit te materialiseren. Het verdeelt de Q-, K- en V-matrices in blokken die in SRAM passen, berekent binnen elke tile partiële attention en voegt de resultaten samen met een online softmax (die het lopende maximum en de lopende som over blokken heen bijhoudt). De tussenopslag daalt van naar , met minder HBM-reads en -writes voor de geteste vormen in het paper. Het rekenwerk voor dense attention blijft kwadratisch in de sequentielengte.
Elke versie richt zich op het bottleneck van zijn GPU-generatie:
- FlashAttention v1 (A100, 2022) bewees dat het idee van tiling plus online softmax werkt. Het paper rapporteerde 2–4x versnelling ten opzichte van standaard attention, maar slechts 25–40% GPU-benutting. Het FA2-paper schrijft dit toe aan niet-matmul-werk, shared-memory-communicatie en beperkte parallelisatie.
- FlashAttention v2 (A100, 2023) herwerkte de parallelisatie zodat het werk over de sequentiedimensie wordt verdeeld, naast batch en heads. Het haalde 50–73% benutting op de A100, ruwweg 2x sneller dan v1.
- FlashAttention v3 (H100 Hopper, 2024) voegde warp specialization toe (aparte warps voor datatransport en rekenwerk) en GEMM-softmax-pipelining om geheugenloads te laten overlappen met berekening. Het paper rapporteert tot 740 TFLOPS in FP16 (75% benutting) en bijna 1.2 PFLOPS in FP8 op de H100.
- FlashAttention v4 (B200 Blackwell, 2026) pakt een nieuw bottleneck aan: op Blackwell schaalt de throughput van de tensor cores zo snel dat niet-matmul-bewerkingen (softmax-exponentiëlen, herschaling) de beperkende factor worden. FA4 emuleert de exponentiële functie in software met polynomiale benaderingen op FMA-eenheden, gebruikt voorwaardelijke herschaling om overhead te verminderen en slaat tussenresultaten op in het eigen tensorgeheugen van Blackwell (TMEM) in plaats van in registers. Het paper rapporteert ongeveer 1.6 PFLOPS op de B200 in BF16, 1.3x sneller dan cuDNN 9.13 en 2.7x sneller dan Triton in zijn tests.
12. FlashDecoding: het decode-bottleneck paralleliseren
Standaard FlashAttention houdt de GPU bezig door het werk te verdelen over batchgrootte en querylengte. Tijdens decode genereert het model precies 1 token per keer (querylengte = 1). Als de batchgrootte maal het aantal attention heads ver onder het aantal SM’s van de GPU ligt (108 op een A100), kunnen veel SM’s inactief blijven terwijl de andere de tokengeschiedenis verwerken.
FlashDecoding lost dit op met een nieuwe parallelisatiedimensie: de lengte van de KV-sequentie zelf. Het hakt de KV cache in kleinere chunks en verdeelt die over alle anders ongebruikte GPU-processors om parallel te evalueren, en voegt hun deelberekeningen daarna samen met een log-sum-exp-reductie.
In de CodeLlama-34B-benchmark met batchgrootte één van Stanford, op vier A100-GPU’s met sequentielengtes van 512 tot 64K tokens, haalde FlashDecoding tot 8x end-to-end-versnelling ten opzichte van de geteste baselines en verbeterde het de schaling van attention over de geteste lange contexten. Het resultaat is begrensd tot die hardware en benchmark en is geen algemene garantie voor decode.
13. Continuous batching versus static batching
Static batching wacht tot elke sequentie in een batch klaar is voordat de volgende begint, zodat korte sequenties GPU-cycli verspillen door stil te staan nadat ze end-of-sequence hebben bereikt. Continuous batching (geïntroduceerd in het Orca-paper, OSDI 2022) werkt per iteratie: bij elke decode-stap worden voltooide sequenties verwijderd en nieuwe ingevoegd. De figuur toont vier batchslots over tien decode-stappen onder elk beleid.
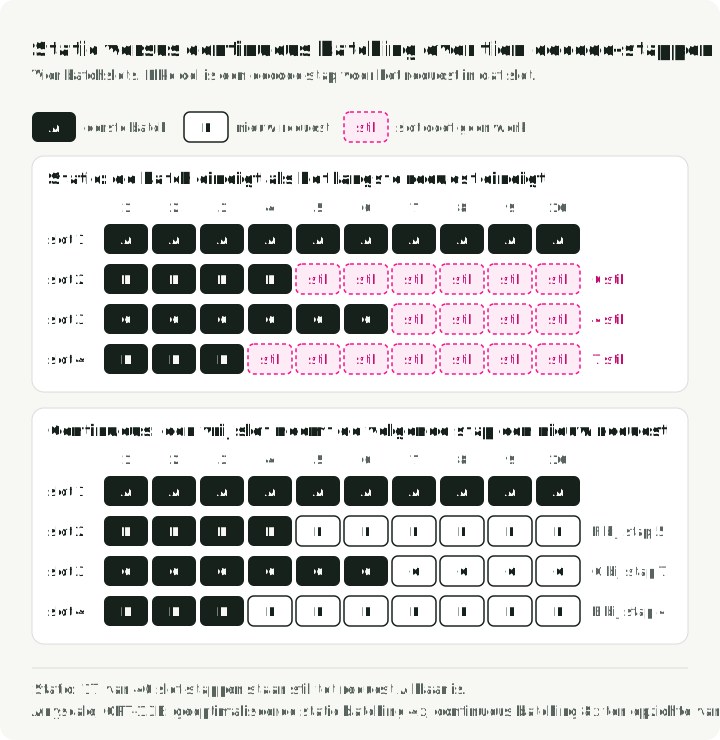
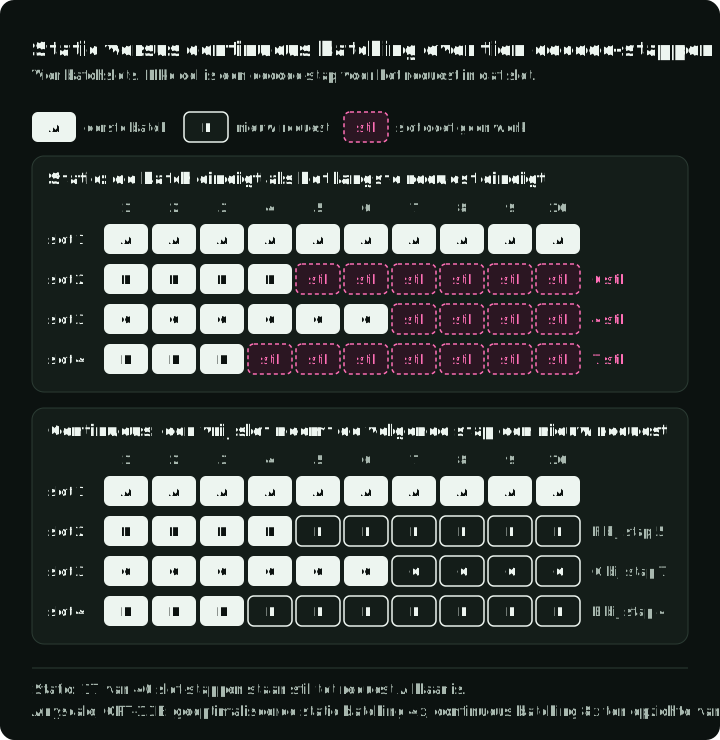
In de OPT-13B-benchmark van Anyscale uit 2023 op een A100-40GB, met 1,000 requests, prompts van 512 tokens en outputs van gemiddeld 128 tokens, bereikte geoptimaliseerde static batching 4x zijn naïeve baseline, continuous batching 8x en vLLM met continuous batching plus PagedAttention 23x (Anyscale, 2023). Continuous batching vergroot ook de druk op de KV-allocatie, en daarom wordt het vaak gecombineerd met gepagineerd geheugenbeheer.
14. PagedAttention: virtual memory voor de KV cache
PagedAttention van vLLM past het idee van virtual memory uit besturingssystemen toe op het beheer van de KV cache. De KV cache wordt verdeeld in blokken van vaste grootte (16 tokens in deze illustratie; blokgroottes verschillen per runtime), blokken worden op aanvraag gealloceerd terwijl tokens worden gegenereerd en logische (opeenvolgende) posities worden via blocktables gekoppeld aan fysieke (verspreide) geheugenlocaties. Meerdere requests met een gedeeld prefix (system prompts, beam search) kunnen naar dezelfde fysieke blokken wijzen. Prefix-hergebruik vereist ook compatibele cachesleutels en een cache-lookupbeleid. De figuur toont een blocktable voor twee requests die een system prompt delen.
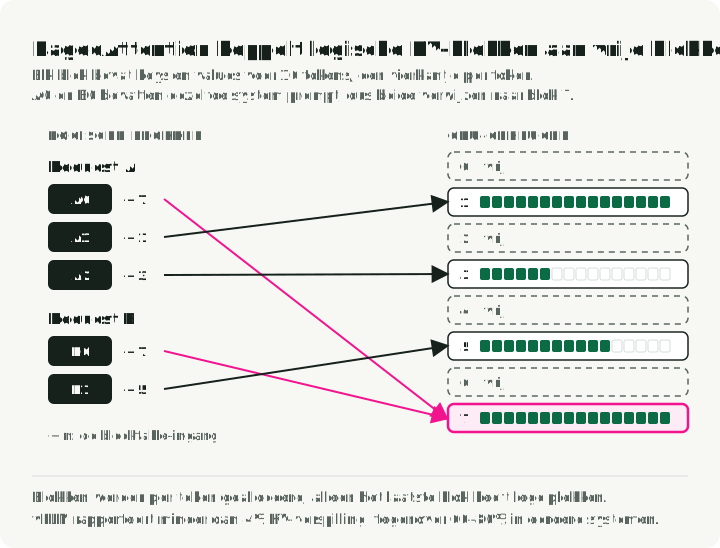
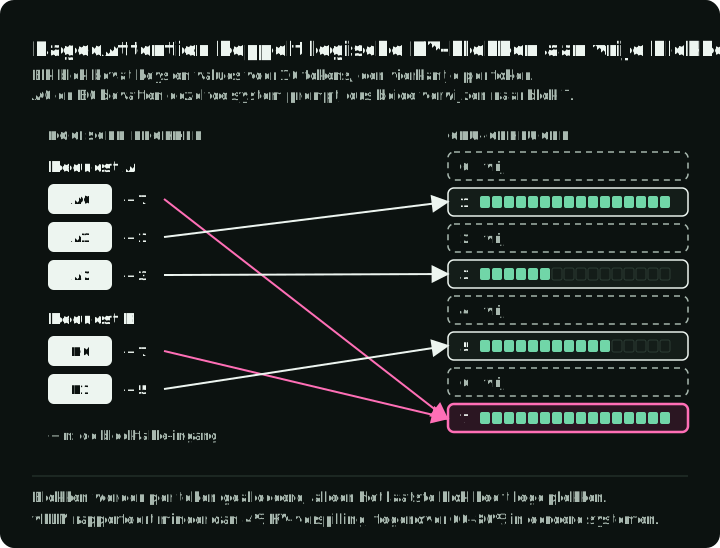
De vLLM-evaluatie uit juni 2023 rapporteerde 60–80% KV-geheugenverspilling in de geteste eerdere systemen en minder dan 4% met de gepagineerde allocator. De throughput lag 2–4x hoger dan bij TGI en in geselecteerde workloads tot 24x hoger dan bij Hugging Face Transformers. Dit zijn historische end-to-end-vergelijkingen van serving systems, geen universele PagedAttention-versnelling of verspillinggrens. Een deels gevuld laatste blok kan bij korte sequenties een groter aandeel verspillen.
15. Speculative decoding: meerdere tokens per forward pass
Bij speculative decoding genereert een klein draft model kandidaat-tokens, waarna het grote target model alle posities in één forward pass scoort. De decoder accepteert draft-tokens van links naar rechts met kansen die zijn afgeleid van de verdelingen van target en draft. Na de eerste afwijzing sampelt hij een correctie uit de residuele target-verdeling en gooit hij de resterende draft-tokens weg. Deze aangepaste rejection-sampling-stap behoudt de outputverdeling van het target model, binnen de numerieke precisie van de hardware; exacte tokenovereenkomst alleen is daarvoor niet genoeg. De figuur werkt één ronde met vier draft-tokens uit.
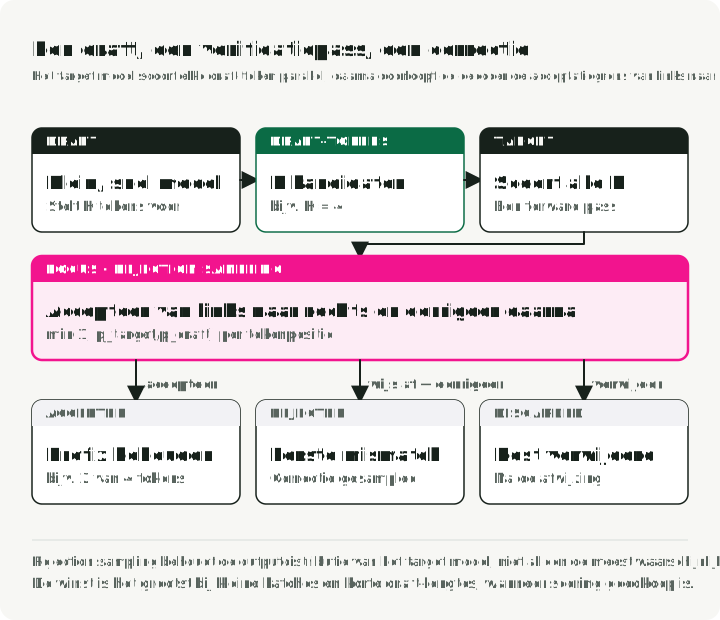
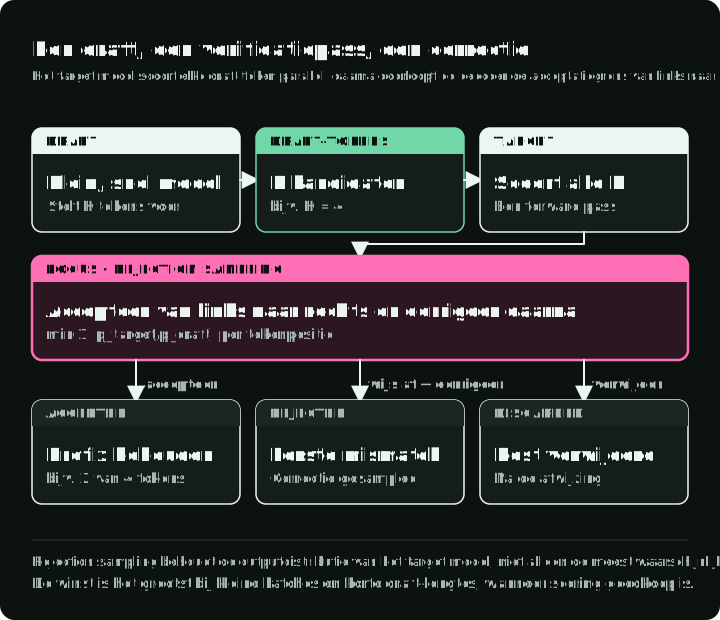
De winst is het meest aannemelijk bij kleine serving-batches en korte draftlengtes, wanneer het scoren van de draft wordt gedomineerd door verkeer van weights, KV cache of communicatie in plaats van door de extra rekenkracht voor tokens. Het oorspronkelijke speculative-sampling-paper rapporteerde een decode-versnelling van 2–2.5x voor zijn geteste Chinchilla-opzet van 70B; EAGLE-3 v3 rapporteerde tot 6.5x in zijn tests. Varianten zijn onder meer Medusa (extra voorspellingskoppen, geen apart model), prompt lookup decoding (n-gram-matching tegen de invoer zonder aparte forward pass van een draft model) en EAGLE. Het oorspronkelijke EAGLE extrapoleert features; EAGLE-3 combineert meerdere feature-niveaus en voorspelt tokens rechtstreeks.
Bij grote batchgroottes kan het extra draft- en verificatiewerk de winst tenietdoen. Speculative decoding is het meest veelbelovend wanneer de serving-batch klein genoeg is en de acceptatie van drafts hoog; benchmark de volledige serving-loop en niet alleen de verificatiekernel.
16. Prefix caching en hergebruik van de KV cache
In plaats van de KV cache weg te gooien wanneer een request klaar is, bewaart prefix caching hem voor hergebruik door nieuwe requests met dezelfde prefix-tokens. Dat bespaart overbodige prefill voor system prompts, few-shot-voorbeelden, RAG-context en de geschiedenis van gesprekken met meerdere beurten.
Automatic Prefix Caching van vLLM hasht KV-blokken en gebruikt een globale hashtabel voor opzoeken. RadixAttention van SGLang onderhoudt een radix tree van gecachete KV-tensors met granulariteit op tokenniveau. Beide vereisen prefixen die token voor token identiek zijn en compatibele cachesleutels. De identiteit van model of adapter, multimodale invoer en isolatie-instellingen kunnen hergebruik ook beïnvloeden. Rapporteer de hitrate naast latency of throughput.
17. Streaming in de praktijk
Streaming stuurt tokens naar de client zodra ze zijn gegenereerd, in plaats van te wachten op het volledige antwoord. Veel serving frameworks bieden het aan via Server-Sent Events: de client opent een langlopende HTTP-verbinding en de server pusht elke token of tokenbatch als data:-event. TTFT bepaalt wanneer de gebruiker voor het eerst output ziet; TPOT bepaalt mede hoe vloeiend het aanvoelt. Stel het doel vast via producttests en het gekozen interactiemodel.
Aan de kant van de client dwingt streaming keuzes over buffering af. Token voor token renderen kan visueel haperen veroorzaken, vooral bij markdown of codeblokken die context van meerdere tokens nodig hebben om goed te worden opgemaakt. Gangbare patronen zijn buffering per woord (tokens verzamelen tot een witruimtegrens), buffering per regel (wachten op een newline voordat je rendert) en adaptieve buffering (prozatekst direct renderen, codeblokken bufferen). In de OpenAI Chat Completions API voegt stream_options: {"include_usage": true} een laatste usage-chunk toe vóór het bericht data: [DONE]. Onderbroken OpenAI-streams kunnen de laatste usage-chunk weglaten. OpenAI-compatibele servers kunnen afwijken, dus controleer de gekozen implementatie.
Chunked prefill is één manier om te voorkomen dat lange prefills de levering van tokens aan gelijktijdige gebruikers vertragen. Scheduling met decode-prioriteit kan lopende requests beschermen, terwijl disaggregated serving prefill en decode isoleert op aparte GPU-pools.
Deel IV — Modelarchitectuur
De architectuur bepaalt de geheugenvoetafdruk, het attention-gedrag en de trainingsdynamiek waar de secties over serving en training omheen werken.
18. Essentiële onderdelen van de transformer-architectuur
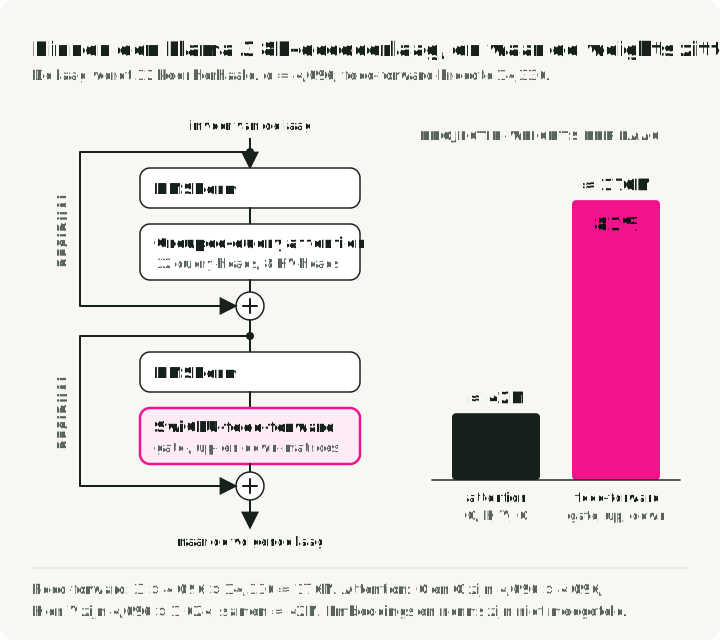
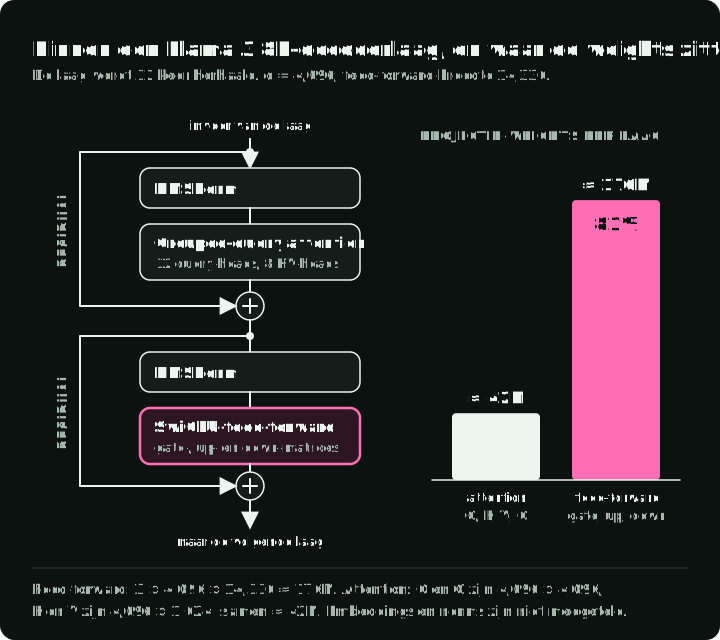
Een moderne decoder-only transformer (GPT, Llama) is een stapel identieke lagen, elk met twee subblokken: attention en feed-forward. Elk subblok is omgeven door een residual connection en normalisatie. De figuur toont één Llama-achtige laag, inclusief de twee paden die een subblok overslaan, en hoe de projectie-weights zich verdelen over attention en het feed-forward-netwerk; de componenten worden eronder beschreven.
De belangrijkste componenten:
Multi-Head Attention laat elke token informatie wegen uit de tokens die onder het attention mask zichtbaar zijn. De invoer wordt geprojecteerd op drie matrices: Queries (waar zoek ik naar?), Keys (wat bevat ik?) en Values (welke informatie draag ik?). De attention-scores worden dan berekend als:
Het inproduct meet de gelijkenis tussen elk paar tokens. Delen door voorkomt dat de inproducten te groot worden (waardoor softmax in gebieden met verdwijnende gradiënten terechtkomt). De softmax zet scores om in kansen en vermenigvuldiging met levert een gewogen combinatie van value-vectoren op. Dit parallel over meerdere heads uitvoeren laat het model tegelijk op verschillende relaties letten (heads kunnen verschillende relaties leren; hun rollen liggen niet vast).
Het Feed-Forward Network (FFN) transformeert elke tokenrepresentatie onafhankelijk, nadat attention informatie over tokens heen heeft gemengd. Moderne LLMs gebruiken vaak SwiGLU in plaats van de oorspronkelijke ReLU-FFN met twee matrices:
SwiGLU heeft drie weight-matrices, tegenover twee voor een ReLU-FFN, en gebruikt de gladde Swish. Llama, Mistral en Qwen gebruiken het; Gemma gebruikt een benaderde GeGLU. De bekende regel van twee derde geldt voor een conventioneel blok met volledige MHA en : de twee FFN-matrices leveren daar ongeveer parameters, tegenover ongeveer voor attention. Het is geen algemene schatting voor SwiGLU/GQA-architecturen. In Llama 3 8B zijn , en acht key/value-heads, waardoor de FFN M parameters per laag heeft, tegenover ongeveer 42M attention-projectieparameters: ongeveer 81% van die projectie-weights, vóór embeddings en normalisatie.
Residual connections tellen de uitvoer van elk subblok bij de invoer op: . Het skip-pad verbetert de propagatie van signaal en gradiënt door diepe stapels.
RMSNorm is gangbaar in moderne LLM-families. LayerNorm centreert opnieuw door het gemiddelde af te trekken en schaalt opnieuw met de standaarddeviatie. RMSNorm slaat het aftrekken van het gemiddelde over en schaalt alleen; het paper rapporteert 7–64% kortere uitvoeringstijd over de geteste models en frameworks, zonder verlies van de gemeten taakprestaties. Pre-norm-plaatsing, waarbij vóór attention of de FFN wordt genormaliseerd, is ook gangbaar omdat die de stabiliteit van gradiënten verbetert.
Schatting van het aantal parameters voor een conventionele decoder met volledige MHA, een FFN met twee matrices van breedte en gedeelde input- en output-embeddings:
waarbij de grootte van het vocabulaire is, de hidden-dimensie en het aantal lagen. De term is de matrix met input-embeddings; de term benadert de attention- en FFN-weights in elke laag. Voor Llama 3 8B (, , ) komt de schatting uit op ongeveer parameters. Het gepubliceerde totaal van 8.03B ligt hoger, omdat de benadering architectuurdetails weglaat, zoals de exacte FFN-breedte en de aparte uitvoerprojectie.
19. Decoder-only-modellen voor general-purpose generatie
De oorspronkelijke Transformer (2017) had zowel een encoder als een decoder. Sindsdien is het vakgebied uiteengevallen in drie architectuurfamilies, en één daarvan werd de standaard voor generatieve AI.
| Familie | Attention | Trainingsdoel | Tegenwoordig gebruikt voor | Voorbeelden |
|---|---|---|---|---|
| Encoder-only | Bidirectioneel | Voorspelling van gemaskeerde tokens | Embeddings, rerankers, classifiers | BERT, RoBERTa |
| Encoder-decoder | Bidirectionele encoder; causale decoder met cross-attention | Sequence to sequence (span corruption, T5) | Vertaling, spraakherkenning | T5, BART, Whisper |
| Decoder-only | Causaal | Voorspelling van de volgende token | Algemene tekstgeneratie, chat, code | GPT, Llama |
Encoder-only-models gebruiken bidirectionele attention: elke token kijkt in beide richtingen naar elke andere token. Dat levert representaties op voor begripstaken. Standaard encoder-only models worden normaal niet als autoregressieve decoders gebruikt; ze vormen vaak de basisarchitectuur voor embedding models, rerankers en lichte classifiers (bijvoorbeeld de op BERT gebaseerde routers in RouteLLM).
Encoder-decoder-models scheiden begrip van generatie. De encoder verwerkt de volledige invoer met bidirectionele attention, waarna de decoder autoregressief output genereert terwijl hij via cross-attention naar de representaties van de encoder kijkt. Dat past bij taken waarbij invoer en uitvoer verschillende reeksen zijn, zoals vertaling en spraakherkenning.
Decoder-only-models zoals GPT, Llama en Mistral gebruiken causale attention: elke token kijkt naar zichzelf en voorgaande tokens. Vier nuttige eigenschappen voor generatie zijn:
- Hergebruik van de KV cache. Bij causale attention kijken eerdere tokens nooit naar latere, dus hun keys en values blijven geldig terwijl nieuwe tokens worden gegenereerd. Eén cache per sequentie groeit door toevoegen (Sectie 6). Een encoder-decoder houdt daarnaast cross-attention-state over de encoder-output bij.
- Training op ruwe tekst. Voorspelling van de volgende token vereist geen gepaarde invoer en uitvoer, dus elk tekstcorpus is trainingsdata.
- Eén herhaald blok. Het model is een stapel identieke decoderlagen, zonder aparte encoderstapel of cross-attention-pad om te bouwen, te sharden en te optimaliseren.
- In-context learning. Instructies, few-shot-voorbeelden en de vraag zijn allemaal tokens in één prefix, dus één model kan een nieuwe taak oppakken op basis van de prompt.
20. Mixture of experts
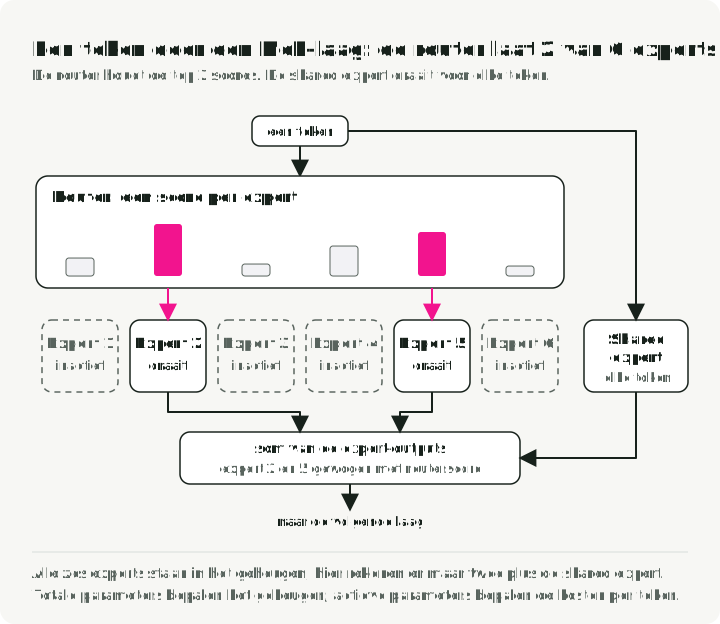
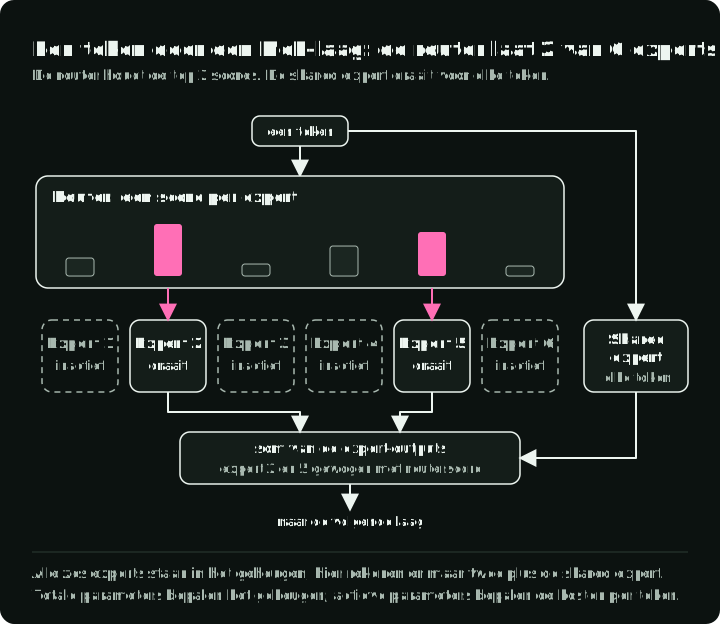
MoE vervangt geselecteerde dense FFN’s door meerdere expert-FFN’s plus een lichte gating router. De router berekent een score voor elke expert (meestal een softmax over geleerde lineaire projecties) en kiest per token de top- experts. Alleen de geactiveerde experts rekenen, dus een model kan een enorme totale capaciteit hebben terwijl de kosten per token laag blijven. Dit is sparse conditional computation. Actieve parameters benaderen het rekenwerk per token, maar alle expert-weights moeten worden opgeslagen. Communicatie, routing, batchbezetting en KV-geheugen beïnvloeden ook de runtime-kosten. De figuur volgt één token door een MoE-laag met zes routed experts en een shared expert.
| Model | Totaal aantal params | Actieve params | Experts (routed + shared) | Top- |
|---|---|---|---|---|
| Mixtral 8x7B | 47B | ~13B | 8 + 0 | 2 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 | 8 |
De shared expert in DeepSeek-V3 wordt voor elke token geactiveerd. Hij levert een basisrepresentatie waarop de routed experts zich kunnen specialiseren.
Het trainen van MoE kent drie terugkerende problemen: load imbalance, expert collapse en communicatie-overhead voor expert parallelism. Traditionele MoE-models voegen een auxiliary loss toe om onevenwichtige routing te bestraffen, maar die loss kan concurreren met de hoofddoelstelling. DeepSeek-V3 gebruikt primair een batchgewijze strategie zonder auxiliary loss: bias-termen buiten backpropagation verlagen de score van overbelaste experts en verhogen die van onderbenutte. Daarnaast past het een extreem kleine aanvullende balansloss per sequentie toe om extreme onbalans binnen een sequentie te voorkomen. Het paper rapporteert in zijn opzet een betere routingbalans zonder de nadelen van de auxiliary loss voor de hoofddoelstelling.
21. Tokenization: BPE, SentencePiece en tiktoken
LLMs zien geen tekst. Ze zien reeksen van gehele token-ID’s. Een tokenizer splitst ruwe tekst in tokens (subwoordstukken) en koppelt elk aan een ID. De keuze van de tokenizer beïnvloedt de modelkwaliteit, de inference-snelheid en de eerlijkheid voor meerdere talen.
Byte Pair Encoding (BPE) is het gangbare algoritme. Het voegt iteratief de meest voorkomende aangrenzende paren in het trainingscorpus samen. Een vereenvoudigd voorbeeld:
- Begin met een vocabulaire op tekenniveau:
[l, o, w, e, r, _] - Het meest voorkomende paar is
(l, o)→ samenvoegen totlo→ vocabulaire:[l, o, w, e, r, _, lo] - Het volgende meest voorkomende paar is
(lo, w)→ samenvoegen totlow→ het vocabulaire krijgtlowerbij - Ga door tot het vocabulaire de doelgrootte bereikt (bijvoorbeeld 128K tokens)
Veelvoorkomende woorden zoals “the” worden enkele tokens, terwijl zeldzame woorden zoals “defenestration” worden gesplitst in subwoordstukken zoals ["def", "en", "est", "ration"] in een verzonnen illustratie. De werkelijke splitsing hangt af van de tokenizer en versie. De afweging is vocabulairegrootte tegenover sequentielengte.
Drie tokenizer-implementaties dekken het meeste productiegebruik:
- SentencePiece traint direct op ruwe Unicode-tekst zonder taalspecifieke pre-tokenizer. Het bewaart witruimte met het meta-symbool
▁en kan optioneel terugvallen op UTF-8-bytetokens. Het ondersteunt zowel BPE- als unigram-models en wordt gebruikt door Llama 1/2, T5 en vroege Mistral-tokenizers. Nieuwere Mistral Tekken-tokenizers gebruiken BPE in tiktoken-stijl. - tiktoken is de op Rust gebaseerde tokenizer van OpenAI met BPE op byteniveau. In zijn gepubliceerde GPT-2-benchmark was hij 3–6x sneller dan de geteste
GPT2TokenizerFast-configuratie. Llama 3 stapte van SentencePiece over op het algoritme van tiktoken. - Hugging Face Tokenizers is een veelgebruikte, op Rust gebaseerde bibliotheek met ondersteuning voor BPE, WordPiece en Unigram.
De grootte van het vocabulaire verschilt sterk tussen modelfamilies:
| Model | Tokenizer | Grootte van het vocabulaire |
|---|---|---|
| GPT-2 | Byte-level BPE | 50,257 |
| Llama 2 | SentencePiece BPE | 32,000 |
| Llama 3 | BPE in tiktoken-stijl | 128,256 |
| GPT-4o | tiktoken o200k_base | ~200K |
Binnen een vergelijkbare tokenizer-trainingsopzet kan een groter vocabulaire minder tokens betekenen voor dezelfde tekst, maar ook een grotere embedding-matrix (de term in Sectie 18).
Fertility meet hoeveel tokens een tokenizer produceert per woord of een andere gekozen teksteenheid. Het varieert met de exacte tokenizer, taal, schrift, normalisatie, domein en steekproef. Meet het op representatief verkeer in plaats van te extrapoleren vanuit één tokenizer of taal.
22. Context windows en positional encodings
Het context window begrenst de reeks tokens die beschikbaar is voor een generatierequest. Chunked prefill en gecachete decode verwerken per pass slechts een deel van die reeks. APIs kunnen ook aparte input- en output-limieten instellen. Gepubliceerde limieten zijn onder meer:
| Model | Gepubliceerde tokenlimiet | Jaar |
|---|---|---|
| Llama 1 | 2,048 | 2023 |
| Llama 3.1 | 128K | 2024 |
| GPT-4.1 | 1,047,576 | 2025 |
| Gemini 2.5 Pro | 1,048,576 input | 2025 |
GPT-4.1 beperkt de output ook tot 32,768 tokens; Gemini 2.5 Pro tot 65,536. De Gemini-rij geeft een input-limiet, terwijl GPT-4.1 een context window geeft; die velden zijn dus niet gelijk.
Attention vergelijkt elk paar zichtbare tokens, maar niets in die vergelijking zegt hoe ver ze uit elkaar liggen. Zonder positie-informatie kan volledige self-attention verschillende woordvolgordes met dezelfde tokens niet onderscheiden; de states per token volgen de permutatie van de input. Het causale mask van een decoder geeft enig ordesignaal, omdat elke token alleen zijn prefix ziet, maar geeft geen expliciete relatieve posities. Positional encodings voegen positie en relatieve afstand expliciet toe.
Drie gangbare aanpakken zijn:
-
RoPE (Rotary Position Embeddings) roteert query- en key-vectoren met hoeken die van de positie afhangen, zodat hun inproduct afhangt van de relatieve positie. De inhoud van de token bepaalt nog steeds de attention-score; RoPE voegt positie-informatie toe zonder geleerde embeddings voor absolute posities. Het wordt gebruikt door open modelfamilies, waaronder Llama, Mistral en Qwen.
-
ALiBi (Attention with Linear Biases) laat aanpassingen van embeddings achterwege en telt een straf direct op bij de attention-scores: hoe verder twee tokens uit elkaar liggen, hoe groter de negatieve bias. Het heeft geen geleerde positionele parameters. In het oorspronkelijke paper presteerde een 1.3B-model dat met sequenties van 1,024 tokens was getraind bij 2,048 tokens vergelijkbaar met een sinusoïdaal-positiemodel dat op 2,048 was getraind. Gedrag buiten de geteste models en lengtes van het paper is modelafhankelijk.
-
YaRN (Yet another RoPE extensioN) breidt een RoPE-model uit voorbij zijn trainingscontext. Het groepeert frequentiedimensies in drie categorieën en schaalt elke categorie anders. In de vergelijking met dezelfde trainingsprocedure en positie-interpolatie gebruikte YaRN 400 in plaats van 1,000 trainingsstappen (Appendix B.2). De bredere claim van 10x minder data in de abstract gebruikt een andere vergelijking.
Deel V — Training en alignment
Dit deel maakt onderscheid tussen het doel dat capaciteiten creëert, de technieken waarmee training op beschikbare hardware past en de methoden die het gedrag van een model daarna vormen.
23. Pretraining, fine-tuning en alignment
Pretraining voor een autoregressief LLM gebruikt self-supervised voorspelling van de volgende token op een groot corpus. Encoder-models kunnen andere doelen gebruiken, zoals voorspelling van gemaskeerde tokens. De rekenkracht daarvoor beslaat vele ordes van grootte; Llama 3 405B gebruikte bijvoorbeeld FLOPs. Supervised fine-tuning (SFT) past het voorgetrainde model aan op taakspecifieke gelabelde data. RLHF / RLAIF gebruikt voorkeursdata om gedrag te vormen: een conventionele RLHF-pipeline verzamelt vergelijkingen, traint een reward model en optimaliseert daarna de policy. RLAIF vervangt een deel van de menselijke oordelen door AI-gegenereerde feedback. Sectie 31 behandelt distillation, een apart pad waarin een uitgelijnde teacher trainingsdata genereert voor een kleinere student.
De benodigde rekenkracht hangt af van modelgrootte, sequentielengte, datavolume, optimizer en methode. PPO heeft ook meer model state nodig dan SFT, omdat een typische opzet een policy-, reference-, reward- en critic-model bevat. Het volledige beslissingskader voor fine-tuning heb ik behandeld in de LLM Fine-Tuning Guide.
24. LoRA en QLoRA: parameter-efficiënte fine-tuning
LoRA bevriest de voorgetrainde weights en voegt trainbare lage-rang-matrices () en () toe, zodat de bijgewerkte weight is. Het LoRA-paper bracht GPT-3 175B in zijn opzet terug tot ongeveer 18 miljoen trainbare parameters. De rang is een tuning-parameter en geen regel voor taakcomplexiteit; kies hem met een sweep over kwaliteit en geheugen. LoRA-adapters kunnen na de training worden samengevoegd met de basis-weights, zodat tijdens inference geen apart adapterpad nodig is.
QLoRA laadt het basismodel met 4-bit NF4-quantization terwijl LoRA-adapters in BF16 worden getraind. NormalFloat4 plaatst meer quantization-niveaus rond nul, waar de dichtheid van weights het hoogst is. Het paper fine-tunede een 65B-model op één GPU van 48 GB en rapporteerde resultaten die dicht bij zijn 16-bit-baselines lagen. De afwegingen in runtime en geheugen gelden alleen voor de geteste stack.
25. Mixed-precision training
Elk floating-point-formaat verdeelt zijn bits over drie velden: teken (altijd 1 bit), exponent (bepaalt het dynamisch bereik) en mantisse (bepaalt de precisie). Meer exponentbits betekent een breder bereik aan representeerbare groottes; meer mantissebits betekent fijnere verschillen tussen naburige waarden. Integerformaten hebben helemaal geen exponent en representeren alleen gelijkmatig verdeelde gehele getallen binnen een vast bereik.
| Formaat | Bits | Indeling (S / E / M) | Bereik | Precisie | Gangbaar gebruik |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ~7 decimale cijfers | Master weights, optimizer states (momentum en variantie van Adam) | |
| BF16 | 16 | 1 / 8 / 7 | ~2 decimale cijfers | Voorkeursformaat voor training; zelfde bereik als FP32 en meestal geen loss scaling | |
| FP16 | 16 | 1 / 5 / 10 | ~3 decimale cijfers | Training met loss scaling (oudere GPU’s); inference op hardware van vóór Hopper | |
| FP8 E4M3 | 8 | 1 / 4 / 3 | ~1 decimaal cijfer | Forward pass op Hopper (H100) — meer precisie voor weights en activations | |
| FP8 E5M2 | 8 | 1 / 5 / 2 | ~0.6 decimaal cijfer | Backward pass op Hopper — breder bereik voor gradiënten | |
| INT8 | 8 | geheel getal met teken | tot | Exacte gehele getallen | Post-training weight quantization voor inference (W8A8); quantization van de KV cache |
| INT4 | 4 | geheel getal met teken | tot | Exacte gehele getallen | Agressieve weight-only quantization (AWQ, GPTQ) voor inference op hardware met beperkt geheugen |
BF16 heeft hetzelfde bereik als FP32 omdat het bereik door het exponentveld wordt bepaald en BF16 alle 8 exponentbits van FP32 behoudt. Het offert in plaats daarvan mantissebits op (7 tegenover 23), en ruilt precisie in voor een 2x lager geheugengebruik, terwijl veel bereikproblemen van FP16-training worden vermeden. FP16 heeft slechts 5 exponentbits, wat het eindige bereik beperkt tot ongeveer 65K. Veel gradiënten zijn juist te klein voor FP16 en lopen onder naar nul. Loss scaling vermenigvuldigt de loss vóór backpropagation, zodat die gradiënten representeerbaar blijven, en schaalt ze vóór de optimizer-stap weer terug; dynamische schaling verlaagt de factor als er overflow optreedt. Het bredere exponentbereik van BF16 maakt dit meestal onnodig.
Integerformaten zijn ongebruikelijk voor de hoofdrekenkunde van training, omdat backpropagation een breed dynamisch bereik nodig heeft. Ze worden veel gebruikt voor inference, waar bevroren weights kunnen worden afgebeeld op gecalibreerde schalen. INT4 weight quantization brengt een 7B-model terug van ongeveer 14 GB naar 3.5 GB vóór runtime-overhead; de kwaliteit moet worden gemeten voor het gekozen model en de gekozen methode.
FP8-training op de H100 via Transformer Engine gebruikt E4M3 waar precisie telt en E5M2 waar een breder bereik telt. Het FP8-LM-paper rapporteert dat zijn mixed-precision framework GPT-175B 75% sneller trainde dan de BF16-Megatron-LM-baseline en 37% sneller dan NVIDIA Transformer Engine in de geteste H100-opzet. DeepSeek-V3 gebruikte FP8 mixed precision en rapporteerde ongeveer $5.6 miljoen aan rekenkracht tegen huurprijs voor de laatste trainingsrun, exclusief R&D en infrastructuur.
26. Gradient checkpointing
Elke laag van de forward pass levert een tussenresultaat op, een activation:
Normaal moeten alle activations in het geheugen blijven, omdat backpropagation ze nodig heeft om gradiënten te berekenen. Bij een diepe transformer kunnen de opgeslagen activations meer geheugen innemen dan de model weights zelf.
Gradient checkpointing ruilt rekenkracht in voor geheugen door de meeste van die activations weg te gooien en ze tijdens backprop on the fly opnieuw te berekenen. De standaardstrategie (Chen et al., 2016) verdeelt een netwerk van lagen in gelijkmatig verdeelde segmenten en slaat alleen de grensactivation van elk segment op. Die opgeslagen grenzen zijn de “checkpoints”. Alle tussenliggende activations binnen een segment worden direct weggegooid.
Wanneer de backward pass een laag binnen een segment bereikt, worden de activations ervan opnieuw berekend vanaf de dichtstbijzijnde checkpoint. Bij de gelijkmatig gesegmenteerde strategie daalt het geheugen voor opgeslagen activations van naar . Elk segment wordt één keer opnieuw berekend, wat per trainingsstap ongeveer één extra forward pass kost (Chen et al., 2016). De werkelijke geheugenbesparing en de herberekeningsoverhead hangen af van het model, de checkpoint-grenzen, de sequentielengte, het framework en de implementatie; meet beide dus op de doel-trainingsrun. FlashAttention past hetzelfde principe toe binnen attention door de volledige attention-matrix niet te materialiseren. Schakel het voor gewone Hugging Face Trainer-runs in met gradient_checkpointing=True. Gebruik bij FSDP de activation-checkpointing-integratie van het framework waar die wordt ondersteund; de generieke optie kan redundante all-gathers tijdens de backward pass veroorzaken.
27. DeepSpeed ZeRO-stadia
Bij standaard data parallelism heeft elke GPU een volledige kopie van de model weights, gradiënten en optimizer states. Bij Adam kost elke parameter 2 bytes voor de FP16-weight + 4 bytes voor de FP32 master weight + 4 bytes voor momentum + 4 bytes voor variantie + 2 bytes voor de gradiënt, samen 16 bytes per parameter. Een model met 7.5B parameters heeft ~120 GB per GPU nodig en elke GPU slaat hetzelfde op. Op 64 GPU’s zijn dat 64 identieke kopieën van 120 GB.
DeepSpeed ZeRO (Zero Redundancy Optimizer) haalt deze duplicatie weg door deze componenten over GPU’s te sharden in plaats van te repliceren:
- Stage 1 — optimizer states partitioneren. Elke GPU slaat slechts 1/N van de optimizer states op (de FP32 master weights plus de eerste en tweede momenten van Adam, 12 bytes/param). Wanneer een GPU een weight moet bijwerken, werkt hij alleen zijn eigen deel bij en broadcast hij het resultaat. Onder de aannames hieronder daalt het geheugen van ~120 GB naar ~41.3 GB per GPU.
- Stage 2 — ook gradiënten partitioneren. Gradiënten (2 bytes/param) worden niet meer met all-reduce naar elke GPU gestuurd. Elke GPU ontvangt via reduce-scatter alleen het gradiëntdeel dat hij nodig heeft. Onder dezelfde aannames daalt het geheugen naar ~28.1 GB per GPU.
- Stage 3 — ook de model weights partitioneren. Elke GPU bewaart slechts 1/N van de FP16-weights. Vóór de forward of backward pass van elke laag roept de GPU all-gather aan om de volledige weights van die laag tijdelijk te reconstrueren uit alle andere GPU’s, rekent hij en gooit hij de verzamelde weights weg. Onder dezelfde aannames daalt het geheugen naar ~15.0 GB per GPU.
De figuur tekent de model state per GPU in elk stadium op schaal, met de communicatiekosten van elk stadium.
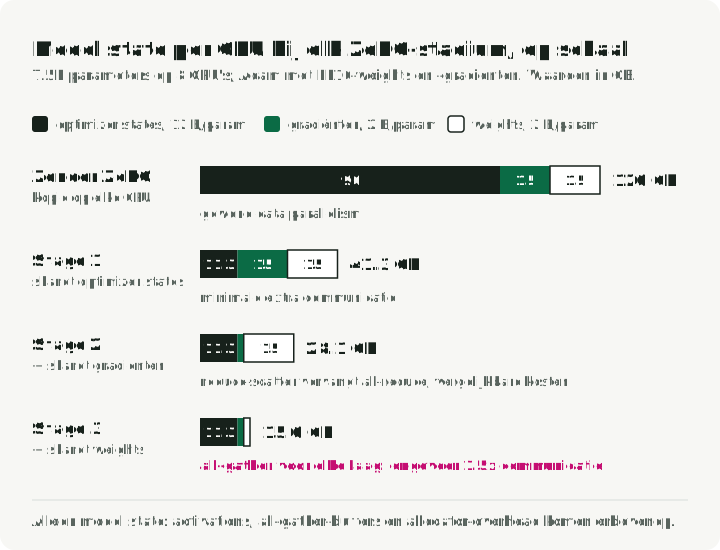
Dit zijn benaderde waarden voor de model state van een model met 7.5B parameters op 8 GPU’s (world size ), met FP16-weights en -gradiënten en FP32 master weights, momentum en variantie van Adam. Ze sluiten activations, tijdelijke all-gather-buffers, allocator-fragmentatie en overhead van framework en runtime uit. De grens van de berekening is bytes per parameter, waarbij elke state alleen in de stadia die hem sharden door wordt gedeeld.
Zo herhaal je de berekening voor een andere modelgrootte of een ander aantal GPU’s:
def zero_model_state_gb(params_b, n_gpus, stage):
    """Model-state GB per GPU for Adam with FP16 weights and gradients.

    Optimizer states (FP32 master weights, momentum, variance) take 12 bytes
    per parameter, gradients 2, and weights 2. Stage 1 shards the optimizer
    states, stage 2 also the gradients, and stage 3 also the weights.
    """
    optimizer, gradients, weights = 12, 2, 2
    if stage >= 1:
        optimizer /= n_gpus
    if stage >= 2:
        gradients /= n_gpus
    if stage >= 3:
        weights /= n_gpus
    return params_b * (optimizer + gradients + weights)

for stage in range(4):
    print(f"stage {stage}: {zero_model_state_gb(7.5, 8, stage):g} GB per GPU")

assert [zero_model_state_gb(7.5, 8, s) for s in range(4)] == [120.0, 41.25, 28.125, 15.0]
# 70B parameters: Stage 3 on 8 GPUs still needs 140 GB of model state per GPU;
# 16 GPUs bring it to 70 GB, before activations.
assert zero_model_state_gb(70, 8, 3) == 140.0
assert zero_model_state_gb(70, 16, 3) == 70.0
De afweging is communicatie. Stage 1 voegt minimale overhead toe en Stage 2 vervangt all-reduce door reduce-scatter tegen vergelijkbare kosten. Stage 3 heeft all-gather-aanroepen nodig vóór elke laag, zowel in de forward als in de backward pass, ruwweg 1.5x het communicatievolume van standaard data parallelism.
ZeRO-Infinity breidt Stage 3 uit door gepartitioneerde states te offloaden naar CPU-RAM en zelfs naar NVMe-SSD’s, waardoor het trainen van models met biljoenen parameters op beperkte GPU-clusters mogelijk kan worden. Offloaden naar opslag voegt PCIe- en opslagoverdrachtskosten toe; de gemeten impact hangt af van de schijf, de PCIe-topologie, de partitionering, prefetching, overlap van overdrachten en de workload. Gebruik het om aan capaciteitseisen te voldoen en ga niet uit van een vaste vertraging; profileer de doelconfiguratie.
28. FSDP: PyTorch-native sharding
Fully Sharded Data Parallel (FSDP) is het ingebouwde antwoord van PyTorch op DeepSpeed ZeRO-3. Het shardt parameters, gradiënten en optimizer states over GPU’s met hetzelfde kernidee. Met volledige sharding en resharding ingeschakeld zijn de bewerkingen per gewrapte unit:
- All-gather de volledige parameters van alle GPU’s (de complete laag tijdelijk reconstrueren).
- Reken de forward of backward pass voor die laag.
- Geef de verzamelde parameters direct vrij. Elke GPU houdt alleen zijn eigen shard.
- Reduce-scatter de gradiënten, zodat elke GPU alleen zijn toegewezen gradiëntdeel krijgt.
Doordat FSDP native is voor PyTorch, integreert het direct met de debugtools en profilers van PyTorch en met torch.compile. De prestaties ten opzichte van DeepSpeed ZeRO-3 hangen af van wrapping policy, communicatietopologie, offload-instellingen en modelgrootte; vergelijk ze dus op hetzelfde cluster.
| Criterium | FSDP (PyTorch) | DeepSpeed ZeRO |
|---|---|---|
| Stijl van controle | Volledige sharding via PyTorch-API’s | Selecteerbare ZeRO-stadia |
| Offloading | CPU-offloading | CPU + NVMe met ZeRO-Infinity |
| Framework-integratie | Native PyTorch, torch.compile-paden | Aparte bibliotheek en configuratiesysteem |
| Selectietest | Profileer de doel-PyTorch-workload | Profileer de vereiste features en offload |
FSDP2 (2024–2025) is een herschrijving die de integratie met torch.compile verbetert voor betere kernel fusion, ondersteuning voor FP8-training toevoegt via TorchAO en de API vereenvoudigt. Zowel FSDP als DeepSpeed zijn beschikbaar via Hugging Face Accelerate, dat beide via configuratie ondersteunt voor compatibele, voorbereide trainingsscripts. De vereiste wrapping-, checkpointing- en offload-instellingen verschillen nog steeds.
29. Scaling laws en inference-kosten
Chinchilla scaling (DeepMind, 2022) vond onder zijn aannames een compute-optimale verdeling van ongeveer 20 trainingstokens per parameter. Dat doel omvat niet de latere serving-kosten. Als een kleiner model dat op meer data is getraind de vereiste kwaliteit haalt, kan het over een inference-levenscyclus met hoog volume goedkoper zijn.
Eén strategie voor de kosten over de hele levenscyclus is een kleiner model op veel meer data trainen:
| Model | Params | Trainingstokens | Tokens/param | Tokens/param ÷ 20 (afgeleid) |
|---|---|---|---|---|
| Chinchilla | 70B | 1.4T | 20:1 | 1× |
| Llama 1 | 65B | 1.4T | 22:1 | 1× |
| Llama 2 | 70B | 2.0T | 29:1 | 1.4× |
| Llama 3 8B | 8B | 15T | 1,875:1 | 94× |
| Qwen3-0.6B | 0.6B | 36T | 60,000:1 | 3,000× |
Dit is de getoonde verhouding tussen tokens en parameters gedeeld door het benaderde punt van 20 tokens per parameter uit het Chinchilla-paper. Het is een beschrijvende verhouding en geen gemeten vermenigvuldiger voor kwaliteit of kosten.
Voor een model dat met hoog volume wordt geserveerd, kan meer trainingsrekenkracht in een kleiner model de kosten over de levenscyclus verlagen. Llama 3 8B illustreert de strategie, maar of ze loont, hangt af van de vereiste kwaliteit en het verwachte inference-volume. “Chinchilla-optimal” verwijst naar efficiëntie van trainingsrekenkracht, een ander doel dan kosten over de levenscyclus.
30. RLHF, DPO, GRPO en het alignment-landschap
Alignment stuurt een voorgetraind model naar gewenste instructies, voorkeuren en veiligheidsregels. Het garandeert op zichzelf geen waarheidsgetrouwheid of veilig gedrag. De methoden hieronder wegen implementatiecomplexiteit, vereiste data, exploratie en trainingsstabiliteit anders af.
De klassieke RLHF-pipeline: SFT → menselijke voorkeursparen verzamelen → een reward model op die paren trainen → de policy fine-tunen met PPO (Proximal Policy Optimization). Een conventionele PPO-opzet heeft vier modelrollen: policy, reference, critic/value model en reward model. Het geheugengebruik hangt af van sharing, sharding, precisie, offload en plaatsing; vier rollen betekenen geen vier volledige GPU-residente kopieën. PPO is ook gevoelig voor hyperparameters. Het is ook gevoelig voor reward hacking, waarbij het model eigenaardigheden van het reward model uitbuit, zoals uitgebreide, zelfverzekerd klinkende antwoorden, in plaats van echt de kwaliteit te verbeteren.
DPO (Direct Preference Optimization) slaat het geleerde reward model en de online RL-loop over door direct een loss op voorkeursparen te optimaliseren. Dat vereenvoudigt de trainingspipeline. Standaard DPO is offline: het traint op een vaste dataset en verkent tijdens de update-loop geen nieuwe antwoorden. Of die beperking ertoe doet, hangt af van de taak en de dekking van de data.
GRPO (Group Relative Policy Optimization, DeepSeek) haalt de geleerde critic van PPO weg door per prompt meerdere completions te genereren en groepsrelatieve beloningen als baseline te gebruiken. Dat verlaagt de last aan model state ten opzichte van een typische PPO-opzet. In tegenstelling tot DPO is GRPO on-policy: het model genereert tijdens de training nieuwe antwoorden. DeepSeek-R1 combineert GRPO met RLVR (reinforcement learning from verifiable rewards), met controles zoals wiskundige antwoorden, het compileren van code en unit tests. Deze beloningen zijn makkelijker te auditen dan een geleerde voorkeursscore, maar onvolledige tests en proxydoelen kunnen nog steeds worden uitgebuit.
| Methode | Modelrollen in een conventionele opzet | Beloningssignaal | Online/offline | Belangrijkste beperking |
|---|---|---|---|---|
| PPO | Policy, reference, critic, reward | Geleerd reward model | Online | Reward hacking, complexe tuning |
| DPO | Policy plus reference-scores, die vooraf berekend kunnen worden | Impliciet (voorkeursparen) | Offline | Geen exploratie, vaste data |
| GRPO | Policy; optionele reference voor KL en optionele geleerde reward | Expliciet (regel/verifier of geleerd) | Online | Hangt af van de kwaliteit van de beloning en informatieve variatie binnen de groep |
De reference-policy in GRPO hangt af van de implementatie. Zo laadt TRL GRPOTrainer geen reference-model als de KL-coëfficiënt beta nul is. Neem modelplaatsing en precisie mee bij een vergelijking van trainingsgeheugen.
31. Distillation: kennis comprimeren over models heen
Knowledge distillation draagt capaciteiten over van een grote teacher naar een kleinere student. Distillation op basis van logits traint de student om de outputverdeling van de teacher na te bootsen. Distillation op basis van data laat de teacher voorbeelden genereren waarop de student wordt gefinetuned. Methoden op basis van data zijn gangbaar voor LLMs omdat ze over architecturen heen en met teachers die alleen via een API beschikbaar zijn kunnen werken, maar hun waarde wordt begrensd door de kwaliteit van de teacher, de dekking van de data, filtering en de kosten van generatie.
DeepSeek-R1 stelde een mix van ongeveer 800,000 voorbeelden samen — ongeveer 600,000 samples gerelateerd aan reasoning en 200,000 zonder reasoning — en gebruikte die om Qwen2.5- en Llama 3-models van 1.5B tot 70B parameters te distilleren. In de evaluatie van het paper:
- DeepSeek-R1-Distill-Qwen-32B scoort 72.6% op AIME 2024 en 94.3% op MATH-500, hoger dan de gerapporteerde cijfers van OpenAI o1-mini in het paper.
- DeepSeek-R1-Distill-Qwen-7B scoort 55.5% op AIME 2024, hoger dan het resultaat van QwQ-32B-Preview in het paper, met een kleiner model.
In de experimenten van DeepSeek-R1 met kleine models deed distillation het beter dan directe GRPO op de geteste basismodels. Dat resultaat ondersteunt distillation voor deze opzet; het stelt geen universele rangorde tussen distillation en RL vast.
32. Generatie van synthetische data
Door LLMs gegenereerde trainingsdata wordt in een aantal terugkerende patronen gebruikt:
- Self-Instruct start met een kleine seed-set van door mensen geschreven instructies: de LLM genereert nieuwe instructies, invoer en uitvoer, die worden gefilterd en weer aan de pool worden toegevoegd. Het Alpaca-project gebruikte 52,000 voorbeelden die uit 175 seeds waren gegenereerd. Stanford rapporteerde minder dan $500 voor het genereren van data en minder dan $100 voor fine-tuning, wat de kosten van de eerste reproductie onder $600 brengt; de vergelijking met GPT-3.5 was een beperkte projectevaluatie en geen brede gelijkwaardigheid.
- Evol-Instruct (WizardLM) neemt bestaande instructies en laat ze iteratief evolueren langs complexiteitsassen (beperkingen toevoegen, reasoning verdiepen, problemen concreter maken) om steeds moeilijkere trainingsvoorbeelden te produceren.
- Phi-4 (14B) van Microsoft gebruikte synthetische data voor een groot deel van de pretraining, onder meer via generatie, kritiek, zelfrevisie en omkering van instructies. Het technische rapport vergelijkt de STEM- en codeprestaties van het resulterende model op geselecteerde benchmarks met die van grotere models.
Een risico is model collapse bij recursieve vervanging van echte data door gegenereerde data. In de onderzochte opzetten verdwijnen zeldzame delen van de oorspronkelijke verdeling geleidelijk (Shumailov et al., gepubliceerd in Nature in 2024). Dit is geen onvermijdelijk resultaat van elk gebruik van synthetische data. Een afzonderlijke accumulatiestudie vond ander gedrag wanneer echte en gegenereerde data over generaties behouden bleven. Een afzonderlijke classifier-studie van Ahrefs nam in april 2025 uit 900,000 pagina’s per domein één nieuw gedetecteerde Engelse pagina als steekproef en classificeerde 74.2% als pagina met enige AI-gegenereerde tekst. Die studie van een leverancier is geen telling van het hele web. Mitigatie begint met het mengen van synthetische en echte data, filtering en lineage tracking, zodat recursief gegenereerd materiaal gemeten kan worden.
Deel VI — Schalen en deployment
Wanneer een workload op één apparaat niet meer past of zijn SLO niet haalt, gaan de keuzes over hoe je het werk verdeelt, welke runtime de benodigde controls biedt en of elk request hetzelfde model nodig heeft.
33. Vier vormen van parallelism
De vier vormen verschillen in welk deel van het model elke GPU bewaart en in wat er over de verbinding tussen GPU’s gaat. De figuur toont elke vorm op twee GPU’s.
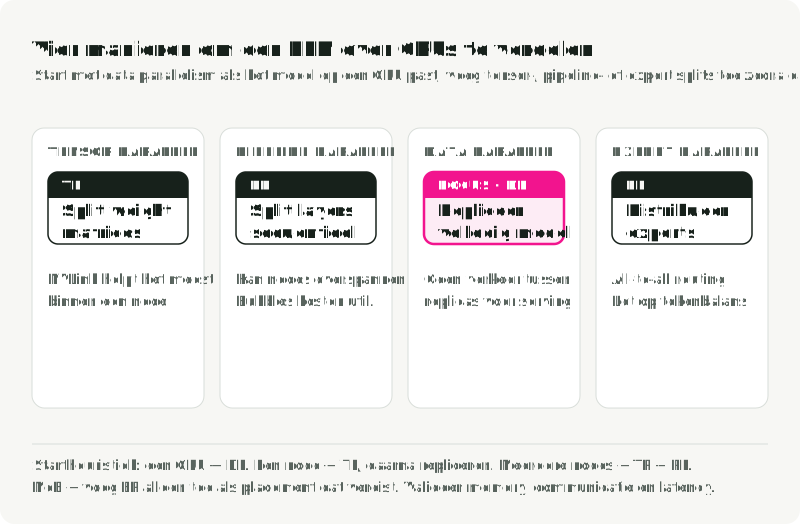
Tensor Parallelism (TP) splitst individuele weight-matrices over GPU’s en communiceert meestal na elke laag. Snelle interconnects binnen een node, zoals NVLink, maken het het praktischst binnen één node. Meer shards verminderen het geheugen en de rekenlast per apparaat maar verhogen de communicatie; kies de graad dus met een latency-benchmark.
Pipeline Parallelism (PP) splitst lagen sequentieel over GPU’s en geeft activations door tussen de stadia. Het communicatiepatroon kan over nodes heen werken, maar pipeline bubbles en ongelijke stadiumtijden verlagen de benutting. Grote deployments combineren vaak TP binnen een node en PP tussen nodes.
Data Parallelism (DP) repliceert het serving-model, zodat elke replica onafhankelijke requests afhandelt zonder communicatie tussen replica’s per request. Het is efficiënt wanneer het model past en het verkeer kan worden gebalanceerd. Bij training wordt DP vaak gecombineerd met ZeRO of FSDP om state te sharden.
Expert Parallelism (EP) verdeelt MoE-experts over GPU’s en gebruikt all-to-all-communicatie voor de routing van tokens. De prestaties hangen af van de balans van tokens, de plaatsing van experts en de topologie van de interconnect; all-to-all-verkeer kan het dominante bottleneck worden.
Een heuristiek om mee te beginnen:
- Het model past op één GPU: begin met onafhankelijke replica’s en meet de DP-schaling.
- Het model past binnen één node: test TP binnen de node en repliceer de groep als het verkeer dat vereist.
- Het model beslaat meerdere nodes: test een combinatie van TP en PP tegen de interconnect en het latency-doel.
- Mixture of experts: voeg EP alleen toe als de plaatsing van experts dat vereist.
34. Serving frameworks vergeleken
De runtime bepaalt welke van de optimalisaties uit Deel III je krijgt zonder zelf kernels te schrijven. Gebruik de tabel om te kiezen welke je het eerst benchmarkt, en vergelijk die daarna met één alternatief op dezelfde prompts, outputlengtes, hardware en SLO.
| Runtime | Gebruik hem wanneer | Controleer eerst |
|---|---|---|
| vLLM | Algemene GPU-serving met een OpenAI-compatibele API | Het doelmodel en de GPU in de actuele compatibiliteitsmatrix |
| SGLang | Het verkeer deelt lange prefixen (system prompts, chat met meerdere beurten, agents) of heeft structured output nodig | De prefix-cache-hitrate op je eigen verkeer |
| TensorRT-LLM | De fleet is alleen NVIDIA en de laagste latency is belangrijker dan portabiliteit | Ondersteuning voor je model en precisie (FP8, FP4) |
| llama.cpp | CPU, Apple silicon of één consumenten-GPU, met GGUF-gequantizede models | Tokens per seconde uit de eigen benchmarktool op de doelmachine |
| Ollama | Lokale ontwikkeling en demo’s | Stap over op een serving runtime vóór hoge concurrency of SLO-werk |
Dezelfde uitgangspunten voor het benchmark als geordende lijst:
- Eén lokale machine of één consumenten-GPU: begin met llama.cpp, of Ollama voor ontwikkeling.
- Alleen NVIDIA en latency heeft prioriteit: neem TensorRT-LLM mee in het benchmark.
- Lange gedeelde prefixen of structured output: SGLang.
- Anders: vLLM.
Benchmark de eerste keuze op je eigen prompts, outputlengtes, hardware en SLO.
vLLM biedt gepagineerde KV-allocatie, continuous batching, een OpenAI-compatibele API en meerdere parallelism-modi. De ondersteuning voor models en hardware verandert vaak.
SGLang combineert RadixAttention voor hergebruik van prefixen, een eigen scheduler en structured generation. De gepubliceerde throughput-winst hangt af van de workload en de configuratie.
TensorRT-LLM richt zich op lage latency per request via CUDA-graph-capture en -replay, die launch-overhead verminderen, en kerneloptimalisatie, inclusief fusion, met native FP8/FP4-ondersteuning. Eerdere versies zoals v1.2.0 ondersteunden het vooraf bouwen van een TensorRT-engine. NVIDIA’s huidige migratiegids noemt PyTorch als enige backend: de LLM-API en trtllm-serve laden een Hugging Face checkpoint direct, zonder een engine te bouwen. De gepubliceerde cijfers gelden voor specifieke hardware en models, en het draait alleen op NVIDIA-GPUs.
TGI is op 21 maart 2026 gearchiveerd en de repository is alleen-lezen. De README raadt voor nieuwe deployments vLLM, SGLang, llama.cpp of MLX aan.
Ollama legt de nadruk op een eenvoudige lokale workflow voor models.
llama.cpp is een portable C/C++-runtime met paden voor ARM, x86, Metal, CUDA, ROCm en Vulkan. GGUF ondersteunt meerdere quantization-niveaus. De prestaties variëren sterk per model, quantization, context en backend.
35. GPU-keuze voor inference
De tabel vergelijkt gepubliceerde hardware-eigenschappen. Ondersteuning van precisies door de leverancier maakt piekrekenkracht niet direct vergelijkbaar tussen formaten; kies daarom eerst op geheugen dat past en benchmark de doelworkload. Controleer actuele cloudprijzen apart, omdat ze variëren per provider, regio, commitment en beschikbaarheid.
| GPU | Geheugen | Bandwidth | Native lage precisie | NVLink per GPU |
|---|---|---|---|---|
| B200 SXM | 180 GB HBM3e | Tot 8 TB/s | FP4, FP8 | 1.8 TB/s |
| H200 SXM | 141 GB HBM3e | 4.8 TB/s | FP8 | 900 GB/s |
| H100 SXM | 80 GB HBM3 | 3.35 TB/s | FP8 | 900 GB/s |
| A100 80 GB SXM | 80 GB HBM2e | 2.039 TB/s | INT8 (geen FP8) | 600 GB/s |
| L40S | 48 GB GDDR6 | 864 GB/s | FP8 | Geen |
| A10G (AWS G5) | 24 GB GDDR6 | 600 GB/s | INT8 (geen FP8) | Geen |
| RTX 4090 | 24 GB GDDR6X | ~1 TB/s | FP8 | Geen |
De A10G-rij gebruikt NVIDIA’s A10-specificatie als benadering voor de bandwidth; de gelinkte AWS G5-specificatie stelt de exacte A10G-bandwidth niet vast. Het cijfer van de RTX 4090 (1,008 GB/s) komt uit de whitepaper over de Ada-architectuur.
De capaciteit van 141 GB van de H200 kan sommige deployments van grote models vereenvoudigen. De GDDR-kaarten in de onderste rijen hebben een derde of minder van de bandwidth van de H100 en geen NVLink, dus ze passen beter bij gequantizede models die op één GPU passen dan bij models die tensor parallelism nodig hebben.
AWQ en GPTQ serveren 4-bit models door ondersteunde matrixbewerkingen te dequantizen naar een rekenformaat zoals FP16 of BF16. Compatibiliteit en snelheid hangen nog steeds af van de modelarchitectuur, het quantization-formaat, de serving-backend, de kernel en de GPU; controleer dus de ondersteuningsmatrix van de backend en benchmark het exacte artefact. Alle genoemde GPU’s ondersteunen INT8-matrixbewerkingen.
LLM-decode wordt vaak beperkt door memory bandwidth, dus HBM-capaciteit en -bandwidth kunnen voor serving-workloads zwaarder wegen dan piek-TFLOPS. Vergelijk GPU’s met model, precisie, batchverdeling, contextlengte en latency-doel constant gehouden.
36. Model cascading en routing
Model routing kiest op basis van voorspelde complexiteit of capaciteit welk LLM elke query afhandelt. RouteLLM (LMSYS/UC Berkeley, ICLR 2025) rapporteert een kostenratio van 3.66x bij 95% van de GPT-4-Turbo-baselinescore op MT-Bench in tabel 6. Dat komt overeen met ongeveer 73% lagere gemodelleerde kosten bij de prijzen, het zwakke model en de scoring-opzet van dat experiment. Of routing loont, hangt af van actuele prijzen, het verkeersmengsel, fouten van de router en de ondergrens voor kwaliteit.
Routers variëren van lichte classifiers tot op LLM gebaseerde judges. Cascading is de sequentiële variant: een query begint bij een goedkoper model en gaat naar een sterker model wanneer een scorefunctie het antwoord afwijst. FrugalGPT rapporteert tot 98% lagere kosten of tot 4% hogere nauwkeurigheid in zijn geëvalueerde modelpool. Een cascade in productie heeft gecalibreerde escalatiecriteria nodig en monitoring op de queries die het goedkope model ten onrechte accepteert. De figuur toont waar elke aanpak zijn keuze maakt en waar elke aanpak faalt.
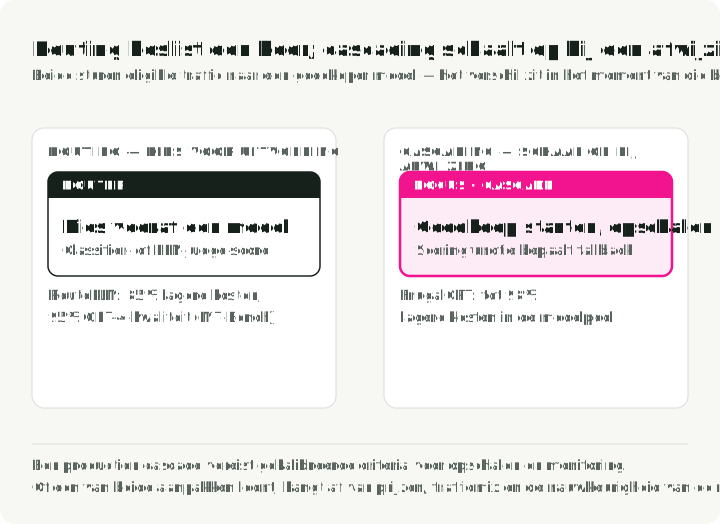
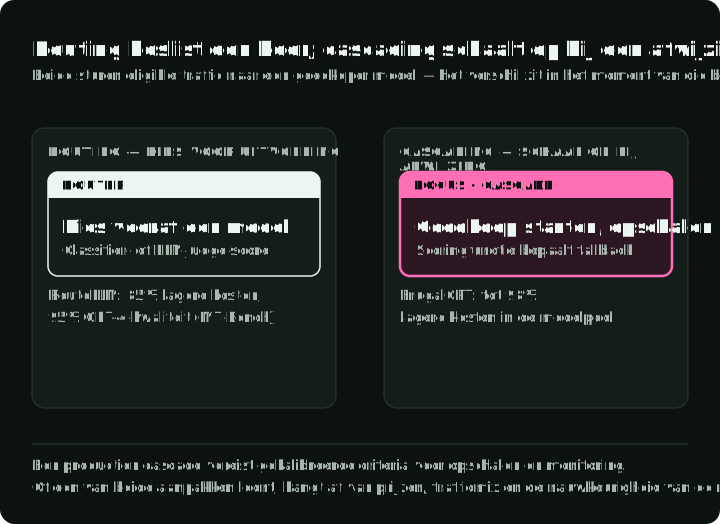
Deel VII — Applicaties
Applicaties falen op plekken die de serving-stack niet ziet. Retrieval kan mislukken voordat generatie begint, agents kunnen een ongeldige actie kiezen en een promptwijziging kan één taak verbeteren terwijl een andere stukgaat.
37. Embedding models versus generatieve models
Embedding models coderen tekst als vectoren van vaste dimensie die semantische betekenis vastleggen. De hieronder vergeleken single-vector models leveren één dense vector per invoer, meestal met enkele honderden tot enkele duizenden dimensies. Andere retrieval-architecturen kunnen meerdere vectoren op tokenniveau bewaren; de volgende opslagvergelijking betreft single-vector embeddings. Hun backbones zijn onder meer bidirectionele encoder-only transformers en van decoders afgeleide models die zijn aangepast voor representation learning. Een pooling-laag brengt de representaties per token vaak samen tot één vector via mean pooling, een speciale classificatietoken of een modelspecifieke methode met de laatste token. Contrastieve fine-tuning trekt daarna semantisch vergelijkbare teksten dichter naar elkaar toe en niet-vergelijkbare teksten verder uit elkaar.
Actuele embedding models verschillen in de eigenschappen die opslagkosten en indexkeuze bepalen: uitvoerdimensies, geaccepteerde invoertypen, deployment en uitvoerprecisie.
| Model | Max. dimensies | Invoer | Weights | Native uitvoerprecisie |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 4,096 (32–4,096 via MRL) | Tekst | Open (Apache 2.0) | Float |
| Gemini Embedding 2 | 3,072 (128–3,072) | Tekst, beeld, video, audio, PDF | API | Niet vermeld |
| pplx-embed-v1-4B | 2,560 (MRL) | Tekst | Open (MIT) | INT8 en binair |
| OpenAI text-embedding-3-large | 3,072 (verkort via dimensions) | Tekst | API | Float |
Dit zijn voorbeelden, geen ranglijst. Evalueer taal, modaliteit, taak, dimensie en serving-kosten op één retrieval-set.
Matryoshka Representation Learning (MRL, Kusupati et al., NeurIPS 2022) maakt de dimensies van embeddings flexibel. Genoemd naar Russische matroesjka’s traint MRL geselecteerde embedding-prefixen om nuttige informatie te behouden. De experimenten vergelijken die prefixen met apart getrainde kleinere representaties; gelijke kwaliteit is een empirisch resultaat, geen garantie voor elke taak. Tijdens de training aggregeert MRL de losses over een gekozen set prefix-dimensies van orde , meestal opeenvolgende halveringen; het voorbeeld met 2048 dimensies in het paper gebruikt . De geaggregeerde loss dwingt de eerste dimensies grove semantische informatie te dragen, terwijl latere dimensies fijner detail toevoegen.
Na de training kan een MRL-embedding worden afgekapt tot een ondersteunde prefix-dimensie. OpenAI meldt dat text-embedding-3-large met 256 dimensies beter presteert dan text-embedding-ada-002 met 1,536 dimensies in zijn aangehaalde MTEB-vergelijking. Dat geeft een 6x kleinere ruwe vectoropslag; zoeklatency en databasekosten hangen daarnaast af van de index, metadata, filtering en hardware.
Het embedding model is één belangrijk onderdeel van een RAG-pipeline, naast parsing, chunking, search, reranking en generatie. Als relevant bewijs niet wordt opgehaald, kan een sterkere generator het niet betrouwbaar herstellen.
38. RAG-architectuur in productie
Retrieval-Augmented Generation voorziet een LLM van documenten die tijdens de query worden opgehaald. Het kan actueel of privé bewijs leveren dat niet in de model weights zit, maar retrieval garandeert niet dat het antwoord dat bewijs correct gebruikt. Een RAG-systeem in productie is een pipeline met meerdere stadia die elk apart geëvalueerd moeten worden. De figuur toont het offline ingestion-pad, het pad per query en waar de drie hieronder genoemde faalmodi optreden.
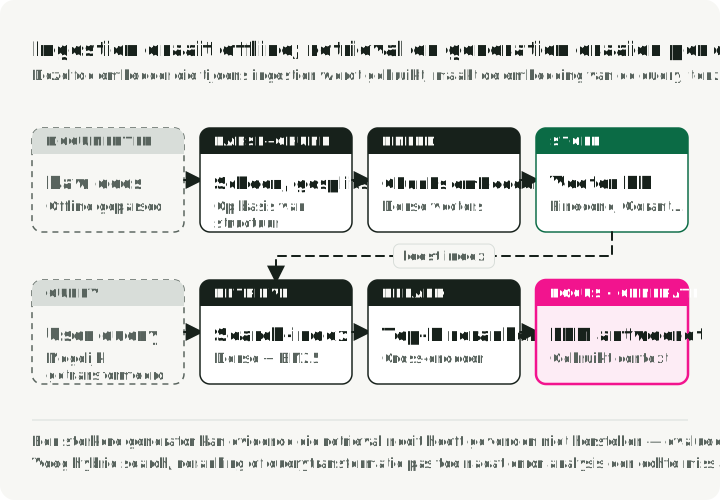
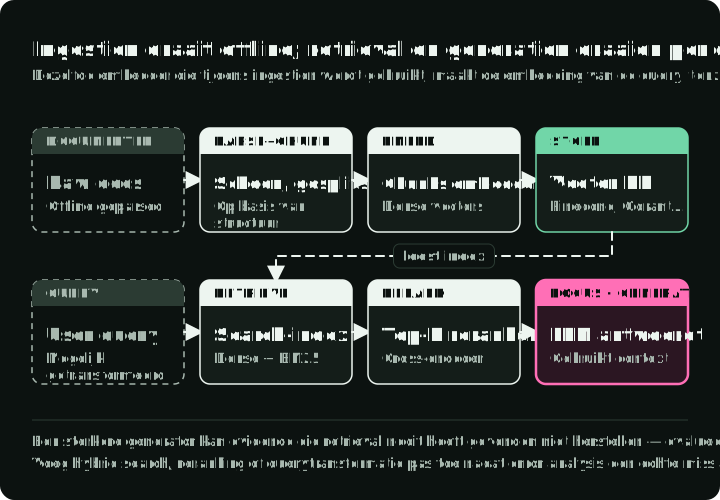
De ingestion-pipeline draait offline. Ruwe documenten (PDF’s, HTML, Markdown, databases) worden eerst geparsed tot schone tekst. Bij het parsen van PDF’s kunnen tabellen, koppen en opmaak verloren gaan. De tekst wordt daarna gesplitst in chunks, die onafhankelijk worden geëmbed en geïndexeerd.
Chunking beïnvloedt zowel de retrieval-recall als de context die de generator krijgt. Bruikbare groottes hangen af van documentstructuur, granulariteit van queries, limieten van de embedder en limieten van de reranker. Gangbare aanpakken zijn vaste grootte met overlap, recursief splitsen langs documentgrenzen en semantische chunking op basis van embedding-gelijkenis. Vergelijk ze op relevantielabels op pagina- of sectieniveau in plaats van één tokenbereik universeel over te nemen.
Elke chunk wordt daarna geëmbed met een model zoals die in Sectie 37 en opgeslagen in een vector index. pgvector bewaart vectoren in een Postgres-database die je al draait. Een speciale store zoals Qdrant, Weaviate of Pinecone voegt ingebouwde hybrid search toe en schaalt de index los van de applicatiedatabase.
De retrieval-pipeline draait tijdens de query. Begin met een meetbare baseline en voeg stadia toe wanneer foutanalyse laat zien dat ze een echte misser verhelpen:
- Hybrid search combineert dense vector retrieval met sparse retrieval zoals BM25, vaak samengevoegd via Reciprocal Rank Fusion (RRF). Dense search vangt semantische parafrases op; sparse search vindt exacte identifiers, foutcodes en acroniemen. Benchmarks van leveranciers rapporteren winst ten opzichte van baselines met alleen vectoren, maar de omvang hangt af van het corpus en de relevantielabels.
- Reranking laat opgehaalde kandidaten door een model gaan dat query en document samen scoort. Dat kan de fijnmazige relevantie verbeteren, ten koste van een extra modelaanroep. Aantal kandidaten, aantal behouden resultaten en latency moeten samen worden afgestemd. De volledige pipeline met meerdere stadia heb ik behandeld in Building a Modern Search Ranking Stack.
- Query transformation herschrijft de query van de gebruiker vóór retrieval om de recall te verbeteren. Bij HyDE (Hypothetical Document Embeddings) laat je de LLM een hypothetisch document genereren, dat vervolgens wordt geëmbed en wordt gebruikt om echte documenten op te halen. De gegenereerde tekst is een zoekrepresentatie, geen geverifieerd bewijs voor het antwoord. Multi-query expansion genereert meerdere formuleringen van dezelfde vraag. Step-back prompting stelt eerst een algemenere vraag om informatie op te halen of te redeneren vanuit algemenere principes.
De gangbare faalmodi:
- Retrieval failure — het juiste document bestaat maar wordt niet opgehaald. Test chunking, query transformation, hybrid search en metadatafiltering tegen de misser.
- Context poisoning — irrelevante opgehaalde chunks misleiden de LLM. Test reranking, contextfilters en kleinere behouden sets.
- Lost-in-the-middle — in de geteste omgevingen voor multi-document question answering en key-value retrieval vonden Liu et al. dat de antwoordprestaties over het algemeen het hoogst waren wanneer relevante informatie aan het begin of einde van de invoer stond en lager wanneer ze in het midden stond.
GraphRAG (Microsoft, 2024) extraheert entiteiten en relaties, detecteert graafgemeenschappen en bouwt samenvattingen van die gemeenschappen. De global-search-methode beantwoordt vragen op corpusniveau vanuit die samenvattingen; het is niet simpelweg vector retrieval met een toegevoegde graaf. De afweging is extra werk voor extractie, indexering, opslag en evaluatie.
Praktijkgidsen publiceren latencybereiken voor embedding, search, reranking en generatie, maar die cijfers variëren per regio, corpus, hardware en model. Meet elk stadium in traces en evalueer de kwaliteitswijziging voordat je de extra latency accepteert.
39. Agent-architecturen en tool calling
LLM-agents gebruiken models om tool calls te kiezen en te sequencen rond een veranderende state. Drie bruikbare orchestration-patronen zijn:
- ReAct — wisselt actiekeuze af met observaties. Het kan zich na elk tool result aanpassen, maar een groeiende geschiedenis verhoogt de kosten in tokens en latency.
- ReWOO — plant tool calls met placeholders en expliciete resultaatafhankelijkheden, voert het plan uit en synthetiseert daarna. Alleen onafhankelijke calls kunnen parallel draaien; een call die naar een eerder resultaat verwijst, moet daarop wachten. Het paper rapporteert tokenbesparing ten opzichte van ReAct, maar het vaste plan heeft een expliciet herstelpad nodig wanneer een tool faalt.
- Planner-executor — scheidt plannen van uitvoeren en kan na een fout een beleid voor herplannen toevoegen. Het laat voor elke rol een ander model toe, maar voegt plan-state en een tweede modelaanroep toe die kan falen.
| Patroon | Herhaald modelwerk | Aanpasbaarheid | Nuttig startpunt |
|---|---|---|---|
| ReAct | Leest observaties vóór de volgende actie | Past zich aan na observaties | Onzekere of verkennende tool use |
| ReWOO | Hergebruikt een plan met expliciete afhankelijkheden | Vast plan tenzij uitgebreid | Werk dat vóór tool results gepland kan worden |
| Planner-executor | Plant, voert uit en kan herplannen | Kan het expliciete plan herzien | Langere taken die baat hebben bij controle |
De figuur tekent de drie patronen, zodat je ziet waar elk plant en of er na een tool result een weg terug is.
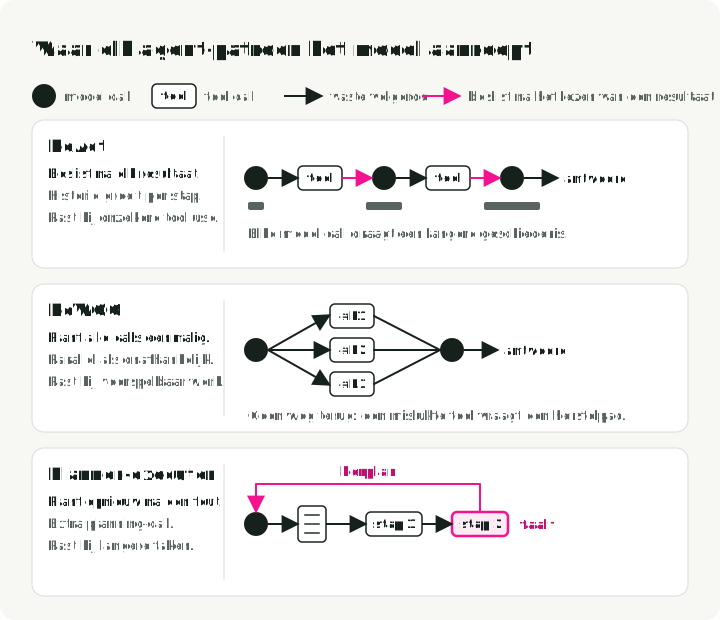
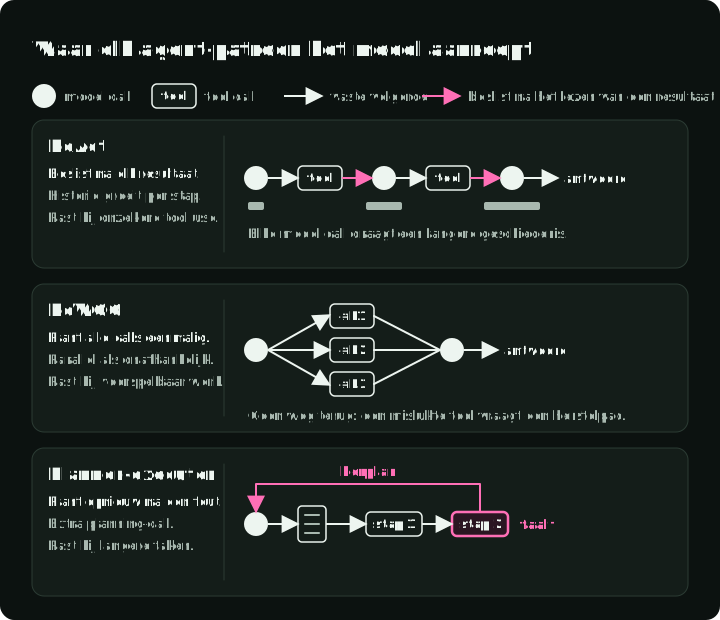
Function calling is een gangbaar mechanisme voor het aanroepen van tools. API’s bieden tooldefinities aan en geven gestructureerde argumenten terug, waardoor het parsen van vrije tekst minder vaak nodig is. Argumenten die aan het schema voldoen, kunnen nog steeds de verkeerde tool selecteren of ongeldige waarden bevatten. Parallel function calling kan het aantal round trips verminderen wanneer bewerkingen onafhankelijk zijn.
Structured output en constrained decoding dwingen een schema af door de tokens te beperken die bij elke generatiestap beschikbaar zijn. Engines zoals xgrammar, dat in vLLM en SGLang wordt gebruikt, kunnen in ondersteunde configuraties veel syntax- en parsingfouten met weinig overhead wegnemen. Ze garanderen niet dat de geëxtraheerde waarden of beslissingen correct zijn. Schema-Guided Reasoning (SGR) gebruikt de volgorde van velden en de structuur van het schema om tussentijdse state inspecteerbaar te maken vóór de uiteindelijke beslissing. De drie patronen zijn Cascade (sequentiële stappen), Routing (union types als semantische schakelaars) en Cycle (begrensde lijsten).
Een grotere set tools en een langere actiereeks kunnen de selectiekwaliteit verlagen en de latency of tokenkosten verhogen. Meet die curves met de werkelijke tooldescripties en foutverdeling. Frameworks zoals LangGraph kunnen state en herstelpaden expliciet maken, maar ze nemen de last van evaluatie niet weg.
40. Prompt engineering voor productie
Prompting in productie is een evaluatieprobleem: verander één onderdeel van de prompt of context en meet daarna de taakkwaliteit en de faalmodi. De technieken hieronder zijn gangbare startpunten, geen universele volgorde.
Few-shot-voorbeelden zijn vaak effectief om het uitvoerformaat te sturen. Begin met 3–5 voorbeelden die lege invoer, dubbelzinnige queries en antwoorden uit meerdere delen dekken, en meet het resultaat daarna op een held-out set. Voorbeelden moeten de echte verdeling van invoer beslaan en niet alleen het happy path. Meer voorbeelden verbruiken context en garanderen geen verdere winst.
Chain-of-thought (CoT)-prompting vraagt een model om tussentijdse redenering te tonen vóór het antwoord. Kojima et al. (2022) rapporteerden winst van het achtervoegsel “Let’s think step by step” op hun geteste reasoning-taken, maar het effect varieert per model en nieuwere reasoning-API’s tonen verborgen traces mogelijk niet. Geef in productie de voorkeur aan een inspecteerbare opdeling van de taak of een beknopte redenering wanneer dat voor de evaluator nuttig is. Self-consistency (Wang et al., 2023) samplet meerdere redeneerpaden en aggregeert de antwoorden, en ruilt extra inference-kosten in voor robuustheid bij geschikte taken.
Structured output met expliciete JSON Schema (Sectie 39) voorkomt veel parsingfouten. Engines voor constrained decoding zoals xgrammar kunnen de ondersteunde grammatica tijdens de generatie afdwingen; feitelijke juistheid en semantische geldigheid moeten nog steeds worden geëvalueerd, en niet-ondersteunde schema-features kunnen nog steeds afhandeling vereisen.
Prompt chaining splitst een taak in gerichte stadia, bijvoorbeeld intentie classificeren → context ophalen → antwoord genereren → output valideren. Het kan fouten lokaliseren, per stadium een ander model toelaten en cachebare tussen-state zichtbaar maken. Het voegt ook interfaces en latency toe, dus vergelijk het met een baseline met één aanroep.
Temperature verandert de sampling-verdeling. Lage waarden zijn een redelijk startpunt voor classificatie of extractie; hogere waarden kunnen de diversiteit voor ideeën vergroten. Het exacte gedrag verschilt per model-API en werkt samen met top_p, top_k en de standaardwaarden van de provider, dus doe een sweep over de ondersteunde instellingen op de taak in plaats van één bereik over te nemen.
Scheiding van system- en user-berichten houdt blijvend beleid gescheiden van inhoud per request. Chat templates en instruction tuning geven deze rollen een verschillende prioriteit, maar maken van een system-bericht geen grens die iets afdwingt. Zet stabiel gedrag in het system-bericht, houd niet-vertrouwde data in user- of tool-inhoud en dwing harde beperkingen zoals het verwijderen van PII ook buiten het model af.
Context engineering breidt promptwerk uit naar het samenstellen van opgehaalde documenten, tool results, gespreksgeschiedenis en voorbeelden. Liu et al. vonden een lost-in-the-middle-effect in de long-context-models die ze testten, dus positie hoort deel te zijn van de evaluatie en moet niet als irrelevant worden aangenomen. De bredere workflow heb ik behandeld in Context Engineering for AI Agents.
Deel VIII — Operations in productie
Operations in productie vertaalt de eerdere concepten naar toelatingslimieten, load tests, alerts en capaciteitsbeslissingen onder echt verkeer.
41. Rate limiting voor requests met variabele kosten
Traditionele rate limiting op requests per seconde gaat uit van ongeveer gelijke kosten per request. LLMs doorbreken die aanname. Een classificatieprompt van 10 tokens en een documentanalyse van 100K tokens raken hetzelfde API-endpoint, maar verschillen een factor 10,000 in invoerlengte. De totale kosten hangen ook af van outputlengte, model, caching en prijzen. Rate limiting op RPS laat dure requests ongecontroleerd door of laat goedkope requests onnodig verhongeren.
Systemen in productie hebben token-based rate limiting over meerdere dimensies nodig. OpenAI documenteert request- en tokenlimieten per gebruiksniveau. Anthropic scheidt limieten voor input-tokens en output-tokens. Exacte quota en algoritmen kunnen veranderen, dus beschouw de documentatie van de provider als bron van waarheid; het architecturale punt is om requests en tokens onafhankelijk te budgetteren.
Een implementatie op applicatieniveau is een multidimensionale limiethiërarchie (gebruiker → applicatie → organisatie → globaal), met prioriteitsniveaus voor premiumtoegang. Reserveer tokens bij het toelaten van een request: schat het totaal (invoer + max_tokens), trek de schatting af van de token bucket en geef het ongebruikte deel terug na afloop, op basis van het werkelijke verbruik. Zo put een piek van requests met lange generaties de capaciteit niet uit voordat ze uitvoer produceren. Een request met 2.000 invoertokens en max_tokens = 1.000 reserveert 3.000. Als het antwoord 200 uitvoertokens gebruikt, is het werkelijke verbruik 2.200 en worden 800 teruggegeven. Dit is een lokaal toelatingsbeleid; quota-algoritmes van providers kunnen andere schattingen en aparte input- en output-budgetten gebruiken. Bevat de bucket minder dan 3.000, retourneer dan een 429 of zet het request in de wachtrij.
Voor self-hosted deployments is het equivalent provisioned throughput: toegewijde GPU-capaciteit reserveren voor doelsnelheden in tokens. Voor vLLM-deployments betekent dat admission control configureren rond actieve decode-slots en KV cache-druk in plaats van alleen het aantal requests. Zoals Sectie 5 uitlegt, hebben zowel throughput als toelating limieten nodig die rekening houden met tokens.
42. Faalmodi om tegen te ontwerpen
LLM-serving voegt faalmodi toe die samenhangen met variabele sequentielengte, KV-geheugen en langlopend decode-werk. Ontwerp en load-test de verdedigingen voordat verkeer in productie ervan afhangt.
Out-of-Memory (OOM) is een veelvoorkomende fout. Een 70B-model in FP16 heeft alleen al voor de weights ongeveer 140 GB nodig, en de KV cache voor één sequentie van Llama 3.1 70B met 128K context kan onder de aannames in Sectie 6 ongeveer 40 GiB toevoegen. Het verschil tussen “past in het geheugen” en “OOM onder load” is kleiner dan het lijkt, omdat een batch van requests met lange context meer KV-geheugen kan verbruiken dan verwacht. Preventie combineert een gemeten geheugenreserve met quantization en gepagineerde KV-allocatie. In vLLM stelt --gpu-memory-utilization het deel van het GPU-geheugen in dat de engine mag gebruiken voor weights, activations en KV cache; de rest is de reserve. Voor workloads met hoge KV-druk kan LMCache KV-data offloaden naar CPU-geheugen of schijf; gebruik de gepubliceerde resultaten als startpunt en benchmark de lokale geheugenhiërarchie.
Preemption gebeurt wanneer KV cache-druk de scheduler dwingt werk te verwijderen of opnieuw te berekenen. De exacte strategie hangt af van de serving-versie en de configuratie. Vanuit de gebruiker gezien is het symptoom een hogere end-to-end-latency zonder duidelijke applicatiefout. Houd het aantal preemptions in de gaten en correleer het met KV-gebruik, queue-diepte en requestlengtes.
Tail latency kan oplopen wanneer grote prefills decode-werk vertragen. Chunked prefill (Sectie 7) en scheduling die rekening houdt met lengte pakken deze interferentie aan. De papers over de Learning-to-Rank-scheduler (Fu et al., 2024) en CascadeInfer rapporteren verbeteringen ten opzichte van hun baselines onder hun geëvalueerde workloads, maar het exacte resultaat hangt af van de verdeling van requestlengtes en de scheduler-configuratie.
Cascading failures kunnen beginnen wanneer trage requests de queue laten groeien, upstream clients een timeout krijgen en retries extra load toevoegen. Verdedigingen zijn onder meer admission control, concurrency-limieten per tenant, limieten op de output, retry-budgetten en circuit breakers in de gateway. Gescheiden prefill- en decode-pools kunnen helpen wanneer load tests blijvende interferentie tussen fasen laten zien. De figuur toont de loop en de verdediging op elke pijl.
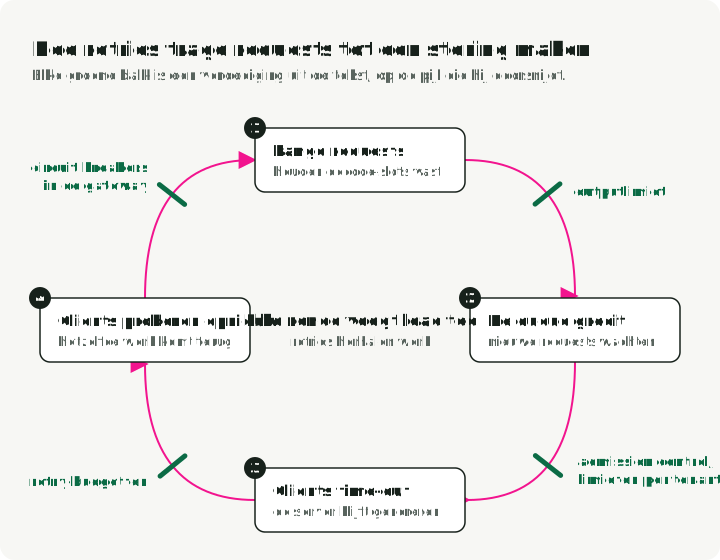
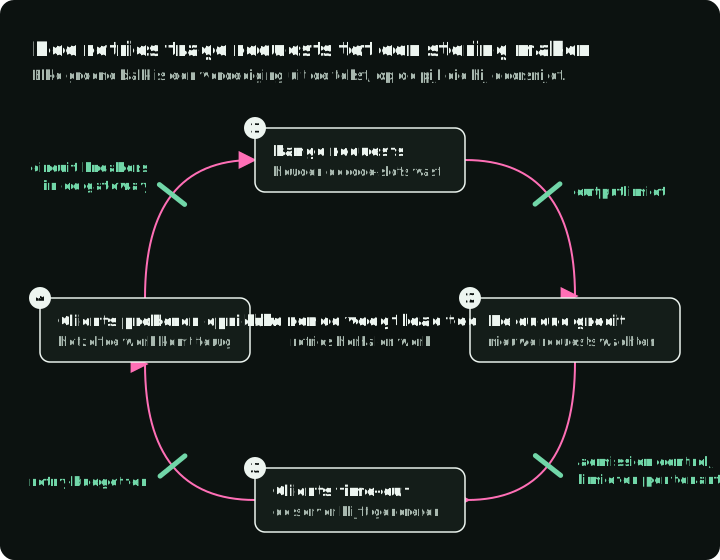
43. LLM-systemen monitoren
Monitoring van LLM’s verschilt op drie punten van API-monitoring: elk request heeft andere kosten, elk request heeft twee fasen met verschillende bottlenecks en de geheugenvoetafdruk hangt af van zowel de invoer- als de uitvoerlengte. Alleen requestlatency en foutpercentage laten niets hiervan zien.
Goodput is het aantal requests per seconde dat aan alle gedefinieerde SLO-drempels voldoet, zoals TTFT, TPOT en totale latency. Het is een nuttige gecombineerde maat, omdat de ruwe throughput er gezond uit kan zien terwijl latency-SLO’s falen: een systeem dat 100 requests per seconde verwerkt maar bij 40% daarvan zijn drempels mist, heeft een goodput van 60 requests per seconde. Optimaliseren op goodput houdt de verdeling van prestaties zichtbaar in plaats van alleen het gemiddelde te rapporteren.
vLLM stelt een Prometheus-endpoint beschikbaar op /metrics met lopende en wachtende requests, KV cache-gebruik, verdelingen van generatielengte en statistieken van de prefix cache. Metricnamen kunnen tussen releases veranderen, dus koppel dashboards aan de gedeployde versie. Een typische stack gebruikt Prometheus voor metrics, Grafana voor visualisatie en traces die compatibel zijn met OpenTelemetry over applicatie- en serving-componenten heen.
Nuttige alertpatronen zijn onder meer de volgende. Leid de drempels ervan af uit load tests in plaats van deze voorbeelden ongewijzigd over te nemen:
- Pieken in het aantal preemptions — de runtime swapt of herberekent werk, wat latency toevoegt zonder applicatiefout.
- KV cache-gebruik dat het geteste preemption-gebied nadert — voeg capaciteit toe of shed load voordat evictions zich opstapelen.
- Queue-diepte die blijvend boven de geteste batchomvang ligt — admission control moet beginnen met afwijzen of lager prioriteren.
- TTFT die stijgt terwijl TPOT vlak blijft — dit uiteenlopen wijst eerst op queueing, admission, netwerk of prefill-druk en niet op decode-throughput. Gebruik traces en queue-metrics om daartussen te onderscheiden.
In vLLM komen de eerste drie alerts overeen met vllm:num_preemptions_total, vllm:kv_cache_usage_perc en vllm:num_requests_waiting (vLLM metrics).
44. Kostenoptimalisatie: een strategie die zich opstapelt
Prijzen van providers en de verhoudingen tussen input- en outputprijzen veranderen. Haal actuele tarieven op vóór een inkoopbeslissing; modelniveau en outputlengte kunnen de rekening domineren nog vóór infrastructuuroptimalisaties.
OpenAI, Anthropic en Google brengen voor hun vlaggenschipmodels per output-token allemaal enkele malen zoveel in rekening als per input-token. Los daarvan verklaart de splitsing tussen prefill en decode waarom input en output verschillende uitvoeringskosten hebben: prefill verwerkt prompt tokens samen, terwijl gewone decode tokens sequentieel genereert. Dit mechanisme alleen verklaart niet hoe een provider commerciële prijzen vaststelt. Onnodige output wegsnijden (een strakke max_tokens, structured output, geen herhaling van de invoer) bespaart meestal meer dan hetzelfde aantal input-tokens wegsnijden.
Meerdere aanpakken kunnen worden gestapeld, maar pas nadat je hebt gemeten welke op de workload van toepassing zijn:
- Quantization van FP16 naar INT4 verlaagt de ruwe opslag van weight-waarden met 75%, vóór schalen en andere metadata. Of dat de rekening verlaagt, hangt af van de kernelsnelheid, de batchgrootte en de benutting van de hardware (Sectie 9).
- Model routing stuurt geschikt verkeer naar goedkopere models. Meet het false-accept-percentage van de router en de end-to-end-kwaliteit voordat je het aandeel vergroot dat het goedkopere model afhandelt (Sectie 36).
- Prompt caching vermindert werk voor herhaalde prefixen. Kortingen van providers en de behandeling van rate limits veranderen in de tijd, dus combineer de gemeten hitrate met actuele voorwaarden (Sectie 16).
- Batch-API’s kunnen korting geven op werk dat niet realtime is, zoals evaluaties, generatie van synthetische data en bulkclassificatie. Controleer actuele prijzen en doorlooptijden.
- Self-hosting kan bij aanhoudende benutting winnen, maar er is geen universeel break-even-punt in tokenvolume. Reken naast GPU-huur ook de kosten voor engineering, orchestration, observability, reservecapaciteit en on-call mee.
Vermenigvuldig afzonderlijke optimalisatiewinsten niet alsof alle requests er onafhankelijk van profiteren: quantization verandert throughput, routing verandert de kwaliteitsverdeling, en caching en batching gelden alleen voor geschikt verkeer. Maak de schatting met gemeten verkeersaandelen en toets die aan de factuur.
45. Capaciteitsplanning en autoscaling
Capaciteitsplanning voor LLM-serving moet rekening houden met variabele requestkosten, langlopend decode-werk en geheugen dat van de sequentie afhangt. Afhankelijk van de workload kan de beperkende resource KV-geheugen, memory bandwidth, rekenkracht of de interconnect zijn.
De theoretische geheugenlimiet voor gelijktijdige requests volgt uit het KV cache-budget:
Stel voor de rekenvoorbeelden dat de runtime een KV-budget van 40 GiB beschikbaar stelt voor Llama 3.1 70B met een FP16 KV cache. Elke sequentie van 4K gebruikt ongeveer 1.25 GiB en elke sequentie van 128K ongeveer 40 GiB. Dat budget bevat dus hooguit ongeveer 32 sequenties van 4K of één sequentie van 128K, vóór overhead van allocator en runtime, variatie in de workload en SLO. De functie kv_cache_bytes in Sectie 6 herhaalt deze berekening voor een ander model of budget. Daarom bepalen GPU-keuze en optimalisatie van de KV cache direct het capaciteitsplan.
De capaciteitsformule voor het dimensioneren van de fleet:
Reken beide snelheden om naar dezelfde tijdseenheid voordat je deelt. Gebruik de throughput per GPU die bij de doel-SLO is gemeten en niet de piekthroughput. Een factor van 1.3 voorziet 30% meer throughput dan de verwachte vraag, zodat bij die vraag ongeveer 23% van de voorziene capaciteit ongebruikt blijft. Rond naar boven af op volledige serving-replica’s; een TP/PP-replica heeft zijn volledige GPU-groep nodig. Snelheden per GPU zijn alleen bruikbaar voor een vaste, gemeten replica-topologie. Kies de factor op basis van gemeten burstiness, storingen en hersteltijd. Piekthroughput in tokens en SLO-conforme throughput kunnen sterk uiteenlopen naarmate de concurrency stijgt. Benchmark met de echte verdeling van prompt- en outputlengtes bij de vereiste TTFT- en TPOT-drempels in plaats van een theoretisch maximum te gebruiken.
GPU-benutting is als enige autoscaling-signaal onvoldoende, omdat ze hoog kan blijven zowel bij gezonde verwerking als bij overbelasting. Combineer haar met queue-diepte, KV cache-benutting en achteruitgang van goodput. Stem drempels af met load tests; waarden zoals 80% KV-benutting zijn startpunten en geen universele limieten. Deze metrics worden geïntroduceerd in Sectie 43.
Scale-to-zero kan passen bij ontwikkel- en staging-omgevingen met lange perioden van inactiviteit. Serverless inference-platforms en autoscalers op Kubernetes-basis zoals KEDA kunnen ongebruikte capaciteit weghalen, maar de besparing en de cold-start-tijd hangen af van modelgrootte, caching van images en weights en infrastructuur. Meet de opstarttijd voordat je hetzelfde beleid toepast op latency-gevoelig verkeer in productie.
Hoe de inference-concepten samenhangen
Deel I tot en met III koppelen geheugencapaciteit aan serving-prestaties. KV-grootte per sequentie (Sectie 6) geeft een ruwe limiet voor het aantal residente sequenties. Grotere decode-batches kunnen weight-hergebruik en arithmetic intensity verbeteren (Sectie 1), maar attention-verkeer, scheduling en communicatie beïnvloeden ook TPOT en throughput. GQA en KV-opslag met lagere precisie verkleinen de cachedata; PagedAttention vermindert allocatieverspilling. Met de vermelde Llama 3.1 70B-indeling, een FP16 KV cache en een budget van 40 GiB is de ruwe limiet 32 sequenties van 4K tokens of één van 128K, vóór runtime-overhead en latency-beperkingen. Admission control kan werk in de wachtrij zetten of weigeren voordat die limiet is bereikt. Onder KV-druk kan de runtime requests preëmpten; ongecontroleerde allocaties kunnen OOM veroorzaken (Sectie 42).
Routing, caching, quantization en hardwarekeuze stapelen zich alleen op wanneer elk wordt geëvalueerd tegen hetzelfde kwaliteits- en latency-doel. Kies één symptoom uit de tabel bovenaan, stel die baseline vast en maak de volgende wijziging makkelijk terug te draaien.
Verder lezen
Verwante verdiepende artikelen van deze blog, per onderwerp:
- LLM Fine-Tuning Guide — wanneer je fine-tunet versus RAG versus prompt engineering
- Open-Source LLM Variants and File Formats — modelvarianten en gequantizede formaten afstemmen op hardware
- LoRAX Serving Guide — duizenden LoRA-adapters in productie serveren
- Scaling Large Language Models — strategieën voor meerdere GPU’s en meerdere nodes
- Local LLMs on macOS — praktische setup met llama.cpp en Ollama
- AI Agent Reasoning Loops in 2026 — verdieping in ReAct-, ReWOO- en planner-executor-loops
- AI Agent Memory Architecture in 2026 — checkpoints, vector stores en documentgeheugen voor agents met state
Referenties
Georganiseerd per onderwerp.
Inference en attention
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness - Dao et al., NeurIPS 2022
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning - Dao, 2023
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision - Shah et al., NeurIPS 2024
- Flash-Decoding for long-context inference - Dao et al., 2023
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022
- GQA: Training Generalized Multi-Query Attention - Ainslie et al., 2023
- Triton: an intermediate language and compiler for neural network computations - Tillet et al., MAPL 2019
- FlashNorm: Fast Normalization for LLMs - 2024
- Deep Kernel Fusion for Transformers - DeepFusionKernel, 2026
Speculative decoding
- Accelerating Large Language Model Decoding with Speculative Sampling - Chen et al., 2023
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models - Li et al., NeurIPS 2025
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - ICML 2024
Quantization
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration - MLSys 2024 Best Paper
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers - Frantar et al., ICLR 2023
- Marlin: Mixed-Precision (FP16xINT4) LLM Inference Kernel - Frantar et al., 2024
Training en fine-tuning
- LoRA: Low-Rank Adaptation of Large Language Models - Hu et al., ICLR 2022
- QLoRA: Efficient Finetuning of Quantized LLMs - Dettmers et al., NeurIPS 2023
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models - Rajbhandari et al., SC20
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning - Rajbhandari et al., 2021
- Self-Instruct: Aligning Language Models with Self-Generated Instructions - Wang et al., ACL 2023
- WizardLM: Empowering Large Language Models to Follow Complex Instructions - Xu et al., ICLR 2024
- Phi-4 Technical Report - Microsoft, 2024
- Training Deep Nets with Sublinear Memory Cost - Chen et al., 2016 (gradient checkpointing)
- AI models collapse when trained on recursively generated data - Shumailov et al., Nature 2024
Alignment
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model - Rafailov et al., NeurIPS 2023
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models - Introduceerde GRPO
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning - DeepSeek, 2025
Schaling en architectuur
- The Llama 3 Herd of Models - Meta, 2024
- LLaMA: Open and Efficient Foundation Language Models - Touvron et al. (Meta), 2023
- Llama 2: Open Foundation and Fine-Tuned Chat Models - Touvron et al. (Meta), 2023
- Qwen3 Technical Report - Qwen Team (Alibaba), 2025
- Training Compute-Optimal Large Language Models - Hoffmann et al. (Chinchilla), NeurIPS 2022
- RoFormer: Enhanced Transformer with Rotary Position Embedding - Su et al., 2021
- YaRN: Efficient Context Window Extension of Large Language Models - Peng et al., ICLR 2024
- SGLang: Efficient Execution of Structured Language Model Programs - Zheng et al., NeurIPS 2024
- Mixtral of Experts - Jiang et al. (Mistral AI), 2024
Embeddings
- Matryoshka Representation Learning - Kusupati et al., NeurIPS 2022
- pplx-embed-v1: Diffusion-Pretrained Dense and Contextual Embeddings - Perplexity AI, 2026
Agent-architecturen
- ReAct: Synergizing Reasoning and Acting in Language Models - Yao et al., ICLR 2023
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models - Xu et al., 2023
Prompting
- Large Language Models are Zero-Shot Reasoners - Kojima et al., NeurIPS 2022
- Self-Consistency Improves Chain of Thought Reasoning in Language Models - Wang et al., ICLR 2023
Routing
- RouteLLM: Learning to Route LLMs with Preference Data - Ong et al., ICLR 2025
Benchmarks
- MLPerf Inference v5.0 Results - MLCommons, april 2025
Serving-architecturen
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve - Agrawal et al., OSDI 2024 (Chunked prefill)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting - Patel et al., ISCA 2024 (Disaggregated Serving)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving - Zhong et al., OSDI 2024 (Disaggregated Serving)
Serving frameworks
- vLLM - Serving-engine op basis van PagedAttention
- SGLang - RadixAttention en structured generation
- TensorRT-LLM - Door NVIDIA geoptimaliseerde inference
- llama.cpp - Portable C/C++-inference
- DeepSpeed - Gedistribueerde trainingsbibliotheek van Microsoft
- Ollama - Lokale LLM-runner
Operations
- Efficient LLM Scheduling by Learning to Rank - Fu et al., NeurIPS 2024 (vLLM-LTR)
- CascadeInfer: Length-Aware Scheduling of LLM Serving with Low Latency and Load Balancing - Yuan et al., 2025
- Goodput metric as measure of ML productivity - Google Cloud, 2024
- vLLM Optimization and Tuning - vLLM-documentatie
- vLLM Metrics - vLLM-documentatie
- LMCache: KV Cache Management for LLM Serving - Offloading van de KV cache
- OpenAI Rate Limits - OpenAI API-documentatie
- Anthropic Rate Limits - Anthropic API-documentatie