Гайд по LLM-инжинирингу: 45 концепций для production-систем

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это справочник для инженеров, которые уже знают базовые концепции ML и систем и хотят связать production-симптом с нужной частью стека. В нём 45 концепций из областей железа, инференса, обучения, деплоя, приложений и эксплуатации. Каждый раздел описывает механизм, то, что он меняет в работающей системе, и условие, при котором справедлив приведённый результат. Если вы идёте от симптома, например от медленного первого токена или OOM под нагрузкой, найдите нужные разделы в таблице симптомов ниже.
Для конкретного вопроса откройте короткие ответы по LLM-инжинирингу. У каждой темы отдельный ответ со ссылкой на соответствующий раздел этого руководства.
| Часть | Темы | Разделы |
|---|---|---|
| I — Основы железа | Модель roofline, память GPU, глоссарий по железу | 1–3 |
| II — Основы инференса | Латентность, throughput, KV cache, аттеншн, квантизация | 4–9 |
| III — Оптимизации инференса | CUDA-ядра, FlashAttention, батчинг, PagedAttention, speculative decoding | 10–17 |
| IV — Архитектура модели | Устройство трансформера, decoder-only, MoE, токенизация, контекстные окна | 18–22 |
| V — Обучение и алайнмент | Претрейнинг, LoRA, смешанная точность, ZeRO, scaling laws, RLHF/DPO/GRPO, дистилляция | 23–32 |
| VI — Масштабирование и деплой | Параллелизм, фреймворки для сервинга, выбор GPU, роутинг | 33–36 |
| VII — Приложения | Эмбеддинги, RAG, агенты, промпт-инжиниринг | 37–40 |
| VIII — Эксплуатация в production | Rate limiting, режимы отказа, мониторинг, стоимость, планирование ёмкости | 41–45 |
Начните с симптома
В каждой строке указано, какие разделы читать первыми и что измерить, прежде чем менять стек.
| Симптом или решение | С чего начать | Что измерить перед изменением стека |
|---|---|---|
| Медленный первый токен | Префилл и декод, TTFT | Время в очереди, длину промпта, время префилла и P99 TTFT |
| Токены стримятся медленно | Roofline, TPOT | TPOT при разной конкурентности, пропускную способность памяти и форму батча |
| Длинные контексты вызывают вытеснение или OOM | KV cache, PagedAttention | Использование KV, длины запросов, потери аллокатора и число вытеснений |
| Модель не помещается в бюджет | Квантизация, Выбор GPU | Качество, throughput ядер, резерв памяти и goodput при целевом SLO |
| Выбор рантайма для сервинга | Фреймворки для сервинга, Параллелизм | Throughput и P99-латентность при целевом SLO на ваших промптах |
| Запросы падают по таймауту под нагрузкой | Режимы отказа, Rate limiting | Глубину очереди, вытеснения, долю повторов и длины ответов |
| Обучение не помещается в память | LoRA и QLoRA, ZeRO, FSDP | Память под состояние модели, коммуникацию, throughput и качество на отложенной выборке |
| Растёт стоимость | Роутинг, Оптимизация стоимости | Долю подходящего трафика, ошибки качества, hit rate кэша и данные счетов |
Глубже по решениям
| Если вы решаете… | С чего начать | Что читать дальше |
|---|---|---|
| Как обслуживать много дообученных адаптеров | Основы инференса и деплой | Руководство по сервингу с LoRAX |
| Нужна ли квантизация | Квантизация | Руководство по квантизации моделей |
| Как разделить модель между GPU | Параллелизм | Масштабирование больших языковых моделей |
| Нужен ли файн-тюнинг | Обучение и алайнмент | Руководство по файн-тюнингу LLM |
| Как встроить retrieval в приложение | Эмбеддинги и RAG | Метрики оценки RAG |
| Как устроены агентные системы | Агенты и промпт-инжиниринг | Циклы ризонинга ИИ-агентов |
| Как ранжировать результаты поиска | Эмбеддинги и реранкинг | Стек ранжирования поиска |
Часть I — Основы железа
Арифметическая интенсивность, иерархия памяти GPU и термины из этой части объясняют многие решения, которые встретятся дальше в гайде.
1. Memory-bound и compute-bound, модель roofline
Отправная точка для производительности LLM — арифметическая интенсивность: сколько полезных вычислений GPU выполняет на каждый байт данных, загруженный из памяти. Это отношение определяет, чем ограничена операция: вычислениями (compute-bound, ждёт процессор) или памятью (memory-bound, ждёт загрузки данных).
У каждого GPU есть «критическая интенсивность»: порог, при котором пиковая вычислительная производительность равна пропускной способности памяти. Для NVIDIA H100 SXM с плотными Tensor Cores в BF16 или FP16 (989 TFLOPS; спецификация на 1 979 TFLOPS предполагает структурную разреженность):
График roofline ниже показывает достижимую производительность в зависимости от арифметической интенсивности. Наклонная линия — область memory-bound, где предел задаёт пропускная способность памяти; горизонтальная линия — максимальный вычислительный throughput; излом между ними лежит на пороге 295 FLOPs/byte.
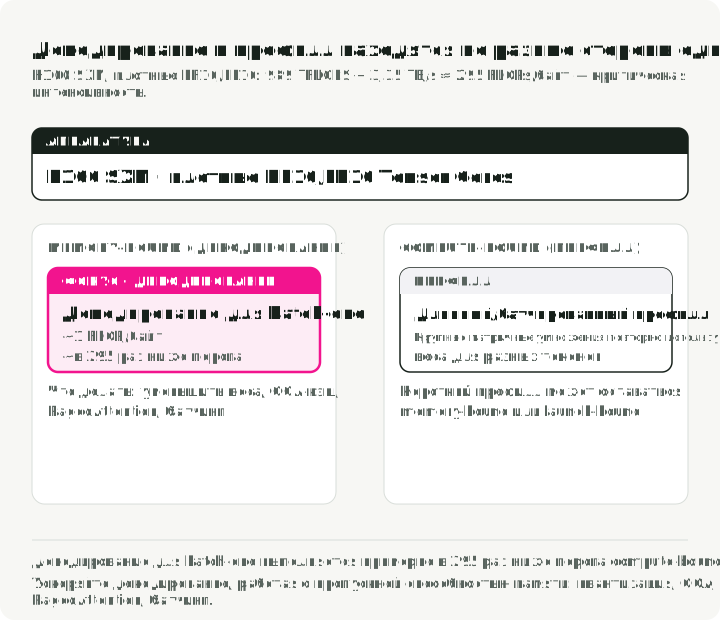
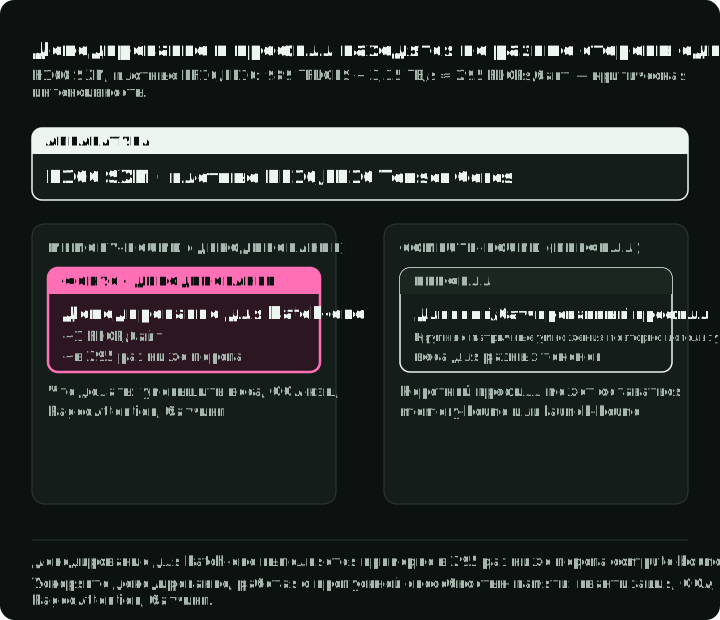
Декод с батчем 1 и длинный либо достаточно батчированный префилл обычно оказываются по разные стороны этого порога:
- Декод ограничен памятью. Когда токены генерируются по одному, для умножения на единственный новый токен приходится загружать из памяти матрицу весов в несколько гигабайт. В упрощённом анализе для плотной модели в 16 битах и батча 1 у операции около 1 FLOP/byte, примерно в 295 раз ниже порога roofline для H100. Этот разрыв объясняет, почему в таком режиме декод не может приблизиться к пиковой вычислительной производительности.
- Длинный или достаточно батчированный префилл часто ограничен вычислениями. Обработка многих токенов промпта переиспользует веса в больших матричных умножениях, и арифметическая интенсивность может подняться выше порога roofline. Короткие промпты и малые батчи могут упираться в трафик памяти или в накладные расходы на запуск ядер.
Поэтому, чтобы ускорить декод, работайте с пропускной способностью памяти: уменьшайте веса с помощью квантизации, снижайте расход памяти на KV с помощью GQA и PagedAttention, а интенсивность повышайте батчингом. Для длинных или хорошо батчированных префиллов могут помочь более быстрые матричные вычисления и вычисления в меньшей точности; нагрузки с короткими префиллами профилируйте отдельно.
2. Иерархия памяти GPU
У GPU четыре уровня памяти с разной ёмкостью и скоростью доступа. Регистры небольшие и быстрые; HBM хранит намного больше данных, но доступ к ней занимает больше времени. Перемещение данных между уровнями — значительное ограничение производительности. На рисунке показана H100 SXM: регистры и shared memory внутри каждого SM, L2 на кристалле и 80 GB HBM3 в стеках рядом с ним.
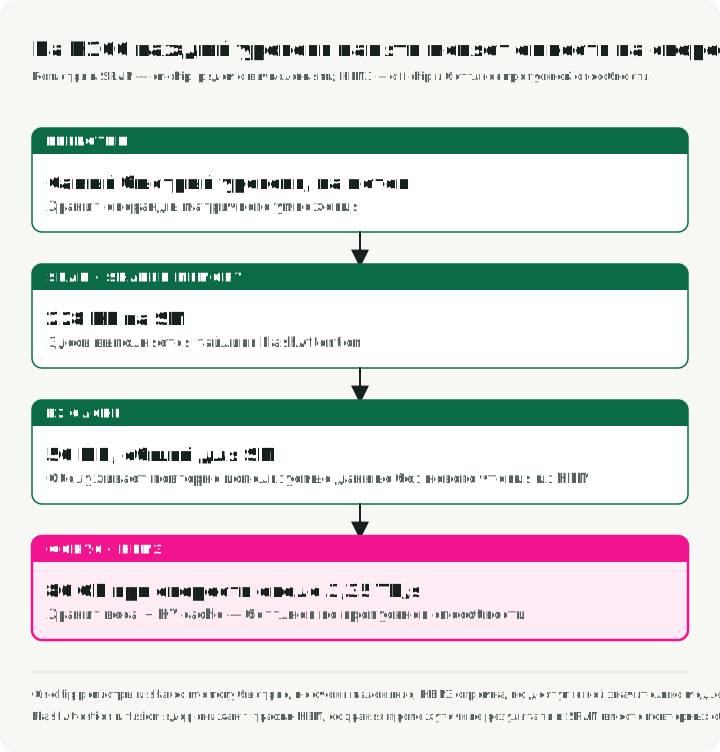
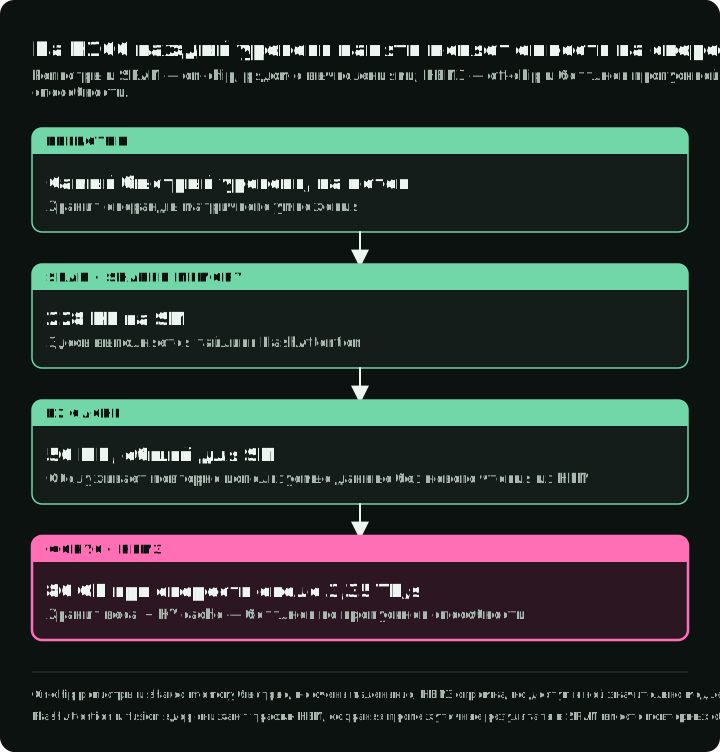
От самого быстрого уровня к самому медленному на H100 SXM:
- Регистры — самая быстрая память, привязанная напрямую к вычислительным потокам. В WGMMA на Hopper матрица A может поступать из регистров или из shared memory, а матрица B — из shared memory.
- SRAM (shared memory) — быстрая рабочая память на кристалле, локальная для каждого SM.
- Кэш L2 — общий слой на 50 MB. Он может отдавать данные, которые переиспользуются между SM, без повторного обращения к HBM.
- HBM3 — основная память на 80 GB, в которой лежат веса модели и KV cache; её пропускная способность составляет ~3,35 TB/s.
Разрыв между памятью на кристалле и вне его велик. По оценке из статьи про FlashAttention, на A100 пропускная способность SRAM на кристалле составляет около 19 TB/s против 1,5–2,0 TB/s у HBM (Dao et al., 2022), то есть примерно в 10 раз. FlashAttention и слияние ядер сокращают трафик HBM, оставляя промежуточные результаты на кристалле или объединяя шаги вычисления. PagedAttention решает другую задачу: он отображает логические блоки KV на несмежные физические блоки памяти GPU, уменьшая фрагментацию и позволяя разделять блоки.
3. Глоссарий по железу GPU
Эти термины встречаются во всём остальном гайде.
HBM (High Bandwidth Memory) — стек кристаллов DRAM, соединённых сквозными кремниевыми переходами (TSV) и расположенных рядом с кристаллом GPU. Поколения: HBM2e (A100, 2 TB/s), HBM3 (H100, 3,35 TB/s) и HBM3e (H200/B200, 4,8–8 TB/s). Пропускная способность HBM напрямую ограничивает TPOT в режимах декода, ограниченных памятью.
GDDR (Graphics DDR) — традиционная графическая память в потребительских GPU и GPU для рабочих станций, например RTX 4090 и L40S. У этих карт пропускная способность памяти ниже, чем у H100 SXM. Согласно документу NVIDIA об архитектуре Ada, GDDR6X на RTX 4090 обеспечивает 1008 GB/s против 3,35 TB/s у HBM3 на H100 SXM.
SM (Streaming Multiprocessor) — базовый вычислительный блок GPU NVIDIA. Каждый SM содержит ядра CUDA, Tensor Cores, shared memory и планировщик варпов. В H100 SXM 132 SM, а в H100 PCIe — 114. В A100 — 108.
Tensor Cores — специализированные блоки умножения матриц с накоплением внутри каждого SM. Они ускоряют матричные умножения смешанной точности, которые доминируют в вычислениях трансформера. Tensor Cores у H100 SXM дают 494,5 TFLOPS TF32 в плотном режиме или 989 TFLOPS в разреженном; при сравнении этой цифры всегда указывайте точность и режим разреженности.
Ядра CUDA (CUDA Cores) — универсальные блоки для чисел с плавающей точкой и целых чисел. Они выполняют поэлементные операции, функции активации и другую нематричную работу, пока Tensor Cores выполняют поддерживаемые матричные операции.
Варп (warp) — группа из 32 потоков на SM. Потоки могут расходиться по ветвям, а GPU начиная с Volta поддерживают независимое планирование потоков. Специализация варпов назначает разные варпы на перемещение данных и вычисления, чтобы эти задачи перекрывались.
NVLink — высокоскоростное соединение GPU с GPU внутри узла от NVIDIA. NVLink 4.0 на H100 даёт 900 GB/s двунаправленной пропускной способности; NVLink 5.0 на B200 достигает 1,8 TB/s. Эта пропускная способность важна для тензорного параллелизма, потому что GPU обмениваются частичными результатами на каждом слое трансформера.
InfiniBand — высокоскоростная сетевая фабрика для связи между узлами. Адаптеры InfiniBand класса ConnectX образуют межузловую фабрику для трафика конвейерного параллелизма и распределённого обучения; пропускная способность зависит от адаптера и конфигурации портов.
RDMA (Remote Direct Memory Access) позволяет устройству обращаться к памяти другой машины, не пропуская путь данных через CPU ни одной из сторон. GPUDirect RDMA поддерживает прямые передачи между GPU на разных узлах, в том числе передачу KV cache при дезагрегированном сервинге.
NVMe (Non-Volatile Memory Express) — интерфейс SSD, который используют для выгрузки KV cache и для выгрузки параметров в ZeRO-Infinity, когда памяти GPU и CPU не хватает. Последовательная пропускная способность зависит от диска и нагрузки и остаётся намного ниже пропускной способности HBM.
TFLOPS и PFLOPS — триллионы и квадриллионы операций с плавающей точкой в секунду. Один TFLOPS равен FLOPS. H100 достигает 989 TFLOPS TF32 на тензорных ядрах в разреженном режиме, а FlashAttention-3 сообщает около 1,2 PFLOPS в FP8; эти значения относятся к разным форматам, и сравнивать их как одну метрику нельзя.
Часть II — Основы инференса
Инференс превращает модель в сервис, который видит пользователь. Следующие концепции разделяют работу, которая задерживает первый токен, и работу, которая замедляет каждый следующий, и показывают ограничения памяти, стоящие за обеими.
4. Латентность: TTFT, TPOT и перцентили
Time to First Token (TTFT) — сквозная задержка от отправки запроса до первого выходного токена. Она включает очередь, токенизацию, планирование, проход префилла, который порождает первый токен, и доставку по сети. Распространённые движки сервинга сэмплируют первый выходной токен из логитов прохода префилла, поэтому отдельного шага декода перед ним нет. Более длинные промпты обычно увеличивают долю префилла, но доминировать может любая из этих стадий. Целевые значения зависят от продукта; MLPerf Inference v5.0 задаёт предел P99 TTFT 450 ms для интерактивного сценария с Llama 2 70B.
Time Per Output Token (TPOT) — средний интервал между последовательными токенами после первого. Он соответствует фазе декода. Декод с батчем 1 или с низкой интенсивностью обычно ограничен пропускной способностью памяти, а достаточно большие батчи могут стать compute-bound:
Это определение требует как минимум двух выходных токенов; для ответа из одного токена TPOT не определён. В этой формуле латентность E2E заканчивается на последнем выходном токене. Таймер до завершения HTTP может также учитывать более поздние метаданные или закрытие соединения; записывайте это время отдельно.
Оценка скорости чтения на английском даёт приблизительный ориентир для стриминга. Средняя скорость чтения про себя у взрослого читателя на английском — около 238 слов в минуту для нон-фикшна (Brysbaert, 2019), то есть около 4 слов в секунду. Если токен в среднем соответствует трём четвертям слова, получается около 5 токенов в секунду, или 200 ms на токен. Это не порог удобства использования: результат зависит от языка, токенизатора, задачи и буферизации в клиенте. В интерактивном сценарии MLPerf предел P99 TPOT намного жёстче: 40 ms. Свою цель задавайте по результатам тестирования продукта.
P50 и P99 важно различать, потому что медиана скрывает хвост. Система с хорошим P50 и плохим P99 может страдать от батчинга, вытеснений, очередей или перекоса нагрузки; чтобы их различить, нужны трейсы.
5. Throughput: токены в секунду и компромисс с латентностью
Throughput измеряют в выходных токенах в секунду по всем параллельным запросам. Запросы в секунду сами по себе — более слабая метрика, потому что ответ из 10 токенов и ответ из 1 000 токенов стоят совершенно по-разному. Опубликованные результаты бенчмарков зависят от модели, точности, железа, длин промпта и ответа, конкурентности и SLO. vLLM, SGLang и TensorRT-LLM сравнивайте в одном харнессе, а не складывайте их заголовочные результаты.
Увеличение небольшого батча декода может повысить throughput за счёт совместного чтения весов. Более крупные батчи или более высокая входящая нагрузка со временем увеличивают латентность или достигают ограничений памяти, вычислений либо коммуникации. Измеряйте эту зависимость, не предполагая линейного масштабирования. Goodput — число запросов в секунду, которые укладываются в ваши целевые SLO, — связывает сырой throughput с тем, что реально видят пользователи.
6. KV cache: память, которая растёт с каждым токеном
При авторегрессионной генерации с полным аттеншном каждый новый токен учитывает текущий и предыдущие токены. KV cache хранит проекции Key и Value, чтобы при генерации не пересчитывать проекции предыдущих токенов на каждом шаге. Декод с полным аттеншном всё равно читает растущую историю; суммарная работа аттеншна на генерируемой последовательности остаётся квадратичной по её длине.
Для обычного кэша MHA или GQA с полным аттеншном память растёт линейно с длиной последовательности, размером батча и числом слоёв. Следующая формула без изменений не применима к архитектурам MLA, sliding-window, рекуррентным или гибридным архитектурам:
где:
- = число слоёв
- = число KV-голов
- = размерность головы
- = длина последовательности
- = размер батча
- = байт на кэшируемый элемент, определяется точностью KV cache
Конкретные примеры для FP16 и батча 1: Llama 3.1 8B при 8 192 токенах занимает ~1,07 GB (1 GiB) KV cache; при 128K токенов — 16 GiB. Llama 3.1 70B при 128K токенов требует 40 GiB (около 43 GB) на одну последовательность, то есть примерно половину 80 GB у H100. При высокой конкурентности или длинном контексте KV cache может превысить память под веса модели; результат зависит от длины последовательности, размера активного батча, точности KV и числа KV-голов. В исходной оценке vLLM 2023 года сообщалось о 60–80% потерь из-за фрагментации и предварительного выделения в сравниваемых системах.
Основные оптимизации: GQA (меньше KV-голов), квантизация KV cache (FP8/INT8), PagedAttention (блочное выделение) и выгрузка повторно используемых данных KV на CPU или NVMe. Их польза зависит от нагрузки и реализации.
Чтобы ответить на вопрос «сколько последовательностей поместится в мой бюджет KV?» для другой модели, возьмите из её config.json три числа: num_hidden_layers, num_key_value_heads и head_dim, если это поле есть. В примерах Llama размерность головы равна hidden_size / num_attention_heads. Память на устройстве также зависит от шардинга кэша и возможной репликации KV-голов. Функция ниже применяет формулу; assert-ы воспроизводят числа выше и пример ёмкости из раздела 45.
def kv_cache_bytes(layers, kv_heads, head_dim, seq_len, batch=1, bytes_per_elem=2):
    """Bytes of KV cache: a key and a value per layer, KV head, and token."""
    return 2 * layers * kv_heads * head_dim * seq_len * batch * bytes_per_elem

GiB = 2**30

# Llama 3.1 8B: 32 layers, 8 KV heads, head dimension 128, FP16 cache.
llama_8b = kv_cache_bytes(32, 8, 128, seq_len=8_192)
print(f"8B at 8K tokens: {llama_8b / 1e9:.2f} GB")  # 1.07 GB
assert llama_8b == 1 * GiB

# Llama 3.1 70B: 80 layers, 8 KV heads, head dimension 128.
assert kv_cache_bytes(80, 8, 128, seq_len=131_072) == 40 * GiB

# How many 4K-token sequences fit in a 40 GiB KV budget?
per_4k = kv_cache_bytes(80, 8, 128, seq_len=4_096)
print(f"70B at 4K tokens: {per_4k / GiB:.2f} GiB per sequence")  # 1.25 GiB
print("4K sequences in 40 GiB:", 40 * GiB // per_4k)  # 32
assert 40 * GiB // per_4k == 32

# An FP8 KV cache halves the size per sequence and doubles the count.
assert 40 * GiB // kv_cache_bytes(80, 8, 128, 4_096, bytes_per_elem=1) == 64
Результат — верхняя граница. Рантайму также нужна память под активации, накладные расходы аллокатора и запас на разброс длин запросов.
7. Префилл и декод: две фазы, два боттлнека
Фаза префилла обрабатывает входной промпт параллельно и заполняет KV cache. Длинные или достаточно батчированные префиллы часто становятся compute-bound, потому что используют большие матричные умножения; короткие префиллы могут оставаться ограниченными трафиком памяти или накладными расходами на запуск ядер. Префилл вносит вклад в время до первого токена (TTFT) наряду с очередью, токенизацией, планированием и доставкой по сети; его проход вперёд также порождает первый выходной токен. Фаза декода генерирует по одному токену. На каждом шаге из HBM читаются веса модели и KV cache, поэтому декод с батчем 1 ограничен пропускной способностью памяти и главным образом определяет время на выходной токен (TPOT).
На рисунке показан один запрос: префилл повторно использует веса для разных токенов промпта и заканчивается первым токеном в пределах TTFT; каждый последующий шаг декодирования снова читает веса и KV cache для одного токена и влияет на TPOT.
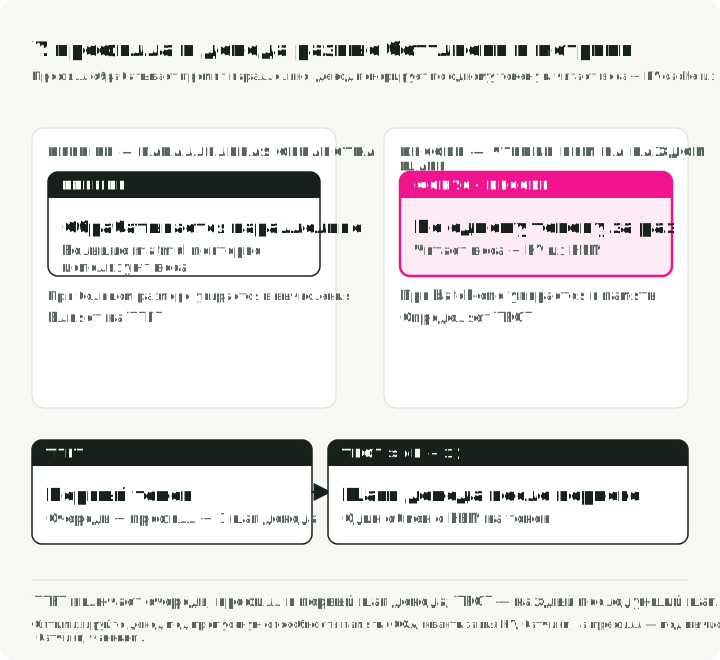
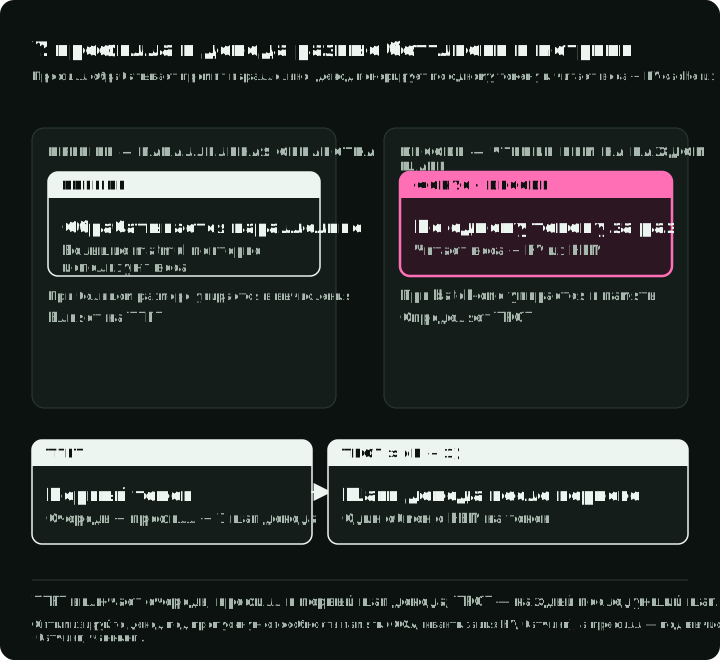
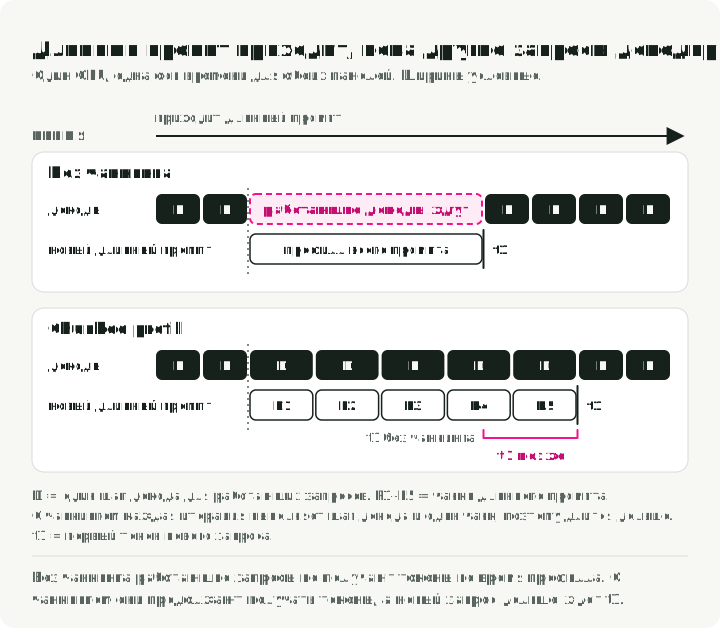
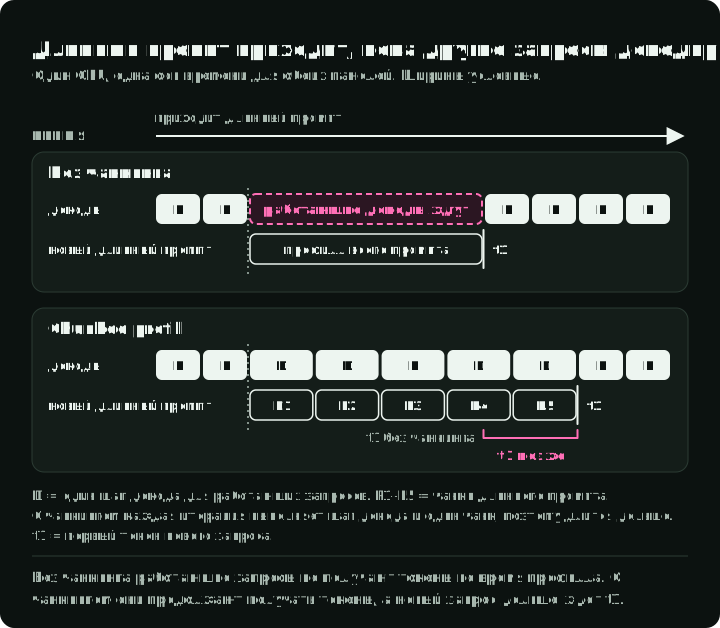
Chunked prefill разбивает длинный промпт на чанки и планирует их вместе с работающими декодами. Фактический размер чанка может меняться в зависимости от доступного бюджета токенов на итерацию. В Sarathi-Serve (раздел 4.2) и в vLLM планировщик сначала кладёт в батч работающие декоды, а остаток бюджета токенов на итерацию заполняет токенами префилла. Длинный промпт больше не мешает остальным запросам получать токены. Платит за это новый запрос: его префилл растягивается на несколько итераций, и каждый чанк заново читает KV cache предыдущих чанков. Sarathi-Serve измерил около 25% дополнительного времени префилла для Yi-34B с тензорным параллелизмом степени два и чанками по 512 токенов (раздел 5.4.1), а документация vLLM сообщает, что меньший бюджет токенов даёт лучшую межтокенную латентность и худший TTFT. Sarathi-Serve сообщает о лучших компромиссах между throughput и латентностью на проверенных нагрузках, но выигрыш зависит от модели, железа, распределения длин запросов, размера чанка и базы для сравнения.
Дезагрегированный сервинг размещает префилл и декод на отдельных пулах GPU, так что каждый пул может целиться в свой боттлнек. Этот паттерн описывают Splitwise и DistServe. Пул префилла отправляет KV cache каждого запроса в пул декода. DistServe использует NVLink внутри узла и InfiniBand между узлами; Splitwise использует InfiniBand, который поддерживает RDMA. Стоимость передачи становится частью архитектуры.
Рисунок помещает оба расписания на одну временную ось: приходит один длинный промпт, пока другие запросы находятся в декоде. Чанкинг сохраняет поток токенов других запросов и сдвигает первый токен нового запроса позже.
8. GQA и MQA: сжатие KV cache
Стандартный Multi-Head Attention (MHA) выдаёт каждой query-голове собственные головы K и V. Multi-Query Attention (MQA) использует одну KV-голову на все query-головы — это радикальное сокращение. Grouped-Query Attention (GQA) — практичная золотая середина: группы query-голов делят одну KV-голову. На рисунке нарисованы восемь query-голов и KV-головы, которые остаются у каждого варианта; KV cache уменьшается пропорционально числу KV-голов.
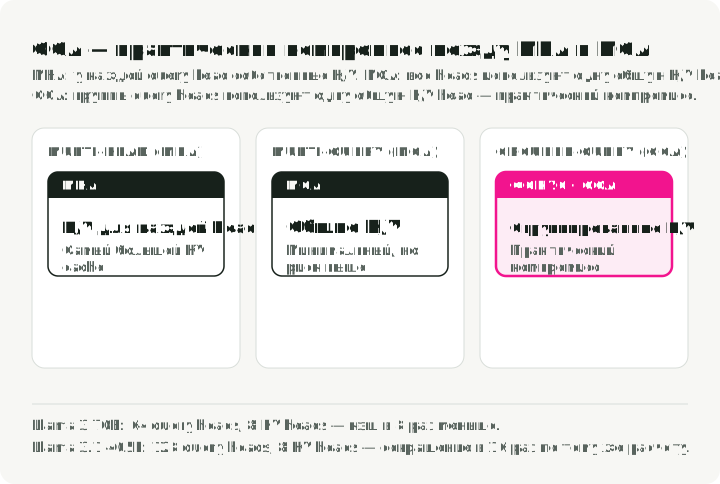
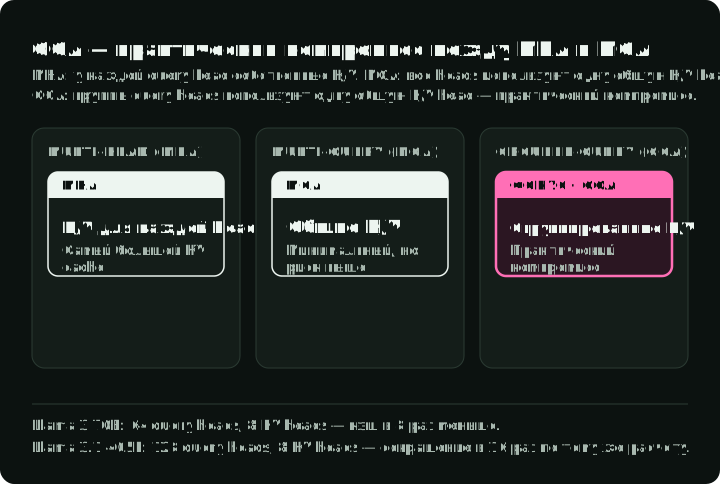
У Llama 3 70B 64 query-головы, но всего 8 KV-голов, то есть KV cache в 8 раз меньше, чем у той же архитектуры с одной KV-головой на каждую query-голову. У Llama 3.1 405B 128 query-голов и 8 KV-голов, то есть сокращение в 16 раз по тому же расчёту (Meta, 2024). Ainslie et al. сообщают, что качество GQA близко к MHA на проверенных моделях, а скорость приближается к MQA. Меньший KV cache позволяет использовать большие батчи, но реальный выигрыш в латентности и throughput всё равно зависит от ядра и нагрузки.
9. Квантизация: меняем биты на скорость и память
Квантизация снижает точность весов модели и (или) активаций. Основные компромиссы:
| Формат | Бит | Память под веса (модель 7B) | Замечание о качестве |
|---|---|---|---|
| FP16/BF16 | 16 | ~14 GB | База для сравнения |
| FP8 | 8 | ~7 GB | Нативная аппаратная поддержка на Hopper; проверяйте модель |
| INT8 | 8 | ~7 GB | Зависит от калибровки и ядра |
| INT4 | 4 | ~3,5 GB | Более сильное сжатие; проверяйте внимательно |
AWQ (Activation-Aware Weight Quantization) определяет значимые каналы весов по величинам активаций и применяет поканальное масштабирование, чтобы их защитить. Потребность в калибровочных данных зависит от модели и конфигурации; в одном сравнении на OPT-6.7B INT3-g128 AWQ использовал 16 калибровочных последовательностей, а GPTQ — 192. В воспроизводимой настройке указывайте и число последовательностей, и их длину. GPTQ использует приближённую информацию второго порядка для послойной квантизации. bitsandbytes умеет квантизовать модель прямо при загрузке, без отдельного прохода предобработки; его формат NF4 лежит в основе файн-тюнинга QLoRA. FP8 на железе класса Hopper вдвое уменьшает память под веса по сравнению с FP16/BF16, но качество и скорость по-прежнему зависят от модели, калибровки и ядра.
Таблица сопоставляет каждый метод с задачей, для которой он обычно подходит. Каждый метод подробно разобран в руководстве по квантизации моделей.
| Метод | Калибровочные данные | Типичное применение |
|---|---|---|
| AWQ или GPTQ (INT4 weight-only) | Да, небольшая выборка | Сервинг большой модели на GPU с ограниченной памятью через поддерживаемое ядро INT4 |
| bitsandbytes NF4 | Нет | Файн-тюнинг QLoRA и быстрые эксперименты |
| FP8 | Небольшая выборка или динамическое масштабирование | Сервинг на Hopper или более новых GPU с проверкой качества на целевой задаче |
| INT8 (W8A8) | Да, для масштабов активаций | GPU без FP8, например A100 или A10G, если сервинговое ядро это поддерживает |
Сервинговое ядро может значить не меньше, чем алгоритм квантизации. Раздел 10 приводит ограниченный по условиям результат Marlin и объясняет, почему выигрыш зависит от конфигурации сервинга.
Часть III — Оптимизации инференса
Оптимизации из этой части решают разные ограничения. FlashAttention сокращает трафик HBM в аттеншне; PagedAttention улучшает выделение памяти под KV; continuous batching не даёт завершённым последовательностям занимать место в батче.
10. CUDA-ядра и слияние ядер
CUDA-ядро (kernel) — функция, написанная для GPU, которая выполняется параллельно на тысячах потоков. Когда CPU вызывает ядро, GPU распределяет работу по своим SM: каждый SM запускает несколько варпов по 32 потока, и каждый поток обрабатывает свой фрагмент данных. Реализация сервинга на CUDA выполняет работу GPU через ядра. Число запусков зависит от графа модели, компилятора, рантайма и слияния. Реализация ядра может определять, уложится ли система в SLO по латентности.
Основные категории ядер в сервинге LLM:
- GEMM-ядра для матричного умножения, которые доминируют в вычислениях и префилла, и декода.
- Ядра аттеншна, такие как FlashAttention, которые разбивают вычисления на тайлы, чтобы оставаться в SRAM, а не выгружаться в HBM.
- Слитые ядра, которые объединяют несколько операций (например, сложение + layer norm или проекцию QKV) в один запуск и пропускают промежуточные обращения к HBM.
- Ядра сэмплирования, которые превращают логиты в ID токенов через top-k, top-p или температурное сэмплирование.
Качество ядра может определять, даст ли сжатие весов ускорение. В статье про Marlin сообщается о сквозном ускорении до 2,8x относительно базы FP16 для проверенных конфигураций vLLM с INT4 weight-only. Этот результат относится к моделям, GPU, размерам батча и конфигурации сервинга из статьи, поэтому его нельзя считать универсальным выигрышем от INT4.
Triton снижает порог входа в написание собственных ядер: он открывает программирование GPU через Python вместо чистого CUDA C++, и оптимизация на уровне ядер становится доступной ML-инженерам, а не только специалистам по GPU. Большинство оптимизаций дальше в этой части (FlashAttention, слитые ядра, PagedAttention) — это либо более удачные ядра, либо более умные способы оркестрации их запусков.
Слияние ядер объединяет последовательные операции в одно ядро GPU и пропускает промежуточные записи в HBM. Типичные слияния: проекция QKV, аттеншн вместе с softmax, остаточное сложение вместе с RMSNorm. FlashNorm вместо этого объединяет масштабирование RMSNorm со следующей линейной проекцией и откладывает нормализацию. DeepFusionKernel объединяет полный MLP SwiGLU, включая матричные умножения. Точный выигрыш в числе запусков и в утилизации зависит от графа модели, компилятора, GPU и фреймворка для сервинга, поэтому профилируйте развёрнутый стек, а не полагайтесь на универсальный процент.
11. FlashAttention: аттеншн по тайлам внутри SRAM
Стандартный аттеншн материализует полную матрицу внимания в HBM, что стоит памяти и порождает много трафика памяти. Идея FlashAttention — не материализовать эту матрицу вообще. Он разбивает матрицы Q, K, V на блоки, помещающиеся в SRAM, считает частичный аттеншн внутри каждого тайла и объединяет результаты с помощью online softmax (постепенно отслеживая текущий максимум и сумму по блокам). Объём промежуточного хранения снижается с до , с меньшим числом чтений и записей HBM для форм тензоров, проверенных в статье. Арифметика плотного аттеншна остаётся квадратичной по длине последовательности.
Каждая версия целится в боттлнек своего поколения GPU:
- FlashAttention v1 (A100, 2022) доказал, что идея тайлинга с online softmax работает. В статье сообщалось об ускорении в 2–4 раза по сравнению со стандартным аттеншном, но всего о 25–40% утилизации GPU. Статья FA2 связывает это с работой вне матричных умножений, коммуникацией через shared memory и ограниченным параллелизмом.
- FlashAttention v2 (A100, 2023) переработал параллелизм: работа делится по измерению последовательности, а также по батчу и головам. Он достиг 50–73% утилизации на A100, примерно в 2 раза быстрее v1.
- FlashAttention v3 (H100 Hopper, 2024) добавил специализацию варпов (отдельные варпы для перемещения данных и для математики) и конвейеризацию GEMM и softmax, чтобы перекрывать загрузки из памяти с вычислениями. В статье сообщается о до 740 TFLOPS в FP16 (75% утилизации) и почти 1,2 PFLOPS в FP8 на H100.
- FlashAttention v4 (B200 Blackwell, 2026) решает новый боттлнек: на Blackwell производительность тензорных ядер растёт так быстро, что ограничителем становятся немматричные операции (экспоненты softmax, перемасштабирование). FA4 программно эмулирует экспоненту полиномиальными приближениями на блоках FMA, использует условное перемасштабирование для снижения накладных расходов и хранит промежуточные значения в выделенной тензорной памяти Blackwell (TMEM), а не в регистрах. В статье сообщается о примерно 1,6 PFLOPS на B200 в BF16, в 1,3 раза быстрее cuDNN 9.13 и в 2,7 раза быстрее Triton в её тестах.
12. FlashDecoding: распараллеливаем боттлнек декода
Стандартный FlashAttention держит GPU занятым, разделяя работу по размеру батча и длине query. Во время декода модель генерирует ровно 1 токен за раз (длина query = 1). Если размер батча, умноженный на число attention heads, намного меньше числа SM у GPU (108 у A100), многие SM могут простаивать, пока активные SM обрабатывают историю токенов.
FlashDecoding решает это, добавляя новое измерение параллелизма: саму длину KV-последовательности. Он нарезает KV cache на более мелкие чанки и раздаёт их всем простаивающим процессорам GPU для параллельной обработки, а затем объединяет их частичные результаты через редукцию log-sum-exp.
В бенчмарке Stanford с батчем 1 на CodeLlama-34B на четырёх GPU A100 при длинах последовательностей от 512 до 64K токенов FlashDecoding достиг до 8x сквозного ускорения по сравнению с проверенными базами и улучшал масштабирование аттеншна на проверенных длинных контекстах. Результат ограничен этим железом и этим бенчмарком и не является общей гарантией для декода.
13. Continuous batching и static batching
Static batching ждёт завершения всех последовательностей в батче, прежде чем начать следующий, поэтому короткие последовательности впустую тратят такты GPU, простаивая после end-of-sequence. Continuous batching (представлен в статье про Orca, OSDI 2022) работает с гранулярностью итерации: на каждом шаге декода завершённые последовательности убираются, а новые вставляются. На рисунке показаны четыре слота батча на десяти шагах декода при каждой политике.
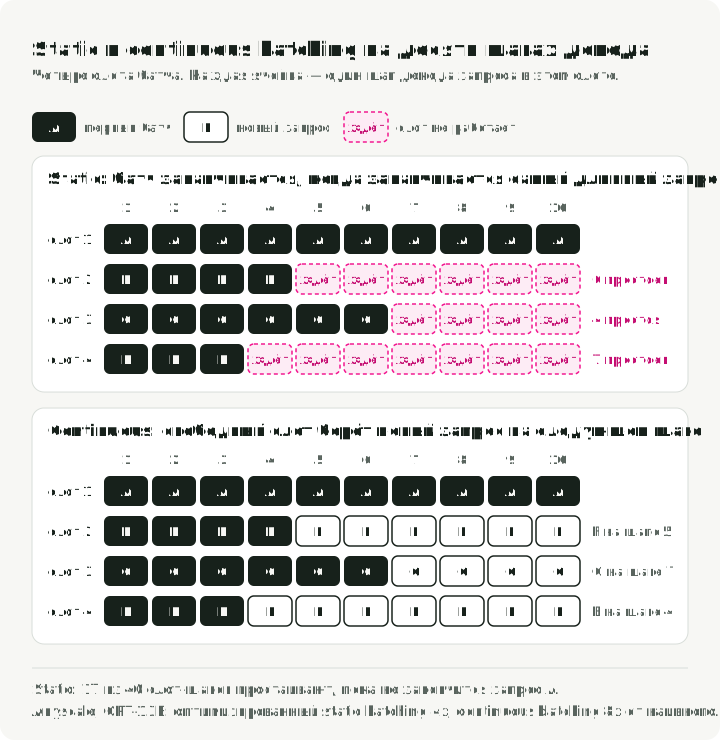
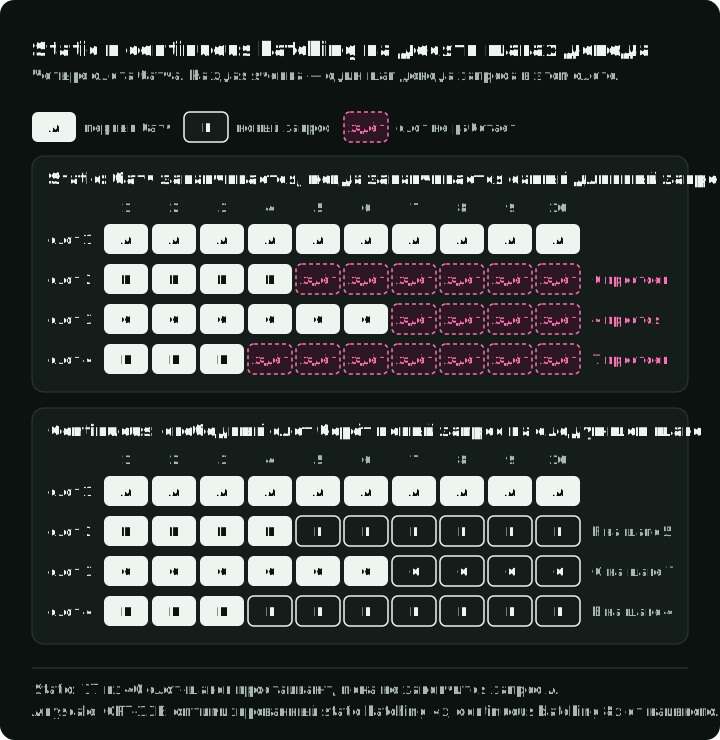
В бенчмарке Anyscale 2023 года на OPT-13B на A100-40GB, с 1000 запросов, промптами по 512 токенов и выходами в среднем по 128 токенов, оптимизированный static batching достиг 4x от наивной базы, continuous batching — 8x, а vLLM с continuous batching и PagedAttention — 23x (Anyscale, 2023). Continuous batching также увеличивает нагрузку на выделение памяти под KV, поэтому его обычно сочетают со страничным управлением памятью.
14. PagedAttention: виртуальная память для KV cache
PagedAttention в vLLM применяет идею виртуальной памяти ОС к управлению KV cache. KV cache разбивается на блоки фиксированного размера (16 токенов в этой иллюстрации; размер блока зависит от рантайма), блоки выделяются по мере генерации токенов, а логические (последовательные) позиции отображаются на физические (разбросанные) области памяти через таблицы блоков. Несколько запросов с общим префиксом (системные промпты, beam search) могут ссылаться на одни и те же физические блоки. Повторное использование префиксов также требует совместимых ключей кэша и политики поиска в кэше. На рисунке показана таблица блоков для двух запросов с общим системным промптом.
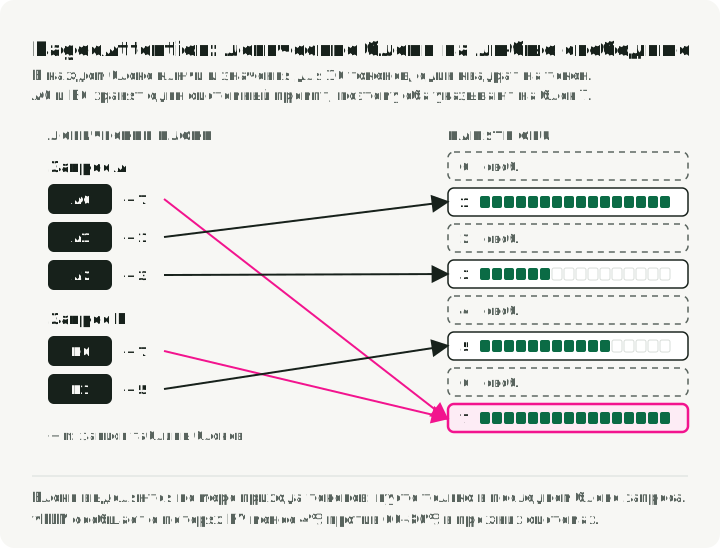
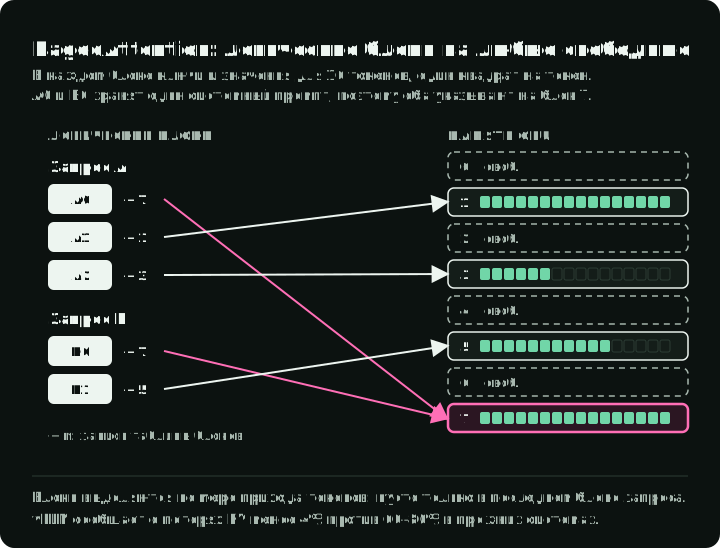
В оценке vLLM за июнь 2023 года сообщалось о 60–80% потерь памяти KV в проверенных прежних системах и о менее 4% со страничным аллокатором. Throughput был в 2–4 раза выше TGI и до 24x выше Hugging Face Transformers на отдельных нагрузках. Это исторические сквозные сравнения систем сервинга, а не универсальное ускорение или предел потерь PagedAttention. Частично заполненный последний блок может терять большую долю памяти на коротких последовательностях.
15. Speculative decoding: несколько токенов за один проход вперёд
В speculative decoding небольшая draft-модель генерирует токенов-кандидатов, а затем большая целевая модель оценивает все позиций за один проход вперёд. Декодер принимает токены черновика слева направо с вероятностями, выведенными из распределений целевой модели и черновика. После первого отклонения он сэмплирует поправку из остаточного распределения целевой модели и отбрасывает оставшиеся токены черновика. Этот модифицированный шаг rejection sampling сохраняет распределение выходов целевой модели с точностью до численных особенностей железа; одного точного совпадения токенов для этого недостаточно. На рисунке разобран один раунд с четырьмя токенами черновика.
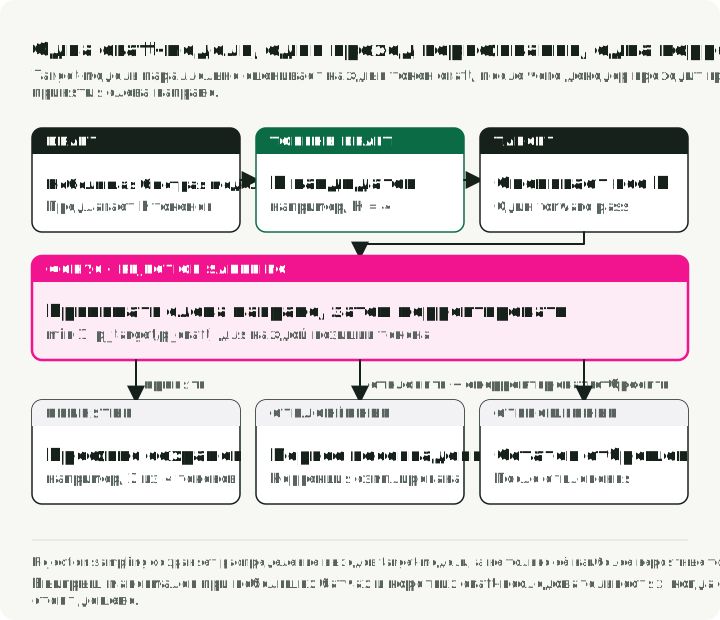
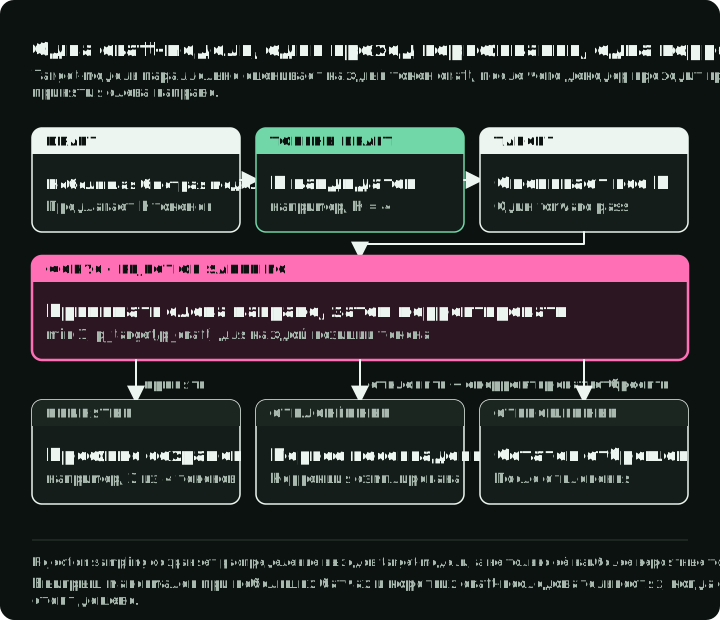
Выигрыш наиболее правдоподобен при малых батчах сервинга и коротких черновиках, когда оценка черновика определяется трафиком весов, KV cache или коммуникации, а не вычислениями для дополнительных токенов. В оригинальной статье про speculative sampling сообщалось об ускорении декодинга в 2–2,5 раза для проверенной конфигурации Chinchilla 70B; EAGLE-3 v3 сообщает об ускорении до 6,5x в своих тестах. Варианты включают Medusa (дополнительные головы предсказания, без отдельной модели), prompt lookup decoding (сопоставление n-грамм с входом без отдельного прохода draft-модели) и EAGLE. Исходный EAGLE экстраполирует признаки; EAGLE-3 объединяет несколько уровней признаков и напрямую предсказывает токены.
При больших батчах дополнительная работа по черновику и проверке может свести выигрыш на нет. Speculative decoding наиболее перспективен, когда батч сервинга достаточно мал, а доля принятых токенов черновика высока; бенчмаркайте весь цикл сервинга, а не только ядро проверки.
16. Prefix caching и повторное использование KV cache
Вместо того чтобы выбрасывать KV cache по завершении запроса, prefix caching сохраняет его для новых запросов с тем же префиксом токенов. Это сокращает лишний префилл для системных промптов, few-shot примеров, контекста RAG и истории многоходового диалога.
Automatic Prefix Caching в vLLM хеширует блоки KV и ищет их в глобальной хеш-таблице. RadixAttention в SGLang поддерживает radix-дерево кэшированных тензоров KV с гранулярностью до токена. Оба подхода требуют префиксов с одинаковыми токенами и совместимых ключей кэша. Идентичность модели или адаптера, мультимодальные входы и настройки изоляции также могут влиять на повторное использование. Указывайте hit rate рядом с латентностью или throughput.
17. Стриминг на практике
Стриминг отправляет токены клиенту по мере генерации, а не ждёт полного ответа. Многие фреймворки для сервинга отдают его через Server-Sent Events: клиент открывает долгоживущее HTTP-соединение, а сервер присылает каждый токен или пачку токенов событием data:. TTFT определяет, когда пользователь впервые увидит вывод; TPOT помогает определить, насколько плавным он будет. Целевое значение задавайте по результатам тестов продукта и выбранной модели взаимодействия.
На стороне клиента стриминг заставляет принимать решения о буферизации. Отрисовка токен за токеном может вызывать визуальное дрожание, особенно с markdown и блоками кода, которым для корректного форматирования нужен контекст из нескольких токенов. Распространённые паттерны: буферизация по словам (накапливать токены до границы пробела), буферизация по строкам (ждать перевода строки перед отрисовкой) и адаптивная буферизация (прозу показывать сразу, блоки кода буферизовать). В OpenAI Chat Completions API параметр stream_options: {"include_usage": true} добавляет финальный чанк с usage перед сообщением data: [DONE]. При прерывании стрима OpenAI финальный чанк с usage может отсутствовать. Серверы, совместимые с OpenAI, могут отличаться, поэтому проверяйте выбранную реализацию.
Chunked prefill — один из способов не дать длинным префиллам задерживать выдачу токенов параллельным пользователям. Планирование с приоритетом декода может защитить запросы, которые уже выполняются, а дезагрегированный сервинг изолирует префилл и декод на отдельных пулах GPU.
Часть IV — Архитектура модели
Архитектура задаёт объём памяти, поведение аттеншна и динамику обучения, вокруг которых строятся разделы про сервинг и обучение.
18. Основы архитектуры трансформера
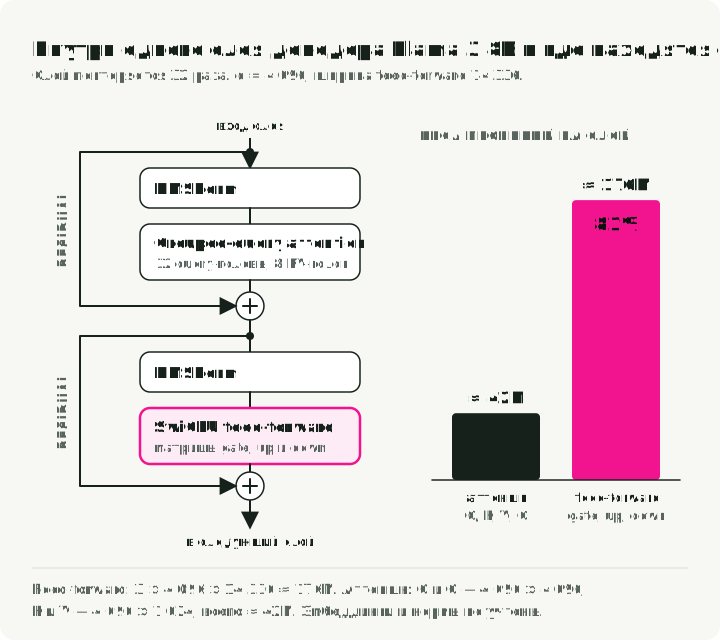
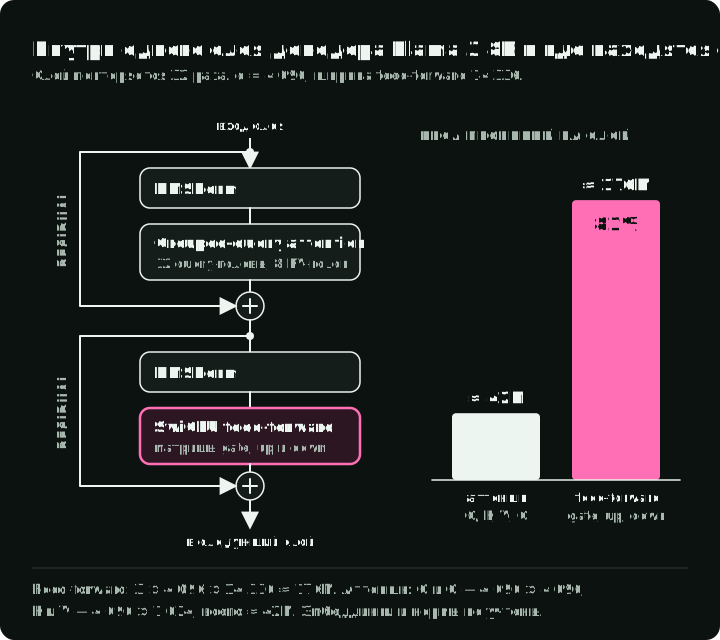
Современный трансформер decoder-only (GPT, Llama) — это стопка одинаковых слоёв, в каждом из которых два подблока: аттеншн и feed-forward. Каждый подблок обёрнут residual-связью и нормализацией. На рисунке показан один слой в стиле Llama, включая два пути, которые обходят подблок, и то, как его веса проекций делятся между аттеншном и feed-forward сетью; компоненты описаны под ним.
Ключевые компоненты:
Multi-Head Attention позволяет каждому токену взвешивать информацию от токенов, видимых по маске аттеншна. Вход проецируется в три матрицы: Queries (что я ищу?), Keys (что я содержу?) и Values (какую информацию я несу?). Оценки аттеншна затем вычисляются так:
Скалярное произведение измеряет сходство между каждой парой токенов. Деление на не даёт скалярным произведениям вырасти слишком сильно (иначе softmax попадает в области с затухающими градиентами). Softmax превращает оценки в вероятности, а умножение на даёт взвешенную комбинацию векторов значений. Параллельный запуск на нескольких головах позволяет модели одновременно обращать внимание на разные отношения (головы могут обучаться разным отношениям; их роли не фиксированы).
Feed-Forward Network (FFN) преобразует представление каждого токена независимо после того, как аттеншн смешал информацию между токенами. Современные LLM часто используют SwiGLU вместо исходной FFN с двумя матрицами и ReLU:
У SwiGLU три матрицы весов против двух у FFN с ReLU, и он использует гладкую функцию Swish. Его применяют Llama, Mistral и Qwen; Gemma использует приближённый GeGLU. Привычное правило «двух третей» применимо к обычному блоку с полным MHA и : две матрицы FFN дают около параметров против около у аттеншна. Для архитектур SwiGLU/GQA это не общая оценка. В Llama 3 8B , , а при восьми key/value-головах FFN даёт M параметров на слой против около 42M параметров проекций аттеншна: около 81% этих весов проекций, не считая эмбеддингов и нормализации.
Residual-связи прибавляют выход каждого подблока к его входу: . Обходной путь улучшает распространение сигнала и градиентов через глубокие стопки.
RMSNorm распространён в современных семействах LLM. LayerNorm центрирует, вычитая среднее, и масштабирует по стандартному отклонению. RMSNorm пропускает вычитание среднего и только масштабирует; в её статье сообщается о сокращении времени выполнения на 7–64% на проверенных моделях и фреймворках без снижения измеренного качества на задачах. Pre-norm, то есть нормализация перед аттеншном или FFN, тоже распространена, потому что улучшает стабильность градиентов.
Оценка числа параметров для обычного декодера с полным MHA, FFN шириной с двумя матрицами и общими входными и выходными эмбеддингами:
где — размер словаря, — скрытая размерность, а — число слоёв. Член — это матрица входных эмбеддингов; член приближает веса аттеншна и FFN в каждом слое. Для Llama 3 8B (, , ) оценка составляет около параметров. Опубликованный итог в 8,03B выше, потому что приближение не учитывает архитектурные детали, такие как точная ширина FFN и отдельная выходная проекция.
19. Модели decoder-only для универсальной генерации
Исходный Transformer (2017) состоял из энкодера и декодера. С тех пор область разделилась на три архитектурных семейства, и одно из них стало стандартом для генеративного AI.
| Семейство | Аттеншн | Цель обучения | Для чего используется сегодня | Примеры |
|---|---|---|---|---|
| Encoder-only | Двунаправленный | Предсказание замаскированных токенов | Эмбеддинги, реранкеры, классификаторы | BERT, RoBERTa |
| Encoder-decoder | Двунаправленный энкодер; каузальный декодер с cross-attention | Sequence to sequence (span corruption, T5) | Перевод, распознавание речи | T5, BART, Whisper |
| Decoder-only | Каузальный | Предсказание следующего токена | Генерация текста общего назначения, чат, код | GPT, Llama |
Модели encoder-only используют двунаправленный аттеншн: каждый токен обращает внимание на все остальные в обоих направлениях. Это даёт представления для задач понимания. Стандартные модели encoder-only обычно не используют как авторегрессионные декодеры; они часто служат базовой архитектурой для эмбеддинг-моделей, реранкеров и лёгких классификаторов (например, роутеров на основе BERT в RouteLLM).
Модели encoder-decoder разделяют понимание и генерацию. Энкодер обрабатывает весь вход с двунаправленным аттеншном, а затем декодер генерирует выход авторегрессионно, обращаясь к представлениям энкодера через cross-attention. Это подходит для задач, где вход и выход — разные последовательности, например для перевода и распознавания речи.
Модели decoder-only, например GPT, Llama и Mistral, используют каузальный аттеншн: каждый токен учитывает себя и предыдущие токены. Четыре полезных свойства для генерации:
- Повторное использование KV cache. При каузальном аттеншне ранние токены никогда не обращаются к более поздним, поэтому их ключи и значения остаются корректными по мере генерации новых токенов. Один кэш на последовательность растёт добавлением (раздел 6). Encoder-decoder дополнительно хранит состояние cross-attention по выходу энкодера.
- Обучение на сыром тексте. Для предсказания следующего токена не нужны парные вход и выход, поэтому любой текстовый корпус подходит как обучающие данные.
- Один повторяющийся блок. Модель — это стопка одинаковых слоёв декодера, без отдельной стопки энкодера или пути cross-attention, которые пришлось бы строить, шардировать и оптимизировать.
- In-context learning. Инструкции, few-shot примеры и запрос — всё это токены одного префикса, поэтому одна модель может освоить новую задачу из промпта.
20. Mixture of experts
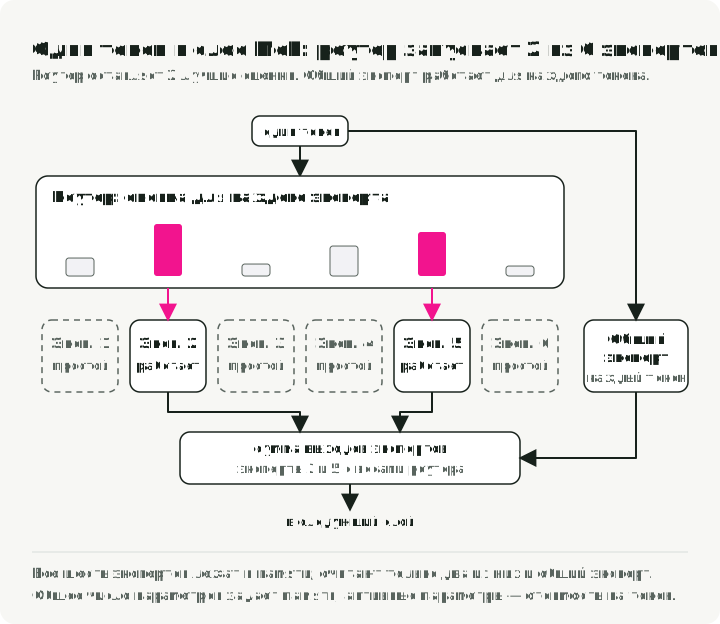
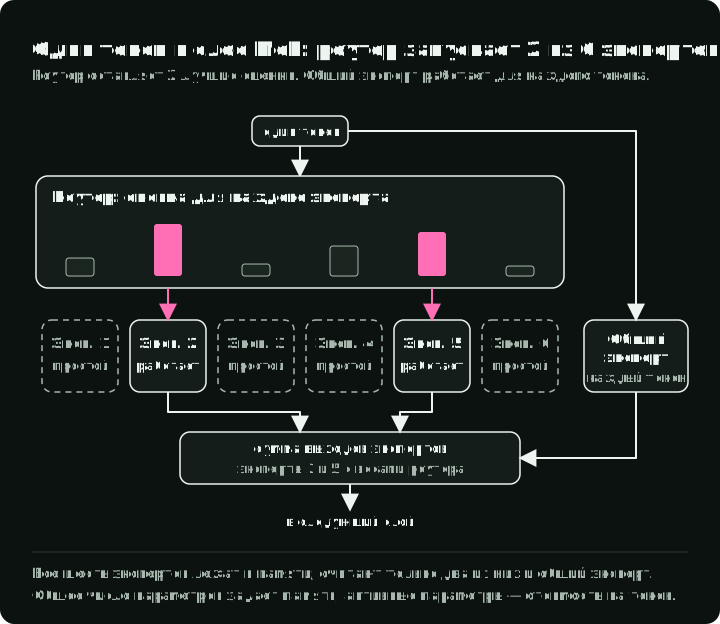
MoE заменяет отдельные плотные FFN несколькими экспертными FFN и лёгким гейтинговым роутером. Роутер вычисляет оценку для каждого эксперта (обычно softmax по обучаемым линейным проекциям) и выбирает для каждого токена top- экспертов. Вычисляют только активированные эксперты, поэтому у модели может быть огромная суммарная ёмкость при низкой стоимости на токен. Это разреженные условные вычисления. Активные параметры приблизительно характеризуют арифметику на токен, но хранить нужно веса всех экспертов. Коммуникация, роутинг, заполнение батча и память KV также влияют на стоимость выполнения. Рисунок прослеживает один токен через слой MoE с шестью маршрутизируемыми экспертами и общим экспертом.
| Модель | Всего параметров | Активных параметров | Эксперты (маршрутизируемые + общие) | Top- |
|---|---|---|---|---|
| Mixtral 8x7B | 47B | ~13B | 8 + 0 | 2 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 | 8 |
Общий эксперт в DeepSeek-V3 активируется для каждого токена. Он даёт базовое представление, поверх которого могут специализироваться маршрутизируемые эксперты.
При обучении MoE регулярно встречаются три проблемы: дисбаланс нагрузки, коллапс экспертов и накладные расходы на коммуникацию для экспертного параллелизма. Традиционные модели MoE добавляют вспомогательный лосс, штрафующий несбалансированный роутинг, но он может конфликтовать с основной целью. DeepSeek-V3 в основном использует батчевую стратегию без вспомогательного лосса: смещения вне обратного распространения снижают оценку перегруженных экспертов и повышают оценку недогруженных. Дополнительно применяется крайне малый комплементарный лосс баланса на уровне последовательности, чтобы не допустить сильного дисбаланса внутри одной последовательности. В статье сообщается о более сбалансированном роутинге без главного компромисса вспомогательного лосса в их постановке.
21. Токенизация: BPE, SentencePiece и tiktoken
LLM не видят текст. Они видят последовательности целочисленных ID токенов. Токенизатор разбивает сырой текст на токены (подслова) и сопоставляет каждому ID. Выбор токенизатора влияет на качество модели, скорость инференса и справедливость к разным языкам.
Byte Pair Encoding (BPE) — самый распространённый алгоритм. Он итеративно объединяет самые частые соседние пары в обучающем корпусе. Упрощённый пример:
- Начинаем со словаря из символов:
[l, o, w, e, r, _] - Самая частая пара —
(l, o)→ объединяем вlo→ словарь:[l, o, w, e, r, _, lo] - Следующая по частоте пара —
(lo, w)→ объединяем вlow→ в словарь добавляетсяlow - Продолжаем, пока словарь не достигнет целевого размера (например, 128K токенов)
Частые слова вроде «the» становятся одиночными токенами, а редкие, например «defenestration», распадаются на подслова вроде ["def", "en", "est", "ration"] в этом вымышленном примере. Фактическое разбиение зависит от токенизатора и его версии. Это компромисс между размером словаря и длиной последовательности.
Три реализации токенизаторов покрывают большую часть production-использования:
- SentencePiece обучается прямо на сыром тексте Unicode без языково-специфичного пре-токенизатора. Он сохраняет пробелы с помощью метасимвола
▁и при желании может откатываться к байтовым токенам UTF-8. Он поддерживает модели BPE и unigram и используется в Llama 1/2, T5 и ранних токенизаторах Mistral. Более новые токенизаторы Mistral Tekken используют BPE в стиле tiktoken. - tiktoken — токенизатор OpenAI на Rust с байтовым BPE. В опубликованном бенчмарке на GPT-2 он работал в 3–6 раз быстрее проверенной конфигурации
GPT2TokenizerFast. Llama 3 перешла с SentencePiece на алгоритм tiktoken. - Hugging Face Tokenizers — широко используемая библиотека на Rust, поддерживающая BPE, WordPiece и Unigram.
Размер словаря сильно различается между семействами моделей:
| Модель | Токенизатор | Размер словаря |
|---|---|---|
| GPT-2 | Byte-level BPE | 50,257 |
| Llama 2 | SentencePiece BPE | 32,000 |
| Llama 3 | BPE в стиле tiktoken | 128,256 |
| GPT-4o | tiktoken o200k_base | ~200K |
При сопоставимых условиях обучения токенизатора больший словарь может означать меньше токенов на тот же текст, но и большую матрицу эмбеддингов (член из раздела 18).
Fertility измеряет, сколько токенов токенизатор выдаёт на слово или другую выбранную единицу текста. Она зависит от конкретного токенизатора, языка, письменности, нормализации, предметной области и выборки. Измеряйте её на репрезентативном трафике, а не экстраполируйте с одного токенизатора или языка.
22. Контекстные окна и позиционные кодировки
Контекстное окно ограничивает последовательность токенов, доступную запросу на генерацию. Chunked prefill и декод с кэшем обрабатывают за один проход только часть этой последовательности. API также могут задавать отдельные ограничения входа и выхода. Опубликованные ограничения:
| Модель | Опубликованный лимит токенов | Год |
|---|---|---|
| Llama 1 | 2,048 | 2023 |
| Llama 3.1 | 128K | 2024 |
| GPT-4.1 | 1,047,576 | 2025 |
| Gemini 2.5 Pro | 1,048,576 на входе | 2025 |
GPT-4.1 также ограничивает выход 32 768 токенами, Gemini 2.5 Pro — 65 536. Строка Gemini указывает лимит входа, а GPT-4.1 — контекстное окно, поэтому эти поля не идентичны.
Аттеншн сравнивает каждую пару видимых токенов, но само сравнение не указывает расстояние между ними. Без позиционной информации полный self-attention не может различить порядок слов одного набора токенов; состояния токенов следуют перестановке входа. Каузальная маска декодера даёт некоторый сигнал порядка, поскольку каждый токен видит только свой префикс, но не задаёт явных относительных позиций. Позиционные кодировки явно добавляют позицию и относительное расстояние.
Три распространённых подхода:
-
RoPE (Rotary Position Embeddings) поворачивает векторы query и key на углы, зависящие от позиции, так что их скалярное произведение зависит от относительной позиции. Оценку аттеншна по-прежнему определяет содержимое токенов; RoPE добавляет информацию о позиции без обучаемых эмбеддингов абсолютных позиций. Его используют открытые семейства моделей, включая Llama, Mistral и Qwen.
-
ALiBi (Attention with Linear Biases) не меняет эмбеддинги и добавляет штраф прямо к оценкам аттеншна: чем дальше друг от друга два токена, тем больше отрицательное смещение. Обучаемых позиционных параметров у него нет. В исходной статье модель на 1,3B, обученная на последовательностях по 1 024 токена, на 2 048 токенах показала результат, сопоставимый с моделью с синусоидальными позициями, обученной на 2 048. Поведение за пределами проверенных в статье моделей и длин зависит от модели.
-
YaRN (Yet another RoPE extensioN) расширяет модель с RoPE за пределы её обучающего контекста. Он группирует частотные измерения в три категории и масштабирует каждую по-своему. В сравнении с одинаковой схемой обучения в статье с интерполяцией позиций YaRN использовал 400 вместо 1000 шагов обучения (приложение B.2). Более широкое утверждение аннотации о 10x меньшем объёме данных использует другое сравнение.
Часть V — Обучение и алайнмент
Эта часть различает цель, которая создаёт способности, техники, позволяющие обучению поместиться в доступное железо, и методы, которые затем формируют поведение модели.
23. Претрейнинг, файн-тюнинг и алайнмент
Претрейнинг авторегрессионной LLM использует самосупервизорное предсказание следующего токена на большом корпусе. Энкодерные модели могут использовать другие цели, например предсказание замаскированных токенов. Его вычислительные затраты охватывают много порядков величины; например, Llama 3 405B потребовала FLOPs. Supervised fine-tuning (SFT) адаптирует предобученную модель к размеченным данным конкретной задачи. RLHF / RLAIF формирует поведение по данным о предпочтениях: традиционный пайплайн RLHF собирает сравнения, обучает reward-модель, а затем оптимизирует политику. RLAIF заменяет часть человеческих оценок обратной связью, сгенерированной AI. Раздел 31 разбирает дистилляцию — отдельный путь, на котором выровненная модель-учитель генерирует обучающие данные для меньшей модели-ученика.
Вычислительные затраты зависят от размера модели, длины последовательности, объёма данных, оптимизатора и метода. PPO также несёт больше состояния модели, чем SFT, потому что типичная конфигурация включает модели политики, референса, reward и критика. Полную схему решения о файн-тюнинге я разобрал в статье Руководство по файн-тюнингу LLM.
24. LoRA и QLoRA: параметрически эффективный файн-тюнинг
LoRA замораживает предобученные веса и добавляет обучаемые матрицы низкого ранга () и (), так что обновлённый вес равен . В статье про LoRA число обучаемых параметров GPT-3 175B в их постановке сократили до примерно 18 миллионов. Ранг — это параметр настройки, а не правило, привязанное к сложности задачи; выбирайте его перебором по качеству и памяти. Адаптеры LoRA после обучения можно слить с базовыми весами, чтобы не иметь отдельного пути адаптера на инференсе.
QLoRA загружает базовую модель в 4-битной квантизации NF4 и обучает адаптеры LoRA в BF16. NormalFloat4 размещает больше уровней квантизации вблизи нуля, где плотность весов наибольшая. В статье модель 65B дообучили на одном GPU на 48 GB и получили результаты, близкие к 16-битным базам. Компромиссы по рантайму и памяти относятся к проверенному стеку.
25. Обучение со смешанной точностью
Каждый формат с плавающей точкой распределяет свои биты между тремя полями: знак (всегда 1 бит), экспонента (задаёт динамический диапазон) и мантисса (задаёт точность). Больше бит экспоненты — шире диапазон представимых величин; больше бит мантиссы — тоньше различия между близкими значениями. У целочисленных форматов экспоненты нет совсем, они представляют только равномерно расположенные целые числа в фиксированном диапазоне.
| Формат | Бит | Раскладка (S / E / M) | Диапазон | Точность | Типичное применение |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ~7 десятичных цифр | Мастер-веса, состояния оптимизатора (момент и дисперсия Adam) | |
| BF16 | 16 | 1 / 8 / 7 | ~2 десятичные цифры | Предпочтительный формат для обучения; тот же диапазон, что у FP32, и обычно без loss scaling | |
| FP16 | 16 | 1 / 5 / 10 | ~3 десятичные цифры | Обучение с loss scaling (старые GPU); инференс на железе до Hopper | |
| FP8 E4M3 | 8 | 1 / 4 / 3 | ~1 десятичная цифра | Проход вперёд на Hopper (H100) — выше точность для весов и активаций | |
| FP8 E5M2 | 8 | 1 / 5 / 2 | ~0,6 десятичной цифры | Проход назад на Hopper — шире диапазон для градиентов | |
| INT8 | 8 | целое со знаком | … | Точные целые числа | Посттренировочная квантизация весов для инференса (W8A8); квантизация KV cache |
| INT4 | 4 | целое со знаком | … | Точные целые числа | Агрессивная квантизация только весов (AWQ, GPTQ) для инференса на железе с ограниченной памятью |
BF16 имеет тот же диапазон, что FP32, потому что диапазон задаётся полем экспоненты, а BF16 сохраняет все 8 бит экспоненты из FP32. Взамен он отдаёт биты мантиссы (7 против 23): меняет точность на двукратное сокращение памяти и при этом избегает многих проблем с диапазоном, которые затрагивают обучение в FP16. У FP16 всего 5 бит экспоненты, поэтому его конечный диапазон ограничен примерно 65K. Многие градиенты, наоборот, слишком малы для FP16 и обнуляются при потере значимости. Loss scaling умножает лосс перед обратным распространением, чтобы эти градиенты оставались представимыми, а перед шагом оптимизатора возвращает масштаб; динамическое масштабирование уменьшает множитель при переполнении. Более широкий диапазон экспоненты BF16 обычно избавляет от этого требования.
Целочисленные форматы нетипичны для основной арифметики обучения, потому что обратному распространению нужен широкий динамический диапазон. Их широко используют для инференса, где замороженные веса можно отобразить на калиброванные масштабы. Квантизация весов в INT4 сокращает модель 7B примерно с 14 GB до 3,5 GB до накладных расходов рантайма; качество необходимо измерить для выбранной модели и метода.
Обучение в FP8 на H100 через Transformer Engine использует E4M3 там, где важна точность, и E5M2 там, где важнее более широкий диапазон. В статье FP8-LM сообщается, что её фреймворк смешанной точности обучал GPT-175B на 75% быстрее, чем база BF16 на Megatron-LM, и на 37% быстрее, чем NVIDIA Transformer Engine, в проверенной конфигурации на H100. DeepSeek-V3 использовала смешанную точность FP8 и сообщила о примерно $5.6 млн в пересчёте на аренду вычислений для финального обучающего прогона без учёта R&D и инфраструктуры.
26. Gradient checkpointing
Каждый слой прохода вперёд порождает промежуточный выход, называемый активацией:
Обычно все активации должны оставаться в памяти, потому что они нужны обратному распространению для вычисления градиентов. В глубоком трансформере сохранённые активации могут занимать больше памяти, чем сами веса модели.
Gradient checkpointing меняет вычисления на память: большая часть активаций отбрасывается и пересчитывается на лету во время backprop. Стандартная стратегия (Chen et al., 2016) делит сеть из слоёв на равномерно расположенных сегментов и сохраняет только граничную активацию каждого сегмента. Эти сохранённые границы и есть «чекпоинты». Все промежуточные активации внутри сегмента сразу отбрасываются.
Когда обратный проход доходит до слоя внутри сегмента, его активации пересчитываются от ближайшего чекпоинта. При равномерной сегментации память под сохранённые активации падает с до . Каждый сегмент пересчитывается один раз, что стоит примерно одного дополнительного прохода вперёд на шаг обучения (Chen et al., 2016). Реальная экономия памяти и накладные расходы на пересчёт зависят от модели, границ чекпоинтов, длины последовательности, фреймворка и реализации, поэтому измеряйте оба показателя на целевом прогоне обучения. FlashAttention применяет тот же принцип внутри аттеншна, не материализуя полную матрицу внимания. Для обычных запусков Hugging Face Trainer включите его через gradient_checkpointing=True. При FSDP используйте интеграцию activation checkpointing фреймворка, если она поддерживается; общая опция может вызывать избыточные all-gather в обратном проходе.
27. Стадии DeepSpeed ZeRO
При стандартном параллелизме данных каждый GPU хранит полную копию весов модели, градиентов и состояний оптимизатора. Для Adam каждый параметр занимает 2 байта на вес FP16 + 4 байта на мастер-вес FP32 + 4 байта на момент + 4 байта на дисперсию + 2 байта на градиент, то есть 16 байт на параметр. Модели на 7,5B параметров нужно ~120 GB на каждый GPU, и каждый GPU хранит одно и то же. На 64 GPU это 64 одинаковые копии по 120 GB.
DeepSpeed ZeRO (Zero Redundancy Optimizer) убирает это дублирование: вместо репликации компоненты шардируются между GPU:
- Стадия 1 — разделение состояний оптимизатора. Каждый GPU хранит только 1/N состояний оптимизатора (мастер-веса FP32 плюс первый и второй моменты Adam, 12 байт/параметр). Когда GPU нужно обновить вес, он обновляет только свой фрагмент и рассылает результат. При допущениях ниже память падает со ~120 GB до ~41,3 GB на GPU.
- Стадия 2 — дополнительно разделяются градиенты. Градиенты (2 байта/параметр) больше не сводятся через all-reduce на каждый GPU. Каждый GPU получает через reduce-scatter только тот фрагмент градиента, который ему нужен. При тех же допущениях память падает до ~28,1 GB на GPU.
- Стадия 3 — дополнительно разделяются веса модели. Каждый GPU хранит только 1/N весов FP16. Перед проходом вперёд или назад каждого слоя GPU вызывает all-gather, чтобы временно собрать полные веса слоя со всех остальных GPU, считает и отбрасывает собранные веса. При тех же допущениях память падает до ~15,0 GB на GPU.
Рисунок в масштабе показывает состояние модели на каждом GPU на каждой стадии вместе со стоимостью коммуникации на этой стадии.
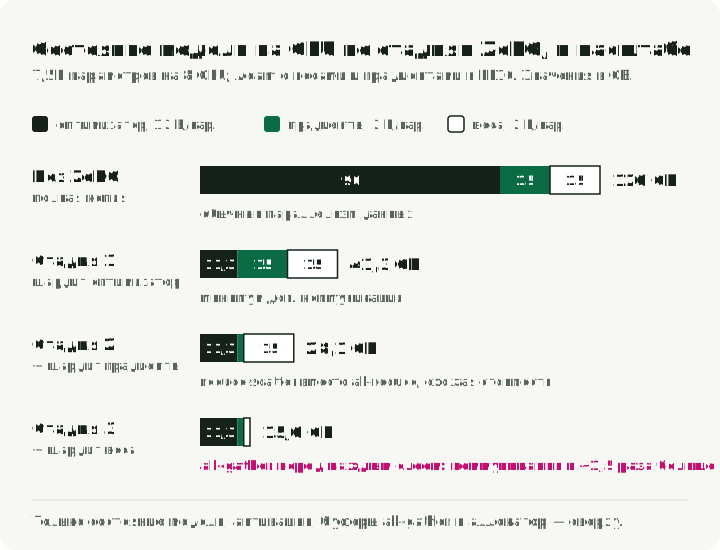
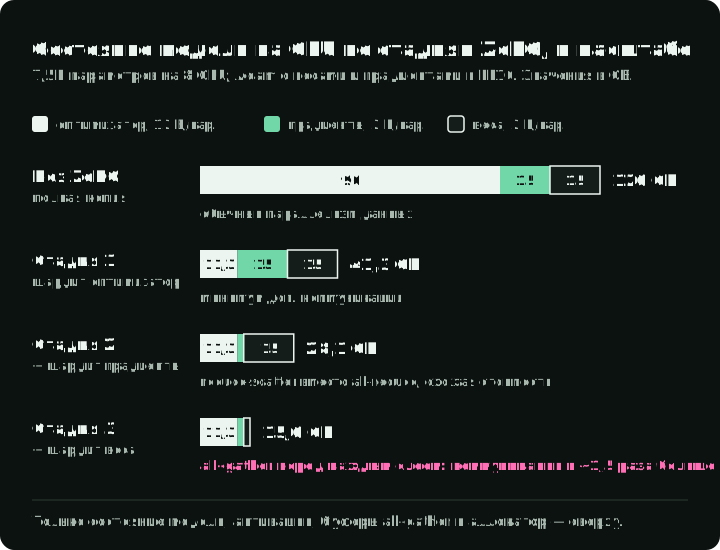
Это приблизительные значения состояния модели для модели на 7,5B параметров на 8 GPU (размер мира ) с весами и градиентами FP16 и мастер-весами, моментом и дисперсией Adam в FP32. Они не включают активации, временные буферы all-gather, фрагментацию аллокатора и накладные расходы фреймворка и рантайма. Граница расчёта: байт на параметр, причём каждое состояние делится на только на тех стадиях, которые его шардируют.
Чтобы повторить расчёт для другого размера модели или числа GPU:
def zero_model_state_gb(params_b, n_gpus, stage):
    """Model-state GB per GPU for Adam with FP16 weights and gradients.

    Optimizer states (FP32 master weights, momentum, variance) take 12 bytes
    per parameter, gradients 2, and weights 2. Stage 1 shards the optimizer
    states, stage 2 also the gradients, and stage 3 also the weights.
    """
    optimizer, gradients, weights = 12, 2, 2
    if stage >= 1:
        optimizer /= n_gpus
    if stage >= 2:
        gradients /= n_gpus
    if stage >= 3:
        weights /= n_gpus
    return params_b * (optimizer + gradients + weights)

for stage in range(4):
    print(f"stage {stage}: {zero_model_state_gb(7.5, 8, stage):g} GB per GPU")

assert [zero_model_state_gb(7.5, 8, s) for s in range(4)] == [120.0, 41.25, 28.125, 15.0]
# 70B parameters: Stage 3 on 8 GPUs still needs 140 GB of model state per GPU;
# 16 GPUs bring it to 70 GB, before activations.
assert zero_model_state_gb(70, 8, 3) == 140.0
assert zero_model_state_gb(70, 16, 3) == 70.0
Цена — коммуникация. Стадия 1 добавляет минимальные накладные расходы, а стадия 2 заменяет all-reduce на reduce-scatter при сопоставимой стоимости. Стадии 3 нужны вызовы all-gather перед каждым слоем и на проходе вперёд, и на проходе назад, то есть примерно в 1,5 раза больший объём коммуникации по сравнению со стандартным параллелизмом данных.
ZeRO-Infinity расширяет стадию 3: разделённые состояния выгружаются в оперативную память CPU и даже на NVMe SSD, что может сделать возможным обучение моделей с триллионами параметров на ограниченных кластерах GPU. Выгрузка на накопители добавляет стоимость PCIe и передачи данных; измеряемый эффект зависит от диска, топологии PCIe, разделения, предвыборки, перекрытия передач и нагрузки. Используйте её, чтобы удовлетворить требования к ёмкости, а не исходя из фиксированного замедления, и профилируйте целевую конфигурацию.
28. FSDP: нативное шардирование в PyTorch
Fully Sharded Data Parallel (FSDP) — встроенный в PyTorch ответ на DeepSpeed ZeRO-3. Он шардирует параметры, градиенты и состояния оптимизатора между GPU на той же основной идее. При включённых полном шардинге и решардинге операции для каждой обёрнутой единицы такие:
- All-gather полных параметров со всех GPU (временно собрать слой целиком).
- Вычислить проход вперёд или назад для этого слоя.
- Освободить собранные параметры сразу. Каждый GPU хранит только свой шард.
- Reduce-scatter градиентов, чтобы каждый GPU получил только отведённый ему фрагмент градиента.
Поскольку FSDP нативен для PyTorch, он напрямую интегрируется с инструментами отладки PyTorch, профилировщиками и torch.compile. Производительность относительно DeepSpeed ZeRO-3 зависит от политики обёртывания, топологии коммуникаций, настроек выгрузки и размера модели, поэтому сравнивайте их на одном кластере.
| Критерий | FSDP (PyTorch) | DeepSpeed ZeRO |
|---|---|---|
| Стиль управления | Полное шардирование через API PyTorch | Выбираемые стадии ZeRO |
| Выгрузка | Выгрузка на CPU | CPU + NVMe с ZeRO-Infinity |
| Интеграция с фреймворком | Нативный PyTorch, пути torch.compile | Отдельная библиотека и система конфигурации |
| Критерий выбора | Профилируйте целевую нагрузку на PyTorch | Профилируйте нужные функции и выгрузку |
FSDP2 (2024–2025) — переписанная версия, которая лучше интегрируется с torch.compile для более эффективного слияния ядер, добавляет поддержку обучения в FP8 через TorchAO и упрощает API. И FSDP, и DeepSpeed доступны через Hugging Face Accelerate, который поддерживает оба варианта через конфигурацию для совместимых, подготовленных скриптов обучения. Требуемые настройки wrapping, checkpointing и offload всё равно различаются.
29. Scaling laws и стоимость инференса
Chinchilla scaling (DeepMind, 2022) нашёл вычислительно оптимальное распределение около 20 обучающих токенов на параметр при своих допущениях. Эта цель не включает стоимость последующего сервинга. Если меньшая модель, обученная на большем объёме данных, достигает нужного качества, она может обойтись дешевле за жизненный цикл с большим объёмом инференса.
Одна из стратегий снижения стоимости жизненного цикла — обучить меньшую модель на гораздо большем объёме данных:
| Модель | Параметры | Токены обучения | Токенов/параметр | Токенов/параметр ÷ 20 (расчёт) |
|---|---|---|---|---|
| Chinchilla | 70B | 1.4T | 20:1 | 1× |
| Llama 1 | 65B | 1.4T | 22:1 | 1× |
| Llama 2 | 70B | 2.0T | 29:1 | 1.4× |
| Llama 3 8B | 8B | 15T | 1,875:1 | 94× |
| Qwen3-0.6B | 0.6B | 36T | 60,000:1 | 3,000× |
Это указанное в таблице отношение токенов к параметрам, делённое на приблизительную точку в 20 токенов на параметр из статьи про Chinchilla. Это описательное отношение, а не измеренный множитель качества или стоимости.
Для модели, которая обслуживает большой объём запросов, дополнительные вычисления на обучение меньшей модели могут снизить стоимость жизненного цикла. Llama 3 8B иллюстрирует эту стратегию, но выигрывает ли она, зависит от требуемого качества и прогнозируемого объёма инференса. «Chinchilla-optimal» относится к эффективности вычислений на обучение, а это другая цель, чем стоимость жизненного цикла.
30. RLHF, DPO, GRPO и ландшафт алайнмента
Алайнмент направляет предобученную модель к желаемым инструкциям, предпочтениям и политикам безопасности. Сам по себе он не гарантирует правдивость или безопасное поведение. Методы ниже по-разному балансируют сложность реализации, требования к данным, исследование и стабильность обучения.
Классический пайплайн RLHF: SFT → сбор пар человеческих предпочтений → обучение reward-модели на этих парах → файн-тюнинг политики с помощью PPO (Proximal Policy Optimization). В обычной конфигурации PPO четыре роли моделей: политика, референс, критик/value-модель и reward-модель. Потребление памяти зависит от совместного использования, шардинга, точности, выгрузки и размещения; четыре роли не означают четыре полные копии в памяти GPU. PPO также чувствителен к гиперпараметрам. Он также склонен к reward hacking, когда модель эксплуатирует особенности reward-модели, например многословные уверенно звучащие ответы, вместо реального улучшения качества.
DPO (Direct Preference Optimization) обходится без обучаемой reward-модели и онлайнового цикла RL, напрямую оптимизируя лосс на парах предпочтений. Это упрощает пайплайн обучения. Стандартный DPO офлайновый: он обучается на фиксированном датасете и не исследует новые ответы в цикле обновления. Важно ли это ограничение, зависит от задачи и покрытия данных.
GRPO (Group Relative Policy Optimization, DeepSeek) убирает обучаемого критика из PPO: для каждого промпта генерируется несколько ответов, а в качестве базы используются групповые относительные награды. Это снижает нагрузку на состояние модели по сравнению с типичной конфигурацией PPO. В отличие от DPO, GRPO on-policy: модель генерирует свежие ответы прямо во время обучения. DeepSeek-R1 сочетает GRPO с RLVR (reinforcement learning from verifiable rewards), используя проверки вроде ответов на математические задачи, компиляции кода и юнит-тестов. Такие награды проще аудировать, чем выученную оценку предпочтений, но неполные тесты и прокси-цели всё равно можно эксплуатировать.
| Метод | Роли моделей в обычной конфигурации | Сигнал награды | Online/offline | Ключевое ограничение |
|---|---|---|---|---|
| PPO | Политика, референс, критик, reward | Обученная reward-модель | Online | Reward hacking, сложная настройка |
| DPO | Политика и референсные оценки, которые можно вычислить заранее | Неявный (пары предпочтений) | Offline | Нет исследования, фиксированные данные |
| GRPO | Политика; опциональный референс для KL и опциональная обученная reward-модель | Явный (правило/верификатор или обученный) | Online | Зависит от качества награды и информативного разброса внутри группы |
Референсная политика в GRPO зависит от реализации. Например, TRL GRPOTrainer не загружает референсную модель, когда коэффициент KL beta равен нулю. При сравнении памяти для обучения учитывайте размещение моделей и точность.
31. Дистилляция: сжатие знаний между моделями
Дистилляция знаний переносит способности от большой модели-учителя к меньшей модели-ученику. Дистилляция по логитам обучает ученика воспроизводить выходное распределение учителя. Дистилляция по данным заставляет учителя генерировать примеры, на которых ученик проходит файн-тюнинг. Методы по данным распространены для LLM, потому что работают между разными архитектурами и с учителями, доступными только через API, но их ценность ограничена качеством учителя, покрытием данных, фильтрацией и стоимостью генерации.
DeepSeek-R1 отобрала смесь примерно из 800 000 примеров — около 600 000 образцов, связанных с ризонингом, и 200 000 образцов без ризонинга — и использовала её для дистилляции моделей Qwen2.5 и Llama 3 размером от 1,5B до 70B параметров. В оценке из статьи:
- DeepSeek-R1-Distill-Qwen-32B набирает 72,6% на AIME 2024 и 94,3% на MATH-500, выше приведённых в статье результатов OpenAI o1-mini.
- DeepSeek-R1-Distill-Qwen-7B набирает 55,5% на AIME 2024, выше результата QwQ-32B-Preview из статьи, при меньшей модели.
В экспериментах DeepSeek-R1 с малыми моделями дистилляция превзошла прямой GRPO на проверенных базовых моделях. Этот результат говорит в пользу дистилляции для данной постановки; он не устанавливает универсального рейтинга между дистилляцией и RL.
32. Генерация синтетических данных
Обучающие данные, сгенерированные LLM, используются в нескольких повторяющихся паттернах:
- Self-Instruct стартует с небольшого начального набора написанных человеком инструкций: LLM генерирует новые инструкции, входы и выходы, которые фильтруются и возвращаются в пул. В проекте Alpaca использовали 52 000 примеров, сгенерированных из 175 начальных. Stanford сообщил о стоимости генерации данных менее $500 и файн-тюнинга менее $100, то есть о стоимости первоначального воспроизведения менее $600; сравнение с GPT-3.5 было ограниченной оценкой проекта, а не доказательством широкой эквивалентности.
- Evol-Instruct (WizardLM) берёт существующие инструкции и итеративно развивает их по осям сложности (добавляет ограничения, углубляет ризонинг, делает задачи конкретнее), чтобы получать всё более сложные обучающие примеры.
- Phi-4 (14B) от Microsoft использовала синтетические данные для значительной части претрейнинга, включая генерацию, критику, самопересмотр и обращение инструкций. Её технический отчёт сравнивает полученные результаты по STEM и коду с более крупными моделями на выбранных бенчмарках.
Один из рисков — коллапс модели при рекурсивной замене реальных данных сгенерированными. В изученных условиях редкие части исходного распределения постепенно исчезают (Shumailov et al., опубликовано в Nature в 2024 году). Это не неизбежный результат любого использования синтетических данных. Отдельное исследование накопления обнаружило иное поведение, когда реальные и сгенерированные данные сохранялись между поколениями. Отдельное исследование классификатора Ahrefs взяло по одной недавно обнаруженной английской странице на домен из 900 000 страниц в апреле 2025 года и классифицировало 74,2% как содержащие хотя бы часть текста, сгенерированного AI. Это исследование вендора не является переписью всего веба. Смягчение начинается со смешивания синтетических и реальных данных, фильтрации и отслеживания происхождения, чтобы рекурсивно сгенерированный материал можно было измерить.
Часть VI — Масштабирование и деплой
Когда нагрузка перестаёт помещаться или укладываться в SLO на одном устройстве, выбирать нужно, как разделить работу, какой рантайм даёт нужные рычаги и нужна ли каждому запросу одна и та же модель.
33. Четыре формы параллелизма
Эти четыре формы различаются тем, какую часть модели хранит каждый GPU и что передаётся по связи между GPU. Рисунок показывает каждую из них на двух GPU.
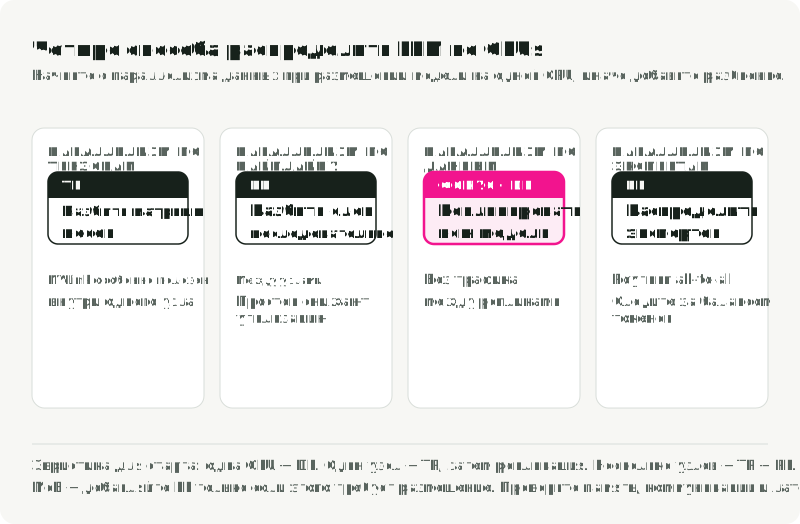
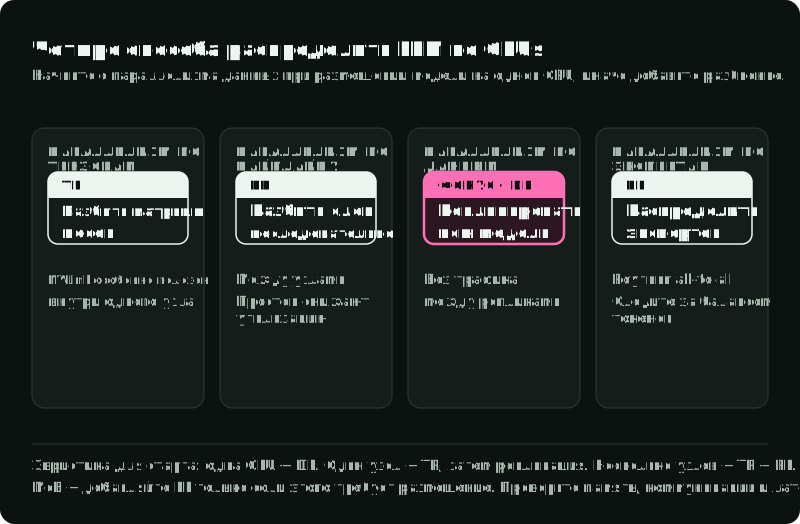
Тензорный параллелизм (TP) разделяет отдельные матрицы весов между GPU и обычно обменивается данными после каждого слоя. Быстрые внутриузловые связи вроде NVLink делают его наиболее практичным внутри одного узла. Больше шардов уменьшают память и вычисления на устройство, но увеличивают коммуникацию, поэтому степень параллелизма выбирайте по бенчмарку латентности.
Конвейерный параллелизм (PP) последовательно разделяет слои между GPU, передавая активации между стадиями. Его паттерн коммуникации может работать между узлами, но пузыри конвейера и неравномерное время стадий снижают утилизацию. Крупные деплои часто сочетают TP внутри узла и PP между узлами.
Параллелизм данных (DP) реплицирует модель для сервинга, так что каждая реплика обрабатывает независимые запросы без коммуникации между репликами на каждый запрос. Он эффективен, когда модель помещается и трафик можно сбалансировать. В обучении DP обычно сочетают с ZeRO или FSDP, чтобы шардировать состояние.
Экспертный параллелизм (EP) распределяет экспертов MoE между GPU, используя коммуникацию all-to-all для роутинга токенов. Его производительность зависит от баланса токенов, размещения экспертов и топологии соединений; трафик all-to-all может стать главным боттлнеком.
Стартовая эвристика по параллелизму:
- Модель помещается на один GPU: начните с независимых реплик и измерьте масштабирование DP.
- Модель помещается в один узел: проверьте TP внутри узла, затем реплицируйте группу, если этого требует трафик.
- Модель занимает несколько узлов: проверьте сочетание TP и PP относительно соединения и целевой латентности.
- Mixture of experts: добавляйте EP, только если этого требует размещение экспертов.
34. Сравнение фреймворков для сервинга
Рантайм определяет, какие оптимизации из части III вы получите без написания ядер. Выберите по таблице первый вариант для бенчмарка, затем сравните его с одной альтернативой на тех же промптах, длинах ответов, железе и SLO.
| Рантайм | Когда использовать | Что проверить в первую очередь |
|---|---|---|
| vLLM | Универсальный сервинг на GPU с OpenAI-совместимым API | Целевую модель и GPU в актуальной матрице совместимости |
| SGLang | Трафик делит длинные префиксы (системные промпты, многоходовой чат, агенты) или требует structured output | Hit rate prefix cache на вашем собственном трафике |
| TensorRT-LLM | Парк состоит только из NVIDIA, и минимальная латентность важнее переносимости | Поддержку вашей модели и точности (FP8, FP4) |
| llama.cpp | CPU, Apple silicon или один потребительский GPU, квантизованные модели GGUF | Токены в секунду по его бенчмарк-инструменту на целевой машине |
| Ollama | Локальная разработка и демо | Переходите на рантайм для сервинга до высокой конкурентности или работы с SLO |
Те же отправные точки для бенчмарков в виде упорядоченного списка:
- Одна локальная машина или один потребительский GPU: начните с llama.cpp, а для разработки с Ollama.
- Только NVIDIA и латентность приоритетна: включите TensorRT-LLM в бенчмарк.
- Длинные общие префиксы или structured output: SGLang.
- Иначе: vLLM.
Проверьте первый выбор бенчмарком на ваших промптах, длинах вывода, железе и SLO.
vLLM предоставляет страничное выделение KV, continuous batching, OpenAI-совместимый API и несколько режимов параллелизма. Поддержка моделей и железа в нём часто меняется.
SGLang сочетает RadixAttention для повторного использования префиксов, собственный планировщик и структурированную генерацию. Опубликованный выигрыш в throughput зависит от нагрузки и конфигурации.
TensorRT-LLM нацелен на низкую латентность отдельных запросов за счёт захвата и повторного выполнения графов CUDA, которые снижают накладные расходы на запуск, и оптимизации ядер, включая слияние, с нативной поддержкой FP8/FP4. Более ранние версии, например v1.2.0, поддерживали предварительную сборку движка TensorRT. В текущем руководстве по миграции NVIDIA указывает PyTorch как единственный бэкенд: API LLM и trtllm-serve напрямую загружают чекпоинт Hugging Face, без сборки движка. Опубликованные показатели относятся к конкретному оборудованию и моделям; TensorRT-LLM работает только на GPU NVIDIA.
TGI был архивирован 21 марта 2026 года, и его репозиторий доступен только для чтения. В его README для новых деплоев рекомендуются vLLM, SGLang, llama.cpp или MLX.
Ollama делает упор на простой локальный рабочий процесс с моделями.
llama.cpp — переносимый рантайм на C/C++ с путями для ARM, x86, Metal, CUDA, ROCm и Vulkan. GGUF поддерживает несколько уровней квантизации. Производительность сильно зависит от модели, квантизации, контекста и бэкенда.
35. Выбор GPU для инференса
Таблица сравнивает опубликованные характеристики железа. Поддержка точностей вендором не делает пиковые вычислительные показатели напрямую сопоставимыми между форматами, поэтому выбирайте сначала по тому, помещается ли модель в память, а затем бенчмаркайте целевую нагрузку. Актуальные цены в облаках проверяйте отдельно: они зависят от провайдера, региона, обязательств и доступности.
| GPU | Память | Пропускная способность | Нативная низкая точность | NVLink на GPU |
|---|---|---|---|---|
| B200 SXM | 180 GB HBM3e | До 8 TB/s | FP4, FP8 | 1,8 TB/s |
| H200 SXM | 141 GB HBM3e | 4,8 TB/s | FP8 | 900 GB/s |
| H100 SXM | 80 GB HBM3 | 3,35 TB/s | FP8 | 900 GB/s |
| A100 80 GB SXM | 80 GB HBM2e | 2,039 TB/s | INT8 (без FP8) | 600 GB/s |
| L40S | 48 GB GDDR6 | 864 GB/s | FP8 | Нет |
| A10G (AWS G5) | 24 GB GDDR6 | 600 GB/s | INT8 (без FP8) | Нет |
| RTX 4090 | 24 GB GDDR6X | ~1 TB/s | FP8 | Нет |
Строка A10G использует спецификацию NVIDIA A10 как приближение пропускной способности; указанная спецификация AWS G5 не устанавливает точную пропускную способность A10G. Значение для RTX 4090 (1008 GB/s) взято из документа об архитектуре Ada.
Ёмкость 141 GB у H200 может упростить некоторые деплои больших моделей. У карт GDDR в нижних строках пропускная способность составляет треть от H100 или меньше, и NVLink отсутствует, поэтому они лучше подходят для квантизованных моделей, помещающихся на один GPU, чем для моделей, которым нужен тензорный параллелизм.
AWQ и GPTQ обслуживают 4-битные модели, деквантизуя поддерживаемые матричные операции в вычислительный формат вроде FP16 или BF16. Совместимость и скорость всё равно зависят от архитектуры модели, формата квантизации, бэкенда сервинга, ядра и GPU, поэтому проверяйте матрицу поддержки бэкенда и бенчмаркайте конкретный артефакт. Все перечисленные GPU поддерживают матричные операции INT8.
Декод LLM часто ограничен пропускной способностью памяти, поэтому ёмкость и пропускная способность HBM для задач сервинга могут значить больше, чем пиковые TFLOPS. Сравнивайте GPU, держа неизменными модель, точность, распределение батчей, длину контекста и целевую латентность.
36. Каскадирование и роутинг моделей
Роутинг моделей выбирает, какая LLM обработает каждый запрос, исходя из предсказанной сложности или нужных возможностей. RouteLLM (LMSYS/UC Berkeley, ICLR 2025) сообщает в таблице 6 об отношении стоимости 3,66x при 95% базового балла GPT-4-Turbo на MT-Bench. Это соответствует примерно 73% снижению расчётной стоимости при ценах, слабой модели и схеме оценки того эксперимента. Окупится ли роутинг, зависит от текущих цен, структуры трафика, ошибок роутера и минимально допустимого качества.
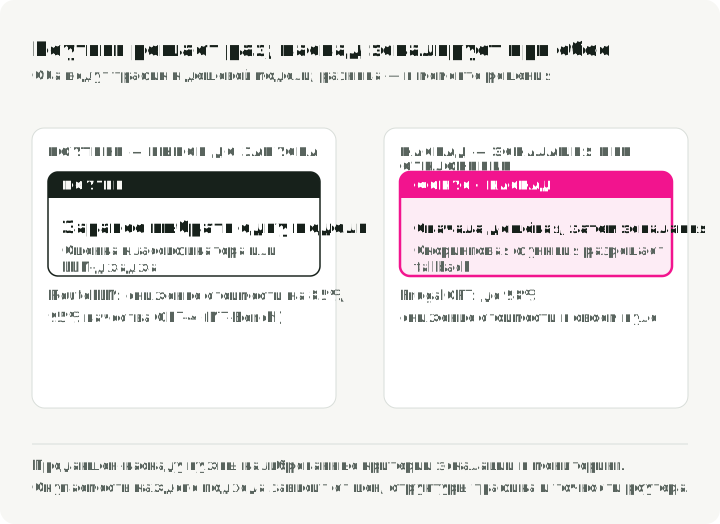
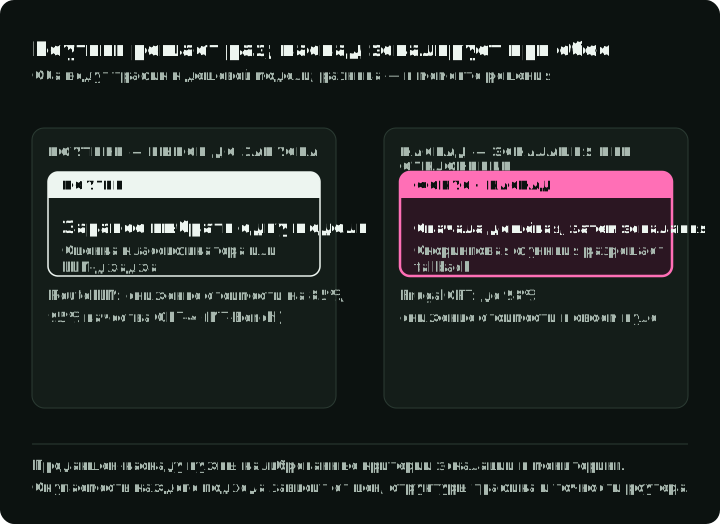
Роутеры варьируются от лёгких классификаторов до джаджей на основе LLM. Каскадирование — последовательный вариант: запрос начинает с более дешёвой модели и переходит к более сильной, если функция оценки отклоняет ответ. FrugalGPT сообщает о снижении стоимости до 98% или росте точности до 4% в оцениваемом пуле моделей. Production-каскаду нужны откалиброванные критерии эскалации и мониторинг запросов, которые дешёвая модель приняла ошибочно. Рисунок показывает, где каждый подход делает свой выбор и где каждый из них даёт сбой.
Часть VII — Приложения
Приложения ломаются в местах, которые стек сервинга не видит. Retrieval может подвести ещё до начала генерации, агенты могут выбрать недопустимое действие, а изменение промпта может улучшить одну задачу и сломать другую.
37. Эмбеддинг-модели и генеративные модели
Эмбеддинг-модели кодируют текст в векторы фиксированной размерности, которые передают семантический смысл. Сравниваемые ниже одновекторные модели возвращают один плотный вектор на вход, обычно размерностью от нескольких сотен до нескольких тысяч. Другие архитектуры retrieval могут хранить несколько векторов на уровне токенов; следующее сравнение хранения относится к одновекторным эмбеддингам. Их основой служат двунаправленные трансформеры encoder-only и модели на основе декодера, адаптированные для обучения представлений. Слой пулинга часто сворачивает представления отдельных токенов в один вектор через усреднение, специальный классификационный токен или метод последнего токена, зависящий от модели. Затем контрастивный файн-тюнинг сближает семантически похожие тексты и отдаляет непохожие.
Современные эмбеддинг-модели различаются свойствами, которые определяют стоимость хранения и выбор индекса: выходной размерностью, принимаемыми типами входа, способом развёртывания и точностью выхода.
| Модель | Макс. размерность | Вход | Веса | Нативная точность выхода |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 4,096 (32–4,096 через MRL) | Текст | Открытые (Apache 2.0) | Float |
| Gemini Embedding 2 | 3,072 (128–3,072) | Текст, изображение, видео, аудио, PDF | API | Не указана |
| pplx-embed-v1-4B | 2,560 (MRL) | Текст | Открытые (MIT) | INT8 и бинарная |
| OpenAI text-embedding-3-large | 3,072 (сокращается через dimensions) | Текст | API | Float |
Это примеры, а не рейтинг. Оценивайте язык, модальность, задачу, размерность и стоимость сервинга на одном наборе для retrieval.
Matryoshka Representation Learning (MRL, Kusupati et al., NeurIPS 2022) делает размерность эмбеддинга гибкой. Название дано по русским матрёшкам. MRL обучает выбранные префиксы эмбеддингов сохранять полезную информацию. В экспериментах эти префиксы сравниваются с отдельно обученными представлениями меньшей размерности; совпадение качества — эмпирический результат, а не гарантия для любой задачи. Во время обучения MRL агрегирует лоссы по выбранному набору из префиксных размерностей, обычно по последовательным делениям пополам; в примере из статьи для 2048-мерного случая это . Агрегированный лосс заставляет первые измерения нести грубую семантическую информацию, а последующие добавляют более тонкие детали.
После обучения эмбеддинг MRL можно обрезать до поддерживаемой префиксной размерности. OpenAI сообщает, что text-embedding-3-large на 256 измерениях превосходит text-embedding-ada-002 на 1 536 измерениях в приведённом сравнении на MTEB. Это даёт сокращение объёма сырых векторов в 6 раз; задержка поиска и стоимость базы данных также зависят от индекса, метаданных, фильтрации и железа.
Эмбеддинг-модель — один из важных компонентов пайплайна RAG наряду с парсингом, чанкингом, поиском, реранкингом и генерацией. Если релевантные данные не извлечены, более сильный генератор не сможет надёжно это исправить.
38. Архитектура RAG в production
Retrieval-Augmented Generation предоставляет LLM документы, найденные в момент запроса. Он может дать актуальные или приватные данные, которых нет в весах модели, но retrieval не гарантирует, что ответ использует эти данные правильно. Production-система RAG — это многостадийный пайплайн, каждую стадию которого нужно оценивать отдельно. Рисунок показывает офлайновый путь индексации, путь отдельного запроса и места, где возникают три перечисленных ниже режима отказа.
Пайплайн индексации работает офлайн. Исходные документы (PDF, HTML, Markdown, базы данных) сначала разбираются в чистый текст. При разборе PDF могут теряться таблицы, заголовки и форматирование. Затем текст делится на чанки, которые независимо получают эмбеддинги и индексируются.
Чанкинг влияет и на recall при retrieval, и на контекст, доступный генератору. Подходящие размеры зависят от структуры документов, гранулярности запросов, ограничений эмбеддера и ограничений реранкера. Распространённые подходы: фиксированный размер с перекрытием, рекурсивное разбиение по границам документа и семантический чанкинг по сходству эмбеддингов. Сравнивайте их по меткам релевантности на уровне страниц или разделов, а не принимайте один диапазон токенов как универсальный.
Каждый чанк затем получает эмбеддинг от модели вроде тех, что описаны в разделе 37, и сохраняется в векторном индексе. pgvector хранит векторы в уже работающей у вас базе Postgres. Специализированное хранилище, такое как Qdrant, Weaviate или Pinecone, добавляет встроенный гибридный поиск и масштабирует индекс отдельно от базы данных приложения.
Пайплайн retrieval работает в момент запроса. Начните с измеримой базовой версии, затем добавляйте стадии, когда анализ ошибок покажет, что они устраняют реальный промах:
- Гибридный поиск сочетает плотный векторный retrieval с разреженным, например BM25, часто объединяя результаты через Reciprocal Rank Fusion (RRF). Плотный поиск справляется с семантическими перефразированиями; разреженный находит точные идентификаторы, коды ошибок и акронимы. Бенчмарки вендоров сообщают о приросте относительно чисто векторных баз, но его размер зависит от корпуса и меток релевантности.
- Реранкинг пропускает найденных кандидатов через модель, которая оценивает запрос и документ вместе. Это может улучшить тонкую релевантность ценой ещё одного вызова модели. Число кандидатов, число сохраняемых и латентность нужно настраивать вместе. Полный многостадийный пайплайн я разобрал в статье Создание современного стека ранжирования поиска.
- Преобразование запроса переписывает запрос пользователя перед retrieval, чтобы улучшить recall. HyDE (Hypothetical Document Embeddings) заставляет LLM сгенерировать гипотетический документ, эмбеддинг которого используется для retrieval реальных документов. Сгенерированный текст — представление для поиска, а не проверенное свидетельство для ответа. Multi-query expansion генерирует несколько формулировок одного вопроса. Step-back prompting сначала задаёт более общий вопрос для retrieval или ризонинга на основе более общих принципов.
Типичные режимы отказа:
- Сбой retrieval — нужный документ существует, но не извлекается. Проверьте на этом промахе чанкинг, преобразование запроса, гибридный поиск и фильтрацию по метаданным.
- Отравление контекста — нерелевантные извлечённые чанки вводят LLM в заблуждение. Проверьте реранкинг, фильтры контекста и меньшие наборы сохраняемых чанков.
- Lost-in-the-middle — в проверенных постановках вопросов-ответов по нескольким документам и извлечения пар «ключ — значение» Liu et al. обнаружили, что качество ответов в целом было наивысшим, когда релевантная информация находилась в начале или конце входа, и ниже, когда она находилась в середине.
GraphRAG (Microsoft, 2024) извлекает сущности и связи, обнаруживает сообщества графа и строит их резюме. Его метод глобального поиска отвечает на вопросы уровня корпуса по этим резюме; это не просто векторный retrieval с добавленным графом. Цена — дополнительная работа по извлечению, индексации, хранению и оценке.
Практические руководства публикуют диапазоны латентности для эмбеддинга, поиска, реранкинга и генерации, но эти цифры зависят от региона, корпуса, железа и модели. Измеряйте каждую стадию в трейсах и оценивайте изменение качества, прежде чем принимать добавленную латентность.
39. Архитектуры агентов и tool calling
ИИ-агенты на основе LLM используют модели, чтобы выбирать и упорядочивать tool calls вокруг меняющегося состояния. Три полезных паттерна оркестрации:
- ReAct — чередует выбор действия с наблюдениями. Он может адаптироваться после каждого результата инструмента, но растущая история увеличивает стоимость в токенах и латентность.
- ReWOO — планирует tool calls с плейсхолдерами и явными зависимостями результатов, затем выполняет план и синтезирует ответ. Параллельно могут выполняться только независимые вызовы; вызов, ссылающийся на предыдущий результат, должен его дождаться. Статья сообщает об экономии токенов по сравнению с ReAct, но фиксированному плану нужен явный путь восстановления на случай сбоя инструмента.
- Planner-executor — отделяет планирование от выполнения и может добавлять политику перепланирования после сбоя. Он позволяет использовать разные модели для разных ролей, но добавляет состояние плана и второй вызов модели, который может сбоить.
| Паттерн | Повторная работа модели | Адаптивность | Полезная отправная точка |
|---|---|---|---|
| ReAct | Читает наблюдения перед следующим действием | Обновляется после наблюдений | Неопределённый или исследовательский tool use |
| ReWOO | Повторно использует план с явными зависимостями | Фиксированный план, если не расширить | Работа, которую можно спланировать до результатов инструментов |
| Planner-executor | Планирует, выполняет и может перепланировать | Может пересматривать явный план | Длинные задачи, которым нужен контроль |
Рисунок показывает три паттерна, чтобы было видно, где каждый из них планирует и есть ли у него путь назад после результата инструмента.
Function calling — распространённый механизм вызова инструментов. API предоставляют определения инструментов и возвращают структурированные аргументы, снижая потребность в разборе свободного текста. Аргументы, валидные по схеме, всё равно могут выбрать не тот инструмент или содержать недопустимые значения. Параллельный function calling может сократить число обращений туда-обратно, когда операции независимы.
Structured output и constrained decoding обеспечивают соблюдение схемы, ограничивая токены, доступные на каждом шаге генерации. Движки вроде xgrammar, который используется в vLLM и SGLang, могут убрать многие сбои синтаксиса и разбора с малыми накладными расходами в поддерживаемых конфигурациях. Они не гарантируют, что извлечённые значения или решения верны. Schema-Guided Reasoning (SGR) использует порядок полей и структуру схемы, чтобы сделать промежуточное состояние проверяемым до итогового решения. Его три паттерна: Cascade (последовательные шаги), Routing (union-типы как семантические переключатели) и Cycle (ограниченные списки).
Больший набор инструментов и более длинная последовательность действий могут снизить качество выбора и увеличить латентность или стоимость в токенах. Измеряйте эти кривые на реальных описаниях инструментов и реальном распределении сбоев. Фреймворки вроде LangGraph могут сделать состояние и пути восстановления явными, но не избавляют от необходимости оценки.
40. Промпт-инжиниринг для production
Промптинг в production — это задача оценки: измените одну часть промпта или контекста, а затем измерьте качество задачи и режимы отказа. Приведённые ниже техники — типичные отправные точки, а не универсальный порядок.
Few-shot примеры часто эффективны для управления форматом вывода. Начните с 3–5 примеров, которые покрывают пустые входы, неоднозначные запросы и многосоставные ответы, затем измерьте результат на отложенной выборке. Примеры должны охватывать реальное распределение входов, а не только удачный сценарий. Больше примеров занимает больше контекста и не гарантирует дальнейшего улучшения.
Промптинг chain-of-thought (CoT) просит модель показать промежуточные рассуждения перед ответом. Kojima et al. (2022) сообщили о приросте от суффикса «Let’s think step by step» на проверенных ими задачах на ризонинг, но эффект зависит от модели, а новые API с ризонингом могут не раскрывать скрытые трассы рассуждений. В production предпочитайте проверяемую декомпозицию задачи или краткое обоснование, если оно полезно для эвалуатора. Self-consistency (Wang et al., 2023) сэмплирует несколько путей рассуждения и агрегирует ответы, обменивая дополнительную стоимость инференса на устойчивость на подходящих задачах.
Structured output с явными JSON Schema (раздел 39) убирает многие сбои разбора. Движки constrained decoding вроде xgrammar могут обеспечивать поддерживаемую грамматику во время генерации; фактическую точность и семантическую корректность всё равно нужно оценивать, а неподдерживаемые возможности схем всё ещё могут требовать обработки.
Prompt chaining разбивает задачу на сфокусированные стадии, например классификация намерения → извлечение контекста → генерация ответа → валидация вывода. Он может локализовать сбои, позволяет использовать разные модели на разных стадиях и делает промежуточное состояние пригодным для кэширования. Он также добавляет интерфейсы и латентность, поэтому сравнивайте его с базовой версией из одного вызова.
Температура меняет распределение сэмплирования. Низкие значения — разумная отправная точка для классификации или извлечения; более высокие могут повысить разнообразие для генерации идей. Точное поведение различается между API моделей и взаимодействует с top_p, top_k и значениями по умолчанию у провайдера, поэтому перебирайте поддерживаемые настройки на своей задаче, а не копируйте один диапазон.
Разделение системных и пользовательских сообщений отделяет постоянную политику от содержимого конкретного запроса. Chat-шаблоны и instruction tuning дают этим ролям разный приоритет, но не превращают системное сообщение в границу принудительного исполнения. Стабильное поведение помещайте в системное сообщение, недоверенные данные держите в пользовательском контенте или контенте инструментов, а жёсткие ограничения вроде удаления PII обеспечивайте и вне модели.
Контекст-инжиниринг расширяет работу с промптом до сборки извлечённых документов, результатов инструментов, истории диалога и примеров. Liu et al. обнаружили эффект lost-in-the-middle у проверенных ими моделей с длинным контекстом, поэтому позицию нужно включать в оценку, а не считать несущественной. Более широкий рабочий процесс я разобрал в статье Контекст-инжиниринг для ИИ-агентов.
Часть VIII — Эксплуатация в production
Эксплуатация в production превращает прежние концепции в лимиты допуска, load tests, алерты и решения о ёмкости при реальном трафике.
41. Rate limiting для запросов с переменной стоимостью
Традиционный rate limiting по запросам в секунду предполагает примерно одинаковую стоимость каждого запроса. LLM нарушают это допущение. Классификация с промптом на 10 токенов и анализ документа на 100K токенов попадают на один и тот же endpoint API, но различаются по длине входа в 10 000 раз. Общая стоимость также зависит от длины выхода, модели, кэширования и цен. Rate limiting по RPS либо пропускает дорогие запросы без контроля, либо без нужды душит дешёвые.
Production-системам нужен rate limiting на основе токенов по нескольким измерениям. OpenAI документирует лимиты запросов и токенов по уровням использования. Anthropic разделяет лимиты входных и выходных токенов. Точные квоты и алгоритмы могут меняться, поэтому считайте документацию провайдера источником истины; архитектурная мысль в том, что запросы и токены нужно бюджетировать независимо.
Один вариант реализации на уровне приложения — многомерная иерархия лимитов (пользователь → приложение → организация → глобально), с уровнями приоритета для премиального доступа. Резервируйте токены при допуске запроса: оцените общее количество (вход + max_tokens), вычтите оценку из доступного лимита и после завершения верните неиспользованную часть по фактическому расходу. Это не позволяет серии запросов с длинной генерацией исчерпать ресурсы до начала выдачи ответа. Запрос с 2000 входных токенов и max_tokens = 1000 резервирует 3000. Если ответ использует 200 выходных токенов, фактический расход составляет 2200, а 800 возвращаются. Это локальная политика допуска; алгоритмы квот провайдеров могут использовать другие оценки и отдельные бюджеты входа и выхода. Если доступно менее 3000, верните 429 или поставьте запрос в очередь.
Для self-hosted деплоев эквивалент — выделенная пропускная способность: резервирование выделенной ёмкости GPU под целевые скорости токенов. Для деплоев vLLM это означает настройку admission control вокруг активных слотов декода и давления на KV cache, а не только вокруг числа запросов. Как объясняет раздел 5, и throughput, и допуск требуют лимитов, учитывающих токены.
42. Режимы отказа, под которые нужно проектировать
Сервинг LLM добавляет режимы отказа, связанные с переменной длиной последовательности, памятью KV и долгой работой декода. Проектируйте защиту и нагрузочно тестируйте её до того, как production-трафик начнёт от неё зависеть.
Нехватка памяти (OOM) — частый сбой. Модели 70B в FP16 нужно около 140 GB только под веса, а KV cache одной последовательности Llama 3.1 70B с контекстом 128K может добавить около 40 GiB при допущениях из раздела 6. Разрыв между «помещается в память» и «OOM под нагрузкой» меньше, чем кажется, потому что батч запросов с длинным контекстом может занять больше памяти KV, чем ожидалось. Профилактика сочетает измеренный резерв памяти с квантизацией и страничным выделением KV. В vLLM --gpu-memory-utilization задаёт долю памяти GPU, которую движок может использовать под веса, активации и KV cache; остаток — это резерв. Для нагрузок с высоким давлением на KV LMCache может выгружать данные KV в память CPU или на диск; используйте его опубликованные результаты как отправную точку и бенчмаркайте локальную иерархию памяти.
Вытеснение (preemption) происходит, когда давление на KV cache заставляет планировщик выгнать работу или пересчитать её. Точная стратегия зависит от версии и конфигурации сервинга. Со стороны пользователя симптом — рост сквозной латентности без очевидной ошибки приложения. Следите за числом вытеснений и сопоставляйте его с использованием KV, глубиной очереди и длинами запросов.
Хвостовая латентность может подскакивать, когда большие префиллы задерживают работу декода. Chunked prefill (раздел 7) и планирование с учётом длины направлены на это взаимное влияние. В статьях про планировщик Learning-to-Rank (Fu et al., 2024) и CascadeInfer сообщается об улучшениях относительно их баз на оцениваемых нагрузках, но точный результат зависит от распределения длин запросов и конфигурации планировщика.
Каскадные отказы могут начаться, когда медленные запросы растят очередь, клиенты выше по цепочке падают по таймауту, а повторы добавляют нагрузку. Защита включает admission control, лимиты конкурентности на тенанта, ограничения на длину вывода, бюджеты повторов и circuit breaker на шлюзе. Дезагрегированные пулы префилла и декода могут помочь, когда load tests показывают устойчивое взаимное влияние фаз. Рисунок показывает цикл и защиту на каждом ребре.
43. Мониторинг LLM-систем
Мониторинг LLM отличается от мониторинга API тремя вещами: у каждого запроса своя стоимость, у каждого запроса две фазы с разными боттлнеками, а его объём памяти зависит и от длины входа, и от длины выхода. Латентность запросов и доля ошибок сами по себе не показывают ничего из этого.
Goodput — число запросов в секунду, которые укладываются во все заданные пороги SLO, такие как TTFT, TPOT и общая латентность. Это полезная комбинированная мера, потому что сырой throughput может выглядеть здоровым, пока латентные SLO нарушаются: система, обрабатывающая 100 запросов в секунду, но не укладывающаяся в пороги у 40% из них, имеет goodput 60 запросов в секунду. Оптимизация по goodput сохраняет видимость распределения производительности, а не сводит отчёт к среднему.
vLLM отдаёт endpoint Prometheus по адресу /metrics с числом выполняемых и ожидающих запросов, использованием KV cache, распределениями длин генерации и статистикой prefix cache. Имена метрик могут меняться между релизами, поэтому привязывайте дашборды к развёрнутой версии. Типичный стек использует Prometheus для метрик, Grafana для визуализации и совместимые с OpenTelemetry трейсы по компонентам приложения и сервинга.
Полезные паттерны алертов приведены ниже. Пороги для них выводите из результатов load tests, а не копируйте эти примеры без изменений:
- Всплески числа вытеснений — рантайм выгружает или пересчитывает работу, что добавляет латентность без ошибки приложения.
- Использование KV cache приближается к проверенной области вытеснений — добавьте ёмкость или сбросьте нагрузку, пока вытеснения не пошли каскадом.
- Глубина очереди устойчиво выше проверенной огибающей батча — admission control должен начать отклонять запросы или понижать их приоритет.
- TTFT растёт, а TPOT остаётся ровным — это расхождение прежде всего указывает на очередь, допуск, сеть или давление префилла, а не на throughput декода. Чтобы их различить, используйте трейсы и метрики очереди.
В vLLM первые три алерта соответствуют vllm:num_preemptions_total, vllm:kv_cache_usage_perc и vllm:num_requests_waiting (метрики vLLM).
44. Оптимизация стоимости: стратегия с накоплением эффекта
Цены провайдеров и соотношения цен на вход и выход меняются. Перед решением о закупке берите актуальные тарифы; уровень модели и длина вывода могут определять счёт ещё до оптимизаций инфраструктуры.
OpenAI, Anthropic и Google оценивают выходные токены своих флагманских моделей в несколько раз дороже входных. Отдельно разделение на префилл и декод объясняет разную стоимость выполнения входа и выхода: префилл обрабатывает токены промпта вместе, а обычный декод генерирует токены последовательно. Сам по себе этот механизм не устанавливает, как провайдер задаёт коммерческие цены. Сокращение ненужного вывода (жёсткий max_tokens, structured output, без повторения входа) обычно экономит больше, чем сокращение того же числа входных токенов.
Несколько подходов можно накладывать друг на друга, но только после измерения того, какие из них подходят нагрузке:
- Квантизация с FP16 до INT4 сокращает хранение исходных значений весов на 75%, до учёта масштабов и других метаданных. Снизит ли это счёт, зависит от скорости ядра, размера батча и загрузки железа (раздел 9).
- Роутинг моделей отправляет подходящий трафик на более дешёвые модели. Измеряйте долю ложных принятий роутера и сквозное качество, прежде чем увеличивать долю трафика, которую обрабатывает более дешёвая модель (раздел 36).
- Кэширование промптов сокращает работу с повторяющимся префиксом. Скидки провайдеров и учёт в rate limit меняются со временем, поэтому сочетайте измеренный hit rate с текущими условиями (раздел 16).
- Batch API могут давать скидку на работу не в реальном времени: эвалы, генерацию синтетических данных и массовую классификацию. Проверяйте актуальные цены и окна выполнения.
- Self-hosting может выиграть при устойчивой загрузке, но универсальной точки безубыточности по объёму токенов не существует. Помимо аренды GPU учитывайте затраты на инжиниринг, оркестрацию, observability, запас ёмкости и дежурства.
Не перемножайте отдельные выигрыши оптимизаций так, будто все запросы получают их независимо: квантизация меняет throughput, роутинг меняет распределение качества, а кэширование и пакетная обработка применимы только к подходящему трафику. Стройте оценку на измеренных долях трафика и сверяйте её со счётом.
45. Планирование ёмкости и автомасштабирование
Планирование ёмкости для сервинга LLM должно учитывать переменную стоимость запросов, долгую работу декода и память, зависящую от последовательности. В зависимости от нагрузки ограничивающим ресурсом может быть память KV, пропускная способность памяти, вычисления или межсоединение.
Теоретический предел по памяти для числа одновременных запросов задаёт бюджет KV cache:
Для арифметики ёмкости предположим, что рантайм выделяет бюджет KV в 40 GiB для Llama 3.1 70B с KV cache в FP16. Каждая последовательность на 4K занимает около 1,25 GiB, а каждая на 128K — около 40 GiB. Поэтому в этот бюджет помещается не более примерно 32 последовательностей по 4K или одна на 128K ещё до накладных расходов аллокатора, рантайма, разброса нагрузки и SLO. Функция kv_cache_bytes из раздела 6 повторяет этот расчёт для другой модели или бюджета. Поэтому выбор GPU и оптимизация KV cache напрямую определяют план ёмкости.
Формула ёмкости для определения размера парка:
Перед делением приведите обе скорости к одной единице времени. Используйте throughput на GPU, измеренный при целевом SLO, а не пиковый. Множитель 1,3 обеспечивает на 30% больше throughput, чем ожидаемый спрос; при таком спросе около 23% обеспеченной ёмкости остаётся неиспользованной. Округляйте вверх до полных реплик сервинга; реплике TP/PP нужна вся её группа GPU. Показатели на GPU полезны только для фиксированной, измеренной топологии реплик. Выбирайте множитель по измеренной неравномерности нагрузки, сбоям и времени восстановления. Пиковый throughput токенов и throughput в рамках SLO могут сильно расходиться по мере роста конкурентности. Бенчмаркайте на реальном распределении длин промптов и ответов при требуемых порогах TTFT и TPOT, а не берите теоретический максимум.
Одной загрузки GPU недостаточно как сигнала автомасштабирования, потому что она может оставаться высокой и при здоровой обработке, и при перегрузке. Сочетайте её с глубиной очереди, использованием KV cache и деградацией goodput. Пороги настраивайте по результатам load tests; значения вроде 80% использования KV — отправные точки, а не универсальные пределы. Эти метрики введены в разделе 43.
Scale-to-zero может подойти для окружений разработки и staging с долгими простоями. Платформы serverless-инференса и автомасштабировщики на основе Kubernetes, такие как KEDA, могут убирать простаивающую ёмкость, но экономия и время холодного старта зависят от размера модели, кэширования образов и весов и инфраструктуры. Прежде чем применять ту же политику к production-трафику, чувствительному к латентности, измерьте время запуска.
Как связаны концепции инференса
Части I–III связывают ёмкость памяти с производительностью сервинга. Размер KV на последовательность (раздел 6) задаёт исходный предел числа последовательностей в памяти. Более крупные батчи декода могут улучшить повторное использование весов и арифметическую интенсивность (раздел 1), но трафик аттеншна, планирование и коммуникация также влияют на TPOT и throughput. GQA и хранение KV с меньшей точностью сокращают объём кэша; PagedAttention сокращает потери при выделении. При указанной конфигурации Llama 3.1 70B, KV cache в FP16 и бюджете 40 GiB исходный предел — 32 последовательности по 4K токенов или одна на 128K, до накладных расходов рантайма и ограничений латентности. Контроль допуска может поставить работу в очередь или отклонить её до достижения этого предела. При давлении на KV рантайм может вытеснять запросы; неконтролируемое выделение памяти может привести к OOM (раздел 42).
Роутинг, кэширование, квантизация и выбор железа дают накопительный эффект, только если каждый оценивается по одной и той же цели по качеству и латентности. Выберите один симптом из таблицы в начале, зафиксируйте эту базовую линию и делайте так, чтобы следующее изменение было легко отменить.
Дополнительное чтение
Связанные подробные материалы из этого блога по темам:
- Руководство по файн-тюнингу LLM — когда использовать файн-тюнинг, а когда RAG или промпт-инжиниринг
- Варианты открытых LLM и форматы файлов — подбор вариантов моделей и квантизованных форматов под железо
- Руководство по сервингу с LoRAX — сервинг тысяч адаптеров LoRA в production
- Масштабирование больших языковых моделей — стратегии для нескольких GPU и нескольких узлов
- Локальные LLM на macOS — практическая настройка с llama.cpp и Ollama
- Циклы ризонинга ИИ-агентов в 2026 году — подробный разбор циклов ReAct, ReWOO и planner-executor
- Архитектура памяти ИИ-агентов в 2026 году — чекпоинты, векторные хранилища и документная память для агентов с состоянием
Источники
Сгруппированы по тематике.
Инференс и аттеншн
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness - Dao et al., NeurIPS 2022
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning - Dao, 2023
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision - Shah et al., NeurIPS 2024
- Flash-Decoding for long-context inference - Dao et al., 2023
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022
- GQA: Training Generalized Multi-Query Attention - Ainslie et al., 2023
- Triton: an intermediate language and compiler for neural network computations - Tillet et al., MAPL 2019
- FlashNorm: Fast Normalization for LLMs - 2024
- Deep Kernel Fusion for Transformers - DeepFusionKernel, 2026
Speculative decoding
- Accelerating Large Language Model Decoding with Speculative Sampling - Chen et al., 2023
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models - Li et al., NeurIPS 2025
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - ICML 2024
Квантизация
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration - MLSys 2024 Best Paper
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers - Frantar et al., ICLR 2023
- Marlin: Mixed-Precision (FP16xINT4) LLM Inference Kernel - Frantar et al., 2024
Обучение и файн-тюнинг
- LoRA: Low-Rank Adaptation of Large Language Models - Hu et al., ICLR 2022
- QLoRA: Efficient Finetuning of Quantized LLMs - Dettmers et al., NeurIPS 2023
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models - Rajbhandari et al., SC20
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning - Rajbhandari et al., 2021
- Self-Instruct: Aligning Language Models with Self-Generated Instructions - Wang et al., ACL 2023
- WizardLM: Empowering Large Language Models to Follow Complex Instructions - Xu et al., ICLR 2024
- Phi-4 Technical Report - Microsoft, 2024
- Training Deep Nets with Sublinear Memory Cost - Chen et al., 2016 (gradient checkpointing)
- AI models collapse when trained on recursively generated data - Shumailov et al., Nature 2024
Алайнмент
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model - Rafailov et al., NeurIPS 2023
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models - представила GRPO
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning - DeepSeek, 2025
Масштабирование и архитектура
- The Llama 3 Herd of Models - Meta, 2024
- LLaMA: Open and Efficient Foundation Language Models - Touvron et al. (Meta), 2023
- Llama 2: Open Foundation and Fine-Tuned Chat Models - Touvron et al. (Meta), 2023
- Qwen3 Technical Report - Qwen Team (Alibaba), 2025
- Training Compute-Optimal Large Language Models - Hoffmann et al. (Chinchilla), NeurIPS 2022
- RoFormer: Enhanced Transformer with Rotary Position Embedding - Su et al., 2021
- YaRN: Efficient Context Window Extension of Large Language Models - Peng et al., ICLR 2024
- SGLang: Efficient Execution of Structured Language Model Programs - Zheng et al., NeurIPS 2024
- Mixtral of Experts - Jiang et al. (Mistral AI), 2024
Эмбеддинги
- Matryoshka Representation Learning - Kusupati et al., NeurIPS 2022
- pplx-embed-v1: Diffusion-Pretrained Dense and Contextual Embeddings - Perplexity AI, 2026
Архитектуры агентов
- ReAct: Synergizing Reasoning and Acting in Language Models - Yao et al., ICLR 2023
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models - Xu et al., 2023
Промптинг
- Large Language Models are Zero-Shot Reasoners - Kojima et al., NeurIPS 2022
- Self-Consistency Improves Chain of Thought Reasoning in Language Models - Wang et al., ICLR 2023
Роутинг
- RouteLLM: Learning to Route LLMs with Preference Data - Ong et al., ICLR 2025
Бенчмарки
- MLPerf Inference v5.0 Results - MLCommons, April 2025
Архитектуры сервинга
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve - Agrawal et al., OSDI 2024 (Chunked prefill)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting - Patel et al., ISCA 2024 (дезагрегированный сервинг)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving - Zhong et al., OSDI 2024 (дезагрегированный сервинг)
Фреймворки для сервинга
- vLLM - движок сервинга на основе PagedAttention
- SGLang - RadixAttention и структурированная генерация
- TensorRT-LLM - оптимизированный инференс от NVIDIA
- llama.cpp - переносимый инференс на C/C++
- DeepSpeed - библиотека распределённого обучения от Microsoft
- Ollama - локальный запуск LLM
Эксплуатация
- Efficient LLM Scheduling by Learning to Rank - Fu et al., NeurIPS 2024 (vLLM-LTR)
- CascadeInfer: Length-Aware Scheduling of LLM Serving with Low Latency and Load Balancing - Yuan et al., 2025
- Goodput metric as measure of ML productivity - Google Cloud, 2024
- vLLM Optimization and Tuning - документация vLLM
- vLLM Metrics - документация vLLM
- LMCache: KV Cache Management for LLM Serving - выгрузка KV cache
- OpenAI Rate Limits - документация OpenAI API
- Anthropic Rate Limits - документация Anthropic API