Leitfaden für LLM Engineering: 45 Konzepte für Systeme im produktiven Betrieb

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dies ist ein Nachschlagewerk für Engineers, die grundlegende ML- und Systemkonzepte bereits kennen und ein Symptom im Produktivbetrieb dem passenden Teil des Stacks zuordnen müssen. Es behandelt 45 Konzepte aus Hardware, Inference, Training, Deployment, Anwendungen und Betrieb. Jeder Eintrag beschreibt den Mechanismus, was er in einem laufenden System ändert und unter welcher Bedingung das genannte Ergebnis gilt. Wenn Sie von einem Symptom ausgehen, etwa einem langsamen ersten Token oder OOM unter Last, finden Sie in der Symptomtabelle unten die passenden Einträge.
Für eine gezielte Frage nutzen Sie die LLM Engineering Fast Answers. Jedes Thema hat eine eigene Antwort mit Links zum entsprechenden Abschnitt dieses Leitfadens.
| Teil | Themen | Abschnitte |
|---|---|---|
| I — Hardware-Grundlagen | Roofline-Model, GPU-Speicher, Hardware-Glossar | 1–3 |
| II — Inference-Grundlagen | Latency, Throughput, KV cache, Attention, Quantization | 4–9 |
| III — Inference-Optimierungen | CUDA-Kernels, FlashAttention, Batching, PagedAttention, Speculative Decoding | 10–17 |
| IV — Modelarchitektur | Transformer-Interna, Decoder-only, MoE, Tokenization, Context Windows | 18–22 |
| V — Training und Alignment | Pretraining, LoRA, Mixed Precision, ZeRO, Scaling Laws, RLHF/DPO/GRPO, Distillation | 23–32 |
| VI — Skalierung und Deployment | Parallelismus, Serving-Frameworks, GPU-Auswahl, Routing | 33–36 |
| VII — Anwendungen | Embeddings, RAG, Agents, Prompt Engineering | 37–40 |
| VIII — Betrieb in Produktion | Rate Limiting, Failure Modes, Monitoring, Kosten, Capacity Planning | 41–45 |
Vom Symptom ausgehen
Jede Zeile nennt die Einträge, die Sie zuerst lesen sollten, und was Sie messen sollten, bevor Sie den Stack ändern.
| Symptom oder Entscheidung | Beginnen mit | Vor Änderungen am Stack messen |
|---|---|---|
| Das erste Token kommt langsam | Prefill und Decode, TTFT | Queue-Zeit, Prompt-Länge, Prefill-Zeit und P99-TTFT |
| Tokens werden langsam gestreamt | Roofline, TPOT | TPOT nach Concurrency, Speicherbandbreite und Batch-Form |
| Lange Kontexte lösen Preemption oder OOM aus | KV cache, PagedAttention | KV-Belegung, Request-Längen, Allocator-Verschnitt und Preemption-Anzahl |
| Ein Model passt nicht ins Budget | Quantization, GPU-Auswahl | Qualität, Kernel-Throughput, Speicherreserve und Goodput beim Ziel-SLO |
| Auswahl einer Serving-Runtime | Serving-Frameworks, Parallelismus | Throughput und P99-Latency beim Ziel-SLO auf Ihren eigenen Prompts |
| Requests laufen unter Last in Timeouts | Failure Modes, Rate Limiting | Queue-Tiefe, Preemptions, Retry-Rate und Output-Längen |
| Ein Trainingslauf passt nicht in den Speicher | LoRA und QLoRA, ZeRO, FSDP | Speicher für Modelzustand, Kommunikation, Throughput und Held-out-Qualität |
| Die Kosten steigen | Routing, Kostenoptimierung | Eignung des Traffics, Qualitätsfehler, Cache-Hit-Rate und Rechnungsdaten |
Vertiefende Leitfäden nach Entscheidung
| Wenn Sie entscheiden… | Beginnen mit | Danach lesen |
|---|---|---|
| Wie Sie viele feinabgestimmte Adapter servieren | Inference-Grundlagen und Deployment | LoRAX Serving Guide |
| Ob Sie quantisieren sollten | Quantization | Model quantization guide |
| Wie Sie ein Model auf GPUs aufteilen | Parallelismus | Scaling Large Language Models |
| Ob Sie Fine-Tuning einsetzen sollten | Training und Alignment | LLM Fine-Tuning Guide |
| Wie Retrieval in eine App passt | Embeddings und RAG | RAG Evaluation Metrics |
| Wie Agent-Systeme funktionieren | Agents und Prompt Engineering | AI Agent Reasoning Loops |
| Wie Sie Suchergebnisse ranken | Embeddings und Reranking | Search Ranking Stack |
Teil I — Hardware-Grundlagen
Arithmetic Intensity, die GPU-Speicherhierarchie und die Hardware-Begriffe in diesem Teil erklären viele Entscheidungen im weiteren Verlauf des Leitfadens.
1. Memory-bound vs. compute-bound und das Roofline-Model
Ausgangspunkt für LLM-Performance ist die Arithmetic Intensity: Wie viele nützliche Berechnungen führt die GPU für jedes Byte aus, das sie aus dem Speicher lädt? Dieses Verhältnis entscheidet, ob eine Operation compute-bound ist (sie wartet auf den Prozessor) oder memory-bound (sie wartet darauf, dass Daten geladen werden).
Jede GPU hat eine „kritische Intensität“, bei der ihr maximaler Compute-Throughput ihrer Speicherbandbreite entspricht. Für eine NVIDIA H100 SXM mit dichten BF16- oder FP16-Tensor-Cores (989 TFLOPS; die Angabe von 1.979 TFLOPS setzt strukturierte Sparsity voraus):
Das Roofline-Diagramm unten zeigt den erreichbaren Compute-Throughput in Abhängigkeit von der arithmetischen Intensität. Die schräge Linie ist der speicherlimitierte Bereich, in dem die Bandbreite die Grenze setzt; die flache Linie ist der maximale Compute-Throughput; ihr Schnittpunkt ist die Schwelle von 295 FLOPs/Byte.
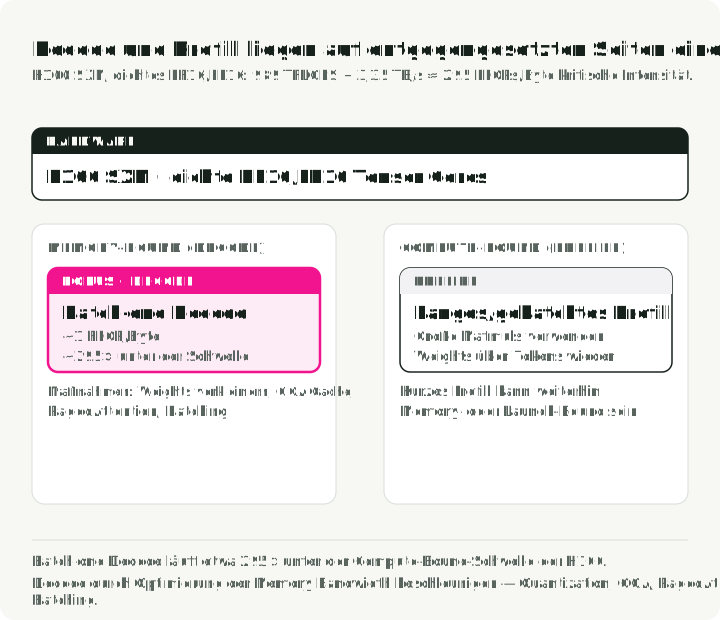
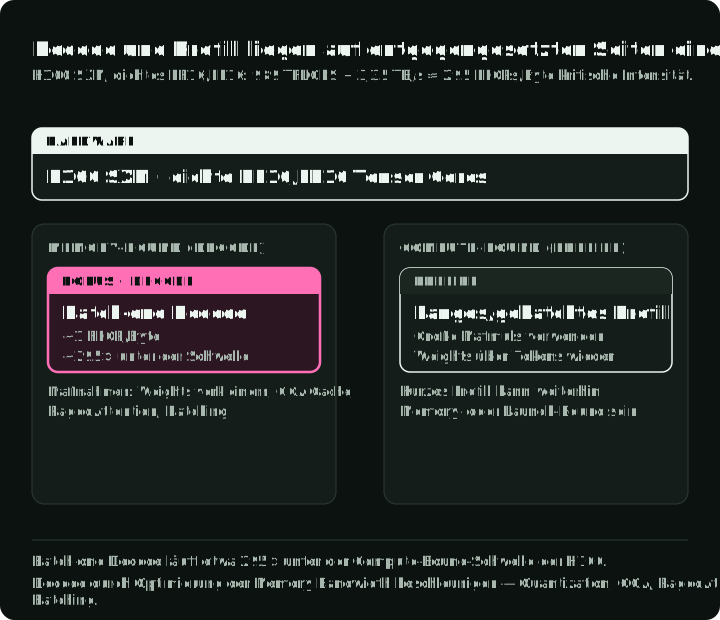
Decode mit Batch-Größe eins und langes oder ausreichend gebatchtes Prefill liegen häufig auf entgegengesetzten Seiten dieser Schwelle:
- Decode ist memory-bound. Wer Tokens einzeln erzeugt, lädt die mehrere Gigabyte große Weight-Matrix aus dem Speicher, um sie mit einem einzigen neuen Token zu multiplizieren. In einer vereinfachten Analyse für dichte 16-Bit-Models mit Batch-Größe eins hat die Operation etwa 1 FLOP/Byte, rund 295-mal weniger als die Roofline-Schwelle der H100. Diese Lücke erklärt, warum Decode in diesem Bereich die maximale Compute-Leistung nicht annähernd erreichen kann.
- Langes oder ausreichend gebatchtes Prefill ist oft compute-bound. Die Verarbeitung vieler Prompt-Tokens verwendet Weights in großen Matrixmultiplikationen mehrfach, was die Arithmetic Intensity über die Roofline-Schwelle heben kann. Kurze Prompts und kleine Batches können stattdessen durch Speicherverkehr oder Kernel-Launch-Overhead begrenzt sein.
Um Decode zu beschleunigen, setzen Sie also bei der Speicherbandbreite an: Verkleinern Sie die Weights mit Quantization, senken Sie den KV-Speicher-Overhead mit GQA und PagedAttention und erhöhen Sie die Intensität durch Batching. Für lange oder gut gebatchte Prefills können schnellere Matrixberechnung und Compute mit niedrigerer Präzision helfen. Profilieren Sie Workloads mit kurzem Prefill gesondert.
2. GPU-Speicherhierarchie
Eine GPU hat vier Speicherebenen mit unterschiedlichen Kapazitäten und Zugriffsgeschwindigkeiten. Register sind klein und schnell; HBM enthält viel mehr Daten, der Zugriff dauert aber länger. Der Datentransfer zwischen diesen Ebenen begrenzt die Performance erheblich. Die Abbildung zeigt eine H100 SXM: Register und Shared Memory innerhalb jedes SM, L2 auf dem Die und 80 GB HBM3 in Stacks daneben.
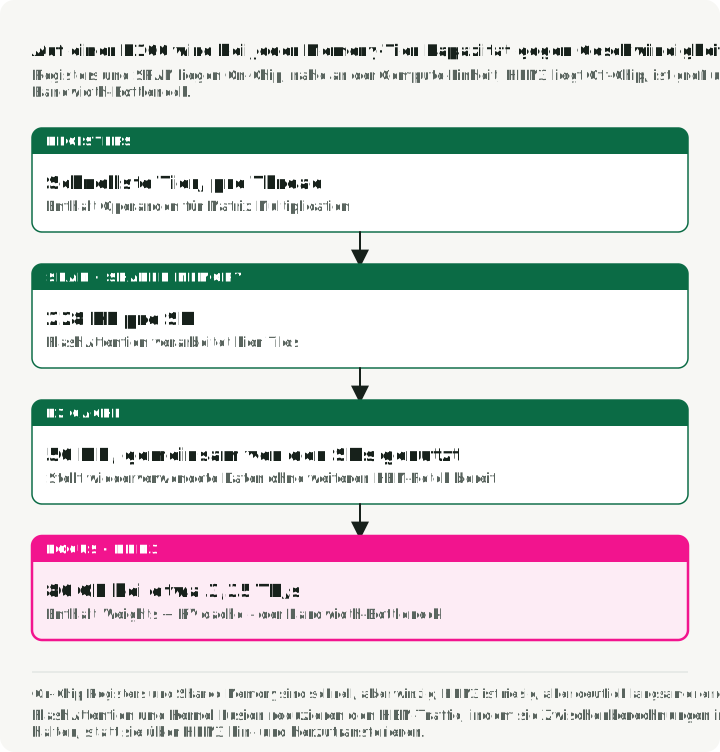
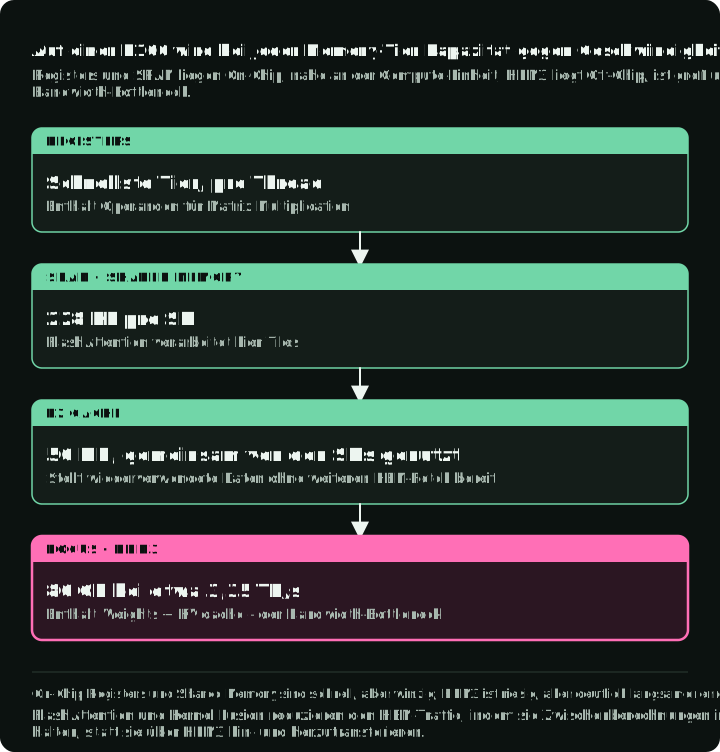
Von der schnellsten zur langsamsten Speicherebene auf einer H100 SXM:
- Register sind der schnellste Speicher und sind direkt an die Verarbeitungs-Threads gekoppelt. Bei WGMMA von Hopper kann Matrix A aus den Registern oder aus dem Shared Memory kommen, während Matrix B aus dem Shared Memory kommt.
- SRAM (Shared Memory) ist schneller On-Chip-Arbeitsspeicher, der jedem SM lokal zugeordnet ist.
- L2-Cache ist eine gemeinsam genutzte 50-MB-Ebene. Sie kann Daten, die mehrere SMs wiederverwenden, ohne weiteren HBM-Zugriff liefern.
- HBM3 ist der 80 GB große Hauptspeicher, der Model Weights und den KV cache enthält, mit ~3,35 TB/s Bandbreite.
Der Abstand zwischen On-Chip- und Off-Chip-Ebenen ist groß. Auf einer A100 schätzt das FlashAttention-Paper die On-Chip-SRAM-Bandbreite auf etwa 19 TB/s, gegenüber 1,5–2,0 TB/s für HBM (Dao et al., 2022), also rund das Zehnfache. FlashAttention und Kernel Fusion verringern den HBM-Verkehr, indem sie Zwischenergebnisse auf dem Chip halten oder zusammenfassen. PagedAttention löst ein anderes Problem: Es bildet logische KV-Blöcke auf nicht zusammenhängende physische Blöcke im GPU-Speicher ab, verringert die Fragmentierung und ermöglicht gemeinsam genutzte Blöcke.
3. GPU-Hardware-Glossar
Die folgenden Begriffe tauchen im weiteren Verlauf des Leitfadens immer wieder auf.
HBM (High Bandwidth Memory) stapelt DRAM-Dies, die über Through-Silicon Vias (TSVs) verbunden sind, neben dem GPU-Die. Zu den Generationen gehören HBM2e (A100, 2 TB/s), HBM3 (H100, 3,35 TB/s) und HBM3e (H200/B200, 4,8–8 TB/s). Die HBM-Bandbreite begrenzt TPOT direkt, wenn Decode memory-bound ist.
GDDR (Graphics DDR) ist herkömmlicher Grafikspeicher in Consumer- und Workstation-GPUs wie RTX 4090 und L40S. Diese Karten haben weniger Speicherbandbreite als die H100 SXM. GDDR6X auf der RTX 4090 erreicht laut NVIDIAs Ada-Architektur-Whitepaper 1.008 GB/s, gegenüber 3,35 TB/s HBM3-Bandbreite der H100 SXM.
Ein SM (Streaming Multiprocessor) ist der grundlegende Compute-Block einer NVIDIA-GPU. Jeder SM enthält CUDA Cores, Tensor Cores, Shared Memory und einen Warp-Scheduler. Die H100 SXM hat 132 SMs; die H100 PCIe hat 114. Die A100 hat 108.
Tensor-Cores sind spezialisierte Einheiten für Matrix-Multiply-Accumulate in jedem SM. Sie beschleunigen die Matmuls mit gemischter Präzision, die die Transformer-Berechnung dominieren. Die Tensor-Cores der H100 SXM liefern 494,5 TFLOPS (TF32, dicht) oder 989 TFLOPS (TF32, sparse). Geben Sie beim Vergleich dieser Zahl stets Präzision und Sparsity-Modus an.
CUDA-Cores sind universelle Einheiten für Gleitkomma- und Ganzzahlarithmetik. Sie übernehmen elementweise Operationen, Activationsfunktionen und andere Nicht-Matrix-Arbeit, während die Tensor-Cores unterstützte Matrixoperationen ausführen.
Ein Warp ist eine Gruppe von 32 Threads auf einem SM. Threads können unterschiedliche Ausführungspfade nehmen; Volta und spätere GPUs unterstützen unabhängiges Thread-Scheduling. Warp Specialization weist verschiedenen Warps Datentransfer und Berechnung zu, damit diese Aufgaben überlappen können.
NVLink ist NVIDIAs schnelle GPU-zu-GPU-Verbindung innerhalb eines Knotens. NVLink 4.0 der H100 liefert 900 GB/s bidirektionale Bandbreite; NVLink 5.0 der B200 erreicht 1,8 TB/s. Diese Bandbreite ist für Tensor Parallelism wichtig, weil die GPUs in jeder Transformer-Schicht Teilergebnisse austauschen.
InfiniBand ist ein schnelles Netzwerk für die Kommunikation zwischen Knoten. InfiniBand-Adapter der ConnectX-Klasse bilden das Netzwerk zwischen den Knoten für Pipeline-parallelen oder verteilten Trainingsverkehr; die Bandbreite hängt vom Adapter und der Port-Konfiguration ab.
RDMA (Remote Direct Memory Access) erlaubt einem Gerät den Zugriff auf den Speicher eines anderen Rechners, ohne dass der Datenpfad über eine der beiden CPUs läuft. GPUDirect RDMA unterstützt direkte GPU-zu-GPU-Transfers zwischen Knoten, einschließlich KV cache-Transfers bei disaggregiertem Serving.
NVMe (Non-Volatile Memory Express) ist die SSD-Schnittstelle für KV cache-Offloading und das Parameter-Offloading von ZeRO-Infinity, wenn GPU- und CPU-Speicher nicht ausreichen. Die sequenzielle Bandbreite hängt vom Laufwerk und der Workload ab und bleibt weit unter der HBM-Bandbreite.
TFLOPS und PFLOPS sind Billionen bzw. Billiarden Gleitkommaoperationen pro Sekunde. Ein TFLOPS entspricht FLOPS. Die H100 erreicht 989 Sparse-TF32-Tensor-TFLOPS, während FlashAttention-3 etwa 1,2 PFLOPS in FP8 meldet; diese Werte beruhen auf unterschiedlichen Formaten und sollten nicht wie eine einzige Kennzahl verglichen werden.
Teil II — Inference-Grundlagen
Inference macht aus einem Model einen für Nutzer sichtbaren Service. Die folgenden Konzepte trennen Arbeit, die das erste Token verzögert, von Arbeit, die jedes spätere Token verlangsamt, und zeigen die Speichergrenzen hinter beiden.
4. Latency: TTFT, TPOT und Perzentile
Time to First Token (TTFT) ist die Gesamtverzögerung vom Absenden der Anfrage bis zum ersten Output-Token. Sie umfasst Queueing, Tokenization, Scheduling, den Prefill-Durchlauf, der das erste Token erzeugt, und die Auslieferung über das Netzwerk. Gängige Serving-Engines ziehen das erste Output-Token aus den Logits des Prefill-Forward-Passes, sodass davor kein eigener Decode-Schritt läuft. Längere Prompts erhöhen meist den Prefill-Anteil, aber jede dieser Stufen kann dominieren. Die Ziele hängen vom Produkt ab; MLPerf Inference v5.0 verwendet für sein interaktives Szenario mit Llama 2 70B ein P99-TTFT-Limit von 450 ms.
Time Per Output Token (TPOT) ist das durchschnittliche Intervall zwischen aufeinanderfolgenden Tokens nach dem ersten. Es entspricht der Decode-Phase. Decode mit Batch-Größe eins oder niedriger Intensität ist meist durch die Speicherbandbreite begrenzt, während ausreichend große Batches compute-bound werden können:
Diese Definition erfordert mindestens zwei Output-Tokens; bei einer Antwort mit einem Token ist TPOT nicht definiert. Für diese Gleichung endet die E2E-Latency am letzten Output-Token. Eine Messung bis zum HTTP-Abschluss kann auch spätere Metadaten oder das Schließen der Verbindung enthalten; erfassen Sie dies separat.
Eine Schätzung der englischen Lesegeschwindigkeit liefert einen groben Anhaltspunkt für Streaming. Die durchschnittliche stille Lesegeschwindigkeit Erwachsener für englische Sachtexte liegt bei etwa 238 Wörtern pro Minute (Brysbaert, 2019), etwa 4 Wörtern pro Sekunde. Wenn ein Token durchschnittlich drei Vierteln eines Wortes entspricht, ergibt das etwa 5 Tokens pro Sekunde oder 200 ms pro Token. Diese Schätzung ist keine Grenze für die Nutzbarkeit: Sprache, Tokenizer, Aufgabe und Client-Buffering ändern das Ergebnis. Das interaktive Szenario von MLPerf nutzt eine deutlich strengere P99-TPOT-Grenze von 40 ms. Legen Sie Ihr eigenes Ziel anhand von Produkttests fest.
P50 vs. P99 Latency ist wichtig, weil der Median das Tail verbirgt. Ein System mit gutem P50 und schlechtem P99 kann Probleme mit Batching, Preemption, Queueing oder ungleichmäßiger Workload haben; um sie zu unterscheiden, braucht man Traces.
5. Throughput: Tokens pro Sekunde und der Latency-Tradeoff
Throughput wird in Output-Tokens pro Sekunde über alle gleichzeitigen Requests gemessen. Requests pro Sekunde sind allein weniger aussagekräftig, weil eine Antwort mit 10 Tokens und eine mit 1.000 Tokens sehr unterschiedlich kosten. Veröffentlichte Benchmark-Zahlen hängen von Model, Präzision, Hardware, Prompt- und Output-Längen, Concurrency und SLO ab. Vergleichen Sie vLLM, SGLang und TensorRT-LLM mit einem einzigen Harness, statt ihre Schlagzeilenwerte zu kombinieren.
Die Vergrößerung eines kleinen Decode-Batches kann den Throughput steigern, indem Weight-Lesezugriffe geteilt werden. Größere Batches oder eine höhere angebotene Last erhöhen schließlich die Latency oder erreichen Speicher-, Compute- oder Kommunikationsgrenzen. Messen Sie diese Kurve, statt lineare Skalierung anzunehmen. Goodput, die Zahl der Requests pro Sekunde, die Ihre SLO-Ziele erfüllen, verbindet den rohen Throughput mit dem tatsächlichen Nutzererlebnis.
6. KV cache: Speicher, der mit jedem Token wächst
Bei autoregressiver Generierung mit vollständiger Attention berücksichtigt jedes neue Token das aktuelle Token und die vorherigen Tokens. Der KV cache speichert Key- und Value-Projektionen, damit die Generierung die Projektionen früherer Tokens nicht bei jedem Schritt neu berechnet. Decode mit vollständiger Attention liest weiterhin einen wachsenden Verlauf; der gesamte Attention-Rechenaufwand über eine generierte Sequenz bleibt quadratisch in ihrer Länge.
Bei einem herkömmlichen MHA- oder GQA-Cache mit vollständiger Attention wächst der Speicher linear mit Sequenzlänge, Batch-Größe und Schichtzahl. Die folgende Formel gilt nicht unverändert für MLA-, Sliding-Window-, rekurrente oder hybride Architekturen:
wobei:
- = Anzahl der Schichten
- = Anzahl der KV-Heads
- = Head-Dimension
- = Sequenzlänge
- = Batch-Größe
- = Bytes pro gecachtem Element, bestimmt durch die Präzision des KV cache
Konkrete Beispiele mit FP16 und Batch-Größe 1: Llama 3.1 8B benötigt bei 8.192 Tokens ~1,07 GB (1 GiB) KV cache; bei 128K Tokens 16 GiB. Llama 3.1 70B benötigt bei 128K Tokens 40 GiB (etwa 43 GB) für eine einzige Sequenz, ungefähr die Hälfte der 80 GB einer H100. Bei hoher Parallelität oder langem Kontext kann der KV cache mehr Speicher als die Model Weights benötigen; das Ergebnis hängt von Sequenzlänge, aktiver Batch-Größe, KV-Präzision und Anzahl der KV-Heads ab. Die ursprüngliche vLLM-Evaluation von 2023 meldete 60–80 % Verschwendung durch Fragmentierung und Vorab-Allokation in den verglichenen Systemen.
Die wichtigsten Optimierungen sind GQA (weniger KV-Heads), KV cache-Quantization (FP8/INT8), PagedAttention (blockbasierte Allokation) und das Auslagern wiederverwendbarer KV-Daten auf CPU oder NVMe. Ihr Nutzen hängt von Workload und Implementierung ab.
Um für ein anderes Model zu beantworten, wie viele Sequenzen in das KV-Budget passen, lesen Sie drei Werte aus seiner config.json: num_hidden_layers, num_key_value_heads und, falls vorhanden, head_dim. Für die Llama-Beispiele ist die Head-Dimension hidden_size / num_attention_heads. Der Speicher pro Gerät hängt auch vom Cache-Sharding und einer möglichen Replikation der KV-Heads ab. Die folgende Funktion wendet die Formel an; die Asserts reproduzieren die Werte oben und das Kapazitätsbeispiel in Abschnitt 45.
def kv_cache_bytes(layers, kv_heads, head_dim, seq_len, batch=1, bytes_per_elem=2):
    """Bytes of KV cache: a key and a value per layer, KV head, and token."""
    return 2 * layers * kv_heads * head_dim * seq_len * batch * bytes_per_elem

GiB = 2**30

# Llama 3.1 8B: 32 layers, 8 KV heads, head dimension 128, FP16 cache.
llama_8b = kv_cache_bytes(32, 8, 128, seq_len=8_192)
print(f"8B at 8K tokens: {llama_8b / 1e9:.2f} GB")  # 1.07 GB
assert llama_8b == 1 * GiB

# Llama 3.1 70B: 80 layers, 8 KV heads, head dimension 128.
assert kv_cache_bytes(80, 8, 128, seq_len=131_072) == 40 * GiB

# How many 4K-token sequences fit in a 40 GiB KV budget?
per_4k = kv_cache_bytes(80, 8, 128, seq_len=4_096)
print(f"70B at 4K tokens: {per_4k / GiB:.2f} GiB per sequence")  # 1.25 GiB
print("4K sequences in 40 GiB:", 40 * GiB // per_4k)  # 32
assert 40 * GiB // per_4k == 32

# An FP8 KV cache halves the size per sequence and doubles the count.
assert 40 * GiB // kv_cache_bytes(80, 8, 128, 4_096, bytes_per_elem=1) == 64
Das Ergebnis ist eine Obergrenze. Die Runtime braucht außerdem Speicher für Activations, Allocator-Overhead und Reserven für Schwankungen der Request-Länge.
7. Prefill vs. Decode: zwei Phasen, zwei Bottlenecks
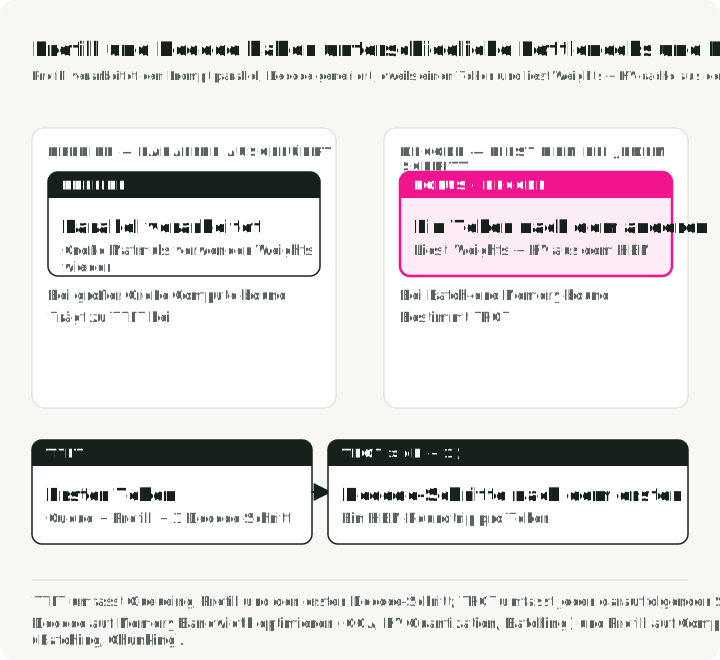
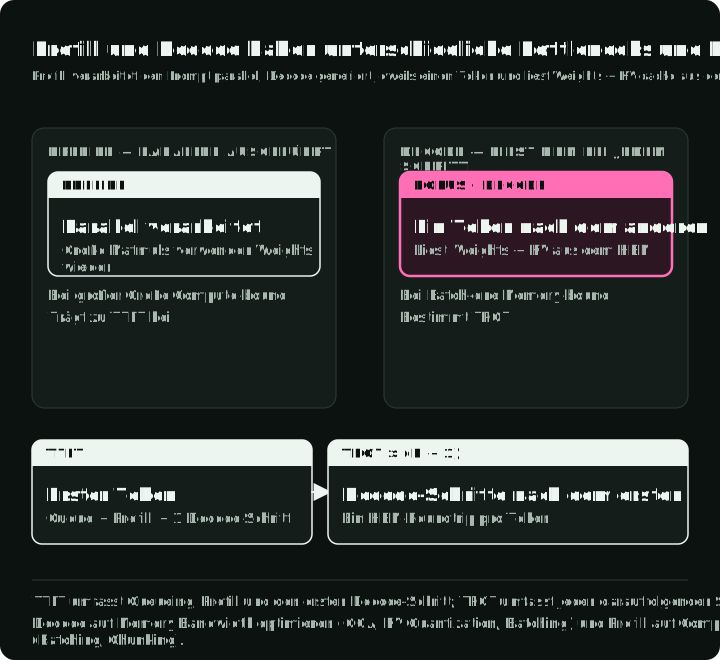
Die Prefill-Phase verarbeitet den Eingabe-Prompt parallel und füllt den KV cache. Lange oder ausreichend gebatchte Prefills werden oft compute-bound, weil sie große Matrixmultiplikationen nutzen; kurze Prefills können weiter durch Speicherverkehr oder Kernel-Launch-Overhead begrenzt sein. Prefill trägt zur Time to First Token (TTFT) bei, neben Queueing, Tokenization, Scheduling und Auslieferung über das Netzwerk; sein Forward Pass erzeugt auch das erste Output-Token. Die Decode-Phase erzeugt jeweils ein Token. Jeder Schritt liest Model Weights und den KV cache aus dem HBM. Deshalb ist Decode mit Batch-Größe eins durch die Speicherbandbreite begrenzt und der wichtigste Treiber der Time Per Output Token (TPOT).
Die Abbildung folgt einem Request: Prefill verwendet Weights für mehrere Prompt-Tokens wieder und endet mit dem ersten Token innerhalb von TTFT; jeder spätere Decode-Schritt liest Weights und KV cache erneut für ein Token und trägt zu TPOT bei.
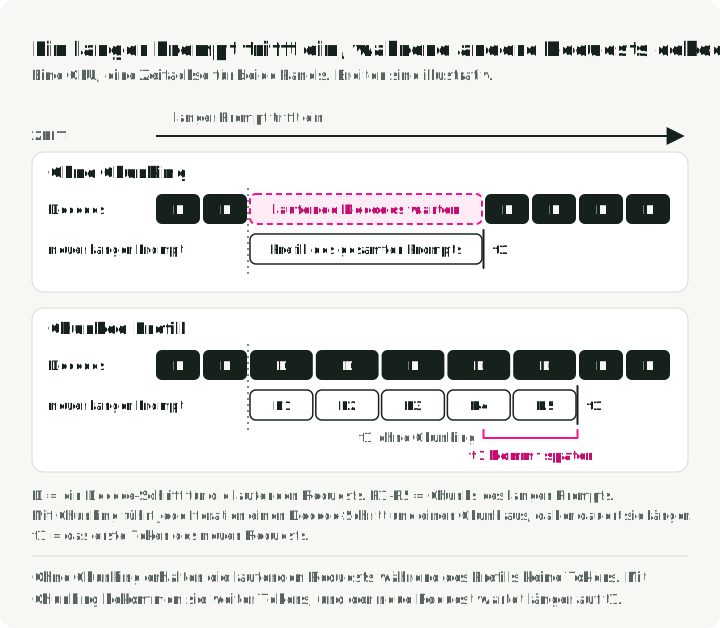
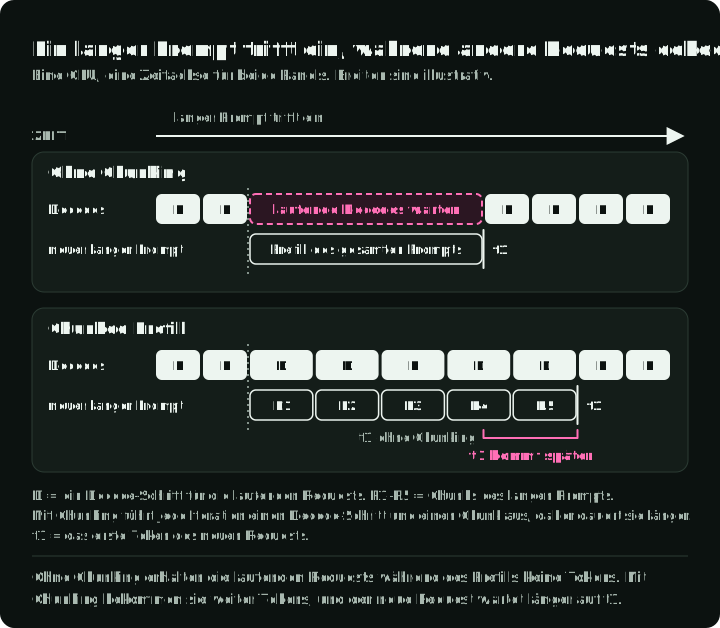
Chunked Prefill teilt einen langen Prompt in Chunks auf und plant sie zusammen mit laufenden Decodes ein. Die tatsächliche Chunk-Größe kann mit dem verfügbaren Token-Budget der Iteration variieren. In Sarathi-Serve (Abschnitt 4.2) und in vLLM legt der Scheduler zuerst die laufenden Decodes in den Batch und füllt den Rest eines Token-Budgets pro Iteration mit Prefill-Tokens. Ein langer Prompt hindert die anderen Requests dann nicht mehr daran, Tokens zu bekommen. Der neue Request zahlt dafür: Sein Prefill erstreckt sich über mehrere Iterationen, und jeder Chunk liest den KV cache der früheren Chunks erneut. Sarathi-Serve maß etwa 25 % zusätzliche Prefill-Zeit für Yi-34B mit Tensor Parallelism von zwei und 512-Token-Chunks (Abschnitt 5.4.1), und die vLLM-Dokumentation hält fest, dass ein kleineres Token-Budget eine bessere Inter-Token-Latenz und eine schlechtere TTFT ergibt. Sarathi-Serve meldet in den getesteten Workloads bessere Throughput-Latency-Tradeoffs, aber der Gewinn hängt von Model, Hardware, Verteilung der Request-Längen, Chunk-Größe und Vergleichsbasis ab.
Disaggregiertes Serving legt Prefill und Decode auf getrennte GPU-Pools, sodass jeder Pool einen anderen Bottleneck adressieren kann. Splitwise und DistServe beschreiben das Muster. Der Prefill-Pool sendet den KV cache jedes Requests an den Decode-Pool. DistServe nutzt NVLink innerhalb eines Nodes und InfiniBand zwischen Nodes; Splitwise nutzt InfiniBand, das RDMA unterstützt. Die Übertragungskosten sind damit Teil des Designs.
Die Abbildung legt beide Schedules auf eine gemeinsame Zeitachse: Ein langer Prompt trifft ein, während andere Requests dekodiert werden. Chunking hält die Tokens der anderen Requests im Fluss und verschiebt das erste Token des neuen Requests nach hinten.
8. GQA und MQA: den KV cache verkleinern
Standard-Multi-Head Attention (MHA) gibt jedem Query-Head einen eigenen K- und V-Head. Multi-Query Attention (MQA) teilt einen einzigen KV-Head über alle Query-Heads, eine extreme Reduktion. Grouped-Query Attention (GQA) ist der praxistaugliche Mittelweg: Gruppen von Query-Heads teilen sich einen KV-Head. Die Abbildung zeigt acht Query-Heads und die KV-Heads, die jede Variante behält; der KV cache schrumpft proportional zur Anzahl der KV-Heads.
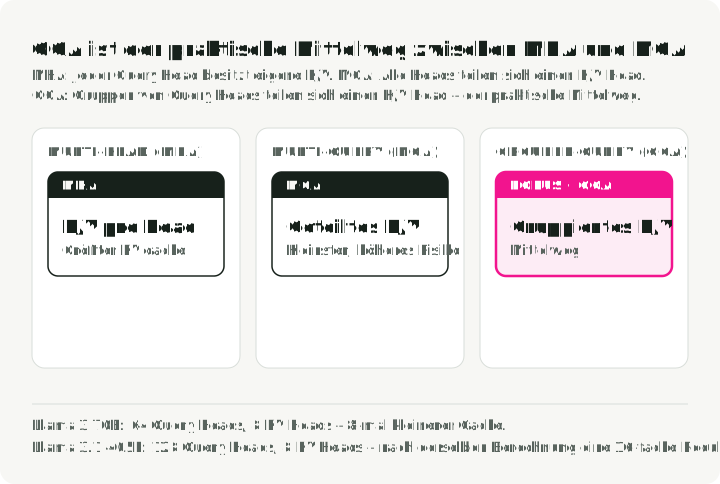
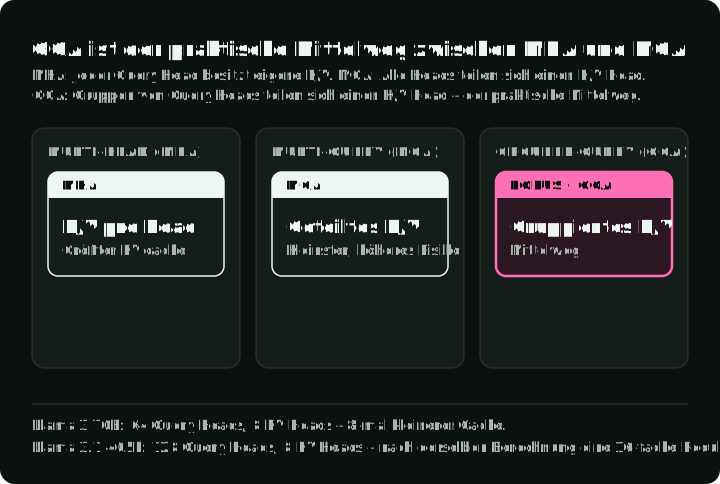
Llama 3 70B nutzt 64 Query-Heads, aber nur 8 KV-Heads, also eine 8-fache KV cache-Reduktion gegenüber derselben Architektur mit einem KV-Head pro Query-Head. Llama 3.1 405B nutzt 128 Query-Heads und 8 KV-Heads, nach derselben Rechnung eine 16-fache Reduktion (Meta, 2024). Ainslie et al. berichten für GQA eine Qualität nahe an MHA in ihren getesteten Models bei einer Geschwindigkeit nahe an MQA. Ein kleinerer KV cache kann größere Batches tragen, aber der tatsächliche Gewinn bei Latency und Throughput hängt weiterhin vom Kernel und von der Workload ab.
9. Quantization: Bits gegen Geschwindigkeit und Speicher tauschen
Quantization verringert die Präzision von Model Weights und/oder Activations. Die wichtigsten Tradeoffs:
| Format | Bits | Speicher für Weights (7B-Model) | Hinweis zur Qualität |
|---|---|---|---|
| FP16/BF16 | 16 | ~14 GB | Baseline für den Vergleich |
| FP8 | 8 | ~7 GB | Hardware-nativ auf Hopper; Model evaluieren |
| INT8 | 8 | ~7 GB | Abhängig von Calibration und Kernel |
| INT4 | 4 | ~3,5 GB | Stärkste Kompression; sorgfältig evaluieren |
AWQ (Activation-Aware Weight Quantization) erkennt wichtige Weight-Kanäle anhand der Größe der Activations und wendet eine kanalweise Skalierung an, um sie zu schützen. Der Bedarf an Calibration hängt von Model und Konfiguration ab; in einem Vergleich mit OPT-6.7B und INT3-g128 nutzte AWQ 16 Calibration-Sequenzen, GPTQ dagegen 192. Geben Sie in einem reproduzierbaren Setup sowohl die Anzahl als auch die Länge der Sequenzen an. GPTQ nutzt approximative Informationen zweiter Ordnung für die schichtweise Quantization. bitsandbytes kann beim Laden des Models quantisieren, ohne separaten Vorverarbeitungsdurchlauf; sein Format NF4 ist die Grundlage des QLoRA-Fine-Tunings. FP8 auf Hardware der Hopper-Klasse halbiert den Speicher für Weights gegenüber FP16/BF16, aber Qualität und Geschwindigkeit hängen weiterhin von Model, Calibration und Kernel ab.
Die Tabelle ordnet jede Methode der Aufgabe zu, für die sie meist passt. Der Leitfaden zur Model Quantization behandelt jede Methode im Detail.
| Methode | Calibration-Daten | Typischer Einsatz |
|---|---|---|
| AWQ oder GPTQ (INT4 weight-only) | Ja, eine kleine Stichprobe | Ein großes Model auf speicherbegrenzten GPUs über einen unterstützten INT4-Kernel servieren |
| bitsandbytes NF4 | Nein | QLoRA-Fine-Tuning und schnelle Experimente |
| FP8 | Kleine Stichprobe oder dynamische Skalierung | Serving auf Hopper oder neueren GPUs, mit Qualitätsprüfung auf der Zielaufgabe |
| INT8 (W8A8) | Ja, für die Activation-Skalen | GPUs ohne FP8, etwa A100 oder A10G, wenn der Serving-Kernel es unterstützt |
Der Serving-Kernel kann genauso wichtig sein wie der Quantization-Algorithmus. Abschnitt 10 nennt ein begrenztes Marlin-Ergebnis und erklärt, warum der Gewinn von der Serving-Konfiguration abhängt.
Teil III — Inference-Optimierungen
Die Optimierungen in diesem Teil lösen unterschiedliche Einschränkungen. FlashAttention verringert den HBM-Verkehr der Attention; PagedAttention verbessert die KV-Allokation; Continuous Batching verhindert, dass fertige Sequenzen Batch-Kapazität blockieren.
10. CUDA-Kernels und Kernel Fusion
Ein CUDA-Kernel ist eine für die GPU geschriebene Funktion, die parallel auf Tausenden von Threads läuft. Wenn die CPU einen Kernel aufruft, verteilt die GPU die Arbeit auf ihre SMs: Jeder SM führt mehrere Warps mit je 32 Threads aus, und jeder Thread verarbeitet einen Ausschnitt der Daten. Eine CUDA-Serving-Implementierung führt GPU-Arbeit über Kernels aus. Die Anzahl der Launches hängt von Modelgraph, Compiler, Runtime und Fusion ab. Die Kernel-Implementierung kann bestimmen, ob das System sein Latency-SLO erfüllt.
Die wichtigsten Kernel-Kategorien im LLM-Serving:
- GEMM-Kernels für die Matrixmultiplikation, die den Compute von Prefill und Decode dominieren.
- Attention-Kernels wie FlashAttention, die Berechnungen in Tiles zerlegen, damit sie im SRAM bleiben, statt in den HBM auszulagern.
- Fused Kernels, die mehrere Operationen (etwa Add + Layer Norm oder QKV-Projektion) in einem einzigen Launch kombinieren, um die Zwischenzugriffe auf den HBM zu sparen.
- Sampling-Kernels, die Logits per Top-k-, Top-p- oder Temperature-Sampling in Token-IDs umwandeln.
Die Qualität des Kernels kann entscheiden, ob komprimierte Weights einen Speedup bringen. Das Marlin-Paper meldet bis zu 2,8-fachen End-to-End-Speedup gegenüber seiner FP16-Baseline für getestete vLLM-Konfigurationen mit weight-only INT4. Dieses Ergebnis gilt nur für die Models, GPUs, Batch-Größen und das Serving-Setup des Papers; es ist kein allgemeiner INT4-Gewinn.
Triton senkt die Hürde für eigene Kernels, indem es GPU-Programmierung über Python statt über rohes CUDA C++ anbietet. Damit ist Optimierung auf Kernel-Ebene auch für ML-Engineers erreichbar und nicht nur für GPU-Spezialisten. Die meisten späteren Optimierungen in diesem Teil (FlashAttention, Fused Kernels, PagedAttention) sind entweder bessere Kernels oder klügere Arten, Kernel-Launches zu orchestrieren.
Kernel Fusion fasst aufeinanderfolgende Operationen in einem GPU-Kernel zusammen und spart Zwischenschreibvorgänge in den HBM. Übliche Fusionen sind QKV-Projektion, Attention plus Softmax und Residualaddition plus RMSNorm. FlashNorm kombiniert dagegen die RMSNorm-Skalierung mit der folgenden linearen Projektion und verschiebt die Normalisierung. DeepFusionKernel fusioniert ein vollständiges SwiGLU-MLP einschließlich seiner Matrixmultiplikationen. Die genauen Gewinne bei Launch-Anzahl und Auslastung hängen von Modelgraph, Compiler, GPU und Serving-Framework ab. Profilieren Sie daher den ausgerollten Stack, statt sich auf einen pauschalen Prozentwert zu verlassen.
11. FlashAttention: Attention in Tiles, die im SRAM bleiben
Standard-Attention materialisiert die vollständige -Attention-Matrix im HBM, was Speicher kostet und viel Speicherverkehr erzeugt. Die Idee hinter FlashAttention ist, diese Matrix nie zu materialisieren. Es zerlegt die Matrizen Q, K, V in Blöcke, die in den SRAM passen, berechnet die partielle Attention innerhalb jedes Tiles und führt die Ergebnisse mit einem Online-Softmax zusammen (es verfolgt inkrementell das laufende Maximum und die laufende Summe über die Blöcke). Der Speicher für Zwischenergebnisse sinkt von auf , mit weniger HBM-Lese- und Schreibzugriffen für die im Paper getesteten Tensorformen. Der Rechenaufwand dichter Attention bleibt quadratisch in der Sequenzlänge.
Jede Version zielt auf den Bottleneck ihrer GPU-Generation:
- FlashAttention v1 (A100, 2022) zeigte, dass die Kombination aus Tiling und Online-Softmax funktioniert. Das Paper meldete einen 2–4-fachen Speedup gegenüber Standard-Attention, aber nur 25–40 % GPU-Auslastung. Das FA2-Paper führt dies auf Nicht-Matmul-Arbeit, Shared-Memory-Kommunikation und begrenzte Parallelität zurück.
- FlashAttention v2 (A100, 2023) baute die Parallelisierung um, sodass sie über die Sequenzdimension sowie über Batch und Heads aufteilt. Es erreichte auf der A100 50–73 % Auslastung, etwa 2-mal schneller als v1.
- FlashAttention v3 (H100 Hopper, 2024) ergänzte Warp Specialization (getrennte Warps für Datentransfer und Mathematik) und GEMM-Softmax-Pipelining, um Speicherladevorgänge mit der Berechnung zu überlappen. Das Paper meldet bis zu 740 TFLOPS in FP16 (75 % Auslastung) und nahezu 1,2 PFLOPS in FP8 auf der H100.
- FlashAttention v4 (B200 Blackwell, 2026) adressiert einen neuen Bottleneck: Auf Blackwell skaliert der Tensor-Core-Throughput so schnell, dass Nicht-Matmul-Operationen (Softmax-Exponentialfunktionen, Rescaling) zum limitierenden Faktor werden. FA4 emuliert die Exponentialfunktion in Software mit Polynomnäherungen auf FMA-Einheiten, nutzt bedingtes Rescaling, um den Overhead zu senken, und legt Zwischenergebnisse in Blackwells dediziertem Tensor-Speicher (TMEM) statt in Registern ab. Das Paper meldet etwa 1,6 PFLOPS auf der B200 in BF16, in seinen Tests 1,3-mal schneller als cuDNN 9.13 und 2,7-mal schneller als Triton.
12. FlashDecoding: den Decode-Bottleneck parallelisieren
Standard-FlashAttention hält die GPU beschäftigt, indem es die Arbeit über Batch-Größe und Query-Länge aufteilt. Beim Decode erzeugt das Model genau 1 Token auf einmal (Query-Länge = 1). Liegt Batch-Größe mal Anzahl der Attention-Heads weit unter der SM-Zahl der GPU (108 bei einer A100), können viele SMs ungenutzt bleiben, während die aktiven SMs den Token-Verlauf verarbeiten.
FlashDecoding löst das, indem es eine neue Parallelisierungsdimension hinzufügt: die KV-Sequenzlänge selbst. Es zerlegt den KV cache in kleinere Chunks und verteilt sie auf alle sonst ungenutzten GPU-Prozessoren, die sie parallel auswerten; die Teilergebnisse werden anschließend mit einer Log-Sum-Exp-Reduktion zusammengeführt.
In Stanfords Benchmark mit CodeLlama-34B bei Batch-Größe eins auf vier A100-GPUs und Sequenzlängen von 512 bis 64K Tokens erreichte FlashDecoding bis zu 8-fachen End-to-End-Speedup gegenüber den getesteten Baselines und verbesserte die Skalierung der Attention über die getesteten langen Kontexte. Das Ergebnis gilt nur für diese Hardware und diesen Benchmark und ist keine allgemeine Decode-Garantie.
13. Continuous Batching vs. Static Batching
Static Batching wartet, bis jede Sequenz eines Batches fertig ist, bevor der nächste beginnt; kurze Sequenzen verschwenden daher GPU-Zyklen im Leerlauf, nachdem sie das End-of-Sequence-Token erreicht haben. Continuous Batching (eingeführt im Orca-Paper, OSDI 2022) arbeitet auf Iterationsebene: In jedem Decode-Schritt werden abgeschlossene Sequenzen entfernt und neue eingefügt. Die Abbildung zeigt vier Batch-Slots über zehn Decode-Schritte unter beiden Strategien.
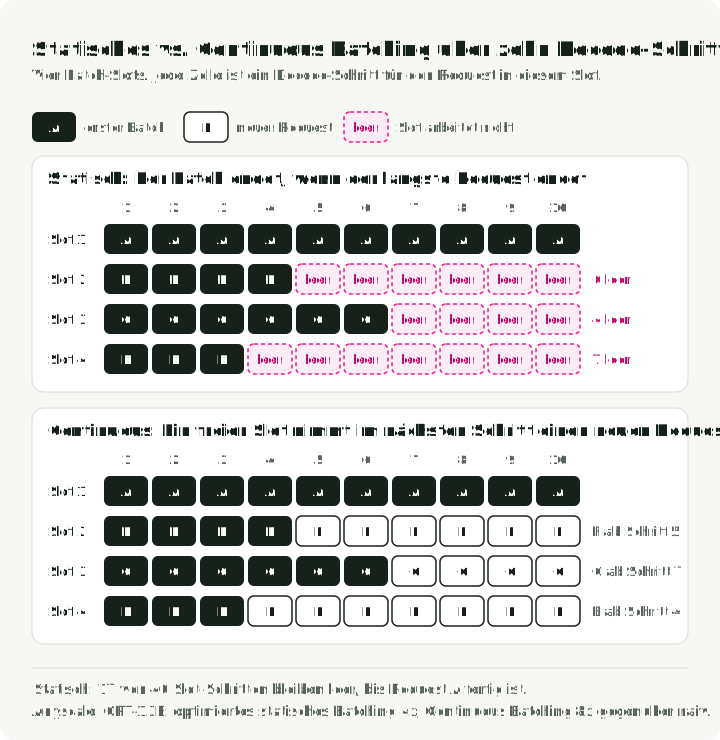
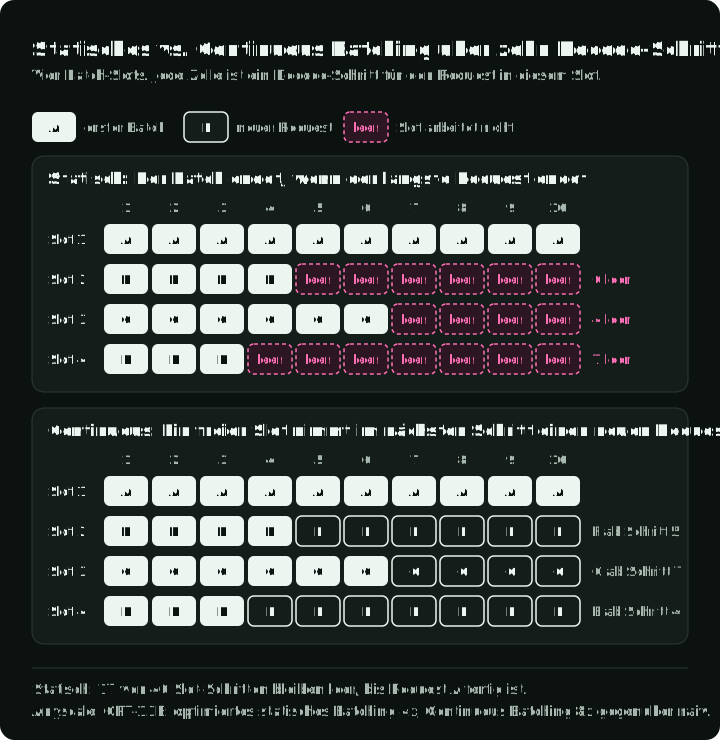
In Anyscales OPT-13B-Benchmark von 2023 auf einer A100-40GB mit 1.000 Requests, 512-Token-Prompts und Outputs mit durchschnittlich 128 Tokens erreichte optimiertes Static Batching das 4-Fache seiner naiven Baseline, Continuous Batching das 8-Fache, und vLLM mit Continuous Batching plus PagedAttention das 23-Fache (Anyscale, 2023). Continuous Batching erhöht außerdem den Druck auf die KV-Allokation, weshalb es üblicherweise mit paginierter Speicherverwaltung kombiniert wird.
14. PagedAttention: virtueller Speicher für den KV cache
vLLMs PagedAttention überträgt die Idee des virtuellen Speichers aus dem Betriebssystem auf die Verwaltung des KV cache. Der KV cache wird in Blöcke fester Größe aufgeteilt (16 Tokens in dieser Abbildung; Blockgrößen variieren je nach Runtime), die Blöcke werden bei Bedarf alloziert, während Tokens entstehen, und logische (sequenzielle) Positionen werden über Block Tables auf physische (verstreute) Speicherorte abgebildet. Mehrere Requests mit gemeinsamem Präfix (System Prompts, Beam Search) können auf dieselben physischen Blöcke zeigen. Präfixwiederverwendung erfordert außerdem kompatible Cache-Schlüssel und eine Cache-Lookup-Policy. Die Abbildung zeigt eine Block Table für zwei Requests, die einen System Prompt teilen.
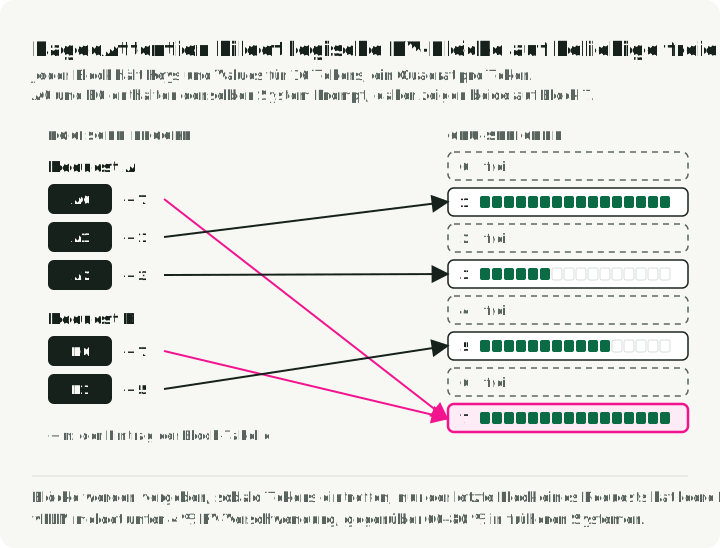
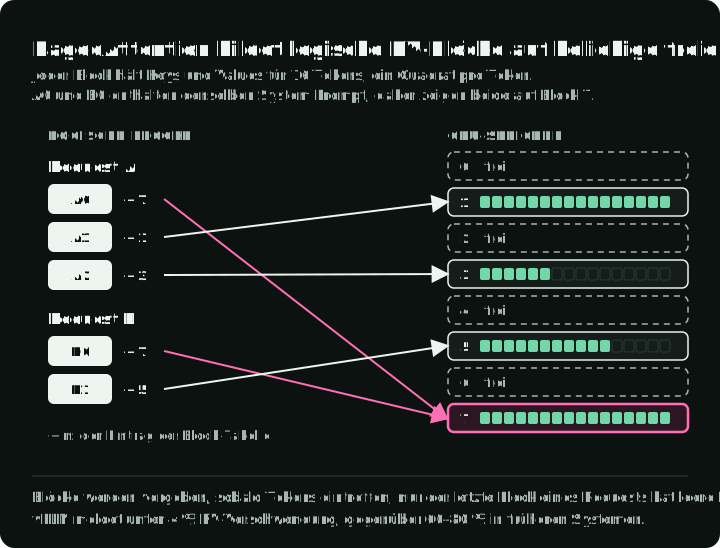
Die vLLM-Evaluation vom Juni 2023 meldete 60–80 % KV-Speicherverschwendung in den getesteten früheren Systemen und unter 4 % mit ihrem paginierten Allokator. Sie meldete 2–4-mal höheren Throughput als TGI und bis zu 24-mal höheren Throughput als Hugging Face Transformers in ausgewählten Workloads. Dies sind historische End-to-End-Vergleiche von Serving-Systemen, kein allgemeiner PagedAttention-Speedup oder fester Höchstwert für die Verschwendung. Ein teilweise gefüllter letzter Block kann bei kurzen Sequenzen einen größeren Anteil verschwenden.
15. Speculative Decoding: mehrere Tokens pro Forward Pass
Beim Speculative Decoding erzeugt ein kleines Draft-Model Kandidaten-Tokens, anschließend bewertet das große Target-Model alle Positionen in einem einzigen Forward Pass. Der Decoder akzeptiert Draft-Tokens von links nach rechts mit Wahrscheinlichkeiten, die sich aus den Verteilungen von Target- und Draft-Model ergeben. Nach der ersten Ablehnung zieht er eine Korrektur aus der Residualverteilung des Target-Models und verwirft die übrigen Draft-Tokens. Dieser modifizierte Rejection-Sampling-Schritt erhält die Output-Verteilung des Target-Models im Rahmen der Hardware-Numerik; exakter Token-Abgleich allein tut das nicht. Die Abbildung geht eine Runde mit vier Draft-Tokens durch.
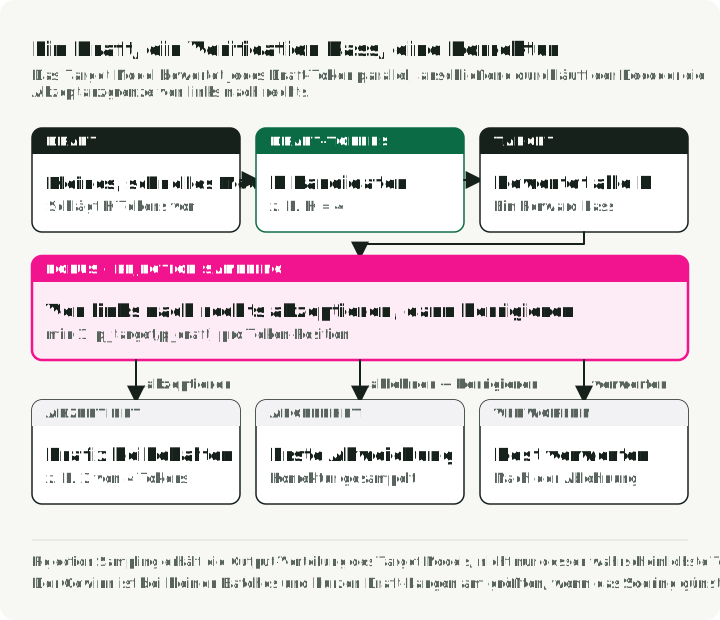
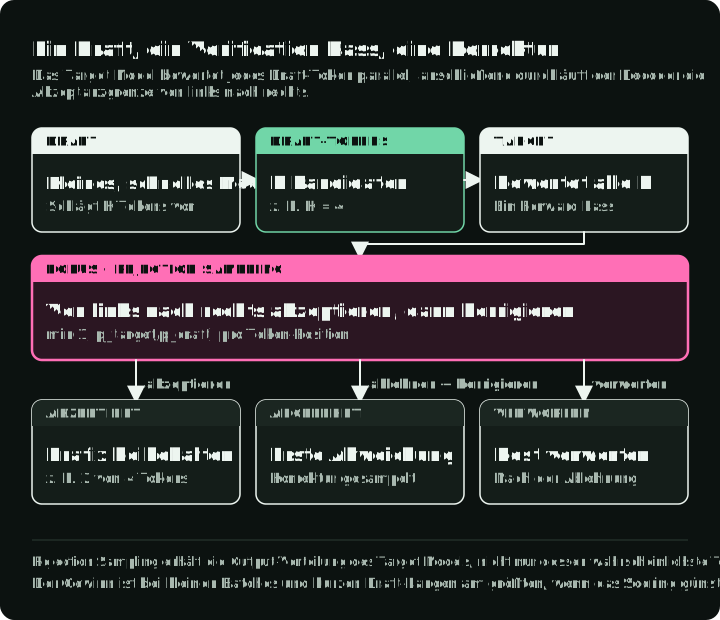
Der Gewinn ist am plausibelsten bei kleinen Serving-Batches und kurzen Draft-Längen, wenn die Bewertung des Drafts von Weight-, KV cache- oder Kommunikationsverkehr dominiert wird und nicht vom zusätzlichen Token-Compute. Das ursprüngliche Paper zum Speculative Sampling meldete für sein getestetes 70B-Chinchilla-Setup einen 2–2,5-fachen Decoding-Speedup; EAGLE-3 v3 meldete in seinen Tests bis zu 6,5-fach. Zu den Varianten gehören Medusa (zusätzliche Vorhersage-Heads, kein separates Model), Prompt Lookup Decoding (N-Gram-Abgleich gegen die Eingabe ohne separaten Forward Pass eines Draft-Models) und EAGLE. Das ursprüngliche EAGLE extrapoliert Features; EAGLE-3 kombiniert mehrere Feature-Ebenen und sagt Tokens direkt vorher.
Bei hohen Batch-Größen kann der zusätzliche Draft- und Verifikationsaufwand den Gewinn aufheben. Speculative Decoding ist am vielversprechendsten, wenn der Serving-Batch klein genug und die Akzeptanzrate der Drafts hoch ist; benchmarken Sie die gesamte Serving-Schleife und nicht nur den Verifikations-Kernel.
16. Prefix Caching und Wiederverwendung des KV cache
Statt den KV cache zu verwerfen, wenn ein Request endet, behält Prefix Caching ihn zur Wiederverwendung für neue Requests mit denselben Präfix-Tokens. Das spart redundanten Prefill für System Prompts, Few-Shot-Beispiele, RAG-Kontext und den Verlauf mehrstufiger Konversationen.
vLLMs Automatic Prefix Caching hasht KV-Blöcke und nutzt eine globale Hash-Tabelle für den Lookup. SGLangs RadixAttention führt einen Radix-Baum mit gecachten KV-Tensoren in Token-Granularität. Beide erfordern tokenidentische Präfixe und kompatible Cache-Schlüssel. Model- oder Adapter-Identität, multimodale Eingaben und Isolationseinstellungen können die Wiederverwendung ebenfalls beeinflussen. Geben Sie die Hit-Rate neben Latency oder Throughput an.
17. Streaming in der Praxis
Streaming sendet Tokens an den Client, sobald sie erzeugt werden, statt auf die vollständige Antwort zu warten. Viele Serving-Frameworks bieten es über Server-Sent Events an: Der Client öffnet eine langlebige HTTP-Verbindung, und der Server schickt jedes Token oder jeden Token-Batch als data:-Event. Die TTFT bestimmt, wann der Nutzer erstmals Output sieht; TPOT bestimmt mit, wie flüssig es sich anfühlt. Legen Sie das Ziel durch Produkttests und das gewählte Interaktionsmodell fest.
Auf der Client-Seite erzwingt Streaming Entscheidungen zum Buffering. Token-für-Token-Rendering kann visuelles Flackern verursachen, besonders bei Markdown oder Codeblöcken, die für die korrekte Formatierung Kontext über mehrere Tokens brauchen. Übliche Muster sind Buffering auf Wortebene (Tokens sammeln, bis eine Leerraumgrenze erreicht ist), Buffering auf Zeilenebene (auf einen Zeilenumbruch warten, bevor gerendert wird) und adaptives Buffering (Fließtext sofort rendern, Codeblöcke puffern). In der OpenAI Chat Completions API fügt stream_options: {"include_usage": true} vor der Nachricht data: [DONE] einen abschließenden Usage-Chunk hinzu. Unterbrochene OpenAI-Streams können den abschließenden Usage-Chunk auslassen. OpenAI-kompatible Server können abweichen, prüfen Sie daher die gewählte Implementierung.
Chunked Prefill ist eine Möglichkeit, lange Prefills daran zu hindern, die Token-Auslieferung für gleichzeitige Nutzer zu blockieren. Decode-Priority-Scheduling kann laufende Requests schützen, während disaggregiertes Serving Prefill und Decode auf getrennten GPU-Pools isoliert.
Teil IV — Modelarchitektur
Die Architektur legt den Speicherbedarf, das Attention-Verhalten und die Trainingsdynamik fest, um die sich die Abschnitte zu Serving und Training herumarbeiten müssen.
18. Grundlagen der Transformer-Architektur
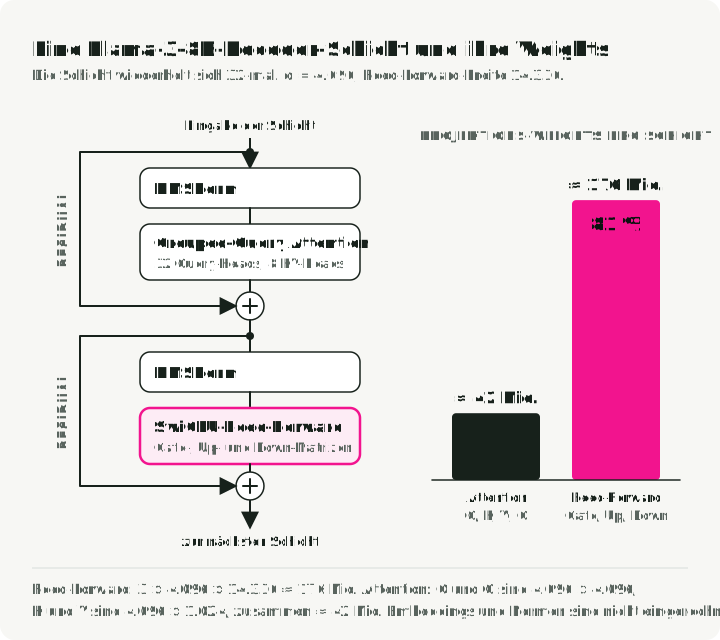
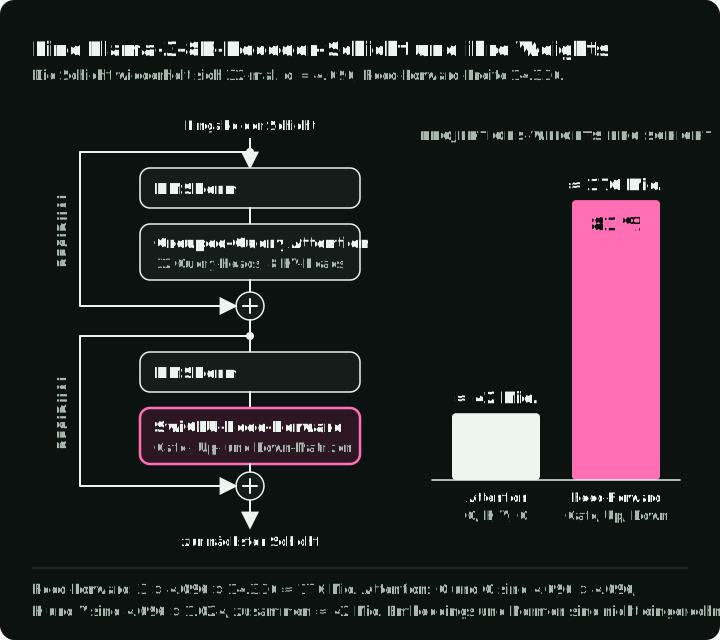
Ein moderner Decoder-only-Transformer (GPT, Llama) ist ein Stapel identischer Schichten mit je zwei Teilblöcken: Attention und Feed-Forward. Jeder Teilblock ist mit einer Residualverbindung und Normalisierung umgeben. Die Abbildung zeigt eine Schicht im Llama-Stil, einschließlich der zwei Pfade, die einen Teilblock überspringen, und wie sich ihre Projektionsgewichte auf Attention und Feed-Forward-Netz verteilen; die Komponenten werden darunter beschrieben.
Die wichtigsten Komponenten:
Multi-Head Attention lässt jedes Token Informationen aus den Tokens gewichten, die unter der Attention-Maske sichtbar sind. Die Eingabe wird in drei Matrizen projiziert: Queries (wonach suche ich?), Keys (was enthalte ich?) und Values (welche Information trage ich?). Die Attention-Scores werden dann so berechnet:
Das Skalarprodukt misst die Ähnlichkeit zwischen allen Tokenpaaren. Die Division durch verhindert, dass die Skalarprodukte zu groß werden (was Softmax in Bereiche mit verschwindenden Gradienten treiben würde). Die Softmax wandelt Scores in Wahrscheinlichkeiten um, und die Multiplikation mit ergibt eine gewichtete Kombination der Value-Vektoren. Werden mehrere Heads parallel ausgeführt, kann das Model verschiedene Beziehungen gleichzeitig beachten (Heads können unterschiedliche Beziehungen lernen; ihre Rollen sind nicht festgelegt).
Das Feed-Forward Network (FFN) transformiert jede Token-Repräsentation unabhängig, nachdem die Attention Informationen über Tokens hinweg gemischt hat. Moderne LLMs verwenden oft SwiGLU statt des ursprünglichen ReLU-FFN mit zwei Matrizen:
SwiGLU hat drei Weight-Matrizen gegenüber zwei bei einem ReLU-FFN und nutzt das glatte Swish. Llama, Mistral und Qwen verwenden es; Gemma nutzt ein approximiertes GeGLU. Die bekannte Zwei-Drittel-Regel gilt für einen herkömmlichen Block mit vollem MHA und : Seine zwei FFN-Matrizen tragen etwa Parameter bei, gegenüber etwa für die Attention. Für SwiGLU-/GQA-Architekturen ist sie keine allgemeine Schätzung. In Llama 3 8B sind , und acht Key-/Value-Heads; damit hat das FFN Mio. Parameter pro Schicht, gegenüber etwa 42 Mio. Parametern der Attention-Projektionen: etwa 81 % dieser Projektionsgewichte, ohne Embeddings und Normalisierung.
Residualverbindungen addieren die Ausgabe jedes Teilblocks zu dessen Eingabe: . Der Skip-Pfad verbessert die Ausbreitung von Signal und Gradient durch tiefe Stapel.
RMSNorm ist in modernen LLM-Familien verbreitet. LayerNorm zentriert neu, indem es den Mittelwert subtrahiert, und skaliert mit der Standardabweichung neu. RMSNorm verzichtet auf die Mittelwertsubtraktion und skaliert nur neu; sein Paper meldet 7–64 % kürzere Laufzeit über die getesteten Models und Frameworks hinweg, ohne die gemessene Aufgabenleistung zu verringern. Auch die Pre-Norm-Platzierung, die vor der Attention oder dem FFN normalisiert, ist verbreitet, weil sie die Gradientenstabilität verbessert.
Schätzung der Parameteranzahl für einen herkömmlichen Decoder mit vollständiger MHA, einem FFN mit zwei Matrizen und Breite sowie gemeinsamen Input-/Output-Embeddings:
wobei die Vokabulargröße, die Hidden-Dimension und die Schichtanzahl ist. Der Term ist die Eingabe-Embedding-Matrix; der Term nähert die Attention- und FFN-Weights jeder Schicht an. Für Llama 3 8B (, , ) ergibt die Schätzung etwa Parameter. Die veröffentlichten 8,03B insgesamt liegen höher, weil die Näherung Architekturdetails wie die genaue FFN-Breite und die separate Ausgabeprojektion auslässt.
19. Decoder-only-Models für allgemeine Generierung
Der ursprüngliche Transformer (2017) hatte sowohl einen Encoder als auch einen Decoder. Seitdem hat sich das Feld in drei Architekturfamilien aufgeteilt, und eine wurde zum Standard für generative AI.
| Familie | Attention | Trainingsziel | Heutiger Einsatz | Beispiele |
|---|---|---|---|---|
| Encoder-only | Bidirektional | Vorhersage maskierter Tokens | Embeddings, Reranker, Klassifikatoren | BERT, RoBERTa |
| Encoder-Decoder | Bidirektionaler Encoder; kausaler Decoder mit Cross-Attention | Sequence-to-Sequence (Span Corruption, T5) | Übersetzung, Spracherkennung | T5, BART, Whisper |
| Decoder-only | Kausal | Vorhersage des nächsten Tokens | Allgemeine Textgenerierung, Chat, Code | GPT, Llama |
Encoder-only-Models verwenden bidirektionale Attention: Jedes Token berücksichtigt jedes andere Token in beide Richtungen. Das erzeugt Repräsentationen für Verständnisaufgaben. Standard-Encoder-only-Models werden üblicherweise nicht als autoregressive Decoder verwendet; sie bilden häufig die Basisarchitektur für Embedding Models, Reranker und schlanke Klassifikatoren (etwa die BERT-basierten Router in RouteLLM).
Encoder-Decoder-Models trennen Verstehen und Generieren. Der Encoder verarbeitet die gesamte Eingabe mit bidirektionaler Attention, danach generiert der Decoder die Ausgabe autoregressiv und greift über Cross-Attention auf die Repräsentationen des Encoders zu. Das passt zu Aufgaben, bei denen Eingabe und Ausgabe unterschiedliche Sequenzen sind, etwa Übersetzung und Spracherkennung.
Decoder-only-Models wie GPT, Llama und Mistral verwenden kausale Attention: Jedes Token berücksichtigt sich selbst und frühere Tokens. Vier nützliche Eigenschaften für die Generierung sind:
- Wiederverwendung des KV cache. Bei kausaler Attention achten frühere Tokens nie auf spätere, sodass ihre Keys und Values gültig bleiben, während neue Tokens entstehen. Ein Cache pro Sequenz wächst durch Anhängen (Abschnitt 6). Ein Encoder-Decoder hält zusätzlich Cross-Attention-Zustand über die Encoder-Ausgabe.
- Training auf Rohtext. Die Vorhersage des nächsten Tokens braucht keine gepaarten Ein- und Ausgaben, sodass jedes Textkorpus Trainingsdaten sind.
- Ein wiederholter Block. Das Model ist ein Stapel identischer Decoder-Schichten, ohne separaten Encoder-Stapel oder Cross-Attention-Pfad, den man bauen, sharden und optimieren müsste.
- In-Context Learning. Anweisungen, Few-Shot-Beispiele und die Anfrage sind alle Tokens in einem Präfix, sodass ein Model eine neue Aufgabe allein aus dem Prompt übernehmen kann.
20. Mixture of Experts
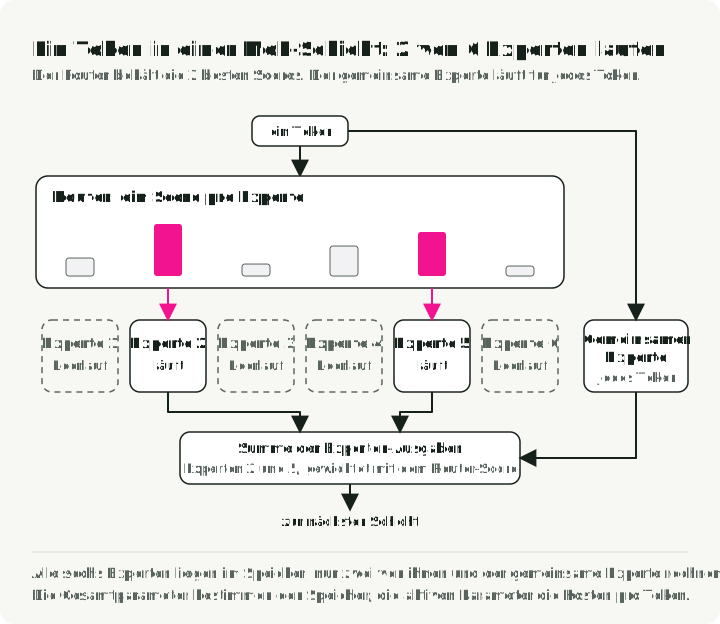
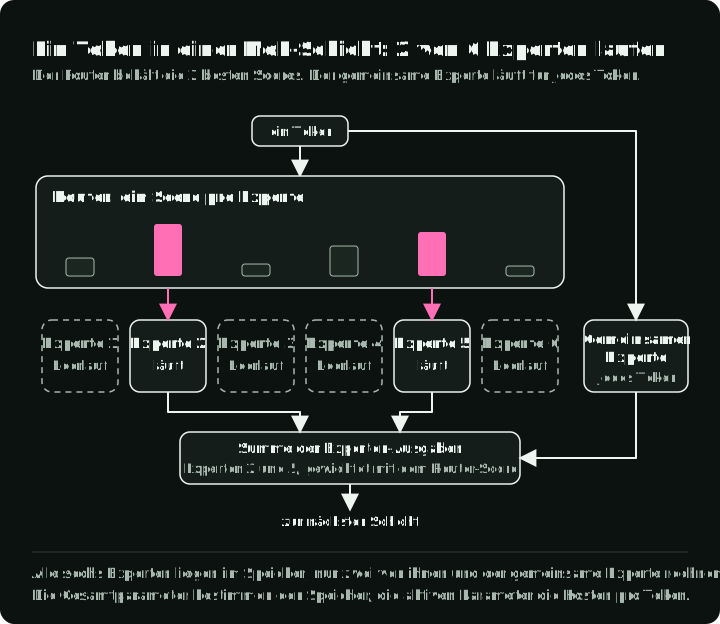
MoE ersetzt ausgewählte dichte FFNs durch mehrere Experten-FFNs plus einen schlanken Gating-Router. Der Router berechnet für jeden Experten einen Score (typischerweise eine Softmax über gelernte lineare Projektionen) und wählt pro Token die Top--Experten. Nur die aktivierten Experten rechnen, sodass ein Model enorme Gesamtkapazität haben und dabei die Kosten pro Token niedrig halten kann. Das ist spärliche bedingte Berechnung. Aktive Parameter nähern den Rechenaufwand pro Token an, aber sämtliche Experten-Weights benötigen Speicher. Kommunikation, Routing, Batch-Belegung und KV-Speicher beeinflussen ebenfalls die Runtime-Kosten. Die Abbildung verfolgt ein Token durch eine MoE-Schicht mit sechs gerouteten Experten und einem Shared Expert.
| Model | Gesamtparameter | Aktive Parameter | Experten (geroutet + shared) | Top- |
|---|---|---|---|---|
| Mixtral 8x7B | 47B | ~13B | 8 + 0 | 2 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 | 8 |
Der Shared Expert in DeepSeek-V3 wird für jedes Token aktiviert. Er liefert eine Basisrepräsentation, auf der sich die gerouteten Experten spezialisieren können.
Das Training von MoE hat drei wiederkehrende Probleme: ungleiche Lastverteilung, Expert Collapse und Kommunikations-Overhead für Expert Parallelism. Klassische MoE-Models fügen einen Hilfsverlust hinzu, der ungleiches Routing bestraft, doch dieser Verlust kann mit dem Hauptziel konkurrieren. DeepSeek-V3 verwendet primär eine batchweise Strategie ohne Hilfsverlust: Bias-Terme außerhalb der Backpropagation senken den Score überlasteter Experten und erhöhen den Score wenig genutzter. Zusätzlich wendet es einen extrem kleinen komplementären sequenzweisen Balance-Verlust an, um extreme Ungleichgewichte innerhalb einer Sequenz zu verhindern. Das Paper meldet in seinem Setup eine bessere Routing-Balance ohne den Zielkonflikt des Hauptverlusts.
21. Tokenization: BPE, SentencePiece und tiktoken
LLMs sehen keinen Text. Sie sehen Folgen ganzzahliger Token-IDs. Ein Tokenizer zerlegt Rohtext in Tokens (Subwort-Teile) und bildet jedes auf eine ID ab. Die Wahl des Tokenizers beeinflusst Modelqualität, Inference-Geschwindigkeit und die Fairness zwischen Sprachen.
Byte Pair Encoding (BPE) ist der gängige Algorithmus. Er verschmilzt iterativ die häufigsten benachbarten Paare im Trainingskorpus. Ein vereinfachtes Beispiel:
- Mit einem Vokabular auf Zeichenebene beginnen:
[l, o, w, e, r, _] - Das häufigste Paar ist
(l, o)→ zuloverschmelzen → Vokabular:[l, o, w, e, r, _, lo] - Das nächsthäufige Paar ist
(lo, w)→ zulowverschmelzen → das Vokabular erhältlow - Fortfahren, bis das Vokabular die Zielgröße erreicht (z. B. 128K Tokens)
Häufige Wörter wie „the“ werden zu einzelnen Tokens, während seltene Wörter wie „defenestration“ in Subwort-Teile wie ["def", "en", "est", "ration"] in einem erfundenen Beispiel zerlegt werden. Die tatsächliche Zerlegung hängt von Tokenizer und Version ab. Der Tradeoff liegt zwischen Vokabulargröße und Sequenzlänge.
Drei Tokenizer-Implementierungen decken die meisten Produktionsfälle ab:
- SentencePiece trainiert direkt auf rohem Unicode-Text ohne sprachspezifischen Pre-Tokenizer. Es erhält Leerraum mit dem Metasymbol
▁und kann optional auf UTF-8-Byte-Tokens zurückfallen. Es unterstützt BPE- und Unigram-Models und wird von Llama 1/2, T5 und frühen Mistral-Tokenizern verwendet. Neuere Mistral-Tekken-Tokenizer nutzen BPE im tiktoken-Stil. - tiktoken ist OpenAIs Rust-basierter Tokenizer mit Byte-Level-BPE. In seinem veröffentlichten GPT-2-Benchmark lief er 3–6-mal schneller als die getestete
GPT2TokenizerFast-Konfiguration. Llama 3 wechselte von SentencePiece zum Algorithmus von tiktoken. - Hugging Face Tokenizers ist eine weit verbreitete Rust-basierte Bibliothek mit Unterstützung für BPE, WordPiece und Unigram.
Die Vokabulargröße unterscheidet sich stark zwischen Modelfamilien:
| Model | Tokenizer | Vokabulargröße |
|---|---|---|
| GPT-2 | Byte-Level-BPE | 50.257 |
| Llama 2 | SentencePiece BPE | 32.000 |
| Llama 3 | BPE im tiktoken-Stil | 128.256 |
| GPT-4o | tiktoken o200k_base | ~200K |
Bei einem vergleichbaren Tokenizer-Trainingssetup kann ein größeres Vokabular weniger Tokens für denselben Text bedeuten, aber auch eine größere Embedding-Matrix (der Term in Abschnitt 18).
Fertility misst, wie viele Tokens ein Tokenizer pro Wort oder einer anderen gewählten Texteinheit erzeugt. Sie variiert mit dem genauen Tokenizer, der Sprache, der Schrift, der Normalisierung, der Domäne und der Stichprobe. Messen Sie sie auf repräsentativem Traffic, statt von einem Tokenizer oder einer Sprache auf andere zu extrapolieren.
22. Context windows und Positionskodierungen
Das Context Window begrenzt die Token-Sequenz, die einem Generierungsrequest zur Verfügung steht. Chunked Prefill und gecachtes Decode verarbeiten pro Durchlauf nur einen Teil dieser Sequenz. APIs können außerdem getrennte Input- und Output-Grenzen setzen. Veröffentlichte Grenzen sind:
| Model | Veröffentlichte Token-Grenze | Jahr |
|---|---|---|
| Llama 1 | 2.048 | 2023 |
| Llama 3.1 | 128K | 2024 |
| GPT-4.1 | 1.047.576 | 2025 |
| Gemini 2.5 Pro | 1.048.576 Input | 2025 |
GPT-4.1 begrenzt den Output außerdem auf 32.768 Tokens; Gemini 2.5 Pro auf 65.536. Die Gemini-Zeile nennt eine Input-Grenze, während GPT-4.1 ein Context Window angibt; diese Felder sind daher nicht identisch.
Attention vergleicht jedes Paar sichtbarer Tokens, aber nichts in diesem Vergleich sagt, wie weit sie auseinanderliegen. Ohne Positionsinformation kann vollständige Self-Attention unterschiedliche Wortreihenfolgen derselben Token-Menge nicht unterscheiden; die Zustände pro Token folgen der Permutation der Eingabe. Die kausale Maske eines Decoders liefert ein gewisses Ordnungssignal, weil jedes Token nur sein Präfix sieht, stellt aber keine expliziten relativen Positionen bereit. Positionskodierungen fügen Position und relative Distanz explizit hinzu.
Drei gängige Ansätze sind:
-
RoPE (Rotary Position Embeddings) rotiert Query- und Key-Vektoren um positionsabhängige Winkel, sodass ihr Skalarprodukt von der relativen Position abhängt. Der Token-Inhalt bestimmt weiterhin den Attention-Score; RoPE fügt Positionsinformation hinzu, ohne gelernte absolute Positions-Embeddings. Es wird von offenen Modelfamilien wie Llama, Mistral und Qwen verwendet.
-
ALiBi (Attention with Linear Biases) verzichtet auf Änderungen an den Embeddings und addiert eine Strafe direkt auf die Attention-Scores: Je weiter zwei Tokens auseinanderliegen, desto größer der negative Bias. Es hat keine gelernten Positionsparameter. Im ursprünglichen Paper erreichte ein 1,3B-Model, trainiert mit Sequenzen von 1.024 Tokens, bei 2.048 Tokens vergleichbare Ergebnisse wie ein Model mit sinusförmiger Positionskodierung, das mit 2.048 trainiert wurde. Das Verhalten jenseits der getesteten Models und Längen des Papers hängt vom Model ab.
-
YaRN (Yet another RoPE extensioN) erweitert ein RoPE-Model über seinen Trainingskontext hinaus. Es gruppiert Frequenzdimensionen in drei Kategorien und skaliert jede anders. Im Vergleich des Papers bei gleichem Trainingsrezept mit Positionsinterpolation benötigte YaRN 400 statt 1.000 Trainingsschritte (Anhang B.2). Die allgemeinere Aussage im Abstract zu 10-mal weniger Daten nutzt einen anderen Vergleich.
Teil V — Training und Alignment
Dieser Teil unterscheidet das Ziel, das Fähigkeiten erzeugt, die Techniken, mit denen das Training auf die verfügbare Hardware passt, und die Methoden, die das Verhalten eines Models danach formen.
23. Pretraining, Fine-Tuning und Alignment
Pretraining für ein autoregressives LLM nutzt selbstüberwachte Vorhersage des nächsten Tokens auf einem großen Korpus. Encoder-Models können andere Ziele nutzen, etwa die Vorhersage maskierter Tokens. Sein Compute-Bedarf umfasst viele Größenordnungen; Llama 3 405B etwa nutzte FLOPs. Supervised Fine-Tuning (SFT) passt das vortrainierte Model an aufgabenspezifische gelabelte Daten an. RLHF / RLAIF nutzt Präferenzdaten, um das Verhalten zu formen: Eine klassische RLHF-Pipeline sammelt Vergleiche, trainiert ein Reward-Model und optimiert dann die Policy. RLAIF ersetzt einen Teil der menschlichen Urteile durch AI-generiertes Feedback. Abschnitt 31 behandelt Distillation, einen separaten Pfad, in dem ein ausgerichtetes Teacher-Model Trainingsdaten für ein kleineres Student-Model erzeugt.
Der Compute-Bedarf hängt von Modelgröße, Sequenzlänge, Datenmenge, Optimizer und Methode ab. PPO trägt außerdem mehr Modelzustand als SFT, weil ein typisches Setup Policy-, Referenz-, Reward- und Critic-Models umfasst. Den vollständigen Entscheidungsrahmen für Fine-Tuning habe ich im LLM Fine-Tuning Guide behandelt.
24. LoRA und QLoRA: parameter-effizientes Fine-Tuning
LoRA friert die vortrainierten Weights ein und fügt trainierbare Low-Rank-Matrizen () und () ein, sodass das aktualisierte Weight ist. Das LoRA-Paper reduzierte GPT-3 175B in seinem Setup auf etwa 18 Millionen trainierbare Parameter. Der Rang ist ein Tuning-Parameter und keine Regel zur Aufgabenkomplexität; wählen Sie ihn über einen Sweep nach Qualität und Speicher. LoRA-Adapter lassen sich nach dem Training in die Basisgewichte mergen, um bei der Inference einen separaten Adapter-Pfad zu vermeiden.
QLoRA lädt das Basismodell in 4-Bit-NF4-Quantization, während LoRA-Adapter in BF16 trainiert werden. NormalFloat4 legt mehr Quantisierungsstufen nahe null, wo die Dichte der Weights am höchsten ist. Das Paper trainierte ein 65B-Model auf einer einzelnen GPU mit 48 GB und meldete Ergebnisse nahe an seinen 16-Bit-Baselines. Die Runtime- und Speicher-Tradeoffs gelten nur für den getesteten Stack.
25. Mixed-Precision-Training
Jedes Gleitkommaformat verteilt seine Bits auf drei Felder: Vorzeichen (immer 1 Bit), Exponent (bestimmt den Dynamikbereich) und Mantisse (bestimmt die Präzision). Mehr Exponent-Bits bedeuten einen größeren Bereich darstellbarer Größenordnungen; mehr Mantissen-Bits bedeuten feinere Unterscheidungen zwischen benachbarten Werten. Ganzzahlformate haben gar keinen Exponenten und stellen nur gleichmäßig verteilte ganze Zahlen in einem festen Bereich dar.
| Format | Bits | Layout (S / E / M) | Bereich | Präzision | Üblicher Einsatz |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ~7 Dezimalstellen | Master-Weights, Optimizer-Zustände (Adam-Momentum und -Varianz) | |
| BF16 | 16 | 1 / 8 / 7 | ~2 Dezimalstellen | Bevorzugtes Trainingsformat; gleicher Bereich wie FP32 und meist ohne Loss Scaling | |
| FP16 | 16 | 1 / 5 / 10 | ~3 Dezimalstellen | Training mit Loss Scaling (ältere GPUs); Inference auf Hardware vor Hopper | |
| FP8 E4M3 | 8 | 1 / 4 / 3 | ~1 Dezimalstelle | Forward Pass auf Hopper (H100) — mehr Präzision für Weights und Activations | |
| FP8 E5M2 | 8 | 1 / 5 / 2 | ~0,6 Dezimalstellen | Backward Pass auf Hopper — größerer Bereich für Gradienten | |
| INT8 | 8 | Ganzzahl mit Vorzeichen | bis | Exakte Ganzzahlen | Post-Training-Quantization der Weights für Inference (W8A8); KV cache-Quantization |
| INT4 | 4 | Ganzzahl mit Vorzeichen | bis | Exakte Ganzzahlen | Aggressive weight-only Quantization (AWQ, GPTQ) für Inference auf speicherbegrenzter Hardware |
BF16 hat denselben Bereich wie FP32, weil der Bereich vom Exponentenfeld bestimmt wird und BF16 alle 8 Exponent-Bits von FP32 behält. Dafür gibt BF16 Mantissen-Bits ab (7 statt 23), tauscht also Präzision gegen eine Halbierung des Speichers ein und vermeidet viele Bereichsprobleme, unter denen das FP16-Training leidet. FP16 hat nur 5 Exponent-Bits, was seinen endlichen Bereich auf etwa 65K begrenzt. Viele Gradienten sind dagegen für FP16 zu klein und laufen gegen null unter. Loss Scaling multipliziert den Loss vor der Backpropagation, damit diese Gradienten darstellbar bleiben, und skaliert sie vor dem Optimizer-Schritt wieder zurück; dynamisches Scaling senkt den Faktor, wenn ein Overflow auftritt. Der größere Exponentenbereich von BF16 macht das meist überflüssig.
Ganzzahlformate sind für die Hauptarithmetik des Trainings unüblich, weil die Backpropagation einen großen Dynamikbereich braucht. Weit verbreitet sind sie bei der Inference, wo sich eingefrorene Weights auf kalibrierte Skalen abbilden lassen. INT4-Quantization der Weights verkleinert ein 7B-Model vor dem Runtime-Overhead von etwa 14 GB auf 3,5 GB; die Qualität muss für das gewählte Model und die gewählte Methode gemessen werden.
FP8-Training auf der H100 über die Transformer Engine nutzt E4M3, wo Präzision zählt, und E5M2, wo ein größerer Bereich zählt. Das FP8-LM-Paper meldet, dass sein Mixed-Precision-Framework GPT-175B 75 % schneller als die BF16-Megatron-LM-Baseline und 37 % schneller als die NVIDIA Transformer Engine trainierte, im getesteten H100-Setup. DeepSeek-V3 nutzte FP8-Mixed-Precision und meldete für seinen finalen Trainingslauf etwa $5.6 Millionen an Compute zu Mietpreisen, ohne Forschung und Entwicklung und Infrastruktur.
26. Gradient Checkpointing
Jede Schicht des Forward Pass erzeugt eine Zwischenausgabe, die Activation heißt:
Normalerweise müssen alle Activations im Speicher bleiben, weil die Backpropagation sie zur Berechnung der Gradienten braucht. Bei einem tiefen Transformer können die gespeicherten Activations mehr Speicher belegen als die Model Weights selbst.
Gradient Checkpointing tauscht Compute gegen Speicher: Es verwirft die meisten dieser Activations und berechnet sie während der Backprop bei Bedarf neu. Die Standardstrategie (Chen et al., 2016) teilt ein Netz mit Schichten in gleichmäßig verteilte Segmente und speichert nur die Grenz-Activation jedes Segments. Diese gespeicherten Grenzen sind die „Checkpoints“. Alle Zwischen-Activations innerhalb eines Segments werden sofort verworfen.
Erreicht der Backward Pass eine Schicht innerhalb eines Segments, werden ihre Activations vom nächstgelegenen Checkpoint aus neu berechnet. Bei der gleichmäßig segmentierten Strategie sinkt der Speicher für gespeicherte Activations von auf . Jedes Segment wird einmal neu berechnet, was pro Trainingsschritt etwa einen zusätzlichen Forward Pass kostet (Chen et al., 2016). Die tatsächliche Speicherersparnis und der Mehraufwand für die Neuberechnung hängen von Model, Checkpoint-Grenzen, Sequenzlänge, Framework und Implementierung ab; messen Sie beides im Ziel-Trainingslauf. FlashAttention wendet dasselbe Prinzip innerhalb der Attention an, indem es die vollständige Attention-Matrix nicht materialisiert. Für gewöhnliche Hugging-Face-Trainer-Läufe aktivieren Sie es mit gradient_checkpointing=True. Mit FSDP nutzen Sie die Activation-Checkpointing-Integration des Frameworks, sofern unterstützt; die generische Option kann redundante All-Gathers im Backward Pass verursachen.
27. DeepSpeed-ZeRO-Stufen
Beim Standard-Data-Parallelism hält jede GPU eine vollständige Kopie der Model Weights, Gradienten und Optimizer-Zustände. Bei Adam braucht jeder Parameter 2 Bytes für das FP16-Weight + 4 Bytes für das FP32-Master-Weight + 4 Bytes für das Momentum + 4 Bytes für die Varianz + 2 Bytes für den Gradienten, also 16 Bytes pro Parameter. Ein Model mit 7,5B Parametern braucht ~120 GB pro GPU, und jede GPU speichert dasselbe. Bei 64 GPUs sind das 64 identische Kopien zu je 120 GB.
DeepSpeed ZeRO (Zero Redundancy Optimizer) beseitigt diese Duplizierung, indem es diese Komponenten über die GPUs verteilt (Sharding), statt sie zu replizieren:
- Stufe 1: Optimizer-Zustände partitionieren. Jede GPU speichert nur 1/N der Optimizer-Zustände (die FP32-Master-Weights plus Adams erstes und zweites Moment, 12 Bytes/Parameter). Wenn eine GPU ein Weight aktualisieren muss, aktualisiert sie nur ihren Ausschnitt und verteilt das Ergebnis per Broadcast. Unter den Annahmen unten sinkt der Speicher von ~120 GB auf ~41,3 GB pro GPU.
- Stufe 2: zusätzlich Gradienten partitionieren. Gradienten (2 Bytes/Parameter) werden nicht mehr per All-Reduce an jede GPU verteilt. Jede GPU erhält per Reduce-Scatter nur den Gradientenausschnitt, den sie braucht. Unter denselben Annahmen sinkt der Speicher auf ~28,1 GB pro GPU.
- Stufe 3: zusätzlich die Model Weights partitionieren. Jede GPU hält nur 1/N der FP16-Weights. Vor dem Forward oder Backward Pass jeder Schicht ruft die GPU All-Gather auf, um die vollständigen Schichtgewichte vorübergehend von allen anderen GPUs zu rekonstruieren, rechnet und verwirft die gesammelten Weights. Unter denselben Annahmen sinkt der Speicher auf ~15,0 GB pro GPU.
Die Abbildung zeichnet den Modelzustand pro GPU in jeder Stufe maßstabsgetreu, mit den Kommunikationskosten jeder Stufe.
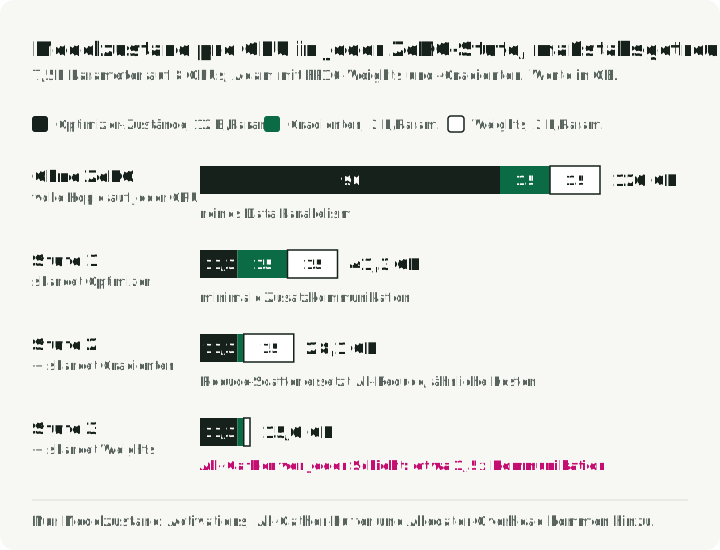
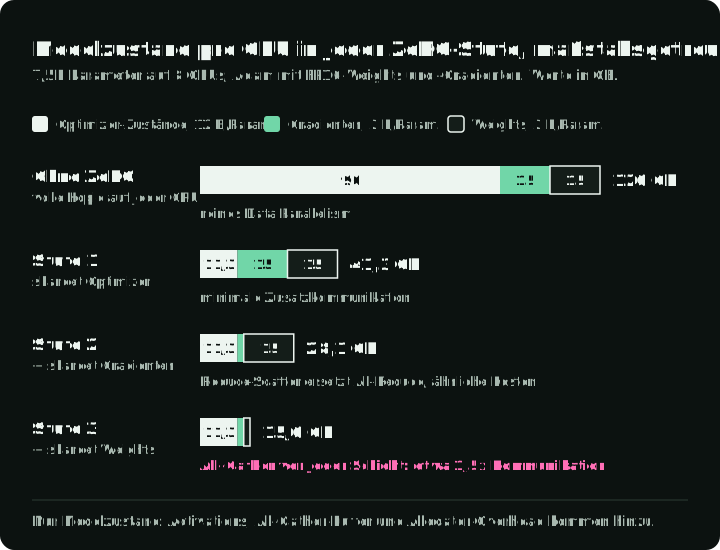
Das sind ungefähre Werte für den Modelzustand eines Models mit 7,5B Parametern auf 8 GPUs (World Size ), mit FP16-Weights und -Gradienten sowie FP32-Adam-Master-Weights, -Momentum und -Varianz. Sie schließen Activations, temporäre All-Gather-Puffer, Allocator-Fragmentierung und Framework-/Runtime-Overhead aus. Die Rechnung lautet Bytes pro Parameter, wobei jeder Zustand nur in den Stufen durch geteilt wird, die ihn sharden.
So wiederholen Sie die Rechnung für eine andere Modelgröße oder GPU-Anzahl:
def zero_model_state_gb(params_b, n_gpus, stage):
    """Model-state GB per GPU for Adam with FP16 weights and gradients.

    Optimizer states (FP32 master weights, momentum, variance) take 12 bytes
    per parameter, gradients 2, and weights 2. Stage 1 shards the optimizer
    states, stage 2 also the gradients, and stage 3 also the weights.
    """
    optimizer, gradients, weights = 12, 2, 2
    if stage >= 1:
        optimizer /= n_gpus
    if stage >= 2:
        gradients /= n_gpus
    if stage >= 3:
        weights /= n_gpus
    return params_b * (optimizer + gradients + weights)

for stage in range(4):
    print(f"stage {stage}: {zero_model_state_gb(7.5, 8, stage):g} GB per GPU")

assert [zero_model_state_gb(7.5, 8, s) for s in range(4)] == [120.0, 41.25, 28.125, 15.0]
# 70B parameters: Stage 3 on 8 GPUs still needs 140 GB of model state per GPU;
# 16 GPUs bring it to 70 GB, before activations.
assert zero_model_state_gb(70, 8, 3) == 140.0
assert zero_model_state_gb(70, 16, 3) == 70.0
Der Tradeoff ist die Kommunikation. Stufe 1 fügt minimalen Overhead hinzu, und Stufe 2 ersetzt All-Reduce durch Reduce-Scatter bei ähnlichen Kosten. Stufe 3 braucht All-Gather-Aufrufe vor jeder Schicht sowohl im Forward als auch im Backward Pass, etwa 1,5-faches Kommunikationsvolumen gegenüber Standard-Data-Parallelism.
ZeRO-Infinity erweitert Stufe 3 durch das Auslagern partitionierter Zustände in den CPU-RAM und sogar auf NVMe-SSDs, was das Training von Models mit Billionen Parametern auf begrenzten GPU-Clustern möglich machen kann. Das Auslagern auf Speichermedien verursacht PCIe- und Speichertransferkosten; die gemessene Auswirkung hängt von Laufwerk, PCIe-Topologie, Partitionierung, Prefetch, Überlappung der Transfers und Workload ab. Nutzen Sie es, um Kapazitätsanforderungen zu erfüllen, statt eine feste Verlangsamung anzunehmen, und profilieren Sie die Zielkonfiguration.
28. FSDP: PyTorch-natives Sharding
Fully Sharded Data Parallel (FSDP) ist PyTorchs eingebaute Antwort auf DeepSpeed ZeRO-3. Es shardet Parameter, Gradienten und Optimizer-Zustände mit derselben Grundidee über die GPUs. Bei aktiviertem vollständigem Sharding und Resharding sind die Operationen für jede umschlossene Einheit:
- All-Gather der vollständigen Parameter von allen GPUs (die komplette Schicht vorübergehend rekonstruieren).
- Compute des Forward oder Backward Pass für diese Schicht.
- Free: die gesammelten Parameter sofort freigeben. Jede GPU behält nur ihren eigenen Shard.
- Reduce-Scatter der Gradienten, sodass jede GPU nur den ihr zugewiesenen Gradientenausschnitt erhält.
Weil FSDP nativ zu PyTorch gehört, lässt es sich direkt in PyTorch-Debugging-Tools, Profiler und torch.compile integrieren. Die Performance im Vergleich zu DeepSpeed ZeRO-3 hängt von Wrapping-Policy, Kommunikationstopologie, Offload-Einstellungen und Modelgröße ab; vergleichen Sie beide daher auf demselben Cluster.
| Kriterium | FSDP (PyTorch) | DeepSpeed ZeRO |
|---|---|---|
| Steuerungsstil | Volles Sharding über PyTorch-APIs | Wählbare ZeRO-Stufen |
| Offloading | CPU-Offloading | CPU + NVMe mit ZeRO-Infinity |
| Framework-Integration | Natives PyTorch, torch.compile-Pfade | Separate Bibliothek und Konfigurationssystem |
| Auswahltest | Ziel-PyTorch-Workload profilieren | Benötigte Features und Offloading profilieren |
FSDP2 (2024–2025) ist eine Neufassung, die die Integration mit torch.compile für bessere Kernel Fusion verbessert, FP8-Training über TorchAO unterstützt und die API vereinfacht. Sowohl FSDP als auch DeepSpeed sind über Hugging Face Accelerate zugänglich, das beide über Konfiguration für kompatible, entsprechend vorbereitete Trainingsskripte unterstützt. Die nötigen Einstellungen für Wrapping, Checkpointing und Offload unterscheiden sich weiterhin.
29. Scaling Laws und Inference-Kosten
Chinchilla Scaling (DeepMind, 2022) fand unter seinen Annahmen eine Compute-optimale Aufteilung bei etwa 20 Trainings-Tokens pro Parameter. Dieses Ziel enthält die nachgelagerten Serving-Kosten nicht. Erreicht ein kleineres, mit mehr Daten trainiertes Model die erforderliche Qualität, kann es über einen Lebenszyklus mit hohem Inference-Volumen weniger kosten.
Eine Strategie für die Lebenszykluskosten ist, ein kleineres Model mit deutlich mehr Daten zu trainieren:
| Model | Parameter | Trainings-Tokens | Tokens/Parameter | Tokens/Parameter ÷ 20 (abgeleitet) |
|---|---|---|---|---|
| Chinchilla | 70B | 1,4T | 20:1 | 1× |
| Llama 1 | 65B | 1,4T | 22:1 | 1× |
| Llama 2 | 70B | 2,0T | 29:1 | 1,4× |
| Llama 3 8B | 8B | 15T | 1.875:1 | 94× |
| Qwen3-0.6B | 0,6B | 36T | 60.000:1 | 3.000× |
Das ist das angezeigte Verhältnis von Tokens pro Parameter, geteilt durch den ungefähren Wert von 20 Tokens pro Parameter aus dem Chinchilla-Paper. Es ist ein beschreibendes Verhältnis und kein gemessener Multiplikator für Qualität oder Kosten.
Für ein Model, das mit hohem Volumen betrieben wird, kann mehr Trainings-Compute für ein kleineres Model die Lebenszykluskosten senken. Llama 3 8B veranschaulicht die Strategie, aber ob sie sich lohnt, hängt von der erforderlichen Qualität und dem erwarteten Inference-Volumen ab. „Chinchilla-optimal“ bezieht sich auf die Effizienz des Trainings-Compute, ein anderes Ziel als die Lebenszykluskosten.
30. RLHF, DPO, GRPO und die Alignment-Landschaft
Alignment lenkt ein vortrainiertes Model in Richtung gewünschter Anweisungen, Präferenzen und Sicherheitsrichtlinien. Es garantiert für sich genommen weder Wahrhaftigkeit noch sicheres Verhalten. Die folgenden Methoden unterscheiden sich in Implementierungsaufwand, Datenanforderungen, Exploration und Trainingsstabilität.
Die klassische RLHF-Pipeline: SFT → menschliche Präferenzpaare sammeln → ein Reward-Model auf diesen Paaren trainieren → die Policy mit PPO (Proximal Policy Optimization) feinabstimmen. Ein herkömmliches PPO-Setup hat vier Modelrollen: Policy, Referenz, Critic/Value-Model und Reward-Model. Ihr Speicherbedarf hängt von Sharing, Sharding, Präzision, Offload und Platzierung ab; vier Rollen bedeuten nicht vier vollständige GPU-residente Kopien. PPO reagiert außerdem empfindlich auf Hyperparameter. Es neigt außerdem zu Reward Hacking: Das Model nutzt Eigenheiten des Reward-Models aus, etwa ausführliche, selbstsicher klingende Antworten, statt die Qualität tatsächlich zu verbessern.
DPO (Direct Preference Optimization) verzichtet auf das gelernte Reward-Model und die Online-RL-Schleife, indem es direkt einen Loss auf Präferenzpaaren optimiert. Das vereinfacht die Trainingspipeline. Standard-DPO ist offline: Es trainiert auf einem festen Dataset und exploriert in der Update-Schleife keine neuen Antworten. Ob diese Einschränkung eine Rolle spielt, hängt von der Aufgabe und der Datenabdeckung ab.
GRPO (Group Relative Policy Optimization, DeepSeek) entfernt den gelernten Critic von PPO, indem es mehrere Completions pro Prompt erzeugt und gruppenrelative Rewards als Baseline verwendet. Das senkt die Last durch Modelzustand im Vergleich zu einem typischen PPO-Setup. Anders als DPO ist GRPO on-policy: Das Model erzeugt während des Trainings frische Antworten. DeepSeek-R1 kombiniert GRPO mit RLVR (Reinforcement Learning from Verifiable Rewards) und nutzt dafür Prüfungen wie Mathematik-Antworten, Code-Kompilierung und Unit-Tests. Diese Rewards lassen sich leichter prüfen als ein gelernter Präferenz-Score, aber unvollständige Tests und Proxy-Ziele können trotzdem ausgenutzt werden.
| Methode | Modelrollen in einem herkömmlichen Setup | Reward-Signal | Online/Offline | Zentrale Einschränkung |
|---|---|---|---|---|
| PPO | Policy, Referenz, Critic, Reward | Gelerntes Reward-Model | Online | Reward Hacking, aufwendiges Tuning |
| DPO | Policy plus Referenz-Scores, die vorab berechnet werden können | Implizit (Präferenzpaare) | Offline | Keine Exploration, feste Daten |
| GRPO | Policy; optionale Referenz für KL und optionaler gelernter Reward | Explizit (Regel/Verifier oder gelernt) | Online | Abhängig von der Reward-Qualität und aussagekräftiger Varianz innerhalb der Gruppe |
Die Referenz-Policy bei GRPO hängt von der Implementierung ab. Beispielsweise lädt TRL GRPOTrainer kein Referenz-Model, wenn sein KL-Koeffizient beta null ist. Berücksichtigen Sie Modelplatzierung und Präzision beim Vergleich des Trainingsspeichers.
31. Distillation: Wissen zwischen Models komprimieren
Knowledge Distillation überträgt Fähigkeiten von einem großen Teacher auf einen kleineren Student. Logit-basierte Distillation trainiert den Student darauf, die Output-Verteilung des Teachers nachzubilden. Bei der datenbasierten Distillation erzeugt der Teacher Beispiele, auf denen der Student feinabgestimmt wird. Datenbasierte Methoden sind bei LLMs verbreitet, weil sie architekturübergreifend und mit reinen API-Teachern funktionieren; ihr Wert wird aber durch die Qualität des Teachers, die Datenabdeckung, die Filterung und die Generierungskosten begrenzt.
DeepSeek-R1 kuratierte eine Mischung von etwa 800.000 Beispielen (rund 600.000 Reasoning-bezogene und 200.000 Nicht-Reasoning-Beispiele) und nutzte sie, um Qwen2.5- und Llama-3-Models von 1,5B bis 70B Parametern zu distillieren. In der Evaluation des Papers:
- DeepSeek-R1-Distill-Qwen-32B erreicht 72,6 % bei AIME 2024 und 94,3 % bei MATH-500, über den im Paper berichteten Werten von OpenAI o1-mini.
- DeepSeek-R1-Distill-Qwen-7B erreicht 55,5 % bei AIME 2024, mit einem kleineren Model über dem Ergebnis von QwQ-32B-Preview im Paper.
In den Experimenten von DeepSeek-R1 mit kleinen Models übertraf Distillation das direkte GRPO auf den getesteten Basismodellen. Dieses Ergebnis spricht in diesem Setup für Distillation; es begründet keine allgemeine Rangfolge zwischen Distillation und RL.
32. Generierung synthetischer Daten
LLM-generierte Trainingsdaten werden in mehreren wiederkehrenden Mustern eingesetzt:
- Self-Instruct startet mit einer kleinen Seed-Menge menschlich geschriebener Anweisungen: Das LLM erzeugt neue Anweisungen, Eingaben und Ausgaben, die gefiltert und in den Pool zurückgegeben werden. Das Alpaca-Projekt nutzte 52.000 Beispiele, die aus 175 Seeds erzeugt wurden. Stanford meldete Kosten für die Datengenerierung unter $500 und für das Fine-Tuning unter $100, was die anfänglichen Reproduktionskosten unter $600 hält; der Vergleich mit GPT-3.5 war eine begrenzte Projektevaluation und keine breite Gleichwertigkeit.
- Evol-Instruct (WizardLM) nimmt vorhandene Anweisungen und entwickelt sie iterativ entlang von Komplexitätsachsen weiter (Einschränkungen hinzufügen, Reasoning vertiefen, Probleme konkreter machen), um zunehmend schwierigere Trainingsbeispiele zu erzeugen.
- Microsofts Phi-4 (14B) nutzte synthetische Daten für einen großen Teil des Pretrainings, darunter Generierung, Kritik, Selbstrevision und Instruction Reversal. Sein technischer Bericht vergleicht die resultierende Leistung bei STEM und Coding auf den ausgewählten Benchmarks mit größeren Models.
Ein Risiko ist Model Collapse, wenn echte Daten rekursiv durch generierte Daten ersetzt werden. In den untersuchten Konfigurationen verschwinden seltene Teile der ursprünglichen Verteilung schrittweise (Shumailov et al., 2024 in Nature veröffentlicht). Dies ist keine unvermeidliche Folge jeder Nutzung synthetischer Daten. Eine separate Akkumulationsstudie fand anderes Verhalten, wenn echte und generierte Daten über Generationen hinweg erhalten blieben. Eine separate Ahrefs-Klassifikatorstudie zog im April 2025 aus 900.000 Seiten eine neu erkannte englische Seite pro Domain und klassifizierte 74,2 % als Seiten mit etwas AI-generiertem Text. Diese Anbieterstudie ist keine Vollerhebung des Webs. Gegenmaßnahmen beginnen mit dem Mischen synthetischer und echter Daten, Filtern und Herkunftsverfolgung, damit rekursiv generiertes Material messbar wird.
Teil VI — Skalierung und Deployment
Sobald eine Workload auf einem einzelnen Gerät nicht mehr passt oder ihr SLO nicht mehr erfüllt, geht es um drei Entscheidungen: wie die Arbeit aufgeteilt wird, welche Runtime die nötigen Stellschrauben bietet und ob jeder Request dasselbe Model braucht.
33. Vier Formen von Parallelismus
Die vier Formen unterscheiden sich darin, welchen Teil des Models jede GPU hält und was über die Verbindung zwischen den GPUs läuft. Die Abbildung zeigt jede Form auf zwei GPUs.
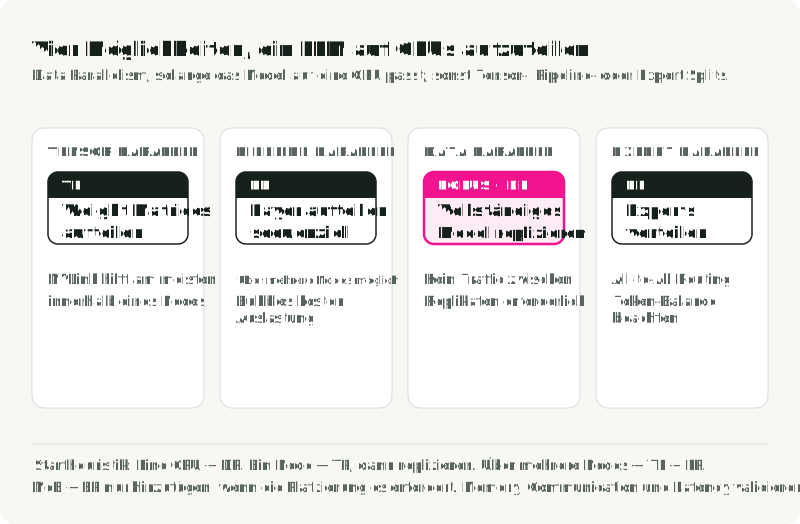
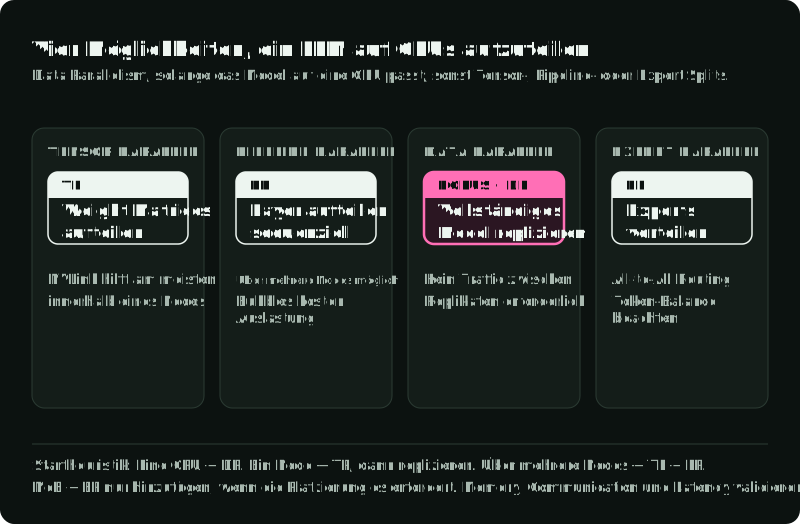
Tensor Parallelism (TP) teilt einzelne Weight-Matrizen über GPUs auf und kommuniziert meist nach jeder Schicht. Schnelle Verbindungen innerhalb eines Knotens wie NVLink machen es dort am praktikabelsten. Mehr Shards verringern Speicher und Compute pro Gerät, erhöhen aber die Kommunikation; wählen Sie den Grad daher mit einem Latency-Benchmark.
Pipeline Parallelism (PP) teilt Schichten sequenziell über GPUs auf und reicht Activations zwischen den Stufen weiter. Sein Kommunikationsmuster funktioniert auch über Knoten hinweg, aber Pipeline-Bubbles und ungleiche Stufenzeiten senken die Auslastung. Große Deployments kombinieren oft TP innerhalb eines Knotens und PP über Knoten hinweg.
Data Parallelism (DP) repliziert das Serving-Model, sodass jedes Replikat unabhängige Requests ohne Kommunikation zwischen den Replikaten pro Request bearbeitet. Es ist effizient, wenn das Model passt und sich der Traffic ausbalancieren lässt. Im Training wird DP üblicherweise mit ZeRO oder FSDP kombiniert, um den Zustand zu sharden.
Expert Parallelism (EP) verteilt MoE-Experten über GPUs und nutzt All-to-All-Kommunikation für das Token-Routing. Seine Performance hängt von Token-Balance, Platzierung der Experten und Interconnect-Topologie ab; der All-to-All-Verkehr kann zum dominierenden Bottleneck werden.
Eine Heuristik für den Einstieg in Parallelismus:
- Das Model passt auf eine GPU: mit unabhängigen Replikaten beginnen und die DP-Skalierung messen.
- Das Model passt in einen Knoten: TP innerhalb des Knotens testen und die Gruppe dann replizieren, wenn der Traffic es verlangt.
- Das Model erstreckt sich über Knoten: eine Kombination aus TP und PP gegen Interconnect und Latency-Ziel testen.
- Mixture of Experts: EP nur hinzufügen, wenn die Platzierung der Experten es erfordert.
34. Serving-Frameworks im Vergleich
Die Runtime entscheidet, welche der Optimierungen aus Teil III Sie erhalten, ohne Kernels zu schreiben. Wählen Sie mit der Tabelle den ersten Kandidaten für den Benchmark und vergleichen Sie ihn dann mit einer Alternative auf denselben Prompts, Output-Längen, derselben Hardware und demselben SLO.
| Runtime | Einsetzen, wenn | Zuerst prüfen |
|---|---|---|
| vLLM | Allgemeines GPU-Serving mit OpenAI-kompatibler API | Das Zielmodell und die GPU in der aktuellen Kompatibilitätsmatrix |
| SGLang | Der Traffic teilt lange Präfixe (System Prompts, mehrstufiger Chat, Agents) oder braucht Structured Output | Prefix-Cache-Hit-Rate auf Ihrem eigenen Traffic |
| TensorRT-LLM | Die Flotte besteht nur aus NVIDIA-Hardware, und die niedrigste Latency ist wichtiger als Portabilität | Unterstützung für Ihr Model und Ihre Präzision (FP8, FP4) |
| llama.cpp | CPU, Apple Silicon oder eine einzelne Consumer-GPU, mit quantisierten GGUF-Models | Tokens pro Sekunde aus dem Benchmark-Tool auf der Zielmaschine |
| Ollama | Lokale Entwicklung und Demos | Vor hoher Concurrency oder SLO-Arbeit auf eine Serving-Runtime wechseln |
Dieselben Ausgangspunkte für Benchmarks als geordnete Liste:
- Eine lokale Maschine oder eine Consumer-GPU: Beginnen Sie mit llama.cpp, für die Entwicklung mit Ollama.
- Nur NVIDIA und Latency hat Priorität: Nehmen Sie TensorRT-LLM in den Benchmark auf.
- Lange gemeinsame Präfixe oder Structured Output: SGLang.
- Sonst: vLLM.
Messen Sie die erste Wahl mit Ihren Prompts, Output-Längen, Ihrer Hardware und Ihrem SLO.
vLLM bietet paginierte KV-Allokation, Continuous Batching, eine OpenAI-kompatible API und mehrere Parallelismus-Modi. Die Unterstützung für Models und Hardware ändert sich häufig.
SGLang kombiniert RadixAttention für die Wiederverwendung von Präfixen, einen eigenen Scheduler und strukturierte Generierung. Die veröffentlichten Throughput-Gewinne hängen von Workload und Konfiguration ab.
TensorRT-LLM zielt durch CUDA-Graph-Aufzeichnung und -Wiedergabe, die den Launch-Overhead reduzieren, sowie Kernel-Optimierung einschließlich Fusion auf niedrige Latency einzelner Requests und unterstützt FP8/FP4 nativ. Frühere Versionen wie v1.2.0 unterstützten den vorab ausgeführten Build einer TensorRT-Engine. NVIDIAs aktueller Migrationsleitfaden nennt PyTorch als einziges Backend: Die LLM-API und trtllm-serve laden einen Hugging Face Checkpoint direkt, ohne Engine-Build. Die veröffentlichten Zahlen gelten für bestimmte Hardware und Models; TensorRT-LLM läuft nur auf NVIDIA-GPUs.
TGI wurde am 21. März 2026 archiviert; sein Repository ist schreibgeschützt. Sein README empfiehlt vLLM, SGLang, llama.cpp oder MLX für neue Deployments.
Ollama legt den Schwerpunkt auf einen einfachen lokalen Model-Workflow.
llama.cpp ist eine portable C/C++-Runtime mit Pfaden für ARM, x86, Metal, CUDA, ROCm und Vulkan. GGUF unterstützt mehrere Quantization-Stufen. Die Performance variiert stark mit Model, Quantization, Kontext und Backend.
35. GPU-Auswahl für Inference
Die Tabelle vergleicht veröffentlichte Hardware-Eigenschaften. Die Präzisionsunterstützung der Hersteller macht Spitzenwerte für Compute nicht direkt über Formate hinweg vergleichbar; wählen Sie daher zuerst nach Speicherbedarf und benchmarken Sie dann die Ziel-Workload. Prüfen Sie aktuelle Cloud-Preise separat, denn sie variieren nach Anbieter, Region, Bindung und Verfügbarkeit.
| GPU | Speicher | Bandbreite | Native niedrige Präzision | NVLink pro GPU |
|---|---|---|---|---|
| B200 SXM | 180 GB HBM3e | Bis 8 TB/s | FP4, FP8 | 1,8 TB/s |
| H200 SXM | 141 GB HBM3e | 4,8 TB/s | FP8 | 900 GB/s |
| H100 SXM | 80 GB HBM3 | 3,35 TB/s | FP8 | 900 GB/s |
| A100 80 GB SXM | 80 GB HBM2e | 2,039 TB/s | INT8 (kein FP8) | 600 GB/s |
| L40S | 48 GB GDDR6 | 864 GB/s | FP8 | Keine |
| A10G (AWS G5) | 24 GB GDDR6 | 600 GB/s | INT8 (kein FP8) | Keine |
| RTX 4090 | 24 GB GDDR6X | ~1 TB/s | FP8 | Keine |
Die A10G-Zeile nutzt NVIDIAs A10-Spezifikation als Näherung für die Bandbreite; die verlinkte AWS-G5-Spezifikation belegt die genaue A10G-Bandbreite nicht. Der Wert der RTX 4090 (1.008 GB/s) stammt aus dem Ada-Architektur-Whitepaper.
Die 141 GB Kapazität der H200 können manche Deployments großer Models vereinfachen. Die GDDR-Karten in den unteren Zeilen haben ein Drittel oder weniger der Bandbreite der H100 und kein NVLink; sie eignen sich daher besser für quantisierte Models, die auf eine GPU passen, als für Models, die Tensor Parallelism brauchen.
AWQ und GPTQ servieren 4-Bit-Models, indem sie unterstützte Matrixoperationen in ein Compute-Format wie FP16 oder BF16 dequantisieren. Kompatibilität und Geschwindigkeit hängen weiterhin von Modelarchitektur, Quantization-Format, Serving-Backend, Kernel und GPU ab; prüfen Sie daher die Support-Matrix des Backends und benchmarken Sie das genaue Artefakt. Alle aufgeführten GPUs unterstützen INT8-Matrixoperationen.
LLM-Decode ist oft durch die Speicherbandbreite begrenzt, daher können HBM-Kapazität und -Bandbreite für Serving-Workloads wichtiger sein als die maximalen TFLOPS. Vergleichen Sie GPUs bei konstant gehaltenem Model, konstanter Präzision, Batch-Verteilung, Kontextlänge und Latency-Ziel.
36. Model Cascading und Routing
Model Routing wählt anhand der vorhergesagten Komplexität oder Fähigkeit aus, welches LLM jede Anfrage bearbeitet. RouteLLM (LMSYS/UC Berkeley, ICLR 2025) meldet in Tabelle 6 ein Kostenverhältnis von 3,66x bei 95 % des GPT-4-Turbo-Baseline-Scores auf MT-Bench. Das entspricht etwa 73 % niedrigeren modellierten Kosten unter den Preisen, dem schwachen Model und dem Bewertungssetup dieses Experiments. Ob Routing sich lohnt, hängt von aktuellen Preisen, Traffic-Mix, Routerfehlern und der Mindestqualität ab.
Router reichen von schlanken Klassifikatoren bis zu LLM-basierten Judges. Cascading ist die sequenzielle Variante: Eine Anfrage beginnt bei einem günstigeren Model und eskaliert, wenn eine Scoring-Funktion die Antwort ablehnt. FrugalGPT meldet in seinem evaluierten Modelpool bis zu 98 % niedrigere Kosten oder bis zu 4 % höhere Genauigkeit. Eine Produktions-Cascade braucht kalibrierte Eskalationskriterien und Monitoring für die Anfragen, die das günstige Model fälschlich akzeptiert. Die Abbildung zeigt, wo jeder Ansatz seine Entscheidung trifft und wo jeder scheitert.
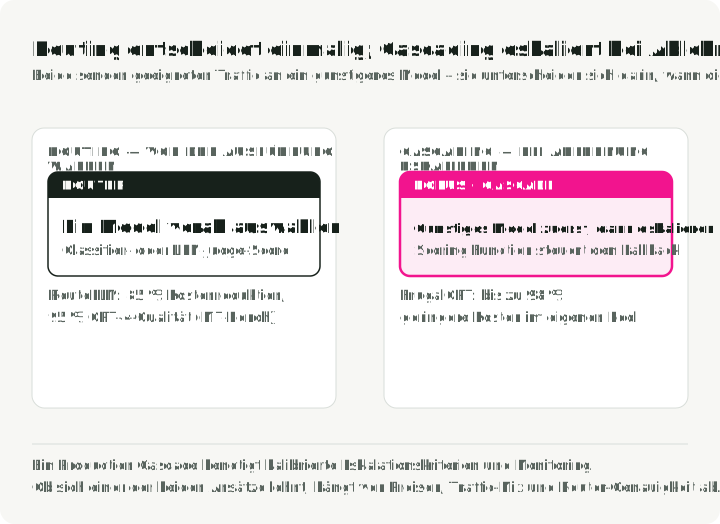
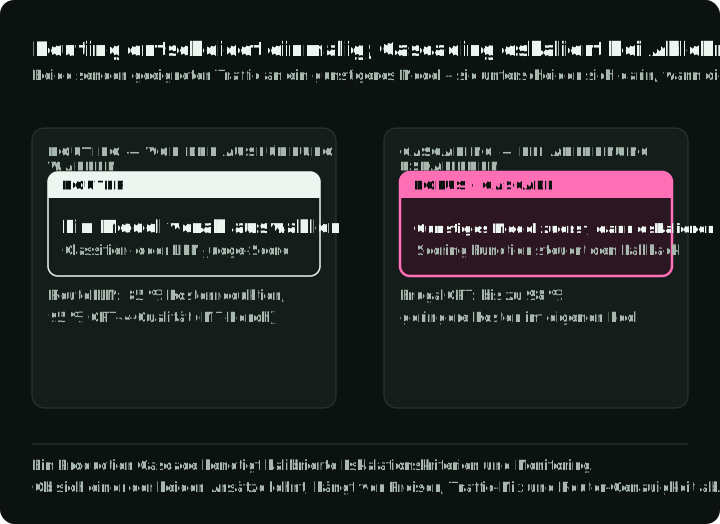
Teil VII — Anwendungen
Anwendungen scheitern an Stellen, die der Serving-Stack nicht sieht. Retrieval kann scheitern, bevor die Generierung beginnt, Agents können eine ungültige Aktion wählen, und eine Prompt-Änderung kann eine Aufgabe verbessern und dabei eine andere kaputtmachen.
37. Embedding-Models vs. generative Models
Embedding Models kodieren Text in Vektoren fester Dimension, die semantische Bedeutung erfassen. Die unten verglichenen Ein-Vektor-Models geben einen dichten Vektor pro Eingabe aus, üblicherweise mit einigen Hundert bis mehreren Tausend Dimensionen. Andere Retrieval-Architekturen können mehrere Vektoren auf Token-Ebene behalten; der folgende Speichervergleich betrifft Ein-Vektor-Embeddings. Ihre Basisarchitekturen umfassen bidirektionale Encoder-only-Transformer und von Decodern abgeleitete Models, die für Repräsentationslernen angepasst wurden. Eine Pooling-Schicht verdichtet Token-Repräsentationen oft zu einem Vektor, über Mean Pooling, ein spezielles Klassifikationstoken oder eine modelspezifische Last-Token-Methode. Kontrastives Fine-Tuning bringt semantisch ähnliche Texte anschließend näher zusammen und unterschiedliche Texte weiter auseinander.
Aktuelle Embedding-Models unterscheiden sich in den Eigenschaften, die Speicherkosten und Indexwahl bestimmen: Ausgabedimensionen, akzeptierte Eingabetypen, Deployment und Ausgabepräzision.
| Model | Max. Dimensionen | Eingabe | Weights | Native Ausgabepräzision |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 4.096 (32–4.096 über MRL) | Text | Offen (Apache 2.0) | Float |
| Gemini Embedding 2 | 3.072 (128–3.072) | Text, Bild, Video, Audio, PDF | API | Nicht angegeben |
| pplx-embed-v1-4B | 2.560 (MRL) | Text | Offen (MIT) | INT8 und binär |
| OpenAI text-embedding-3-large | 3.072 (verkürzt über dimensions) | Text | API | Float |
Das sind Beispiele und keine Rangliste. Evaluieren Sie Sprache, Modalität, Aufgabe, Dimension und Serving-Kosten auf einem gemeinsamen Retrieval-Set.
Matryoshka Representation Learning (MRL, Kusupati et al., NeurIPS 2022) macht Embedding-Dimensionen flexibel. Benannt nach russischen Matroschka-Puppen, trainiert MRL ausgewählte Embedding-Präfixe so, dass sie nützliche Informationen erhalten. Seine Experimente vergleichen diese Präfixe mit separat trainierten kleineren Repräsentationen; gleiche Qualität ist ein empirisches Ergebnis, keine Garantie für jede Aufgabe. Beim Training aggregiert MRL die Verluste über eine gewählte Menge von Präfixdimensionen, meist fortlaufende Halbierungen; das Beispiel des Papers mit 2048 Dimensionen nutzt . Der aggregierte Verlust bringt die führenden Dimensionen dazu, grobe semantische Information zu tragen, wobei spätere Dimensionen feinere Details ergänzen.
Nach dem Training lässt sich ein MRL-Embedding auf eine unterstützte Präfixdimension kürzen. OpenAI meldet, dass text-embedding-3-large mit 256 Dimensionen in seinem zitierten MTEB-Vergleich text-embedding-ada-002 mit 1.536 Dimensionen übertrifft. Das ergibt eine 6-fache Reduktion des rohen Vektorspeichers; Suchlatenz und Datenbankkosten hängen außerdem von Index, Metadaten, Filterung und Hardware ab.
Das Embedding-Model ist eine wichtige Komponente in einer RAG-Pipeline, neben Parsing, Chunking, Suche, Reranking und Generierung. Wird relevante Evidenz nicht abgerufen, kann ein stärkerer Generator sie nicht zuverlässig ersetzen.
38. RAG-Architektur in Produktion
Retrieval-Augmented Generation versorgt ein LLM mit Dokumenten, die zur Abfragezeit abgerufen werden. Es kann aktuelle oder private Evidenz liefern, die in den Model Weights fehlt, aber Retrieval garantiert nicht, dass die Antwort diese Evidenz korrekt verwendet. Ein RAG-System in Produktion ist eine mehrstufige Pipeline, deren Stufen getrennt evaluiert werden müssen. Die Abbildung zeigt den Offline-Ingestion-Pfad, den Pfad pro Anfrage und wo die drei unten aufgeführten Fehlermodi auftreten.
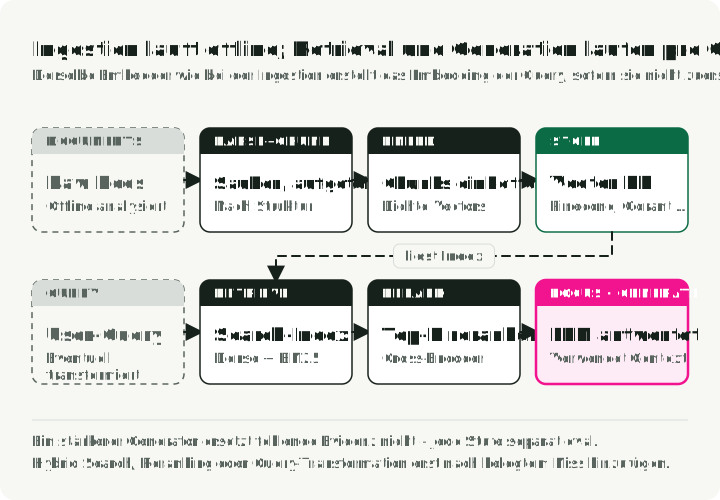
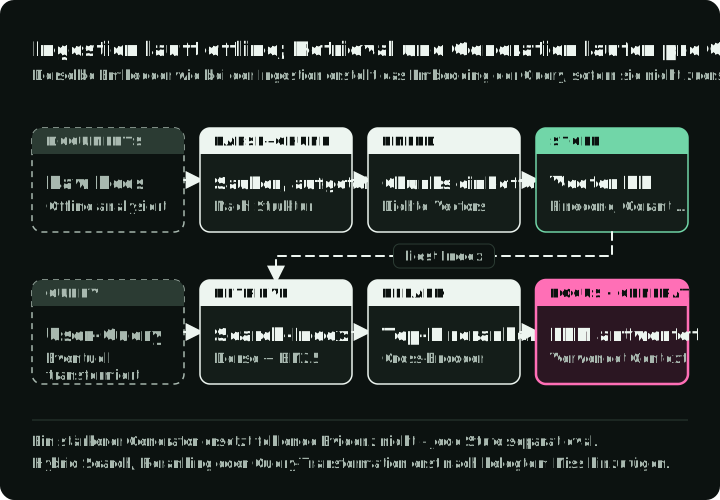
Die Ingestion-Pipeline läuft offline. Rohdokumente (PDFs, HTML, Markdown, Datenbanken) werden zuerst in sauberen Text geparst. Beim PDF-Parsing können Tabellen, Überschriften und Formatierung verloren gehen. Der Text wird dann in Chunks zerlegt, die unabhängig voneinander eingebettet und indexiert werden.
Chunking beeinflusst sowohl den Retrieval-Recall als auch den Kontext, der dem Generator zur Verfügung steht. Sinnvolle Größen hängen von Dokumentstruktur, Granularität der Anfragen sowie den Grenzen von Embedder und Reranker ab. Gängige Ansätze sind feste Größe mit Überlappung, rekursives Aufteilen entlang von Dokumentgrenzen und semantisches Chunking nach Embedding-Ähnlichkeit. Vergleichen Sie sie anhand von Relevanzlabels auf Seiten- oder Abschnittsebene, statt einen Token-Bereich pauschal zu übernehmen.
Jeder Chunk wird dann mit einem Model wie denen aus Abschnitt 37 eingebettet und in einem Vektorindex gespeichert. pgvector hält Vektoren in einer Postgres-Datenbank, die Sie ohnehin betreiben. Ein dedizierter Store wie Qdrant, Weaviate oder Pinecone bringt eingebaute hybride Suche mit und skaliert den Index getrennt von der Anwendungsdatenbank.
Die Retrieval-Pipeline läuft zur Abfragezeit. Beginnen Sie mit einer messbaren Baseline und fügen Sie Stufen erst hinzu, wenn die Fehleranalyse zeigt, dass sie einen echten Fehlgriff beheben:
- Hybride Suche kombiniert dichtes Vektor-Retrieval mit spärlichem Retrieval wie BM25, oft zusammengeführt über Reciprocal Rank Fusion (RRF). Die dichte Suche deckt semantische Umschreibungen ab; die spärliche Suche findet exakte Bezeichner, Fehlercodes und Akronyme. Herstellerbenchmarks melden Gewinne gegenüber reinen Vektor-Baselines, aber die Größe hängt vom Korpus und von den Relevanzlabels ab.
- Reranking schickt abgerufene Kandidaten durch ein Model, das Anfrage und Dokument gemeinsam bewertet. Das kann die feine Relevanz verbessern, kostet aber einen weiteren Modelaufruf. Anzahl der Kandidaten, Anzahl der behaltenen Ergebnisse und Latency sollten gemeinsam abgestimmt werden. Die vollständige mehrstufige Pipeline habe ich in Building a Modern Search Ranking Stack behandelt.
- Query Transformation formuliert die Anfrage des Nutzers vor dem Retrieval um, um den Recall zu verbessern. HyDE (Hypothetical Document Embeddings) lässt das LLM ein hypothetisches Dokument erzeugen, das eingebettet und für das Retrieval echter Dokumente genutzt wird. Der generierte Text ist eine Suchrepräsentation, kein verifizierter Antwortbeleg. Multi-Query Expansion erzeugt mehrere Formulierungen derselben Frage. Step-Back Prompting stellt zuerst eine allgemeinere Frage, um Informationen zu übergeordneten Prinzipien abzurufen oder von ihnen auszugehen.
Die häufigen Fehlerbilder:
- Retrieval-Fehler: Das richtige Dokument existiert, wird aber nicht abgerufen. Testen Sie Chunking, Query-Transformation, hybride Suche und Metadatenfilter gegen den Fehlgriff.
- Context Poisoning: Irrelevante abgerufene Chunks führen das LLM in die Irre. Testen Sie Reranking, Kontextfilter und kleinere behaltene Mengen.
- Lost-in-the-Middle: In den getesteten Settings für Multi-Dokument-Fragebeantwortung und Key-Value-Retrieval fanden Liu et al., dass die Antwortleistung im Allgemeinen am höchsten war, wenn relevante Information am Anfang oder Ende der Eingabe stand, und niedriger, wenn sie in der Mitte stand.
GraphRAG (Microsoft, 2024) extrahiert Entitäten und Beziehungen, erkennt Graph-Communities und erstellt Community-Zusammenfassungen. Seine globale Suche beantwortet korpusweite Fragen anhand dieser Zusammenfassungen; sie ist nicht einfach Vector Retrieval mit einem zusätzlichen Graph. Der Tradeoff ist zusätzliche Arbeit für Extraktion, Indexierung, Speicherung und Evaluation.
Leitfäden aus der Praxis nennen Latency-Bereiche für Embedding, Suche, Reranking und Generierung, doch diese Werte variieren nach Region, Korpus, Hardware und Model. Messen Sie jede Stufe in Traces und evaluieren Sie die Qualitätsänderung, bevor Sie die zusätzliche Latency akzeptieren.
39. Agent-Architekturen und Tool Calling
LLM-Agents nutzen Models, um Tool Calls rund um einen sich entwickelnden Zustand auszuwählen und zu sequenzieren. Drei nützliche Orchestrationsmuster sind:
- ReAct verschränkt die Auswahl von Aktionen mit Beobachtungen. Es kann sich nach jedem Tool Result anpassen, aber ein wachsender Verlauf erhöht Token- und Latency-Kosten.
- ReWOO — plant Tool Calls mit Platzhaltern und expliziten Ergebnisabhängigkeiten, führt dann den Plan aus und synthetisiert die Antwort. Nur unabhängige Calls können parallel laufen; ein Call, der ein früheres Ergebnis referenziert, muss darauf warten. Das Paper meldet Token-Einsparungen gegenüber ReAct, aber der feste Plan benötigt einen expliziten Recovery-Pfad, wenn ein Tool fehlschlägt.
- Planner-Executor trennt Planung von Ausführung und kann nach einem Fehler eine Re-Planning-Policy ergänzen. Er erlaubt für jede Rolle ein anderes Model, fügt aber Planzustand und einen zweiten Modelaufruf hinzu, der scheitern kann.
| Muster | Wiederholte Modelarbeit | Anpassbarkeit | Nützlicher Ausgangspunkt |
|---|---|---|---|
| ReAct | Liest Beobachtungen vor der nächsten Aktion | Aktualisiert nach Beobachtungen | Ungewisser oder explorativer Tool Use |
| ReWOO | Nutzt einen Plan mit expliziten Abhängigkeiten wieder | Fester Plan, sofern nicht erweitert | Arbeit, die vor Tool Results geplant werden kann |
| Planner-executor | Plant, führt aus und kann neu planen | Kann den expliziten Plan ändern | Längere Aufgaben, die von Kontrolle profitieren |
Die Abbildung zeigt die drei Muster, sodass Sie sehen, wo jedes plant und ob es nach einem Tool Result einen Weg zurück hat.
Function Calling ist ein gängiger Mechanismus für den Aufruf von Tools. APIs stellen Tool-Definitionen bereit und liefern strukturierte Argumente zurück, was den Bedarf an Freitext-Parsing verringert. Schema-gültige Argumente können dennoch das falsche Tool wählen oder ungültige Werte enthalten. Paralleles Function Calling kann Roundtrips verringern, wenn Operationen unabhängig sind.
Structured Output und Constrained Decoding erzwingen ein Schema, indem sie die in jedem Generierungsschritt verfügbaren Tokens einschränken. Engines wie xgrammar, das in vLLM und SGLang verwendet wird, können in unterstützten Konfigurationen viele Syntax- und Parsing-Fehler mit geringem Overhead beseitigen. Sie garantieren nicht, dass die extrahierten Werte oder Entscheidungen korrekt sind. Schema-Guided Reasoning (SGR) nutzt Feldreihenfolge und Schemastruktur, um den Zwischenzustand vor der endgültigen Entscheidung prüfbar zu machen. Seine drei Muster sind Cascade (sequenzielle Schritte), Routing (Union-Typen als semantische Weichen) und Cycle (begrenzte Listen).
Ein größerer Tool-Satz und eine längere Aktionssequenz können die Auswahlqualität verringern und Latency oder Token-Kosten erhöhen. Messen Sie diese Kurven mit den tatsächlichen Tool-Beschreibungen und der Fehlerverteilung. Frameworks wie LangGraph können State und Recovery-Pfade explizit machen, nehmen Ihnen aber die Evaluation nicht ab.
40. Prompt Engineering für Produktion
Prompting in Produktion ist ein Evaluationsproblem: Ändern Sie einen Teil des Prompts oder Kontexts und messen Sie dann Aufgabenqualität und Fehlerbilder. Die folgenden Techniken sind gängige Ausgangspunkte, keine allgemeingültige Reihenfolge.
Few-Shot-Beispiele sind oft wirksam, um das Ausgabeformat zu steuern. Beginnen Sie mit 3–5 Beispielen, die leere Eingaben, mehrdeutige Anfragen und mehrteilige Antworten abdecken, und messen Sie das Ergebnis dann auf einem Held-out-Set. Beispiele sollten die reale Eingabeverteilung abdecken und nicht nur den Idealfall. Mehr Beispiele verbrauchen Kontext und garantieren keine weiteren Gewinne.
Chain-of-Thought-(CoT-)Prompting bittet ein Model, Zwischenschritte seines Reasoning vor der Antwort offenzulegen. Kojima et al. (2022) meldeten Gewinne durch das Suffix „Let’s think step by step“ bei ihren getesteten Reasoning-Aufgaben, doch der Effekt variiert je nach Model, und neuere Reasoning-APIs legen verborgene Traces möglicherweise nicht offen. Bevorzugen Sie in Produktion eine prüfbare Aufgabenzerlegung oder eine knappe Begründung, wenn sie für den Evaluator nützlich ist. Self-Consistency (Wang et al., 2023) zieht mehrere Reasoning-Pfade als Stichprobe und aggregiert die Antworten; dabei werden zusätzliche Inference-Kosten gegen Robustheit bei geeigneten Aufgaben getauscht.
Structured Output mit expliziten JSON Schema (Abschnitt 39) beseitigt viele Parsing-Fehler. Engines für Constrained Decoding wie xgrammar können die unterstützte Grammatik während der Generierung durchsetzen; faktische Korrektheit und semantische Gültigkeit erfordern weiterhin Evaluation, und nicht unterstützte Schema-Features müssen möglicherweise gesondert behandelt werden.
Prompt Chaining zerlegt eine Aufgabe in fokussierte Stufen, zum Beispiel Intent klassifizieren → Kontext abrufen → Antwort generieren → Ausgabe validieren. Es kann Fehler lokalisieren, pro Stufe unterschiedliche Models erlauben und cachebaren Zwischenzustand offenlegen. Es fügt aber auch Schnittstellen und Latency hinzu; vergleichen Sie es daher mit einer Baseline aus einem einzigen Aufruf.
Temperature verändert die Sampling-Verteilung. Niedrige Werte sind ein vernünftiger Ausgangspunkt für Klassifikation oder Extraktion; höhere Werte können die Vielfalt beim Ideenfinden erhöhen. Das genaue Verhalten unterscheidet sich zwischen Model-APIs und wechselwirkt mit top_p, top_k und den Standardwerten des Anbieters; testen Sie daher die unterstützten Einstellungen an der Aufgabe, statt einen Bereich zu übernehmen.
Trennung von System- und User-Nachricht hält dauerhafte Richtlinien getrennt von Inhalten pro Request. Chat-Templates und Instruction Tuning geben diesen Rollen unterschiedliche Priorität, machen aber aus einer System-Nachricht keine Durchsetzungsgrenze. Legen Sie stabiles Verhalten in die System-Nachricht, halten Sie nicht vertrauenswürdige Daten in User- oder Tool-Inhalten und setzen Sie harte Vorgaben wie das Entfernen personenbezogener Daten zusätzlich außerhalb des Models durch.
Context Engineering erweitert die Prompt-Arbeit auf die Zusammenstellung von abgerufenen Dokumenten, Tool Results, Konversationsverlauf und Beispielen. Liu et al. fanden in den von ihnen getesteten Long-Context-Models einen Lost-in-the-Middle-Effekt; die Position sollte daher Teil der Evaluation sein und nicht als irrelevant angenommen werden. Den breiteren Workflow habe ich in Context Engineering for AI Agents behandelt.
Teil VIII — Betrieb in Produktion
Der Betrieb in Produktion überführt die früheren Konzepte in Zulassungsgrenzen, Load Tests, Alerts und Kapazitätsentscheidungen unter realem Traffic.
41. Rate Limiting für Requests mit variablen Kosten
Herkömmliches Rate Limiting nach Requests pro Sekunde nimmt ungefähr gleiche Kosten pro Request an. Bei LLMs gilt diese Annahme nicht. Ein Klassifikationsprompt mit 10 Tokens und eine Dokumentanalyse mit 100K Tokens nutzen denselben API-Endpunkt, unterscheiden sich aber in der Input-Länge um den Faktor 10.000. Die Gesamtkosten hängen auch von Output-Länge, Model, Caching und Preisen ab. Rate Limiting nach RPS lässt entweder teure Requests ungeprüft durch oder beschränkt günstige unnötig.
Produktionssysteme brauchen tokenbasiertes Rate Limiting über mehrere Dimensionen. OpenAI dokumentiert Request- und Token-Limits nach Nutzungsstufe. Anthropic trennt Limits für Input-Tokens und Output-Tokens. Genaue Kontingente und Algorithmen können sich ändern, betrachten Sie daher die Dokumentation des Anbieters als maßgebliche Quelle; der architektonische Punkt ist, Requests und Tokens unabhängig voneinander zu budgetieren.
Eine Implementierung auf Anwendungsebene ist eine mehrdimensionale Limit-Hierarchie (Nutzer → Anwendung → Organisation → global), mit Prioritätsstufen für Premium-Zugang. Reservieren Sie auf Request-Ebene Tokens beim Zulassen: Schätzen Sie die Gesamtzahl (Input + max_tokens), ziehen Sie die Schätzung vom Token-Bucket ab und erstatten Sie den ungenutzten Teil nach Abschluss anhand des tatsächlichen Verbrauchs. So erschöpft ein Schub langer Generierungs-Requests die Kapazität nicht, bevor Output entsteht. Ein Request mit 2.000 Input-Tokens und max_tokens = 1.000 reserviert 3.000. Verwendet die Antwort 200 Output-Tokens, beträgt der tatsächliche Verbrauch 2.200, und 800 werden erstattet. Dies ist eine lokale Admission-Policy; Quotenalgorithmen der Anbieter können andere Schätzungen und getrennte Input-/Output-Budgets nutzen. Enthält der Bucket weniger als 3.000, geben Sie 429 zurück oder stellen Sie den Request in die Queue.
Bei selbst gehosteten Deployments ist das Äquivalent provisionierter Throughput: dedizierte GPU-Kapazität für Ziel-Token-Raten zu reservieren. Bei vLLM-Deployments heißt das, die Admission Control um aktive Decode-Slots und KV cache-Druck herum zu konfigurieren und nicht allein um die Anzahl der Requests. Wie Abschnitt 5 erklärt, brauchen Throughput und Zulassung beide tokenbewusste Limits.
42. Fehlerbilder, gegen die Sie entwerfen sollten
LLM-Serving bringt Fehlerbilder mit sich, die an variable Sequenzlänge, KV-Speicher und lang laufende Decode-Arbeit gebunden sind. Entwerfen und testen Sie die Schutzmaßnahmen per Load Test, bevor Produktions-Traffic von ihnen abhängt.
Out-of-Memory (OOM) ist ein häufiger Fehler. Ein 70B-Model in FP16 braucht allein für die Weights etwa 140 GB, und der KV cache für eine einzelne Sequenz von Llama 3.1 70B mit 128K Kontext kann unter den Annahmen in Abschnitt 6 etwa 40 GiB hinzufügen. Der Abstand zwischen „passt in den Speicher“ und „OOM unter Last“ ist kleiner, als er aussieht, weil ein Batch aus Requests mit langem Kontext mehr KV-Speicher verbrauchen kann als erwartet. Zur Vorbeugung gehören eine gemessene Speicherreserve, Quantization und paginierte KV-Allokation. In vLLM legt --gpu-memory-utilization fest, welchen Anteil des GPU-Speichers die Engine für Weights, Activations und KV cache nutzen darf; der Rest ist die Reserve. Für Workloads mit hohem KV-Druck kann LMCache KV-Daten in den CPU-Speicher oder auf Disk auslagern; nutzen Sie die veröffentlichten Ergebnisse als Ausgangspunkt und benchmarken Sie die lokale Speicherhierarchie.
Preemption tritt auf, wenn KV cache-Druck den Scheduler zwingt, Arbeit zu verdrängen oder neu zu berechnen. Die genaue Strategie hängt von Serving-Version und Konfiguration ab. Aus Sicht des Nutzers ist das Symptom eine höhere End-to-End-Latency ohne offensichtlichen Anwendungsfehler. Beobachten Sie die Preemption-Anzahl und korrelieren Sie sie mit KV-Belegung, Queue-Tiefe und Request-Längen.
Tail Latency kann ansteigen, wenn große Prefills Decode-Arbeit verzögern. Chunked Prefill (Abschnitt 7) und längenbewusstes Scheduling zielen auf diese Interferenz. Die Arbeiten zum Learning-to-Rank-Scheduler (Fu et al., 2024) und zu CascadeInfer melden unter ihren evaluierten Workloads Verbesserungen gegenüber ihren Baselines, doch das genaue Ergebnis hängt von der Verteilung der Request-Längen und der Scheduler-Konfiguration ab.
Kaskadierende Ausfälle können beginnen, wenn langsame Requests die Queue wachsen lassen, vorgelagerte Clients in Timeouts laufen und Retries zusätzliche Last erzeugen. Zu den Gegenmaßnahmen gehören Admission Control, Concurrency-Limits pro Mandant, Output-Obergrenzen, Retry-Budgets und Circuit Breaker im Gateway. Disaggregierte Prefill- und Decode-Pools können helfen, wenn Load Tests dauerhafte Interferenz zwischen den Phasen zeigen. Die Abbildung zeigt die Schleife und die Gegenmaßnahme an jeder Kante.
43. Monitoring von LLM-Systemen
Monitoring von LLMs unterscheidet sich vom Monitoring von APIs in drei Punkten: Jeder Request hat andere Kosten, jeder Request hat zwei Phasen mit unterschiedlichen Bottlenecks, und sein Speicherbedarf hängt von der Länge von Eingabe und Ausgabe ab. Request-Latency und Fehlerrate allein zeigen nichts davon.
Goodput ist die Anzahl der Requests pro Sekunde, die alle definierten SLO-Schwellen erfüllen, etwa für TTFT, TPOT und Gesamtlatency. Er ist eine nützliche kombinierte Kennzahl, weil der rohe Throughput gesund aussehen kann, während Latency-SLOs verfehlt werden: Ein System, das 100 Requests pro Sekunde verarbeitet, bei 40 % davon aber die Schwellen verfehlt, hat einen Goodput von 60 Requests pro Sekunde. Die Optimierung auf Goodput hält die Leistungsverteilung sichtbar, statt nur den Mittelwert zu melden.
vLLM stellt einen Prometheus-Endpunkt unter /metrics bereit mit laufenden und wartenden Requests, KV cache-Belegung, Verteilungen der Generierungslängen und Prefix-Cache-Statistiken. Metrik-Namen können sich zwischen Releases ändern; binden Sie Dashboards daher an die ausgerollte Version. Ein typischer Stack nutzt Prometheus für Metriken, Grafana für die Visualisierung und OpenTelemetry-kompatible Traces über Anwendungs- und Serving-Komponenten hinweg.
Nützliche Alert-Muster sind die folgenden. Leiten Sie ihre Schwellenwerte aus Load Tests ab, statt diese Beispiele unverändert zu übernehmen:
- Spitzen bei der Preemption-Anzahl: Die Runtime lagert Arbeit aus oder berechnet sie neu, was Latency ohne Anwendungsfehler erzeugt.
- KV cache-Auslastung nähert sich dem getesteten Preemption-Bereich: Kapazität hinzufügen oder Last verwerfen, bevor Verdrängungen sich kaskadenartig ausbreiten.
- Queue-Tiefe liegt dauerhaft über dem getesteten Batch-Bereich: Die Admission Control sollte beginnen, Requests abzulehnen oder niedriger zu priorisieren.
- TTFT steigt, während TPOT flach bleibt: Diese Divergenz deutet zuerst auf Queueing, Zulassung, Netzwerk oder Prefill-Druck statt auf den Decode-Throughput. Nutzen Sie Traces und Queue-Metriken, um zwischen ihnen zu unterscheiden.
In vLLM entsprechen die ersten drei Alerts vllm:num_preemptions_total, vllm:kv_cache_usage_perc und vllm:num_requests_waiting (vLLM-Metriken).
44. Kostenoptimierung: eine sich verstärkende Strategie
Preise der Anbieter und das Verhältnis von Input- zu Output-Preisen ändern sich. Holen Sie vor einer Kaufentscheidung aktuelle Preise ein; Modelstufe und Output-Länge können die Rechnung schon vor Infrastruktur-Optimierungen dominieren.
OpenAI, Anthropic und Google berechnen für Output-Tokens ihrer Spitzenmodels jeweils ein Mehrfaches des Input-Token-Preises. Unabhängig davon erklärt die Prefill-/Decode-Aufteilung, warum Input und Output unterschiedliche Ausführungskosten haben: Prefill verarbeitet Prompt-Tokens gemeinsam, gewöhnliches Decode generiert Tokens dagegen sequenziell. Dieser Mechanismus allein belegt nicht, wie ein Anbieter seine kommerziellen Preise festlegt. Unnötigen Output zu kürzen (ein knappes max_tokens, Structured Output, keine Wiederholung der Eingabe) spart meist mehr als dieselbe Anzahl von Input-Tokens zu kürzen.
Mehrere Ansätze lassen sich stapeln, aber erst nachdem gemessen wurde, welche für die Workload zutreffen:
- Quantization von FP16 auf INT4 senkt den reinen Speicher für Weight-Werte um 75 %, vor Skalen und anderen Metadaten. Ob das die Rechnung senkt, hängt von Kernel-Geschwindigkeit, Batch-Größe und Hardware-Auslastung ab (Abschnitt 9).
- Model Routing schickt geeigneten Traffic an günstigere Models. Messen Sie die False-Accept-Rate des Routers und die End-to-End-Qualität, bevor Sie den Anteil erhöhen, den das günstigere Model bearbeitet (Abschnitt 36).
- Prompt Caching verringert die Arbeit für wiederholte Präfixe. Rabatte der Anbieter und die Behandlung bei Rate Limits ändern sich mit der Zeit, kombinieren Sie daher die gemessene Hit-Rate mit den aktuellen Konditionen (Abschnitt 16).
- Batch-APIs können Arbeit ohne Echtzeitanforderung rabattieren, etwa Evaluationen, die Generierung synthetischer Daten und Massenklassifikation. Prüfen Sie aktuelle Preise und Fertigstellungsfenster.
- Self-Hosting kann bei dauerhafter Auslastung gewinnen, aber es gibt keinen allgemeingültigen Break-even bei einem Token-Volumen. Rechnen Sie neben der GPU-Miete auch Engineering, Orchestration, Observability, Kapazitätspuffer und Bereitschaftsdienst ein.
Multiplizieren Sie separate Optimierungsgewinne nicht, als würden alle Requests unabhängig profitieren: Quantization verändert den Throughput, Routing den Qualitätsmix, und Caching sowie Batching gelten nur für geeigneten Traffic. Erstellen Sie die Schätzung anhand gemessener Traffic-Anteile und prüfen Sie sie gegen die Rechnung.
45. Capacity Planning und Autoscaling
Capacity Planning für LLM-Serving muss variable Request-Kosten, lang laufende Decode-Arbeit und sequenzabhängigen Speicher berücksichtigen. Je nach Workload kann die begrenzende Ressource KV-Speicher, Speicherbandbreite, Compute oder der Interconnect sein.
Die theoretische Speichergrenze für gleichzeitige Requests ergibt sich aus dem KV cache-Budget:
Für die Kapazitätsrechnung nehmen wir an, die Runtime stelle für Llama 3.1 70B mit einem KV cache in FP16 ein KV-Budget von 40 GiB bereit. Jede 4K-Sequenz belegt etwa 1,25 GiB und jede 128K-Sequenz etwa 40 GiB. Dieses Budget fasst daher höchstens etwa 32 Sequenzen mit 4K oder eine Sequenz mit 128K, vor Overhead durch Allocator, Runtime, Workload-Varianz und SLO. Die Funktion kv_cache_bytes in Abschnitt 6 wiederholt diese Rechnung für ein anderes Model oder Budget. Deshalb bestimmen GPU-Auswahl und KV cache-Optimierung den Kapazitätsplan unmittelbar.
Die Kapazitätsformel für die Dimensionierung der Flotte:
Bringen Sie beide Raten vor der Division auf dieselbe Zeiteinheit. Verwenden Sie den pro GPU beim Ziel-SLO gemessenen Throughput, nicht den Spitzenwert. Ein Multiplikator von 1,3 stellt 30 % mehr Throughput als die erwartete Nachfrage bereit; bei dieser Nachfrage bleiben dadurch etwa 23 % der bereitgestellten Kapazität ungenutzt. Runden Sie auf vollständige Serving-Replikate auf; ein TP-/PP-Replikat benötigt seine gesamte GPU-Gruppe. Raten pro GPU sind nur bei einer festen, gemessenen Replikat-Topologie sinnvoll. Wählen Sie den Multiplikator anhand gemessener Lastspitzen, Ausfälle und Wiederherstellungszeit. Spitzen-Token-Throughput und SLO-konformer Throughput können bei steigender Parallelität stark auseinanderliegen. Benchmarken Sie mit der echten Verteilung von Prompt- und Output-Längen bei den erforderlichen TTFT- und TPOT-Grenzen statt mit einem theoretischen Maximum.
GPU-Auslastung reicht als einziges Autoscaling-Signal nicht aus, weil sie sowohl bei gesunder Verarbeitung als auch bei Überlast hoch bleiben kann. Kombinieren Sie sie mit Queue-Tiefe, KV cache-Auslastung und Goodput-Verschlechterung. Stimmen Sie Schwellenwerte anhand von Load Tests ab; Werte wie 80 % KV-Auslastung sind Ausgangspunkte und keine allgemeinen Grenzen. Diese Metriken werden in Abschnitt 43 eingeführt.
Scale-to-Zero kann zu Entwicklungs- und Staging-Umgebungen mit langen Leerlaufzeiten passen. Serverless-Inference-Plattformen und Kubernetes-basierte Autoscaler wie KEDA können ungenutzte Kapazität entfernen, aber Einsparung und Cold-Start-Zeit hängen von Modelgröße, Caching von Image und Weights und der Infrastruktur ab. Messen Sie die Startzeit, bevor Sie dieselbe Policy für latenzkritischen Produktions-Traffic einsetzen.
Wie die Inference-Konzepte zusammenhängen
Die Teile I bis III verbinden Speicherkapazität mit Serving-Performance. Die KV-Größe pro Sequenz (Abschnitt 6) liefert eine rohe Grenze für residente Sequenzen. Größere Decode-Batches können die Weight-Wiederverwendung und arithmetische Intensität verbessern (Abschnitt 1), aber Attention-Verkehr, Scheduling und Kommunikation beeinflussen ebenfalls TPOT und Throughput. GQA und KV-Speicherung mit geringerer Präzision verringern die Cache-Nutzdaten; PagedAttention reduziert Allokationsverschwendung. Beim genannten Llama-3.1-70B-Layout, einem FP16-KV cache und einem Budget von 40 GiB liegt die rohe Grenze bei 32 Sequenzen mit 4K Tokens oder einer mit 128K, vor Runtime-Overhead und Latency-Bedingungen. Admission Control kann Arbeit vorher einreihen oder ablehnen. Unter KV-Druck kann die Runtime Requests verdrängen; ungeprüfte Allokationen können OOM verursachen (Abschnitt 42).
Routing, Caching, Quantization und Hardware-Wahl verstärken sich nur dann, wenn jedes gegen dasselbe Qualitäts- und Latency-Ziel evaluiert wird. Wählen Sie ein Symptom aus der Tabelle am Anfang, legen Sie diese Baseline fest und machen Sie die nächste Änderung leicht rückgängig.
Weiterführende Lektüre
Verwandte Vertiefungen aus diesem Blog, nach Thema geordnet:
- LLM Fine-Tuning Guide — wann Fine-Tuning, RAG oder Prompt Engineering
- Open-Source LLM Variants and File Formats — Modelvarianten und quantisierte Formate passend zur Hardware wählen
- LoRAX Serving Guide — Tausende LoRA-Adapter in Produktion servieren
- Scaling Large Language Models — Strategien für Multi-GPU und Multi-Node
- Local LLMs on macOS — praktisches Setup mit llama.cpp und Ollama
- AI Agent Reasoning Loops in 2026 — Vertiefung zu ReAct, ReWOO und Planner-Executor-Schleifen
- AI Agent Memory Architecture in 2026 — Checkpoints, Vector Stores und Dokumentgedächtnis für zustandsbehaftete Agents
Referenzen
Nach Themenbereich geordnet.
Inference und Attention
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness - Dao et al., NeurIPS 2022
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning - Dao, 2023
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision - Shah et al., NeurIPS 2024
- Flash-Decoding for long-context inference - Dao et al., 2023
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022
- GQA: Training Generalized Multi-Query Attention - Ainslie et al., 2023
- Triton: an intermediate language and compiler for neural network computations - Tillet et al., MAPL 2019
- FlashNorm: Fast Normalization for LLMs - 2024
- Deep Kernel Fusion for Transformers - DeepFusionKernel, 2026
Speculative Decoding
- Accelerating Large Language Model Decoding with Speculative Sampling - Chen et al., 2023
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models - Li et al., NeurIPS 2025
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - ICML 2024
Quantization
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration - MLSys 2024 Best Paper
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers - Frantar et al., ICLR 2023
- Marlin: Mixed-Precision (FP16xINT4) LLM Inference Kernel - Frantar et al., 2024
Training und Fine-Tuning
- LoRA: Low-Rank Adaptation of Large Language Models - Hu et al., ICLR 2022
- QLoRA: Efficient Finetuning of Quantized LLMs - Dettmers et al., NeurIPS 2023
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models - Rajbhandari et al., SC20
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning - Rajbhandari et al., 2021
- Self-Instruct: Aligning Language Models with Self-Generated Instructions - Wang et al., ACL 2023
- WizardLM: Empowering Large Language Models to Follow Complex Instructions - Xu et al., ICLR 2024
- Phi-4 Technical Report - Microsoft, 2024
- Training Deep Nets with Sublinear Memory Cost - Chen et al., 2016 (Gradient Checkpointing)
- AI models collapse when trained on recursively generated data - Shumailov et al., Nature 2024
Alignment
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model - Rafailov et al., NeurIPS 2023
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models - führte GRPO ein
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning - DeepSeek, 2025
Skalierung und Architektur
- The Llama 3 Herd of Models - Meta, 2024
- LLaMA: Open and Efficient Foundation Language Models - Touvron et al. (Meta), 2023
- Llama 2: Open Foundation and Fine-Tuned Chat Models - Touvron et al. (Meta), 2023
- Qwen3 Technical Report - Qwen Team (Alibaba), 2025
- Training Compute-Optimal Large Language Models - Hoffmann et al. (Chinchilla), NeurIPS 2022
- RoFormer: Enhanced Transformer with Rotary Position Embedding - Su et al., 2021
- YaRN: Efficient Context Window Extension of Large Language Models - Peng et al., ICLR 2024
- SGLang: Efficient Execution of Structured Language Model Programs - Zheng et al., NeurIPS 2024
- Mixtral of Experts - Jiang et al. (Mistral AI), 2024
Embeddings
- Matryoshka Representation Learning - Kusupati et al., NeurIPS 2022
- pplx-embed-v1: Diffusion-Pretrained Dense and Contextual Embeddings - Perplexity AI, 2026
Agent-Architekturen
- ReAct: Synergizing Reasoning and Acting in Language Models - Yao et al., ICLR 2023
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models - Xu et al., 2023
Prompting
- Large Language Models are Zero-Shot Reasoners - Kojima et al., NeurIPS 2022
- Self-Consistency Improves Chain of Thought Reasoning in Language Models - Wang et al., ICLR 2023
Routing
- RouteLLM: Learning to Route LLMs with Preference Data - Ong et al., ICLR 2025
Benchmarks
- MLPerf Inference v5.0 Results - MLCommons, April 2025
Serving-Architekturen
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve - Agrawal et al., OSDI 2024 (Chunked Prefill)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting - Patel et al., ISCA 2024 (disaggregiertes Serving)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving - Zhong et al., OSDI 2024 (disaggregiertes Serving)
Serving-Frameworks
- vLLM - PagedAttention-basierte Serving-Engine
- SGLang - RadixAttention und strukturierte Generierung
- TensorRT-LLM - von NVIDIA optimierte Inference
- llama.cpp - portable C/C++-Inference
- DeepSpeed - verteilte Trainingsbibliothek von Microsoft
- Ollama - Runner für lokale LLMs
Betrieb
- Efficient LLM Scheduling by Learning to Rank - Fu et al., NeurIPS 2024 (vLLM-LTR)
- CascadeInfer: Length-Aware Scheduling of LLM Serving with Low Latency and Load Balancing - Yuan et al., 2025
- Goodput metric as measure of ML productivity - Google Cloud, 2024
- vLLM Optimization and Tuning - vLLM-Dokumentation
- vLLM Metrics - vLLM-Dokumentation
- LMCache: KV Cache Management for LLM Serving - Auslagerung des KV cache
- OpenAI Rate Limits - OpenAI-API-Dokumentation
- Anthropic Rate Limits - Anthropic-API-Dokumentation