Guide d’ingénierie des LLM : 45 concepts pour les systèmes de production

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cette référence s’adresse aux ingénieurs qui connaissent déjà les bases du ML et des systèmes, et qui doivent relier un symptôme de production à la partie concernée de la stack. Elle couvre 45 concepts : hardware, inférence, entraînement, déploiement, applications et opérations. Chaque entrée donne le mécanisme, ce qu’il change dans un système en production, et la condition dans laquelle le résultat cité s’applique. Si vous partez d’un symptôme, comme un premier token lent ou un OOM sous charge, utilisez le tableau des symptômes ci-dessous pour trouver les entrées à lire.
Pour une question précise, utilisez les réponses rapides sur l’ingénierie des LLM. Chaque sujet possède une réponse distincte et un lien vers la section correspondante du guide.
| Partie | Sujets | Sections |
|---|---|---|
| I — Fondamentaux du hardware | Modèle Roofline, mémoire GPU, glossaire du hardware | 1–3 |
| II — Fondamentaux de l’inférence | Latence, débit, KV cache, attention, quantification | 4–9 |
| III — Optimisations de l’inférence | CUDA kernels, FlashAttention, batching, PagedAttention, speculative decoding | 10–17 |
| IV — Architecture des modèles | Fonctionnement interne du Transformer, decoder-only, MoE, tokenisation, fenêtres de contexte | 18–22 |
| V — Entraînement et alignment | Préentraînement, LoRA, précision mixte, ZeRO, lois d’échelle, RLHF/DPO/GRPO, distillation | 23–32 |
| VI — Passage à l’échelle et déploiement | Parallélisme, serving frameworks, choix du GPU, routage | 33–36 |
| VII — Applications | Embeddings, RAG, agents, prompt engineering | 37–40 |
| VIII — Opérations en production | Rate limiting, modes de défaillance, monitoring, coûts, capacity planning | 41–45 |
Partir d’un symptôme
Chaque ligne indique les entrées à lire en premier et ce qu’il faut mesurer avant de modifier la stack.
| Symptôme ou décision | Commencer par | À mesurer avant de modifier la stack |
|---|---|---|
| Le premier token est lent | Prefill et decode, TTFT | Temps d’attente en file, longueur du prompt, temps de prefill et TTFT P99 |
| Les tokens sont générés lentement | Roofline, TPOT | TPOT selon la concurrence, bande passante mémoire et forme du batch |
| Les longs contextes déclenchent préemption ou OOM | KV cache, PagedAttention | Usage du KV, longueurs des requêtes, perte d’allocation et nombre de préemptions |
| Un modèle ne tient pas dans le budget | Quantification, choix du GPU | Qualité, débit des kernels, réserve mémoire et goodput au SLO cible |
| Choisir un serving runtime | Serving frameworks, Parallélisme | Débit et latence P99 au SLO cible, sur vos propres prompts |
| Les requêtes expirent sous charge | Modes de défaillance, Rate limiting | Profondeur de la file, préemptions, taux de retry et longueurs de sortie |
| Un entraînement ne tient pas en mémoire | LoRA et QLoRA, ZeRO, FSDP | Mémoire d’état du modèle, communication, débit et qualité sur données de validation |
| Les coûts augmentent | Routage, optimisation des coûts | Part du trafic éligible, erreurs de qualité, taux de cache hit et données de facturation |
Guides détaillés par décision
| Si vous décidez… | Commencer par | Lire ensuite |
|---|---|---|
| Comment servir de nombreux adapters fine-tunés | Fondamentaux de l’inférence et déploiement | Guide LoRAX Serving |
| S’il faut quantifier | Quantification | Guide de la quantification des modèles |
| Comment répartir un modèle sur plusieurs GPU | Parallélisme | Mettre à l’échelle les grands modèles de langage |
| S’il faut faire du fine-tuning | Entraînement et alignment | Guide du fine-tuning des LLM |
| Comment intégrer la recherche documentaire dans une application | Embeddings et RAG | Métriques d’évaluation du RAG |
| Comment fonctionnent les systèmes d’agents | Agents et prompt engineering | Boucles de raisonnement des AI agents |
| Comment classer les résultats de recherche | Embeddings et reranking | Stack de classement de recherche |
Partie I — Fondamentaux du hardware
L’intensité arithmétique, la hiérarchie mémoire du GPU et les termes de hardware de cette partie expliquent bon nombre des choix faits plus loin dans le guide.
1. Limitation par la mémoire ou par le calcul : le modèle Roofline
Le point de départ de la performance des LLM est l’intensité arithmétique : pour chaque octet de données que le GPU charge depuis la mémoire, combien de calculs utiles effectue-t-il ? Ce rapport détermine si une opération est limitée par le calcul (elle attend le processeur) ou limitée par la mémoire (elle attend le chargement des données).
Chaque GPU a une intensité « critique », seuil où son débit de calcul maximal égale sa bande passante mémoire. Pour un NVIDIA H100 SXM utilisant les Tensor Cores denses en BF16 ou FP16 (989 TFLOPS ; la spécification à 1 979 TFLOPS suppose une sparsité structurée) :
Le graphique roofline ci-dessous trace le calcul atteignable en fonction de l’intensité arithmétique. La droite inclinée correspond à la zone limitée par la mémoire, où la bande passante fixe la limite ; la droite horizontale est le débit de calcul maximal ; leur intersection est le seuil de 295 FLOPs/byte.
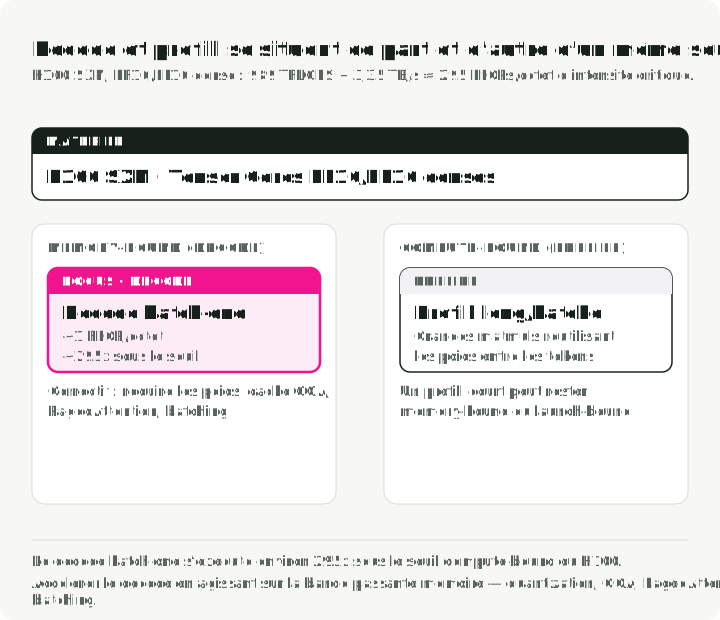
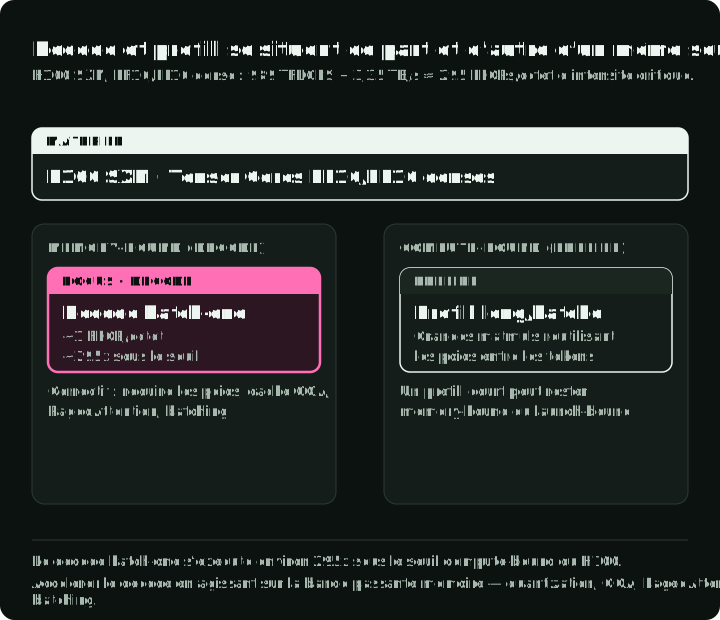
Le decode à batch 1 et un prefill long ou suffisamment batché se trouvent couramment de part et d’autre de ce seuil :
- Le decode est limité par la mémoire. Générer les tokens un par un oblige à charger depuis la mémoire une matrice de poids de plusieurs gigaoctets pour la multiplier par un seul nouveau token. Dans une analyse simplifiée, dense, en 16 bits et à batch 1, l’opération représente environ 1 FLOP/octet, soit près de 295 fois moins que le seuil roofline du H100. Cet écart explique pourquoi le decode ne peut pas approcher le débit de calcul maximal dans ce régime.
- Un prefill long ou suffisamment batché est souvent limité par le calcul. Traiter de nombreux tokens de prompt réutilise les poids dans de grandes multiplications de matrices, ce qui peut porter l’intensité arithmétique au-dessus du seuil roofline. Des prompts courts et de petits batchs peuvent au contraire être limités par le trafic mémoire ou par le coût de lancement des kernels.
Pour accélérer le decode, il faut donc agir sur la bande passante mémoire : réduire les poids avec la quantification, réduire l’empreinte mémoire du KV avec GQA et PagedAttention, et augmenter l’intensité avec le batching. Pour les prefills longs ou bien batchés, un calcul matriciel plus rapide et un calcul en précision plus basse peuvent aider ; profilez séparément les workloads à prefill court.
2. Hiérarchie mémoire du GPU
Un GPU a quatre niveaux de mémoire avec des capacités et des vitesses d’accès différentes. Les registres sont petits et rapides ; la HBM contient beaucoup plus de données, mais leur accès prend plus de temps. Le déplacement des données entre ces niveaux est une contrainte majeure de performance. La figure montre un H100 SXM : registres et mémoire partagée dans chaque SM, L2 sur la puce, et 80 Go de HBM3 en empilements à côté.
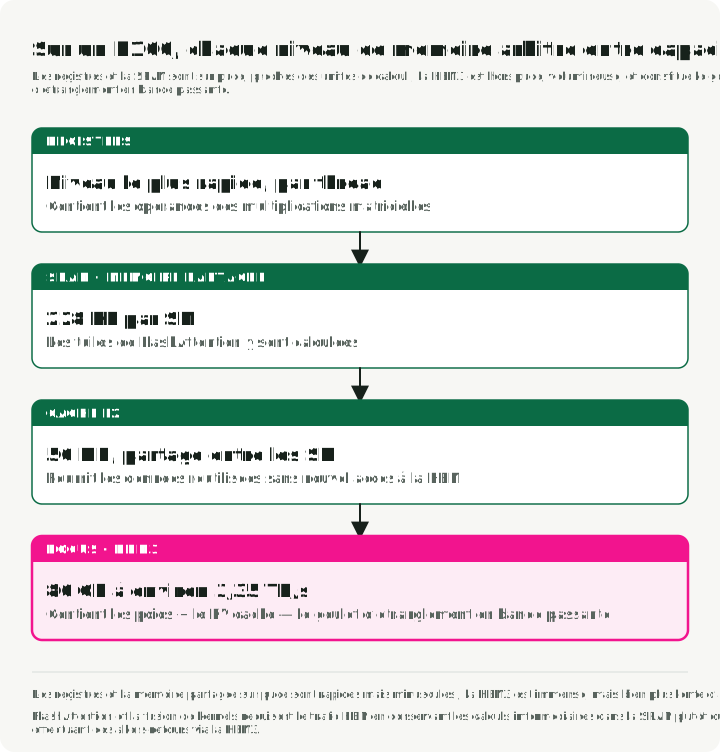
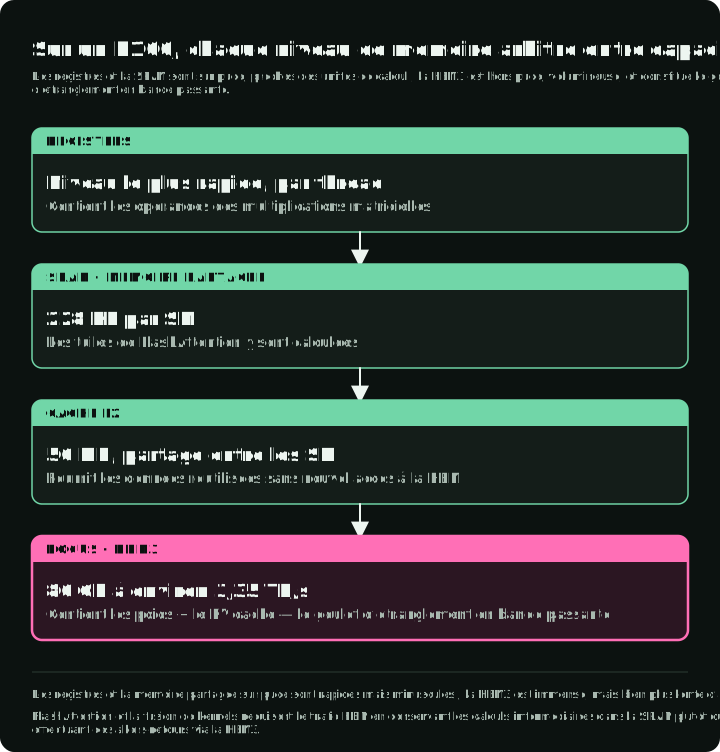
Du plus rapide au plus lent sur un H100 SXM :
- Les registres sont la mémoire la plus rapide et sont rattachés directement aux threads de calcul. Pour le WGMMA de Hopper, la matrice A peut provenir des registres ou de la mémoire partagée, tandis que la matrice B provient de la mémoire partagée.
- La SRAM (mémoire partagée) est une mémoire de travail rapide, sur puce, locale à chaque SM.
- Le cache L2 est une couche partagée de 50 Mo. Il peut servir des données réutilisées entre SM sans nouvel accès à la HBM.
- La HBM3 est la mémoire principale de 80 Go qui contient les poids du modèle et le KV cache, avec une bande passante d’environ 3,35 To/s.
L’écart entre les niveaux sur puce et hors puce est important. Sur un A100, l’article FlashAttention estime la bande passante de la SRAM sur puce à environ 19 To/s, contre 1,5 à 2,0 To/s pour la HBM (Dao et al., 2022), soit un facteur d’environ 10. FlashAttention et la fusion de kernels réduisent le trafic HBM en gardant ou en combinant sur puce les résultats intermédiaires. PagedAttention vise un autre problème : il associe des blocs logiques de KV à des blocs physiques non contigus de la mémoire GPU, ce qui réduit la fragmentation et permet de partager des blocs.
3. Glossaire du hardware GPU
Les termes ci-dessous reviennent dans le reste du guide.
HBM (High Bandwidth Memory) empile des puces DRAM reliées par des through-silicon vias (TSV) à côté de la puce GPU. Parmi les générations : HBM2e (A100, 2 To/s), HBM3 (H100, 3,35 To/s) et HBM3e (H200/B200, 4,8 à 8 To/s). La bande passante de la HBM contraint directement le TPOT dans les régimes de decode limités par la mémoire.
GDDR (Graphics DDR) est la mémoire graphique traditionnelle des GPU grand public et des stations de travail, comme la RTX 4090 et la L40S. Ces cartes ont une bande passante mémoire inférieure à celle du H100 SXM. La GDDR6X de la RTX 4090 délivre 1 008 Go/s selon le livre blanc de NVIDIA sur l’architecture Ada, contre 3,35 To/s de HBM3 pour le H100 SXM.
Un SM (Streaming Multiprocessor) est le bloc de calcul de base d’un GPU NVIDIA. Chaque SM contient des CUDA cores, des Tensor Cores, de la mémoire partagée et un warp scheduler. Le H100 SXM compte 132 SM ; le H100 PCIe en compte 114 ; l’A100 en compte 108.
Les Tensor Cores sont des unités spécialisées de multiplication-accumulation de matrices, présentes dans chaque SM. Ils accélèrent les multiplications matricielles en précision mixte qui dominent le calcul des transformers. Les Tensor Cores du H100 SXM délivrent 494,5 TFLOPS TF32 en dense ou 989 en sparse ; indiquez toujours la précision et le mode de sparsité quand vous comparez ce chiffre.
Les CUDA Cores sont des unités généralistes de calcul en virgule flottante et en entiers. Ils gèrent les opérations élément par élément, les fonctions d’activation et les autres calculs non matriciels, pendant que les Tensor Cores exécutent les opérations matricielles prises en charge.
Un warp est un groupe de 32 threads sur un SM. Les threads peuvent diverger, et les GPU Volta et suivants prennent en charge l’ordonnancement indépendant des threads. La warp specialization affecte des warps différents au déplacement des données et au calcul, pour que les deux tâches se recouvrent.
NVLink est l’interconnexion GPU à GPU à haut débit de NVIDIA au sein d’un nœud. NVLink 4.0 sur le H100 offre 900 Go/s de bande passante bidirectionnelle ; NVLink 5.0 sur le B200 atteint 1,8 To/s. Cette bande passante compte pour le parallélisme tensoriel, car les GPU échangent des résultats partiels à chaque couche du transformer.
InfiniBand est un réseau à haut débit pour la communication entre nœuds. Les adaptateurs InfiniBand de classe ConnectX fournissent le réseau entre nœuds pour le trafic du parallélisme en pipeline ou de l’entraînement distribué ; la bande passante dépend de l’adaptateur et de la configuration des ports.
RDMA (Remote Direct Memory Access) permet à un périphérique d’accéder à la mémoire d’une autre machine sans faire passer le chemin des données par l’un ou l’autre des CPU. GPUDirect RDMA prend en charge les transferts directs de GPU à GPU entre nœuds, y compris les transferts de KV cache dans le serving désagrégé.
NVMe (Non-Volatile Memory Express) est l’interface SSD utilisée pour le déchargement du KV cache et pour le déchargement des paramètres de ZeRO-Infinity lorsque la mémoire GPU et CPU ne suffit pas. La bande passante séquentielle dépend du disque et du workload, et reste très inférieure à celle de la HBM.
TFLOPS et PFLOPS désignent des milliers de milliards (10¹²) et des millions de milliards (10¹⁵) d’opérations en virgule flottante par seconde. Un TFLOPS vaut FLOPS. Le H100 atteint 989 TFLOPS tensoriels TF32 en sparse, tandis que FlashAttention-3 annonce environ 1,2 PFLOPS en FP8 ; ces valeurs portent sur des formats différents et ne doivent pas être comparées comme s’il s’agissait d’une seule métrique.
Partie II — Fondamentaux de l’inférence
L’inférence transforme un modèle en un service visible par l’utilisateur. Les concepts suivants distinguent le travail qui retarde le premier token de celui qui ralentit chaque token suivant, et mettent en évidence les limites de mémoire derrière les deux.
4. Latence : TTFT, TPOT et percentiles
Le Time to First Token (TTFT) est le délai de bout en bout entre l’envoi de la requête et le premier token de sortie. Il comprend la mise en file d’attente, la tokenisation, l’ordonnancement, la passe de prefill qui produit le premier token et la livraison réseau. Les moteurs de serving courants échantillonnent le premier token de sortie à partir des logits de la passe avant du prefill ; aucune étape de decode distincte ne s’exécute donc avant lui. Des prompts plus longs augmentent généralement la part du prefill, mais n’importe laquelle de ces étapes peut dominer. Les cibles dépendent du produit ; MLPerf Inference v5.0 utilise une limite de TTFT P99 de 450 ms pour son scénario interactif Llama 2 70B.
Le Time Per Output Token (TPOT) est l’intervalle moyen entre deux tokens consécutifs après le premier. Il correspond à la phase de decode. Le decode à batch 1 ou à faible intensité est généralement limité par la bande passante mémoire, alors que des batchs suffisamment grands peuvent devenir limités par le calcul :
Cette définition exige au moins deux tokens de sortie ; le TPOT n’est pas défini pour une réponse d’un seul token. Pour cette équation, la latence E2E se termine au dernier token de sortie. Un chronomètre de fin de requête HTTP peut aussi inclure les métadonnées ultérieures ou la fermeture de la connexion ; mesurez cela séparément.
Une estimation de la vitesse de lecture en anglais donne un repère approximatif pour le streaming. La vitesse moyenne de lecture silencieuse d’un adulte en anglais est d’environ 238 mots par minute pour les textes non fictionnels (Brysbaert, 2019), soit environ 4 mots par seconde. Si un token représente en moyenne trois quarts d’un mot, cela donne environ 5 tokens par seconde, soit 200 ms par token. Cette estimation n’est pas un seuil d’utilisabilité : la langue, le tokenizer, la tâche et la mise en tampon côté client changent le résultat. Le scénario interactif de MLPerf utilise une limite de TPOT P99 beaucoup plus stricte, 40 ms. Fixez votre propre cible à partir de tests produit.
Latence P50 et P99 : la différence compte parce que la médiane masque la queue de distribution. Un système avec un bon P50 et un mauvais P99 peut avoir des problèmes de batching, de préemption, de file d’attente ou de répartition inégale du workload ; il faut des traces pour les distinguer.
5. Débit : tokens par seconde et compromis avec la latence
Le débit se mesure en tokens de sortie par seconde sur l’ensemble des requêtes concurrentes. Les requêtes par seconde sont un indicateur plus faible à elles seules, car une réponse de 10 tokens et une réponse de 1 000 tokens ont des coûts très différents. Les chiffres de benchmark publiés varient selon le modèle, la précision, le hardware, les longueurs de prompt et de sortie, la concurrence et le SLO. Comparez vLLM, SGLang et TensorRT-LLM avec un seul harness, plutôt que de combiner leurs résultats annoncés.
Agrandir un petit batch de decode peut augmenter le débit en partageant les lectures des poids. Des batchs plus grands ou une charge entrante plus élevée finissent par augmenter la latence ou atteindre les limites de mémoire, de calcul ou de communication. Mesurez cette courbe plutôt que de supposer une croissance linéaire. Le goodput, c’est-à-dire le nombre de requêtes par seconde qui respectent vos cibles de SLO, relie le débit brut à ce que les utilisateurs vivent réellement.
6. KV cache : la mémoire qui croît à chaque token
Pendant la génération autorégressive avec attention complète, chaque nouveau token porte son attention sur le token courant et les précédents. Le KV cache stocke les projections Key et Value pour éviter de recalculer celles des tokens précédents à chaque étape. Le decode avec attention complète lit toujours un historique croissant ; le travail total d’attention sur une séquence générée reste quadratique en sa longueur.
Pour un cache MHA ou GQA classique avec attention complète, la mémoire croît linéairement avec la longueur de séquence, la taille du batch et le nombre de couches. La formule suivante ne s’applique pas telle quelle aux architectures MLA, à fenêtre glissante, récurrentes ou hybrides :
où :
- = nombre de couches
- = nombre de têtes KV
- = dimension d’une tête
- = longueur de séquence
- = taille du batch
- = octets par élément mis en cache, fixés par la précision du KV cache
Exemples concrets en FP16 avec un batch de taille 1 : Llama 3.1 8B à 8 192 tokens utilise environ 1,07 Go (1 GiB) de KV cache ; à 128K tokens, 16 GiB. Llama 3.1 70B à 128K tokens exige 40 GiB (environ 43 Go) pour une seule séquence, soit environ la moitié des 80 Go d’un H100. À forte concurrence ou en contexte long, le KV cache peut dépasser la mémoire des poids du modèle ; le résultat dépend de la longueur de séquence, de la taille du batch actif, de la précision du KV et du nombre de têtes KV. L’évaluation originale de vLLM en 2023 a rapporté 60 à 80 % de perte due à la fragmentation et à la préallocation dans les systèmes comparés.
Les principales optimisations sont GQA (moins de têtes KV), la quantification du KV cache (FP8/INT8), PagedAttention (allocation par blocs) et le déchargement des données KV réutilisables vers le CPU ou le NVMe. Leurs bénéfices dépendent de la charge et de l’implémentation.
Pour répondre à « combien de séquences tiennent dans mon budget KV ? » pour un autre modèle, lisez trois valeurs dans son config.json : num_hidden_layers, num_key_value_heads et head_dim si ce champ existe. Pour les exemples Llama, la dimension de tête est hidden_size / num_attention_heads. La mémoire par appareil dépend aussi du partitionnement du cache et d’une éventuelle réplication des têtes KV. La fonction ci-dessous applique la formule ; les assertions reproduisent les chiffres ci-dessus et l’exemple de capacité de la Section 45.
def kv_cache_bytes(layers, kv_heads, head_dim, seq_len, batch=1, bytes_per_elem=2):
    """Bytes of KV cache: a key and a value per layer, KV head, and token."""
    return 2 * layers * kv_heads * head_dim * seq_len * batch * bytes_per_elem

GiB = 2**30

# Llama 3.1 8B: 32 layers, 8 KV heads, head dimension 128, FP16 cache.
llama_8b = kv_cache_bytes(32, 8, 128, seq_len=8_192)
print(f"8B at 8K tokens: {llama_8b / 1e9:.2f} GB")  # 1.07 GB
assert llama_8b == 1 * GiB

# Llama 3.1 70B: 80 layers, 8 KV heads, head dimension 128.
assert kv_cache_bytes(80, 8, 128, seq_len=131_072) == 40 * GiB

# How many 4K-token sequences fit in a 40 GiB KV budget?
per_4k = kv_cache_bytes(80, 8, 128, seq_len=4_096)
print(f"70B at 4K tokens: {per_4k / GiB:.2f} GiB per sequence")  # 1.25 GiB
print("4K sequences in 40 GiB:", 40 * GiB // per_4k)  # 32
assert 40 * GiB // per_4k == 32

# An FP8 KV cache halves the size per sequence and doubles the count.
assert 40 * GiB // kv_cache_bytes(80, 8, 128, 4_096, bytes_per_elem=1) == 64
Le résultat est une borne supérieure. Le runtime a aussi besoin de mémoire pour les activations, pour l’overhead de l’allocateur et pour une marge face à la variance des longueurs de requêtes.
7. Prefill et decode : deux phases, deux bottlenecks
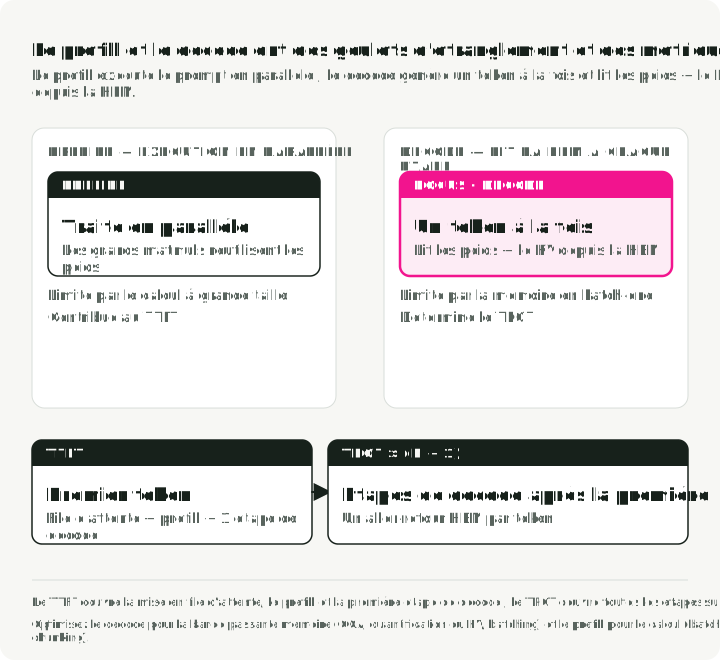
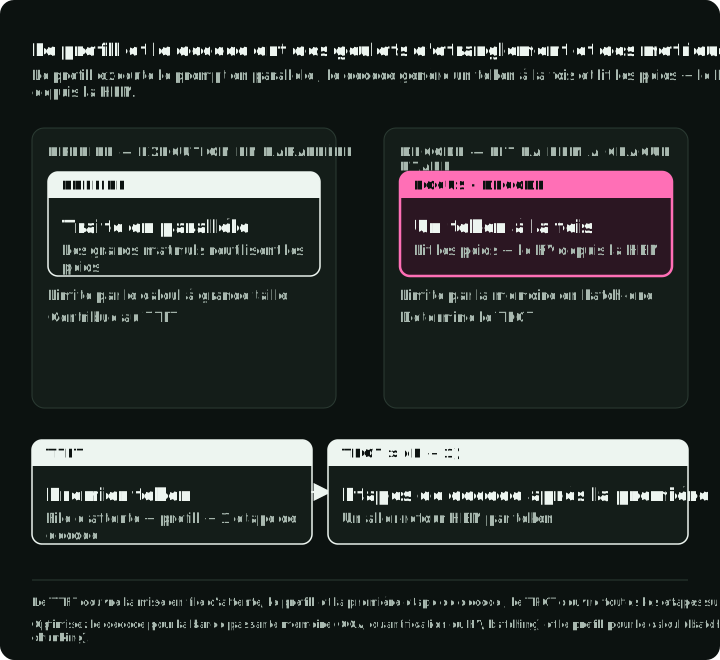
La phase de prefill traite le prompt d’entrée en parallèle et remplit le KV cache. Les prefills longs ou suffisamment batchés deviennent souvent limités par le calcul, car ils utilisent de grandes multiplications de matrices ; les prefills courts peuvent rester limités par le trafic mémoire ou par le coût de lancement des kernels. Le prefill contribue au time to first token (TTFT), avec la mise en file d’attente, la tokenisation, l’ordonnancement et la livraison réseau ; sa passe avant produit aussi le premier token de sortie. La phase de decode génère un token à la fois. Chaque étape lit les poids du modèle et le KV cache depuis la HBM, ce qui rend le decode à batch 1 limité par la bande passante mémoire et en fait le principal déterminant du time per output token (TPOT).
La figure suit une requête : le prefill réutilise les poids entre les tokens du prompt et se termine par le premier token, compris dans le TTFT ; chaque étape de décodage suivante relit les poids et le KV cache pour un token et contribue au TPOT.
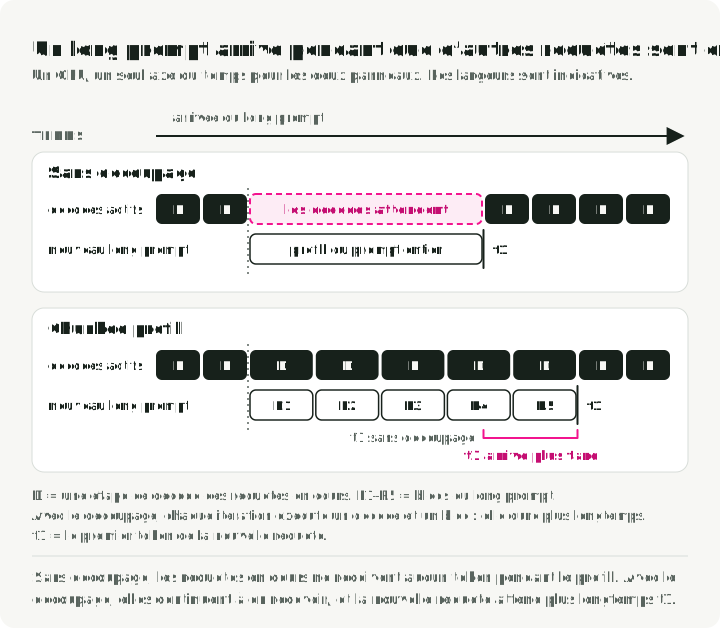
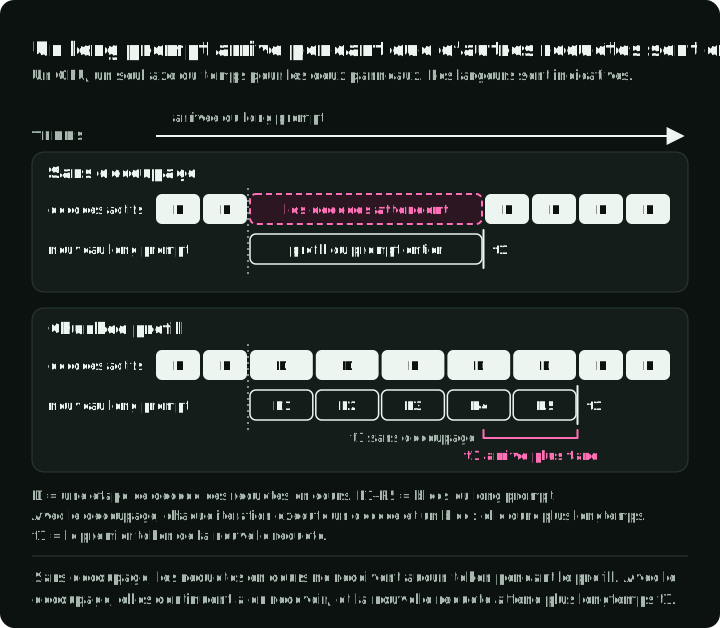
Le chunked prefill découpe un long prompt en blocs et les planifie avec les decodes en cours. La taille réelle des blocs peut varier selon le budget de tokens disponible pour l’itération. Dans Sarathi-Serve (section 4.2) et dans vLLM, le scheduler place d’abord les decodes en cours dans le batch, puis remplit le reste d’un budget de tokens par itération avec des tokens de prefill. Un long prompt n’empêche donc plus les autres requêtes de recevoir des tokens. La nouvelle requête en paie le prix : son prefill s’étale sur plusieurs itérations, et chaque bloc relit le KV cache des blocs précédents. Sarathi-Serve a mesuré environ 25 % de temps de prefill supplémentaire pour Yi-34B avec un parallélisme tensoriel de deux et des blocs de 512 tokens (section 5.4.1), et la documentation de vLLM indique qu’un budget de tokens plus petit donne une meilleure latence inter-token et un moins bon TTFT. Sarathi-Serve annonce de meilleurs compromis débit-latence sur les workloads testés, mais le gain dépend du modèle, du hardware, de la distribution des longueurs de requêtes, de la taille des blocs et de la référence de comparaison.
Le serving désagrégé place le prefill et le decode sur des pools de GPU distincts, ce qui permet à chaque pool de cibler un bottleneck différent. Splitwise et DistServe décrivent ce schéma. Le pool de prefill envoie le KV cache de chaque requête au pool de decode. DistServe utilise NVLink à l’intérieur d’un nœud et InfiniBand entre nœuds ; Splitwise utilise InfiniBand, qui prend en charge le RDMA. Le coût du transfert fait partie de la conception.
La figure place les deux ordonnancements sur le même axe du temps : un long prompt arrive pendant que d’autres requêtes sont en decode. Le découpage garde les tokens des autres requêtes en flux et repousse le premier token de la nouvelle requête.
8. GQA et MQA : réduire la taille du KV cache
Le Multi-Head Attention (MHA) standard donne à chaque tête de requête ses propres têtes K et V. Le Multi-Query Attention (MQA) partage une seule tête KV entre toutes les têtes de requête, ce qui est une réduction extrême. Le Grouped-Query Attention (GQA) est le compromis pratique : des groupes de têtes de requête partagent une tête KV. La figure dessine huit têtes de requête et les têtes KV que garde chaque variante ; le KV cache diminue proportionnellement au nombre de têtes KV.
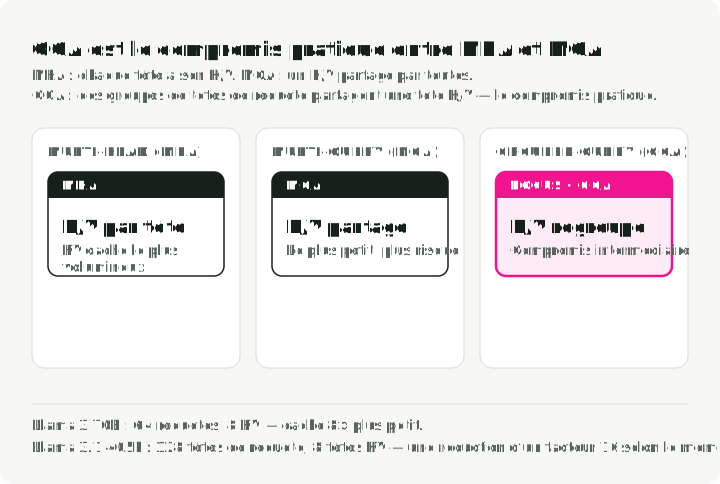
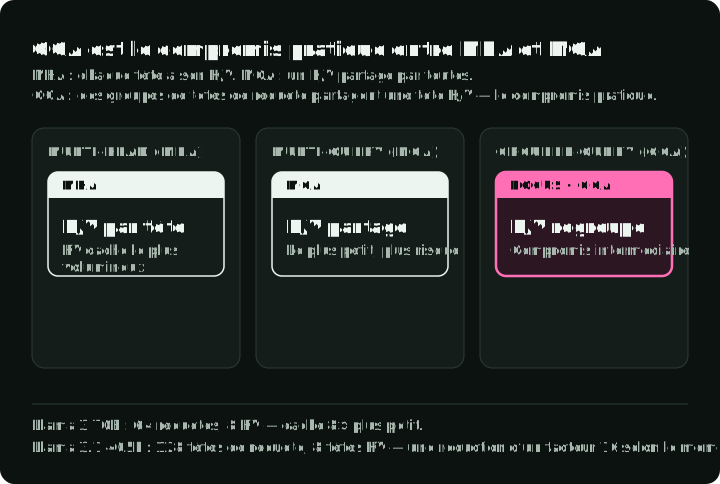
Llama 3 70B utilise 64 têtes de requête mais seulement 8 têtes KV, soit une réduction du KV cache d’un facteur 8 par rapport à la même architecture avec une tête KV par tête de requête. Llama 3.1 405B utilise 128 têtes de requête et 8 têtes KV, soit une réduction d’un facteur 16 selon le même calcul (Meta, 2024). Ainslie et al. rapportent une qualité du GQA proche de celle du MHA sur leurs modèles testés, avec une vitesse proche de celle du MQA. Un KV cache plus petit permet des batchs plus grands, mais le gain réel de latence et de débit dépend encore du kernel et du workload.
9. Quantification : échanger des bits contre de la vitesse et de la mémoire
La quantification réduit la précision des poids et/ou des activations du modèle. Les principaux compromis :
| Format | Bits | Mémoire des poids (modèle 7B) | Remarque sur la qualité |
|---|---|---|---|
| FP16/BF16 | 16 | ~14 Go | Référence de comparaison |
| FP8 | 8 | ~7 Go | Natif sur Hopper ; évaluer le modèle |
| INT8 | 8 | ~7 Go | Dépend de la calibration et du kernel |
| INT4 | 4 | ~3,5 Go | Compression plus forte ; évaluer avec soin |
AWQ (Activation-Aware Weight Quantization) identifie les canaux de poids saillants à partir de l’amplitude des activations et applique une mise à l’échelle par canal pour les protéger. Ses besoins de calibration dépendent du modèle et de la configuration ; dans une comparaison OPT-6.7B en INT3-g128, AWQ a utilisé 16 séquences de calibration contre 192 pour GPTQ. Indiquez à la fois le nombre et la longueur des séquences dans une configuration reproductible. GPTQ utilise une information approximative du second ordre pour quantifier couche par couche. bitsandbytes peut quantifier pendant le chargement du modèle, sans passe de prétraitement séparée ; son format NF4 alimente le fine-tuning QLoRA. Le FP8 sur du hardware de classe Hopper divise par deux la mémoire des poids par rapport au FP16/BF16, mais la qualité et la vitesse dépendent encore du modèle, de la calibration et du kernel.
Le tableau associe chaque méthode à la tâche à laquelle elle convient en général. Le guide de la quantification des modèles détaille chaque méthode.
| Méthode | Données de calibration | Usage typique |
|---|---|---|
| AWQ ou GPTQ (INT4, poids seuls) | Oui, un petit échantillon | Servir un grand modèle sur des GPU à mémoire limitée via un kernel INT4 pris en charge |
| bitsandbytes NF4 | Non | Fine-tuning QLoRA et expériences rapides |
| FP8 | Petit échantillon ou scaling dynamique | Servir sur des GPU Hopper ou plus récents, avec un contrôle de qualité sur la tâche cible |
| INT8 (W8A8) | Oui, pour les échelles d’activation | GPU sans FP8, comme A100 ou A10G, lorsque le kernel de serving le prend en charge |
Le kernel de serving peut compter autant que l’algorithme de quantification. La Section 10 donne un résultat borné pour Marlin et explique pourquoi le gain dépend de la configuration de serving.
Partie III — Optimisations de l’inférence
Les optimisations de cette partie répondent à des contraintes différentes. FlashAttention réduit le trafic HBM de l’attention ; PagedAttention améliore l’allocation du KV ; le continuous batching empêche les séquences terminées de monopoliser la capacité du batch.
10. CUDA kernels et fusion de kernels
Un CUDA kernel est une fonction écrite pour le GPU, qui s’exécute en parallèle sur des milliers de threads. Quand le CPU appelle un kernel, le GPU répartit le travail entre ses SM : chaque SM exécute plusieurs warps de 32 threads, et chaque thread traite une tranche des données. Une implémentation de serving CUDA exécute le travail GPU via des kernels. Le nombre de lancements dépend du graphe du modèle, du compilateur, du runtime et de la fusion. L’implémentation des kernels peut déterminer si le système respecte son SLO de latence.
Les principales catégories de kernels dans le serving des LLM :
- Les kernels GEMM pour la multiplication matricielle, qui dominent le calcul du prefill comme du decode.
- Les kernels d’attention comme FlashAttention, qui découpent les calculs en tuiles pour rester en SRAM au lieu de déborder vers la HBM.
- Les kernels fusionnés, qui combinent plusieurs opérations (comme add + layer norm ou la projection QKV) en un seul lancement pour éviter les allers-retours intermédiaires vers la HBM.
- Les kernels d’échantillonnage, qui convertissent les logits en identifiants de tokens par échantillonnage top-k, top-p ou par température.
La qualité des kernels peut déterminer si des poids compressés apportent une accélération. L’article Marlin annonce jusqu’à 2,8 fois d’accélération de bout en bout par rapport à sa référence FP16 pour des configurations vLLM testées en INT4 sur les poids seuls. Ce résultat est propre aux modèles, aux GPU, aux tailles de batch et à la configuration de serving de l’article ; ce n’est donc pas un gain universel de l’INT4.
Triton abaisse la barrière pour écrire des kernels personnalisés en exposant la programmation GPU via Python plutôt que via du CUDA C++ brut, ce qui met l’optimisation au niveau des kernels à la portée des ingénieurs ML et pas seulement des spécialistes GPU. La plupart des optimisations de la suite de cette partie (FlashAttention, kernels fusionnés, PagedAttention) sont soit de meilleurs kernels, soit des façons plus malignes d’orchestrer les lancements de kernels.
La fusion de kernels combine des opérations séquentielles en un seul kernel GPU et évite les écritures intermédiaires en HBM. Les fusions courantes incluent la projection QKV, l’attention plus softmax, et l’addition résiduelle plus RMSNorm. FlashNorm combine plutôt la mise à l’échelle RMSNorm avec la projection linéaire suivante et reporte la normalisation. DeepFusionKernel fusionne un MLP SwiGLU complet, y compris ses multiplications matricielles. Les gains exacts en nombre de lancements et en utilisation dépendent du graphe du modèle, du compilateur, du GPU et du serving framework ; profilez donc la stack déployée plutôt que de vous fier à un pourcentage universel.
11. FlashAttention : tuiler l’attention pour rester en SRAM
L’attention standard matérialise toute la matrice d’attention en HBM, ce qui coûte de mémoire et génère beaucoup de trafic mémoire. L’idée de FlashAttention est de ne jamais matérialiser cette matrice. Il découpe les matrices Q, K, V en blocs qui tiennent en SRAM, calcule l’attention partielle dans chaque tuile, puis fusionne les résultats avec un softmax en ligne (en suivant de façon incrémentale le maximum et la somme courants d’un bloc à l’autre). Le stockage intermédiaire passe de à , avec moins de lectures et d’écritures HBM pour les formes testées dans l’article. Le calcul de l’attention dense reste quadratique en la longueur de séquence.
Chaque version cible le bottleneck de sa génération de GPU :
- FlashAttention v1 (A100, 2022) a prouvé que l’idée du tuilage avec softmax en ligne fonctionne. L’article annonçait une accélération de 2 à 4 fois par rapport à l’attention standard, mais seulement 25 à 40 % d’utilisation du GPU. L’article FA2 attribue ce résultat au travail hors matmul, à la communication en mémoire partagée et au parallélisme limité.
- FlashAttention v2 (A100, 2023) a retravaillé le parallélisme pour répartir le travail selon la dimension de séquence en plus du batch et des têtes. Il a atteint 50 à 73 % d’utilisation sur A100, soit environ 2 fois plus vite que la v1.
- FlashAttention v3 (H100 Hopper, 2024) a ajouté la warp specialization (des warps distincts pour le déplacement des données et pour le calcul) et un pipeline GEMM-softmax pour recouvrir les chargements mémoire par le calcul. L’article annonce jusqu’à 740 TFLOPS en FP16 (75 % d’utilisation) et près de 1,2 PFLOPS en FP8 sur H100.
- FlashAttention v4 (B200 Blackwell, 2026) traite un nouveau bottleneck : sur Blackwell, le débit des Tensor Cores augmente si vite que les opérations hors matmul (exponentielles du softmax, remise à l’échelle) deviennent le facteur limitant. FA4 émule l’exponentielle par logiciel avec des approximations polynomiales sur les unités FMA, utilise une remise à l’échelle conditionnelle pour réduire l’overhead, et stocke les valeurs intermédiaires dans la mémoire tensorielle dédiée de Blackwell (TMEM) plutôt que dans les registres. L’article annonce environ 1,6 PFLOPS sur B200 en BF16, soit 1,3 fois plus vite que cuDNN 9.13 et 2,7 fois plus vite que Triton dans ses tests.
12. FlashDecoding : paralléliser le bottleneck du decode
FlashAttention standard garde le GPU occupé en répartissant le travail selon la taille du batch et la longueur de la query d’attention. Pendant le decode, le modèle génère exactement 1 token à la fois (longueur de query = 1). Si la taille du batch multipliée par le nombre de têtes d’attention est bien inférieure au nombre de SM du GPU (108 sur un A100), de nombreux SM peuvent rester inactifs pendant que les autres traitent l’historique des tokens.
FlashDecoding résout ce problème en ajoutant une nouvelle dimension de parallélisation : la longueur de séquence KV elle-même. Il découpe le KV cache en blocs plus petits et les répartit sur tous les processeurs GPU autrement inactifs pour les évaluer en parallèle, puis fusionne leurs calculs partiels par une réduction log-sum-exp.
Dans le benchmark CodeLlama-34B à batch 1 de Stanford, sur quatre GPU A100 avec des longueurs de séquence de 512 à 64K tokens, FlashDecoding a atteint jusqu’à 8 fois d’accélération de bout en bout par rapport aux références testées et a amélioré la croissance du coût de l’attention sur les contextes longs testés. Le résultat est limité à ce hardware et à ce benchmark ; ce n’est pas une garantie générale pour le decode.
13. Continuous batching contre static batching
Le static batching attend que toutes les séquences d’un batch soient terminées avant de démarrer le suivant ; les séquences courtes gaspillent donc des cycles GPU en restant inactives après leur token de fin de séquence. Le continuous batching (introduit par l’article Orca, OSDI 2022) opère à la granularité de l’itération : à chaque étape de decode, les séquences terminées sont retirées et de nouvelles sont insérées. La figure montre quatre slots de batch sur dix étapes de decode sous chaque politique.
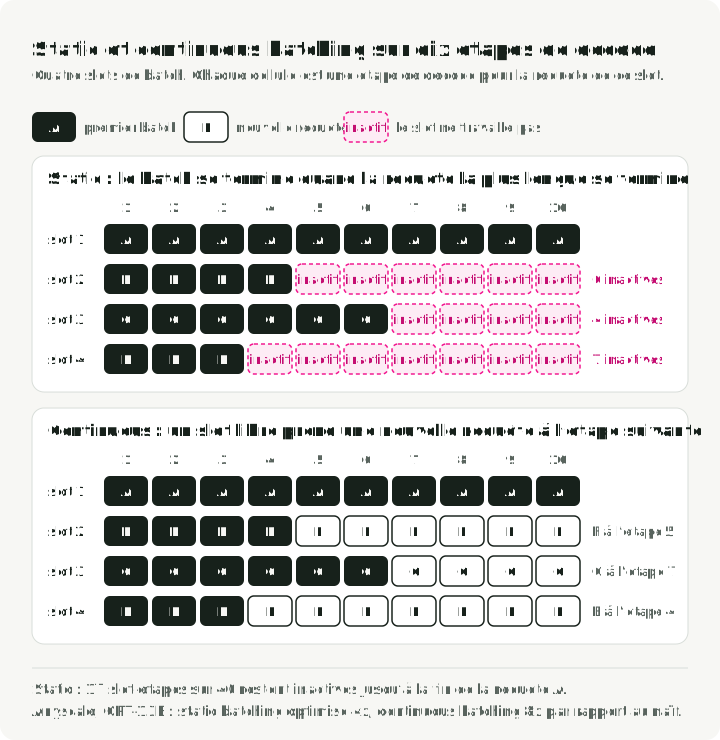
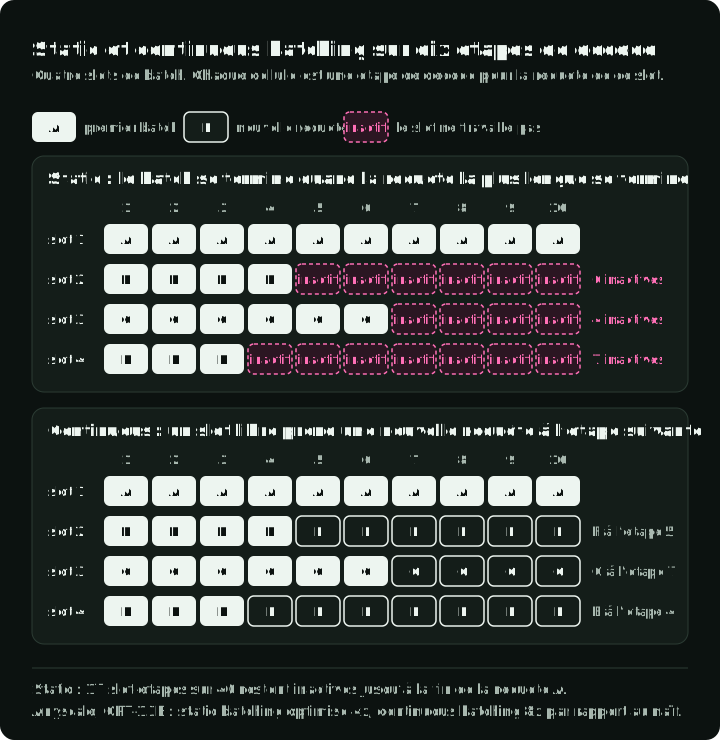
Dans le benchmark OPT-13B d’Anyscale de 2023 sur un A100-40GB, avec 1 000 requêtes, des prompts de 512 tokens et des sorties de 128 tokens en moyenne, le static batching optimisé atteignait 4 fois sa référence naïve, le continuous batching 8 fois, et vLLM avec continuous batching plus PagedAttention 23 fois (Anyscale, 2023). Le continuous batching augmente aussi la pression sur l’allocation du KV, ce qui explique pourquoi on l’associe couramment à une gestion paginée de la mémoire.
14. PagedAttention : mémoire virtuelle pour le KV cache
PagedAttention de vLLM applique l’idée de la mémoire virtuelle des systèmes d’exploitation à la gestion du KV cache. Le KV cache est découpé en blocs de taille fixe (16 tokens dans cette illustration ; la taille des blocs varie selon le runtime), les blocs sont alloués à la demande au fil de la génération des tokens, et les positions logiques (séquentielles) sont associées à des emplacements mémoire physiques (dispersés) par des tables de blocs. Plusieurs requêtes qui partagent un préfixe (system prompts, beam search) peuvent pointer vers les mêmes blocs physiques. La réutilisation des préfixes exige aussi des clés de cache compatibles et une politique de recherche dans le cache. La figure montre une table de blocs pour deux requêtes qui partagent un system prompt.
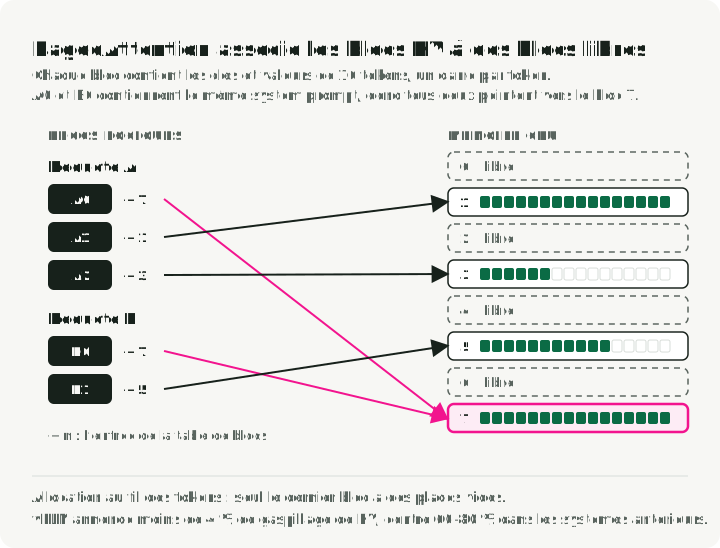
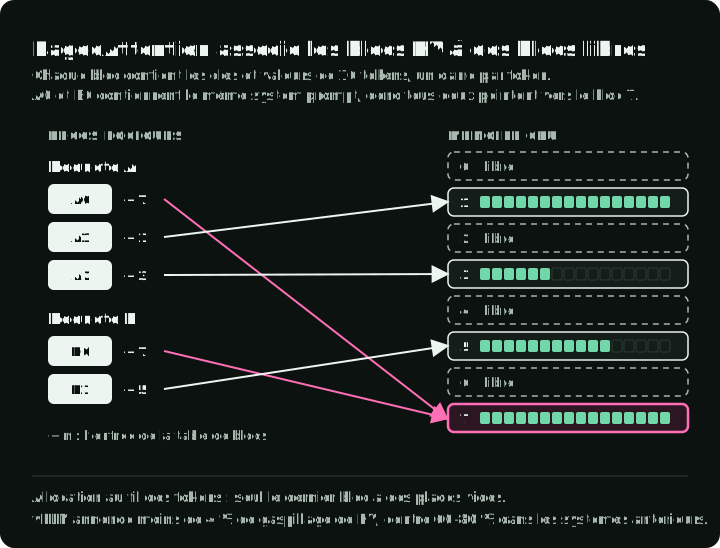
L’évaluation de vLLM de juin 2023 a rapporté 60 à 80 % de perte de mémoire KV dans les systèmes antérieurs testés, contre moins de 4 % avec son allocateur paginé. Elle a rapporté un débit 2 à 4 fois supérieur à TGI et jusqu’à 24 fois supérieur à Hugging Face Transformers sur certaines charges. Ce sont des comparaisons historiques de bout en bout entre systèmes de serving, pas une accélération ni une limite de perte universelles pour PagedAttention. Un dernier bloc partiellement rempli peut gaspiller une part plus importante pour les séquences courtes.
15. Speculative decoding : plusieurs tokens par forward pass
Dans le speculative decoding, un petit modèle draft génère tokens candidats, puis le grand modèle cible évalue les positions en une seule passe avant. Le décodeur accepte les tokens du draft de gauche à droite, avec des probabilités dérivées des distributions de la cible et du draft. Après le premier rejet, il échantillonne une correction dans la distribution cible résiduelle et écarte les tokens restants du draft. Cette étape modifiée d’échantillonnage par rejet préserve la distribution de sortie du modèle cible, aux imprécisions numériques du hardware près ; une simple correspondance exacte des tokens ne suffit pas. La figure déroule un tour avec quatre tokens de draft.
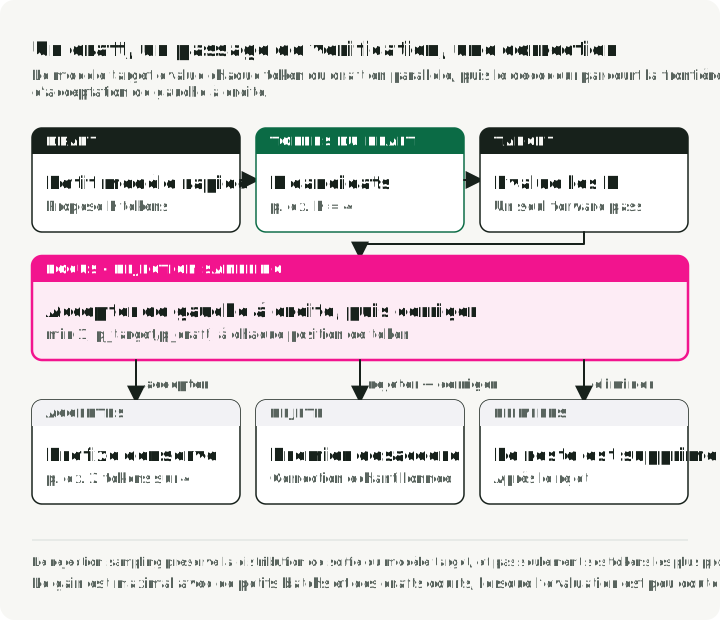
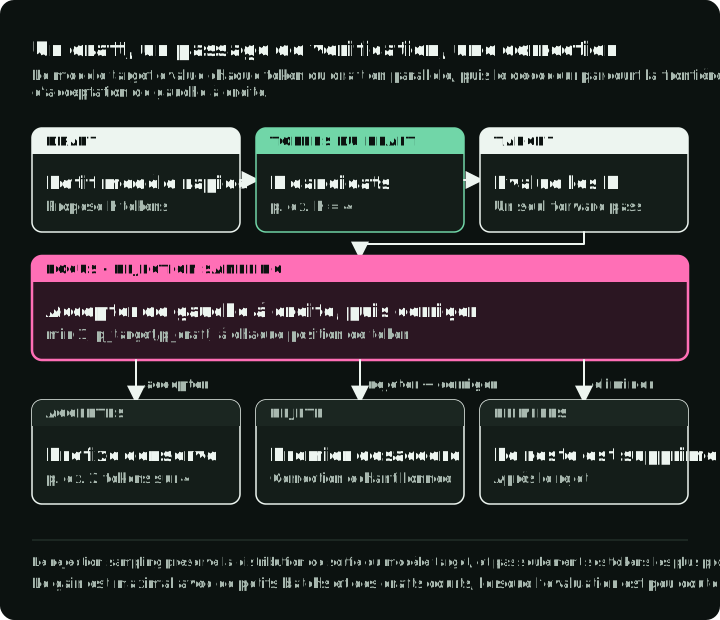
Le gain est le plus plausible avec de petits batchs de serving et de courtes longueurs de draft, lorsque l’évaluation du draft est dominée par le trafic des poids, du KV cache ou de la communication plutôt que par le calcul des tokens supplémentaires. L’article original sur le speculative sampling annonçait une accélération du décodage de 2 à 2,5 fois pour sa configuration testée avec Chinchilla 70B ; EAGLE-3 v3 annonce jusqu’à 6,5 fois dans ses tests. Parmi les variantes : Medusa (têtes de prédiction supplémentaires, sans modèle séparé), le prompt lookup decoding (correspondance de n-grammes avec l’entrée, sans passe avant d’un modèle draft séparé) et EAGLE. L’EAGLE original extrapole des features ; EAGLE-3 combine plusieurs niveaux de features et prédit directement les tokens.
À forte taille de batch, le travail supplémentaire de draft et de vérification peut effacer le gain. Le speculative decoding est le plus prometteur quand le batch de serving est assez petit et que le taux d’acceptation du draft est élevé ; mesurez la boucle de serving complète plutôt que le seul kernel de vérification.
16. Prefix caching et réutilisation du KV cache
Au lieu de jeter le KV cache à la fin d’une requête, le prefix caching le conserve pour le réutiliser avec les nouvelles requêtes qui partagent les mêmes tokens de préfixe. Cela réduit le prefill redondant pour les system prompts, les exemples few-shot, le contexte RAG et l’historique des conversations multi-tours.
L’Automatic Prefix Caching de vLLM hache les blocs de KV et utilise une table de hachage globale pour la recherche. RadixAttention de SGLang maintient un arbre radix de tenseurs KV en cache avec une granularité au niveau du token. Les deux exigent des préfixes identiques au token près et des clés de cache compatibles. L’identité du modèle ou de l’adaptateur, les entrées multimodales et les paramètres d’isolation peuvent aussi affecter la réutilisation. Indiquez le taux de hit avec la latence ou le débit.
17. Le streaming en pratique
Le streaming envoie les tokens au client au fur et à mesure de leur génération au lieu d’attendre la réponse complète. De nombreux serving frameworks l’exposent via les Server-Sent Events : le client ouvre une connexion HTTP de longue durée, et le serveur pousse chaque token ou lot de tokens sous forme d’événement data:. Le TTFT détermine quand l’utilisateur voit la première sortie ; le TPOT contribue à la fluidité perçue. Fixez la cible par des tests produit et selon le modèle d’interaction choisi.
Côté client, le streaming impose des choix de mise en tampon. Un rendu token par token peut provoquer des saccades visuelles, en particulier avec du markdown ou des blocs de code qui ont besoin du contexte de plusieurs tokens pour être formatés correctement. Les schémas courants sont la mise en tampon au niveau du mot (accumuler les tokens jusqu’à une frontière d’espace), la mise en tampon au niveau de la ligne (attendre un saut de ligne avant d’afficher) et la mise en tampon adaptative (afficher immédiatement la prose, mettre les blocs de code en tampon). Dans l’API OpenAI Chat Completions, stream_options: {"include_usage": true} ajoute un dernier fragment d’usage avant le message data: [DONE]. Les streams OpenAI interrompus peuvent omettre le dernier fragment d’usage. Les serveurs compatibles OpenAI peuvent différer ; vérifiez donc l’implémentation retenue.
Le chunked prefill est un moyen d’éviter que de longs prefills bloquent la livraison des tokens aux utilisateurs concurrents. Un ordonnancement qui donne la priorité au decode peut protéger les requêtes en cours, tandis que le serving désagrégé isole le prefill et le decode sur des pools de GPU distincts.
Partie IV — Architecture des modèles
L’architecture fixe l’empreinte mémoire, le comportement de l’attention et la dynamique d’entraînement, autour desquels s’organisent les sections sur le serving et l’entraînement.
18. Les fondamentaux de l’architecture Transformer
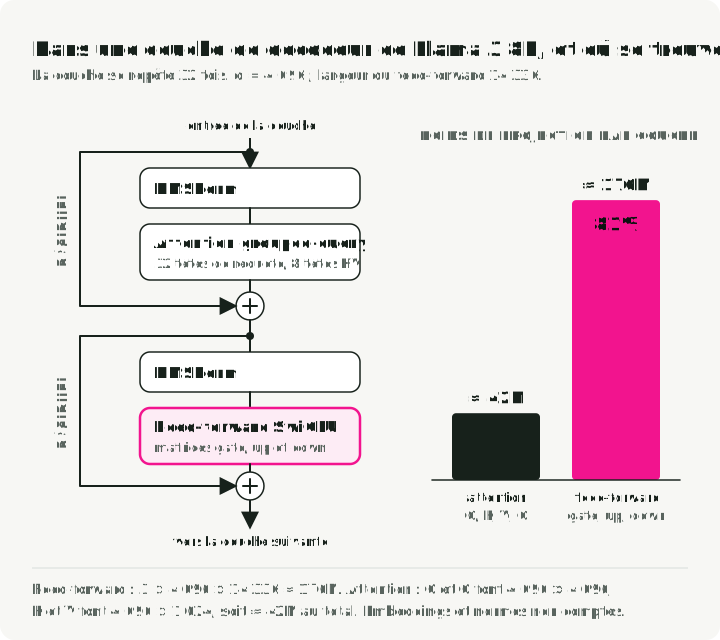
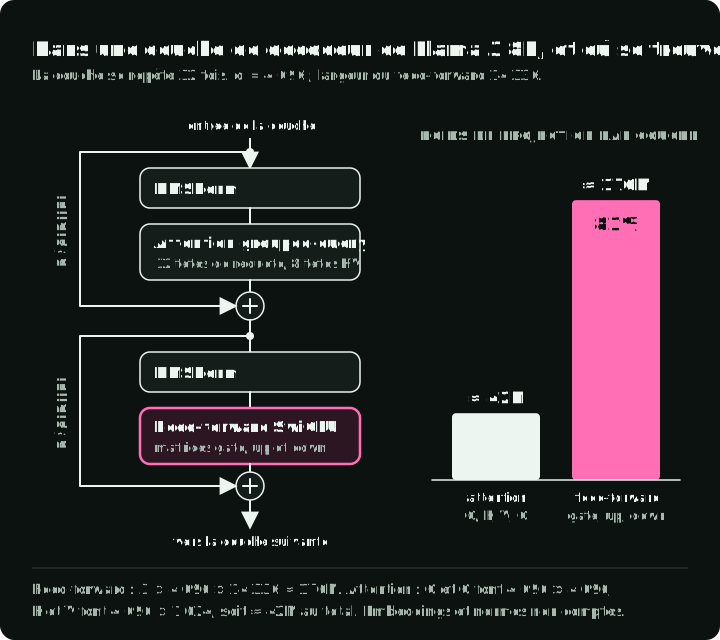
Un transformer decoder-only moderne (GPT, Llama) est une pile de couches identiques, chacune avec deux sous-blocs : l’attention et le feed-forward. Chaque sous-bloc est entouré d’une connexion résiduelle et d’une normalisation. La figure montre une couche de type Llama, avec les deux chemins qui contournent un sous-bloc, et comment ses poids de projection se répartissent entre l’attention et le réseau feed-forward ; les composants sont décrits en dessous.
Les composants clés :
Le Multi-Head Attention permet à chaque token de pondérer l’information des tokens visibles selon le masque d’attention. L’entrée est projetée en trois matrices : les Queries (que recherche ce token ?), les Keys (que contient-il ?) et les Values (quelle information porte-t-il ?). Les scores d’attention sont ensuite calculés ainsi :
Le produit scalaire mesure la similarité entre chaque paire de tokens. La division par évite que les produits scalaires deviennent trop grands (ce qui pousserait le softmax dans des zones où les gradients s’annulent). Le softmax convertit les scores en probabilités, et la multiplication par produit une combinaison pondérée des vecteurs de valeurs. Exécuter cela sur plusieurs têtes en parallèle permet au modèle de suivre simultanément différentes relations (les têtes peuvent apprendre des relations différentes ; leurs rôles ne sont pas fixes).
Le Feed-Forward Network (FFN) transforme chaque représentation de token indépendamment, après que l’attention a mélangé l’information entre les tokens. Les LLM modernes utilisent souvent SwiGLU à la place du FFN ReLU d’origine à deux matrices :
SwiGLU a trois matrices de poids, contre deux pour un FFN ReLU, et utilise la fonction Swish, plus lisse. Llama, Mistral et Qwen l’utilisent ; Gemma utilise un GeGLU approximatif. La règle bien connue des deux tiers s’applique à un bloc MHA complet classique avec : ses deux matrices de FFN apportent environ paramètres, contre environ pour l’attention. Ce n’est pas une estimation générale pour les architectures SwiGLU/GQA. Dans Llama 3 8B, , , et huit têtes key/value font que le FFN compte M paramètres par couche, contre environ 42M paramètres pour les projections d’attention : environ 81 % de ces poids de projection, hors embeddings et normalisation.
Les connexions résiduelles ajoutent la sortie de chaque sous-bloc à son entrée : . Le chemin de saut améliore la propagation du signal et des gradients dans les piles profondes.
RMSNorm est courant dans les familles de LLM modernes. LayerNorm recentre en soustrayant la moyenne et remet à l’échelle par l’écart type. RMSNorm omet la soustraction de la moyenne et se contente de remettre à l’échelle ; son article annonce des réductions du temps d’exécution de 7 à 64 % sur les modèles et frameworks testés, sans réduire les performances mesurées sur les tâches. Le placement pre-norm, qui normalise avant l’attention ou le FFN, est aussi courant parce qu’il améliore la stabilité des gradients.
L’estimation du nombre de paramètres pour un décodeur classique avec MHA complète, un FFN à deux matrices de largeur et des embeddings d’entrée et de sortie liés :
où est la taille du vocabulaire, la dimension cachée et le nombre de couches. Le terme est la matrice d’embeddings d’entrée ; le terme approxime les poids d’attention et de FFN de chaque couche. Pour Llama 3 8B (, , ), l’estimation est d’environ paramètres. Le total publié de 8,03B est plus élevé, car l’approximation omet des détails d’architecture comme la largeur exacte du FFN et la projection de sortie séparée.
19. Modèles decoder-only pour la génération généraliste
Le Transformer d’origine (2017) avait à la fois un encodeur et un décodeur. Depuis, le domaine s’est scindé en trois familles d’architectures, et l’une est devenue la valeur par défaut de l’AI générative.
| Famille | Attention | Objectif d’entraînement | Usage actuel | Exemples |
|---|---|---|---|---|
| Encoder-only | Bidirectionnelle | Prédiction de tokens masqués | Embeddings, rerankers, classifieurs | BERT, RoBERTa |
| Encoder-decoder | Encodeur bidirectionnel ; décodeur causal avec cross-attention | Séquence à séquence (span corruption, T5) | Traduction, reconnaissance vocale | T5, BART, Whisper |
| Decoder-only | Causale | Prédiction du token suivant | Génération de texte généraliste, chat, code | GPT, Llama |
Les modèles encoder-only utilisent une attention bidirectionnelle : chaque token porte son attention sur tous les autres dans les deux sens. Cela produit des représentations pour les tâches de compréhension. Les modèles encoder-only classiques ne servent normalement pas de décodeurs autorégressifs ; ils fournissent souvent l’architecture de base des modèles d’embeddings, des rerankers et des classifieurs légers (par exemple les routeurs à base de BERT de RouteLLM).
Les modèles encoder-decoder séparent la compréhension de la génération. L’encodeur traite toute l’entrée avec une attention bidirectionnelle, puis le décodeur génère la sortie de façon autorégressive en portant son attention sur les représentations de l’encodeur par la cross-attention. Cela convient aux tâches où l’entrée et la sortie sont des séquences différentes, comme la traduction et la reconnaissance vocale.
Les modèles decoder-only comme GPT, Llama et Mistral utilisent une attention causale : chaque token porte son attention sur lui-même et les tokens précédents. Quatre propriétés utiles pour la génération sont :
- Réutilisation du KV cache. Avec l’attention causale, les tokens précédents ne portent jamais leur attention sur les suivants ; leurs keys et values restent donc valides à mesure que de nouveaux tokens sont générés. Un seul cache par séquence grandit par ajout (Section 6). Un encoder-decoder conserve aussi un état de cross-attention sur la sortie de l’encodeur.
- Entraînement sur du texte brut. La prédiction du token suivant n’a besoin d’aucune paire entrée-sortie ; tout corpus de texte devient donc une donnée d’entraînement.
- Un seul bloc répété. Le modèle est une pile de couches de décodeur identiques, sans pile d’encodeur séparée ni chemin de cross-attention à construire, à répartir en shards et à optimiser.
- Apprentissage en contexte. Les instructions, les exemples few-shot et la requête sont tous des tokens d’un même préfixe ; un seul modèle peut donc aborder une nouvelle tâche à partir du prompt.
20. Mixture of experts
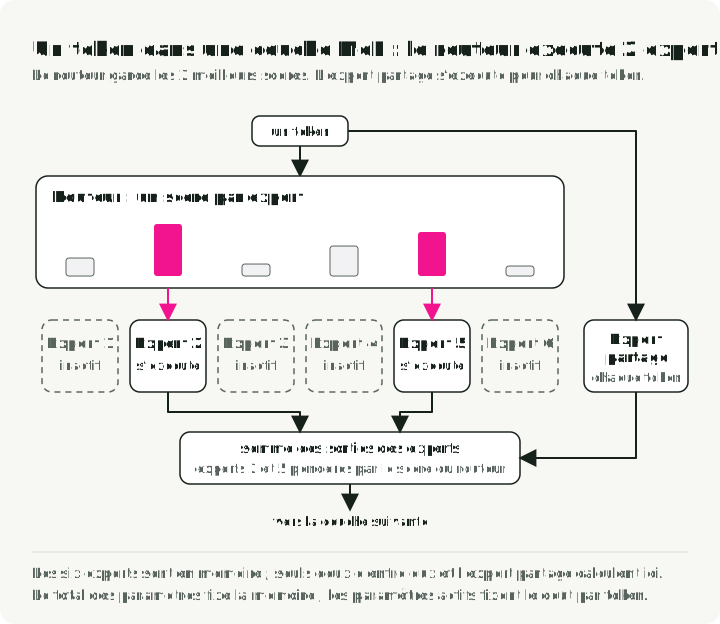
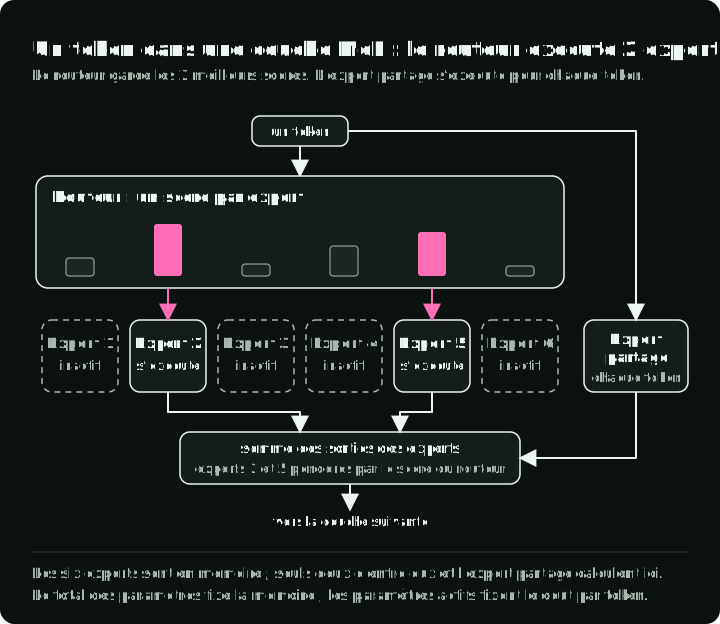
Le MoE remplace certains FFN denses par plusieurs FFN experts et un routeur de gating léger. Le routeur calcule un score pour chaque expert (en général un softmax sur des projections linéaires apprises) et sélectionne les meilleurs experts par token. Seuls les experts activés calculent ; un modèle peut donc avoir une énorme capacité totale tout en gardant un faible coût par token. C’est du calcul conditionnel parcimonieux. Les paramètres actifs donnent une approximation du calcul par token, mais tous les poids des experts doivent être stockés. La communication, le routage, l’occupation des batchs et la mémoire KV affectent aussi le coût d’exécution. La figure suit un token à travers une couche MoE avec six experts routés et un expert partagé.
| Modèle | Paramètres totaux | Paramètres actifs | Experts (routés + partagés) | Top- |
|---|---|---|---|---|
| Mixtral 8x7B | 47B | ~13B | 8 + 0 | 2 |
| DeepSeek-V3 | 671B | 37B | 256 + 1 | 8 |
L’expert partagé de DeepSeek-V3 est activé pour chaque token. Il fournit une représentation de base sur laquelle les experts routés peuvent se spécialiser.
L’entraînement d’un MoE pose trois problèmes récurrents : le déséquilibre de charge, l’effondrement des experts et le coût de communication du parallélisme d’experts. Les modèles MoE traditionnels ajoutent une perte auxiliaire pour pénaliser un routage déséquilibré, mais cette perte peut entrer en concurrence avec l’objectif principal. DeepSeek-V3 utilise principalement une stratégie par batch sans perte auxiliaire : des termes de biais, hors rétropropagation, abaissent le score des experts surchargés et relèvent celui des experts sous-utilisés. Il applique aussi une perte d’équilibrage complémentaire, extrêmement petite, au niveau de la séquence, pour éviter un déséquilibre extrême au sein d’une séquence. L’article annonce un meilleur équilibre du routage, sans le compromis de la perte auxiliaire principale, dans sa configuration.
21. Tokenisation : BPE, SentencePiece et tiktoken
Les LLM ne voient pas le texte. Ils voient des séquences d’identifiants de tokens entiers. Un tokenizer découpe le texte brut en tokens (morceaux de sous-mots) et associe un identifiant à chacun. Le choix du tokenizer influe sur la qualité du modèle, la vitesse d’inférence et l’équité multilingue.
Le Byte Pair Encoding (BPE) est l’algorithme courant. Il fusionne itérativement les paires adjacentes les plus fréquentes du corpus d’entraînement. Un exemple simplifié :
- Partir d’un vocabulaire au niveau des caractères :
[l, o, w, e, r, _] - La paire la plus fréquente est
(l, o)→ fusion enlo→ vocabulaire :[l, o, w, e, r, _, lo] - La paire la plus fréquente suivante est
(lo, w)→ fusion enlow→ le vocabulaire gagnelow - Continuer jusqu’à ce que le vocabulaire atteigne la taille cible (par ex., 128K tokens)
Les mots courants comme « the » deviennent des tokens uniques, tandis que les mots rares comme « defenestration » sont découpés en morceaux de sous-mots comme ["def", "en", "est", "ration"] dans une illustration inventée. Le découpage réel dépend du tokenizer et de sa version. Le compromis porte sur la taille du vocabulaire face à la longueur des séquences.
Trois implémentations de tokenizer couvrent la plupart des usages en production :
- SentencePiece s’entraîne directement sur du texte Unicode brut, sans pré-tokenizer propre à une langue. Il préserve les espaces avec le méta-symbole
▁et peut éventuellement se rabattre sur des tokens d’octets UTF-8. Il prend en charge les modèles BPE et unigram, et est utilisé par Llama 1/2, T5 et les premiers tokenizers de Mistral. Les tokenizers Mistral Tekken plus récents utilisent un BPE de type tiktoken. - tiktoken est le tokenizer d’OpenAI écrit en Rust, qui utilise un BPE au niveau de l’octet. Dans son benchmark GPT-2 publié, il s’exécutait 3 à 6 fois plus vite que la configuration
GPT2TokenizerFasttestée. Llama 3 est passé de SentencePiece à l’algorithme de tiktoken. - Hugging Face Tokenizers est une bibliothèque Rust très utilisée, qui prend en charge BPE, WordPiece et Unigram.
La taille du vocabulaire varie beaucoup d’une famille de modèles à l’autre :
| Modèle | Tokenizer | Taille du vocabulaire |
|---|---|---|
| GPT-2 | BPE au niveau de l’octet | 50,257 |
| Llama 2 | SentencePiece BPE | 32,000 |
| Llama 3 | BPE de type tiktoken | 128,256 |
| GPT-4o | tiktoken o200k_base | ~200K |
Dans une configuration comparable d’entraînement du tokenizer, un vocabulaire plus grand peut donner moins de tokens pour le même texte, mais une matrice d’embeddings plus grande (le terme de la Section 18).
La fertilité mesure combien de tokens un tokenizer produit par mot ou par une autre unité de texte choisie. Elle varie selon le tokenizer exact, la langue, l’écriture, la normalisation, le domaine et l’échantillon. Mesurez-la sur du trafic représentatif plutôt que d’extrapoler à partir d’un seul tokenizer ou d’une seule langue.
22. Fenêtres de contexte et encodages positionnels
La fenêtre de contexte limite la séquence de tokens disponible pour une requête de génération. Le chunked prefill et le decode avec cache ne traitent qu’une partie de cette séquence par passe. Les APIs peuvent aussi définir des limites distinctes pour l’entrée et la sortie. Parmi les limites publiées :
| Modèle | Limite de tokens publiée | Année |
|---|---|---|
| Llama 1 | 2,048 | 2023 |
| Llama 3.1 | 128K | 2024 |
| GPT-4.1 | 1,047,576 | 2025 |
| Gemini 2.5 Pro | 1,048,576 en entrée | 2025 |
GPT-4.1 limite aussi la sortie à 32 768 tokens ; Gemini 2.5 Pro la limite à 65 536. La ligne Gemini indique une limite d’entrée, tandis que GPT-4.1 indique une fenêtre de contexte ; ces champs ne sont donc pas identiques.
L’attention compare chaque paire de tokens visibles, mais rien dans cette comparaison n’indique à quelle distance ils se trouvent l’un de l’autre. Sans information de position, une self-attention complète ne distingue pas des ordres de mots différents contenant les mêmes tokens ; les états par token suivent la permutation de l’entrée. Le masque causal d’un décodeur donne un certain signal d’ordre, parce que chaque token ne voit que son préfixe, mais il ne fournit pas de positions relatives explicites. Les encodages positionnels ajoutent explicitement la position et la distance relative.
Trois approches courantes :
-
RoPE (Rotary Position Embeddings) fait tourner les vecteurs de requête et de clé selon des angles dépendant de la position, de sorte que leur produit scalaire dépend de la position relative. Le contenu du token détermine toujours le score d’attention ; RoPE ajoute l’information de position sans embeddings de position absolue appris. Il est utilisé par des familles de modèles ouverts dont Llama, Mistral et Qwen.
-
ALiBi (Attention with Linear Biases) ne modifie pas les embeddings et ajoute une pénalité directement aux scores d’attention : plus deux tokens sont éloignés, plus le biais négatif est grand. Il n’a aucun paramètre positionnel appris. Dans l’article d’origine, un modèle de 1,3B entraîné sur des séquences de 1 024 tokens avait des performances comparables à 2 048 tokens à celles d’un modèle à positions sinusoïdales entraîné à 2 048. Au-delà des modèles et des longueurs testés dans l’article, le comportement dépend du modèle.
-
YaRN (Yet another RoPE extensioN) étend un modèle RoPE au-delà de son contexte d’entraînement. Il regroupe les dimensions de fréquence en trois catégories et met chacune à l’échelle différemment. Dans la comparaison de l’article avec la même procédure et l’interpolation de positions, YaRN utilise 400 étapes d’entraînement au lieu de 1 000 (annexe B.2). La réduction de données de 10 fois annoncée dans le résumé utilise une autre comparaison.
Partie V — Entraînement et alignment
Cette partie distingue l’objectif qui crée les capacités, les techniques qui permettent à l’entraînement de tenir sur le hardware disponible et les méthodes qui façonnent ensuite le comportement du modèle.
23. Préentraînement, fine-tuning et alignment
Le préentraînement d’un LLM autorégressif utilise la prédiction auto-supervisée du token suivant sur un grand corpus. Les modèles encodeurs peuvent utiliser d’autres objectifs, comme la prédiction de tokens masqués. Son calcul s’étend sur de nombreux ordres de grandeur ; Llama 3 405B, par exemple, a utilisé FLOPs. Le fine-tuning supervisé (SFT) adapte le modèle préentraîné à des données étiquetées propres à une tâche. RLHF / RLAIF utilise des données de préférence pour façonner le comportement : un pipeline RLHF classique collecte des comparaisons, entraîne un modèle de récompense, puis optimise la politique. RLAIF remplace une partie des jugements humains par un retour généré par une AI. La Section 31 couvre la distillation, un chemin distinct où un enseignant aligné génère des données d’entraînement pour un élève plus petit.
Le calcul dépend de la taille du modèle, de la longueur de séquence, du volume de données, de l’optimiseur et de la méthode. PPO porte aussi plus d’état de modèle que le SFT, car une configuration typique comprend des modèles de politique, de référence, de récompense et de critique. J’ai couvert le cadre complet de décision sur le fine-tuning dans le Guide du fine-tuning des LLM.
24. LoRA et QLoRA : fine-tuning efficace en paramètres
LoRA fige les poids préentraînés et injecte des matrices de faible rang entraînables () et (), de sorte que le poids mis à jour vaut . L’article LoRA a réduit GPT-3 175B à environ 18 millions de paramètres entraînables dans sa configuration. Le rang est un paramètre de réglage et non une règle de complexité de la tâche ; choisissez-le par un balayage de qualité et de mémoire. Les adapters LoRA peuvent être fusionnés dans les poids de base après l’entraînement, pour éviter un chemin d’adapter distinct à l’inférence.
QLoRA charge le modèle de base en quantification NF4 sur 4 bits tout en entraînant les adapters LoRA en BF16. NormalFloat4 place davantage de niveaux de quantification près de zéro, là où la densité des poids est la plus élevée. L’article a fine-tuné un modèle de 65B sur un seul GPU de 48 Go et rapporté des résultats proches de ses références en 16 bits. Ses compromis de temps d’exécution et de mémoire sont propres à la stack testée.
25. Entraînement en précision mixte
Chaque format en virgule flottante répartit ses bits entre trois champs : le signe (toujours 1 bit), l’exposant (qui fixe la plage dynamique) et la mantisse (qui fixe la précision). Plus de bits d’exposant signifie une plage plus large de grandeurs représentables ; plus de bits de mantisse signifie des distinctions plus fines entre des valeurs proches. Les formats entiers n’ont pas d’exposant du tout et ne représentent que des nombres entiers régulièrement espacés dans une plage fixe.
| Format | Bits | Disposition (S / E / M) | Plage | Précision | Usage courant |
|---|---|---|---|---|---|
| FP32 | 32 | 1 / 8 / 23 | ~7 chiffres décimaux | Poids maîtres, états de l’optimiseur (moment et variance d’Adam) | |
| BF16 | 16 | 1 / 8 / 7 | ~2 chiffres décimaux | Format d’entraînement privilégié ; même plage que FP32 et généralement pas de loss scaling | |
| FP16 | 16 | 1 / 5 / 10 | ~3 chiffres décimaux | Entraînement avec loss scaling (GPU plus anciens) ; inférence sur du hardware antérieur à Hopper | |
| FP8 E4M3 | 8 | 1 / 4 / 3 | ~1 chiffre décimal | Passe avant sur Hopper (H100) — plus de précision pour les poids et les activations | |
| FP8 E5M2 | 8 | 1 / 5 / 2 | ~0,6 chiffre décimal | Passe arrière sur Hopper — plage plus large pour les gradients | |
| INT8 | 8 | entier signé | à | Entiers exacts | Quantification des poids après entraînement pour l’inférence (W8A8) ; quantification du KV cache |
| INT4 | 4 | entier signé | à | Entiers exacts | Quantification agressive des poids seuls (AWQ, GPTQ) pour l’inférence sur du hardware à mémoire contrainte |
Le BF16 a la même plage que le FP32, parce que la plage est fixée par le champ d’exposant et que le BF16 garde les 8 bits d’exposant du FP32. Il sacrifie des bits de mantisse à la place (7 contre 23), échangeant de la précision contre une réduction de mémoire d’un facteur 2, tout en évitant de nombreux problèmes de plage qui touchent l’entraînement en FP16. Le FP16 n’a que 5 bits d’exposant, ce qui plafonne sa plage finie à environ 65K. De nombreux gradients sont au contraire trop petits pour le FP16 et passent à zéro par underflow. Le loss scaling multiplie la perte avant la rétropropagation pour que ces gradients restent représentables, puis les remet à l’échelle avant l’étape de l’optimiseur ; le scaling dynamique abaisse le facteur en cas d’overflow. La plage d’exposant plus large du BF16 évite généralement cette exigence.
Les formats entiers sont peu utilisés pour l’arithmétique principale de l’entraînement, car la rétropropagation a besoin d’une large plage dynamique. Ils sont très utilisés pour l’inférence, où des poids figés peuvent être associés à des échelles calibrées. La quantification des poids en INT4 fait passer un modèle de 7B d’environ 14 Go à 3,5 Go avant l’overhead du runtime ; la qualité doit être mesurée pour le modèle et la méthode choisis.
L’entraînement en FP8 sur H100 via Transformer Engine utilise E4M3 là où la précision compte et E5M2 là où une plage plus large compte. L’article FP8-LM rapporte que son framework de précision mixte a entraîné GPT-175B 75 % plus vite que sa référence Megatron-LM en BF16 et 37 % plus vite que NVIDIA Transformer Engine, dans la configuration H100 testée. DeepSeek-V3 a utilisé la précision mixte FP8 et annoncé environ $5.6 millions de calcul en équivalent location pour son entraînement final, hors R&D et infrastructure.
26. Gradient checkpointing
Chaque couche de la passe avant produit une sortie intermédiaire appelée activation :
Normalement, toutes les activations doivent rester en mémoire, car la rétropropagation en a besoin pour calculer les gradients. Pour un transformer profond, les activations stockées peuvent occuper plus de mémoire que les poids du modèle eux-mêmes.
Le gradient checkpointing échange du calcul contre de la mémoire : il jette la plupart de ces activations et les recalcule à la volée pendant la rétropropagation. La stratégie standard (Chen et al., 2016) divise un réseau de couches en segments régulièrement espacés et ne sauvegarde que l’activation de frontière de chaque segment. Ces frontières sauvegardées sont les « checkpoints ». Toutes les activations intermédiaires d’un segment sont abandonnées immédiatement.
Quand la passe arrière atteint une couche à l’intérieur d’un segment, ses activations sont recalculées à partir du checkpoint le plus proche. Avec la stratégie de segmentation régulière, la mémoire d’activations sauvegardées passe de à . Chaque segment est recalculé une fois, ce qui coûte environ une passe avant supplémentaire par étape d’entraînement (Chen et al., 2016). Les économies réelles de mémoire et le surcoût de recalcul dépendent du modèle, des frontières de checkpoint, de la longueur de séquence, du framework et de l’implémentation ; mesurez donc les deux sur l’entraînement cible. FlashAttention applique le même principe à l’intérieur de l’attention en ne matérialisant pas la matrice d’attention complète. Pour les entraînements ordinaires avec Hugging Face Trainer, activez-le avec gradient_checkpointing=True. Avec FSDP, utilisez l’intégration d’activation checkpointing du framework lorsqu’elle est prise en charge ; l’option générique peut provoquer des all-gathers redondants pendant la passe arrière.
27. Étapes ZeRO de DeepSpeed
Dans le data parallelism standard, chaque GPU conserve une copie complète des poids du modèle, des gradients et des états de l’optimiseur. Pour Adam, chaque paramètre prend 2 octets pour le poids FP16 + 4 octets pour le poids maître FP32 + 4 octets pour le moment + 4 octets pour la variance + 2 octets pour le gradient, soit 16 octets par paramètre. Un modèle de 7,5B paramètres demande ~120 Go par GPU, et chaque GPU stocke la même chose. Sur 64 GPU, cela fait 64 copies identiques de 120 Go.
DeepSpeed ZeRO (Zero Redundancy Optimizer) supprime cette duplication en répartissant ces composants entre les GPU au lieu de les répliquer :
- Étape 1 — partitionner les états de l’optimiseur. Chaque GPU ne stocke que 1/N des états de l’optimiseur (les poids maîtres FP32 plus le premier et le second moment d’Adam, 12 octets/param). Quand un GPU doit mettre à jour un poids, il ne met à jour que sa tranche et diffuse le résultat. Avec les hypothèses ci-dessous, la mémoire passe d’environ 120 Go à ~41,3 Go par GPU.
- Étape 2 — partitionner aussi les gradients. Les gradients (2 octets/param) ne sont plus tous réduits par all-reduce vers chaque GPU. Chaque GPU ne reçoit que la tranche de gradient dont il a besoin, par reduce-scatter. Avec les mêmes hypothèses, la mémoire tombe à ~28,1 Go par GPU.
- Étape 3 — partitionner aussi les poids du modèle. Chaque GPU ne détient que 1/N des poids FP16. Avant la passe avant ou arrière de chaque couche, le GPU appelle all-gather pour reconstituer temporairement les poids complets de la couche à partir de tous les autres GPU, calcule, puis abandonne les poids rassemblés. Avec les mêmes hypothèses, la mémoire tombe à ~15,0 Go par GPU.
La figure dessine à l’échelle l’état du modèle par GPU à chaque étape, avec le coût de communication de chaque étape.
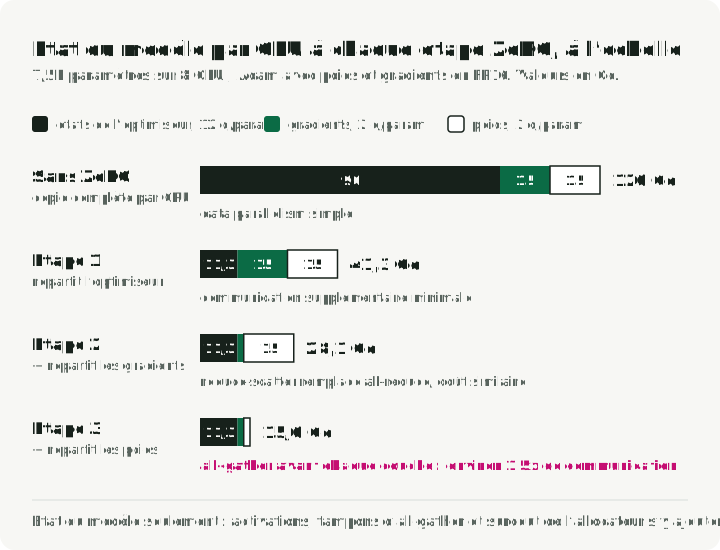
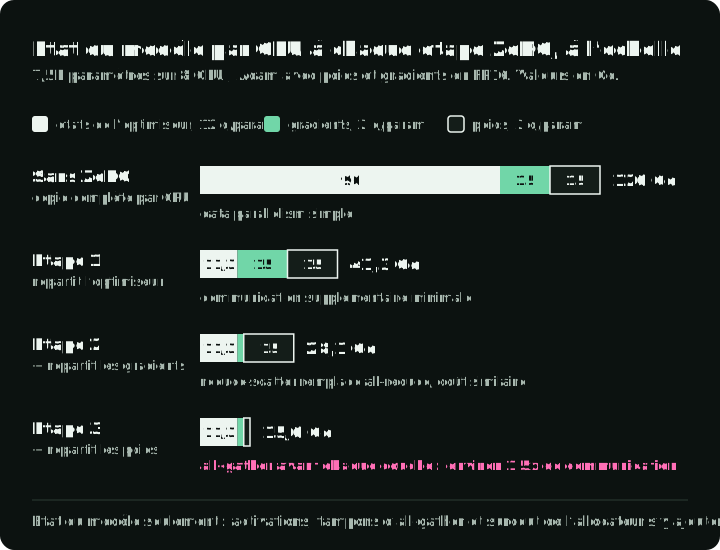
Ce sont des valeurs approximatives de mémoire d’état du modèle pour un modèle de 7,5B paramètres sur 8 GPU (world size ), avec des poids et des gradients FP16 et des poids maîtres, un moment et une variance d’Adam en FP32. Elles excluent les activations, les tampons temporaires d’all-gather, la fragmentation de l’allocateur et l’overhead du framework et du runtime. La limite du calcul est octets par paramètre, chaque état étant divisé par uniquement aux étapes qui le répartissent.
Pour refaire le calcul avec une autre taille de modèle ou un autre nombre de GPU :
def zero_model_state_gb(params_b, n_gpus, stage):
    """Model-state GB per GPU for Adam with FP16 weights and gradients.

    Optimizer states (FP32 master weights, momentum, variance) take 12 bytes
    per parameter, gradients 2, and weights 2. Stage 1 shards the optimizer
    states, stage 2 also the gradients, and stage 3 also the weights.
    """
    optimizer, gradients, weights = 12, 2, 2
    if stage >= 1:
        optimizer /= n_gpus
    if stage >= 2:
        gradients /= n_gpus
    if stage >= 3:
        weights /= n_gpus
    return params_b * (optimizer + gradients + weights)

for stage in range(4):
    print(f"stage {stage}: {zero_model_state_gb(7.5, 8, stage):g} GB per GPU")

assert [zero_model_state_gb(7.5, 8, s) for s in range(4)] == [120.0, 41.25, 28.125, 15.0]
# 70B parameters: Stage 3 on 8 GPUs still needs 140 GB of model state per GPU;
# 16 GPUs bring it to 70 GB, before activations.
assert zero_model_state_gb(70, 8, 3) == 140.0
assert zero_model_state_gb(70, 16, 3) == 70.0
Le compromis, c’est la communication. L’étape 1 ajoute un overhead minimal, et l’étape 2 remplace all-reduce par reduce-scatter pour un coût similaire. L’étape 3 demande des appels all-gather avant chaque couche, à la fois dans la passe avant et dans la passe arrière, soit environ 1,5 fois le volume de communication du data parallelism standard.
ZeRO-Infinity étend l’étape 3 en déchargeant les états partitionnés vers la RAM du CPU et même vers des SSD NVMe, ce qui peut rendre possible l’entraînement de modèles à des milliers de milliards de paramètres sur des clusters de GPU limités. Le déchargement vers le stockage ajoute un coût de transfert PCIe et de stockage ; son impact mesuré dépend du disque, de la topologie PCIe, du partitionnement, du prefetch, du recouvrement des transferts et du workload. Utilisez-le pour satisfaire des exigences de capacité plutôt que de supposer un ralentissement fixe, et profilez la configuration cible.
28. FSDP : sharding natif de PyTorch
Fully Sharded Data Parallel (FSDP) est la réponse intégrée de PyTorch à DeepSpeed ZeRO-3. Il répartit paramètres, gradients et états de l’optimiseur entre les GPU selon la même idée de fond. Avec le partitionnement complet et le repartitionnement activés, les opérations pour chaque unité enveloppée sont :
- All-gather des paramètres complets depuis tous les GPU (reconstitution temporaire de la couche complète).
- Calcul de la passe avant ou arrière de cette couche.
- Libération immédiate des paramètres rassemblés. Chaque GPU ne garde que son propre shard.
- Reduce-scatter des gradients pour que chaque GPU ne reçoive que la tranche de gradient qui lui est assignée.
Comme FSDP est natif à PyTorch, il s’intègre directement aux outils de débogage et aux profileurs de PyTorch, ainsi qu’à torch.compile. Sa performance par rapport à DeepSpeed ZeRO-3 dépend de la politique de wrapping, de la topologie de communication, des réglages de déchargement et de la taille du modèle ; comparez-les donc sur le même cluster.
| Critère | FSDP (PyTorch) | DeepSpeed ZeRO |
|---|---|---|
| Style de contrôle | Sharding complet via les API PyTorch | Étapes ZeRO au choix |
| Déchargement | Déchargement vers le CPU | CPU + NVMe avec ZeRO-Infinity |
| Intégration au framework | PyTorch natif, chemins torch.compile | Bibliothèque séparée et système de config propre |
| Test de sélection | Profiler le workload PyTorch cible | Profiler les fonctionnalités et le déchargement requis |
FSDP2 (2024–2025) est une réécriture qui améliore l’intégration de torch.compile pour une meilleure fusion de kernels, ajoute la prise en charge de l’entraînement FP8 via TorchAO et simplifie l’API. FSDP et DeepSpeed sont tous deux accessibles via Hugging Face Accelerate, qui les prend tous deux en charge par configuration pour des scripts d’entraînement compatibles et préparés. Les paramètres nécessaires d’enveloppement, de checkpointing et de déchargement restent différents.
29. Lois d’échelle et coût d’inférence
Le scaling de Chinchilla (DeepMind, 2022) a trouvé une répartition optimale du calcul proche de 20 tokens d’entraînement par paramètre, selon ses hypothèses. Cet objectif n’inclut pas le coût du serving en aval. Si un modèle plus petit entraîné sur plus de données atteint la qualité requise, il peut coûter moins cher sur un cycle de vie d’inférence à fort volume.
Une stratégie de coût sur le cycle de vie consiste à entraîner un modèle plus petit sur beaucoup plus de données :
| Modèle | Paramètres | Tokens d’entraînement | Tokens/paramètre | Tokens/paramètre ÷ 20 (dérivé) |
|---|---|---|---|---|
| Chinchilla | 70B | 1.4T | 20:1 | 1× |
| Llama 1 | 65B | 1.4T | 22:1 | 1× |
| Llama 2 | 70B | 2.0T | 29:1 | 1.4× |
| Llama 3 8B | 8B | 15T | 1,875:1 | 94× |
| Qwen3-0.6B | 0.6B | 36T | 60,000:1 | 3,000× |
Il s’agit du rapport tokens par paramètre affiché, divisé par le point approximatif de 20 tokens par paramètre de l’article Chinchilla. C’est un rapport descriptif, et non un multiplicateur mesuré de qualité ou de coût.
Pour un modèle servi à fort volume, consacrer plus de calcul d’entraînement à un modèle plus petit peut réduire le coût sur le cycle de vie. Llama 3 8B illustre la stratégie, mais son bénéfice dépend de la qualité requise et du volume d’inférence prévu. « Chinchilla-optimal » renvoie à l’efficacité du calcul d’entraînement, objectif différent du coût sur le cycle de vie.
30. RLHF, DPO, GRPO et paysage de l’alignment
L’alignment oriente un modèle préentraîné vers les instructions, les préférences et les politiques de sécurité souhaitées. Il ne garantit pas à lui seul la véracité ni la sûreté du comportement. Les méthodes ci-dessous diffèrent par la complexité d’implémentation, les besoins en données, l’exploration et la stabilité de l’entraînement.
Le pipeline RLHF classique : SFT → collecte de paires de préférences humaines → entraînement d’un modèle de récompense sur ces paires → fine-tuning de la politique avec PPO (Proximal Policy Optimization). Une configuration PPO classique comporte quatre rôles de modèle : politique, référence, modèle critique/valeur et modèle de récompense. Leur mémoire dépend du partage, du partitionnement, de la précision, du déchargement et du placement ; quatre rôles ne signifient pas quatre copies complètes en mémoire GPU. PPO est aussi sensible aux hyperparamètres. Il est aussi sujet au reward hacking, où le modèle exploite les particularités du modèle de récompense, comme des réponses verbeuses et assurées, au lieu d’améliorer réellement la qualité.
DPO (Direct Preference Optimization) supprime le modèle de récompense appris et la boucle de RL en ligne en optimisant directement une perte sur des paires de préférences. Cela simplifie le pipeline d’entraînement. Le DPO standard est hors ligne : il s’entraîne sur un dataset fixe et n’explore pas de nouvelles réponses pendant la boucle de mise à jour. L’importance de cette limite dépend de la tâche et de la couverture des données.
GRPO (Group Relative Policy Optimization, DeepSeek) supprime le critique appris de PPO en générant plusieurs complétions par prompt et en utilisant les récompenses relatives au groupe comme référence. Cela réduit la charge d’état de modèle par rapport à une configuration PPO typique. Contrairement au DPO, GRPO est on-policy : le modèle génère de nouvelles réponses pendant l’entraînement. DeepSeek-R1 combine GRPO avec RLVR (reinforcement learning from verifiable rewards), qui s’appuie sur des vérifications comme des réponses mathématiques, la compilation du code et des tests unitaires. Ces récompenses sont plus faciles à auditer qu’un score de préférence appris, mais des tests incomplets et des objectifs approchés peuvent tout de même être exploités.
| Méthode | Rôles de modèle dans une configuration classique | Signal de récompense | En ligne/hors ligne | Limite principale |
|---|---|---|---|---|
| PPO | Politique, référence, critique, récompense | Modèle de récompense appris | En ligne | Reward hacking, réglage complexe |
| DPO | Politique plus scores de référence, pouvant être précalculés | Implicite (paires de préférences) | Hors ligne | Pas d’exploration, données fixes |
| GRPO | Politique ; référence facultative pour KL et récompense apprise facultative | Explicite (règle/vérificateur ou apprise) | En ligne | Dépend de la qualité de la récompense et d’une variation informative au sein du groupe |
La politique de référence de GRPO dépend de l’implémentation. Par exemple, TRL GRPOTrainer ne charge pas de modèle de référence lorsque son coefficient KL beta vaut zéro. Précisez le placement des modèles et leur précision pour comparer la mémoire d’entraînement.
31. Distillation : transférer des connaissances entre modèles
La distillation de connaissances transfère des capacités d’un grand enseignant à un élève plus petit. La distillation par logits entraîne l’élève à reproduire la distribution de sortie de l’enseignant. La distillation par données fait générer par l’enseignant des exemples sur lesquels l’élève est fine-tuné. Les méthodes par données sont courantes pour les LLM, car elles fonctionnent entre architectures différentes et avec des enseignants accessibles uniquement par API, mais leur valeur est bornée par la qualité de l’enseignant, la couverture des données, le filtrage et le coût de génération.
DeepSeek-R1 a constitué un mélange d’environ 800 000 exemples — environ 600 000 échantillons liés au raisonnement et 200 000 échantillons hors raisonnement — et l’a utilisé pour distiller des modèles Qwen2.5 et Llama 3 de 1,5B à 70B paramètres. Dans l’évaluation de l’article :
- DeepSeek-R1-Distill-Qwen-32B obtient 72,6 % sur AIME 2024 et 94,3 % sur MATH-500, au-dessus des chiffres d’OpenAI o1-mini rapportés par l’article.
- DeepSeek-R1-Distill-Qwen-7B obtient 55,5 % sur AIME 2024, au-dessus du résultat de QwQ-32B-Preview rapporté par l’article, avec un modèle plus petit.
Dans les expériences sur petits modèles de DeepSeek-R1, la distillation a dépassé le GRPO direct sur les modèles de base testés. Ce résultat plaide pour la distillation dans cette configuration ; il n’établit pas de classement universel entre distillation et RL.
32. Génération de données synthétiques
Les données d’entraînement générées par des LLM servent selon plusieurs schémas récurrents :
- Self-Instruct part d’un petit jeu d’instructions écrites par des humains : le LLM génère de nouvelles instructions, entrées et sorties, qui sont filtrées puis réinjectées dans le pool. Le projet Alpaca a utilisé 52 000 exemples générés à partir de 175 graines. Stanford a annoncé une génération de données à moins de $500 et un fine-tuning à moins de $100, soit un coût de reproduction initial inférieur à $600 ; sa comparaison avec GPT-3.5 était une évaluation limitée du projet, pas une équivalence générale.
- Evol-Instruct (WizardLM) prend des instructions existantes et les fait évoluer itérativement selon des axes de complexité (ajout de contraintes, raisonnement plus profond, problèmes plus concrets) pour produire des exemples d’entraînement de plus en plus difficiles.
- Phi-4 de Microsoft (14B) a utilisé des données synthétiques pour une grande partie du préentraînement, avec génération, critique, auto-révision et inversion d’instructions. Son rapport technique compare les performances obtenues en STEM et en code à celles de modèles plus grands sur les benchmarks sélectionnés.
Un risque est l’effondrement de modèle (model collapse) lorsque les données réelles sont remplacées récursivement par des données générées. Dans les configurations étudiées, les parties rares de la distribution d’origine disparaissent progressivement (Shumailov et al., publié dans Nature en 2024). Ce n’est pas une conséquence inévitable de toute utilisation de données synthétiques. Une étude sur l’accumulation distincte a trouvé un comportement différent lorsque les données réelles et générées étaient conservées entre générations. Une étude de classifieur d’Ahrefs distincte a échantillonné une page anglaise nouvellement détectée par domaine parmi 900 000 pages en avril 2025 et en a classé 74,2 % comme contenant du texte généré par AI. Cette étude d’éditeur n’est pas un recensement du web. L’atténuation commence par le mélange de données synthétiques et réelles, le filtrage et le suivi de la provenance, afin que le matériel généré récursivement puisse être mesuré.
Partie VI — Passage à l’échelle et déploiement
Quand un workload ne tient plus ou ne respecte plus son SLO sur un seul appareil, il faut choisir comment répartir le travail, quel runtime offre les contrôles nécessaires et si chaque requête a besoin du même modèle.
33. Quatre formes de parallélisme
Les quatre formes diffèrent par la partie du modèle que chaque GPU détient et par ce qui circule sur la liaison entre GPU. La figure montre chacune d’elles sur deux GPU.
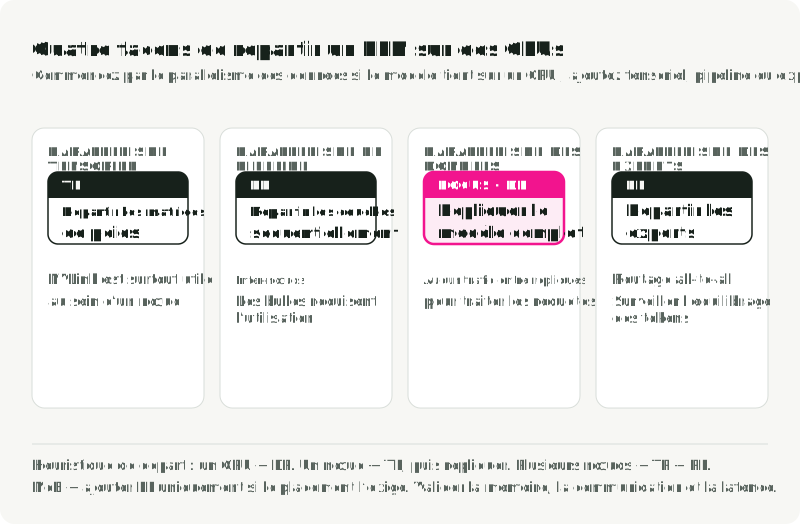
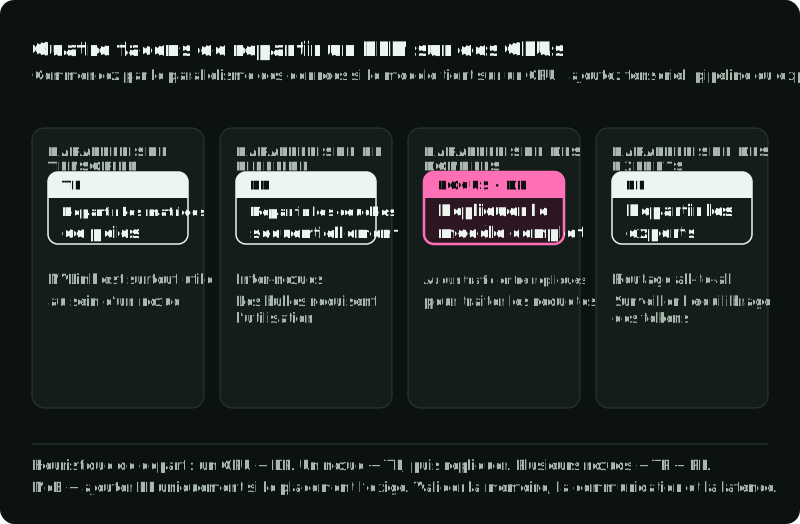
Le parallélisme tensoriel (Tensor Parallelism, TP) répartit chaque matrice de poids entre les GPU et communique en général après chaque couche. Les liaisons rapides intra-nœud comme NVLink le rendent surtout pratique au sein d’un nœud. Plus de shards réduisent la mémoire et le calcul par appareil mais augmentent la communication ; choisissez donc le degré avec un benchmark de latence.
Le parallélisme en pipeline (Pipeline Parallelism, PP) répartit les couches séquentiellement entre les GPU, en passant les activations d’une étape à l’autre. Son schéma de communication peut fonctionner entre nœuds, mais les bulles de pipeline et l’inégalité des temps d’étape réduisent l’utilisation. Les grands déploiements combinent souvent le TP au sein d’un nœud et le PP entre nœuds.
Le parallélisme de données (Data Parallelism, DP) réplique le modèle servi pour que chaque réplique traite des requêtes indépendantes, sans communication entre répliques par requête. Il est efficace quand le modèle tient et que le trafic peut être équilibré. À l’entraînement, le DP est couramment combiné avec ZeRO ou FSDP pour répartir l’état.
Le parallélisme d’experts (Expert Parallelism, EP) distribue les experts d’un MoE entre les GPU, avec une communication all-to-all pour router les tokens. Sa performance dépend de l’équilibre des tokens, du placement des experts et de la topologie de l’interconnexion ; le trafic all-to-all peut devenir le bottleneck dominant.
Une heuristique de départ pour le parallélisme :
- Le modèle tient sur un GPU : commencer par des répliques indépendantes et mesurer le passage à l’échelle du DP.
- Le modèle tient dans un nœud : tester le TP au sein du nœud, puis répliquer le groupe si le trafic l’exige.
- Le modèle s’étend sur plusieurs nœuds : tester une combinaison TP et PP selon l’interconnexion et la cible de latence.
- Mixture of experts : n’ajouter l’EP que si le placement des experts l’exige.
34. Comparaison des serving frameworks
Le runtime décide lesquelles des optimisations de la Partie III vous obtenez sans écrire de kernels. Utilisez le tableau pour choisir le premier à tester en benchmark, puis comparez-le à une alternative avec les mêmes prompts, longueurs de sortie, hardware et SLO.
| Runtime | À utiliser quand | À vérifier d’abord |
|---|---|---|
| vLLM | Serving GPU généraliste avec une API compatible OpenAI | Le modèle et le GPU cibles dans la matrice de compatibilité actuelle |
| SGLang | Le trafic partage de longs préfixes (system prompts, chat multi-tours, agents) ou demande des structured outputs | Le taux de hit du prefix cache sur votre propre trafic |
| TensorRT-LLM | Le parc est uniquement NVIDIA et la latence la plus basse compte plus que la portabilité | La prise en charge de votre modèle et de votre précision (FP8, FP4) |
| llama.cpp | CPU, Apple silicon ou un seul GPU grand public, avec des modèles quantifiés GGUF | Les tokens par seconde de son outil de benchmark sur la machine cible |
| Ollama | Développement local et démos | Passer à un serving runtime avant la forte concurrence ou le travail sur le SLO |
Les mêmes points de départ pour le benchmark sous forme de liste ordonnée :
- Une seule machine locale ou un seul GPU grand public : commencer par llama.cpp, ou Ollama pour le développement.
- Uniquement NVIDIA et la latence est prioritaire : inclure TensorRT-LLM dans le benchmark.
- Longs préfixes partagés ou structured output : SGLang.
- Sinon : vLLM.
Faites un benchmark du premier choix sur vos prompts, vos longueurs de sortie, votre hardware et votre SLO.
vLLM fournit l’allocation paginée du KV, le continuous batching, une API compatible OpenAI et plusieurs modes de parallélisme. La prise en charge des modèles et du hardware change souvent.
SGLang combine RadixAttention pour la réutilisation des préfixes, un scheduler personnalisé et la génération structurée. Les gains de débit qu’il publie dépendent du workload et de la configuration.
TensorRT-LLM vise une faible latence par requête grâce à la capture et à la réexécution de graphes CUDA, qui réduisent le surcoût de lancement, et à l’optimisation des kernels, y compris la fusion, avec un support natif de FP8/FP4. Les versions antérieures comme v1.2.0 permettaient de compiler un moteur TensorRT à l’avance. Le guide de migration actuel de NVIDIA définit PyTorch comme unique backend : son API LLM et trtllm-serve chargent directement un checkpoint Hugging Face, sans compilation de moteur. Les chiffres publiés concernent des matériels et des modèles précis, et TensorRT-LLM fonctionne uniquement sur les GPUs NVIDIA.
TGI a été archivé le 21 mars 2026 et son dépôt est en lecture seule. Son README recommande vLLM, SGLang, llama.cpp ou MLX pour les nouveaux déploiements.
Ollama met l’accent sur un workflow local simple avec les modèles.
llama.cpp est un runtime C/C++ portable, avec des chemins ARM, x86, Metal, CUDA, ROCm et Vulkan. GGUF prend en charge plusieurs niveaux de quantification. La performance varie beaucoup selon le modèle, la quantification, le contexte et le backend.
35. Choix d’un GPU pour l’inférence
Le tableau compare des caractéristiques de hardware publiées. La prise en charge d’une précision par le fournisseur ne rend pas les chiffres de calcul de crête directement comparables d’un format à l’autre ; choisissez donc d’abord selon l’adéquation mémoire, puis mesurez le workload cible en benchmark. Vérifiez séparément les prix actuels du cloud, car ils varient selon le fournisseur, la région, l’engagement et la disponibilité.
| GPU | Mémoire | Bande passante | Basse précision native | NVLink par GPU |
|---|---|---|---|---|
| B200 SXM | 180 Go HBM3e | Jusqu’à 8 To/s | FP4, FP8 | 1,8 To/s |
| H200 SXM | 141 Go HBM3e | 4,8 To/s | FP8 | 900 Go/s |
| H100 SXM | 80 Go HBM3 | 3,35 To/s | FP8 | 900 Go/s |
| A100 80 Go SXM | 80 Go HBM2e | 2,039 To/s | INT8 (pas de FP8) | 600 Go/s |
| L40S | 48 Go GDDR6 | 864 Go/s | FP8 | Aucun |
| A10G (AWS G5) | 24 Go GDDR6 | 600 Go/s | INT8 (pas de FP8) | Aucun |
| RTX 4090 | 24 Go GDDR6X | ~1 To/s | FP8 | Aucun |
La ligne A10G utilise la spécification A10 de NVIDIA comme approximation de bande passante ; la spécification AWS G5 liée n’établit pas la bande passante exacte de l’A10G. Le chiffre de la RTX 4090 (1 008 Go/s) provient du livre blanc de l’architecture Ada.
La capacité de 141 Go du H200 peut simplifier certains déploiements de grands modèles. Les cartes GDDR des lignes du bas ont un tiers ou moins de la bande passante du H100 et pas de NVLink ; elles conviennent donc mieux aux modèles quantifiés qui tiennent sur un seul GPU qu’aux modèles qui exigent du parallélisme tensoriel.
AWQ et GPTQ servent des modèles 4 bits en déquantifiant les opérations matricielles prises en charge vers un format de calcul comme FP16 ou BF16. La compatibilité et la vitesse dépendent encore de l’architecture du modèle, du format de quantification, du backend de serving, du kernel et du GPU ; consultez donc la matrice de prise en charge du backend et mesurez l’artefact exact en benchmark. Tous les GPU listés prennent en charge les opérations matricielles INT8.
Le decode des LLM est souvent limité par la bande passante mémoire ; la capacité et la bande passante de la HBM peuvent donc compter plus que les TFLOPS de crête pour les workloads de serving. Comparez les GPU en gardant constants le modèle, la précision, la distribution des batchs, la longueur de contexte et la cible de latence.
36. Cascading et routage de modèles
Le routage de modèles choisit quel LLM traite chaque requête selon sa complexité ou la capacité prédites. RouteLLM (LMSYS/UC Berkeley, ICLR 2025) rapporte un rapport de coûts de 3,66 fois à 95 % du score de référence GPT-4-Turbo sur MT-Bench dans le tableau 6. Cela correspond à un coût modélisé inférieur d’environ 73 % avec les prix, le modèle faible et la procédure de notation de cette expérience. L’intérêt du routage dépend des prix actuels, du mélange de trafic, des erreurs du routeur et du seuil de qualité minimal.
Les routeurs vont de classifieurs légers à des juges à base de LLM. Le cascading en est la variante séquentielle : une requête commence avec un modèle moins cher et monte vers un modèle plus fort quand une fonction de score rejette la réponse. FrugalGPT annonce jusqu’à 98 % de coût en moins, ou jusqu’à 4 % de précision en plus, dans son pool de modèles évalué. Une cascade de production a besoin de critères d’escalade calibrés et d’un monitoring des requêtes que le modèle peu coûteux accepte à tort. La figure montre où chaque approche fait son choix et où chacune échoue.
Partie VII — Applications
Les applications échouent là où la stack de serving ne regarde pas. La recherche documentaire peut échouer avant le début de la génération, les agents peuvent choisir une action invalide, et un changement de prompt peut améliorer une tâche tout en en dégradant une autre.
37. Modèles d’embeddings contre modèles génératifs
Les modèles d’embeddings encodent le texte en vecteurs de dimension fixe qui capturent le sens sémantique. Les modèles à vecteur unique comparés ci-dessous renvoient un vecteur dense par entrée, avec couramment quelques centaines à plusieurs milliers de dimensions. D’autres architectures de récupération peuvent conserver plusieurs vecteurs au niveau des tokens ; la comparaison de stockage suivante concerne les embeddings à vecteur unique. Leur ossature comprend des transformers encoder-only bidirectionnels et des modèles dérivés de décodeurs adaptés à l’apprentissage de représentations. Une couche de pooling réduit souvent les représentations par token à un seul vecteur par mean pooling, par un token de classification spécial ou par une méthode propre au modèle fondée sur le dernier token. Un fine-tuning contrastif rapproche ensuite les textes sémantiquement similaires et éloigne les textes dissemblables.
Les modèles d’embeddings actuels diffèrent par les propriétés qui fixent le coût de stockage et le choix de l’index : dimensions de sortie, types d’entrée acceptés, déploiement et précision de sortie.
| Modèle | Dimensions max. | Entrée | Poids | Précision de sortie native |
|---|---|---|---|---|
| Qwen3-Embedding-8B | 4,096 (32–4,096 via MRL) | Texte | Ouverts (Apache 2.0) | Flottant |
| Gemini Embedding 2 | 3,072 (128–3,072) | Texte, image, vidéo, audio, PDF | API | Non indiquée |
| pplx-embed-v1-4B | 2,560 (MRL) | Texte | Ouverts (MIT) | INT8 et binaire |
| OpenAI text-embedding-3-large | 3,072 (raccourci via dimensions) | Texte | API | Flottant |
Ce sont des exemples, pas un classement. Évaluez la langue, la modalité, la tâche, la dimension et le coût de serving sur un même jeu de test de recherche.
Matryoshka Representation Learning (MRL, Kusupati et al., NeurIPS 2022) rend les dimensions des embeddings flexibles. Nommé d’après les poupées russes gigognes, MRL entraîne certains préfixes d’embedding à conserver des informations utiles. Ses expériences comparent ces préfixes à de plus petites représentations entraînées séparément ; égaler leur qualité est un résultat empirique, pas une garantie pour toutes les tâches. Pendant l’entraînement, MRL agrège les pertes sur un ensemble de dimensions de préfixe de taille , en général des divisions par deux successives ; l’exemple à 2048 dimensions de l’article utilise . La perte agrégée pousse les premières dimensions à porter une information sémantique grossière, les dimensions suivantes ajoutant des détails plus fins.
Après l’entraînement, un embedding MRL peut être tronqué à une dimension de préfixe prise en charge. OpenAI rapporte que text-embedding-3-large à 256 dimensions dépasse text-embedding-ada-002 à 1 536 dimensions dans la comparaison MTEB qu’il cite. Cela donne une réduction de 6 fois du stockage brut des vecteurs ; la latence de recherche et le coût de la base dépendent aussi de l’index, des métadonnées, du filtrage et du hardware.
Le modèle d’embeddings est un composant important d’un pipeline RAG, avec le parsing, le chunking, la recherche, le reranking et la génération. Si les éléments pertinents ne sont pas récupérés, un générateur plus puissant ne peut pas les retrouver de façon fiable.
38. Architecture RAG en production
Le Retrieval-Augmented Generation fournit à un LLM des documents récupérés au moment de la requête. Il peut apporter des éléments à jour ou privés qui sont absents des poids du modèle, mais la récupération ne garantit pas que la réponse les utilise correctement. Un système RAG de production est un pipeline à plusieurs étapes, dont chacune demande une évaluation séparée. La figure montre le chemin d’ingestion hors ligne, le chemin par requête et l’endroit où surviennent les trois modes de défaillance listés ci-dessous.
Le pipeline d’ingestion s’exécute hors ligne. Les documents bruts (PDF, HTML, Markdown, bases de données) sont d’abord parsés en texte propre. Le parsing des PDF peut perdre des tableaux, des en-têtes et la mise en forme. Le texte est ensuite découpé en chunks, dont l’embedding est calculé et qui sont indexés indépendamment.
Le chunking affecte à la fois le rappel de la récupération et le contexte disponible pour le générateur. Les tailles utiles dépendent de la structure des documents, de la granularité des requêtes, des limites de l’embedder et de celles du reranker. Les approches courantes sont le découpage de taille fixe avec chevauchement, le découpage récursif selon les frontières du document et le chunking sémantique par similarité d’embeddings. Comparez-les sur des étiquettes de pertinence au niveau de la page ou de la section, au lieu d’adopter partout une même plage de tokens.
Chaque chunk reçoit ensuite son embedding avec un modèle comme ceux de la Section 37 et est stocké dans un index vectoriel. pgvector garde les vecteurs dans une base Postgres que vous exploitez déjà. Un store dédié comme Qdrant, Weaviate ou Pinecone ajoute la recherche hybride intégrée et fait évoluer l’index séparément de la base de l’application.
Le pipeline de récupération s’exécute au moment de la requête. Partez d’une référence mesurable, puis ajoutez des étapes quand l’analyse d’erreurs montre qu’elles corrigent un vrai manque :
- La recherche hybride combine la récupération vectorielle dense avec une récupération parcimonieuse comme BM25, souvent fusionnées par Reciprocal Rank Fusion (RRF). La recherche dense gère les paraphrases sémantiques ; la recherche parcimonieuse attrape les identifiants exacts, les codes d’erreur et les acronymes. Les benchmarks des éditeurs rapportent des gains par rapport aux références purement vectorielles, mais leur ampleur dépend du corpus et des étiquettes de pertinence.
- Le reranking fait passer les candidats récupérés dans un modèle qui évalue ensemble la requête et le document. Cela peut améliorer la pertinence fine au prix d’un appel de modèle supplémentaire. Le nombre de candidats, le nombre retenu et la latence doivent être réglés ensemble. J’ai couvert le pipeline multi-étapes complet dans Construire une stack moderne de classement de recherche.
- La transformation de requête reformule la requête de l’utilisateur avant la récupération pour améliorer le rappel. HyDE (Hypothetical Document Embeddings) fait générer un document hypothétique par le LLM ; son embedding est calculé et utilisé pour récupérer des documents réels. Le texte généré sert de représentation de recherche, pas de preuve vérifiée pour la réponse. L’expansion multi-requêtes génère plusieurs formulations de la même question. Le step-back prompting pose d’abord une question plus générale pour récupérer des informations ou raisonner à partir de principes plus généraux.
Les modes de défaillance courants :
- Échec de récupération — le bon document existe mais n’est pas récupéré. Testez le chunking, la transformation de requête, la recherche hybride et le filtrage par métadonnées sur le cas manqué.
- Empoisonnement du contexte — des chunks récupérés non pertinents induisent le LLM en erreur. Testez le reranking, les filtres de contexte et des ensembles retenus plus petits.
- Lost-in-the-middle — dans les configurations testées de question-réponse multi-documents et de récupération clé-valeur, Liu et al. ont constaté que la performance de réponse était généralement la plus haute quand l’information pertinente apparaissait près du début ou de la fin de l’entrée, et plus basse quand elle apparaissait au milieu.
GraphRAG (Microsoft, 2024) extrait des entités et des relations, détecte des communautés dans le graphe et construit des résumés de communautés. Sa méthode de recherche globale répond aux questions au niveau du corpus à partir de ces résumés ; ce n’est pas une simple récupération vectorielle avec un graphe ajouté. Le compromis est un travail supplémentaire d’extraction, d’indexation, de stockage et d’évaluation.
Des guides de praticiens publient des plages de latence pour l’embedding, la recherche, le reranking et la génération, mais ces chiffres varient selon la région, le corpus, le hardware et le modèle. Mesurez chaque étape dans les traces et évaluez le changement de qualité avant d’accepter la latence ajoutée.
39. Architectures d’agents et tool calling
Les agents LLM utilisent des modèles pour sélectionner et enchaîner des tool calls autour d’un état qui évolue. Trois patterns d’orchestration utiles :
- ReAct — alterne la sélection d’actions et les observations. Il peut s’adapter après chaque tool result, mais un historique qui grossit augmente le coût en tokens et en latence.
- ReWOO — planifie les tool calls avec des variables de substitution et des dépendances de résultats explicites, puis exécute le plan et synthétise. Seuls les appels indépendants peuvent s’exécuter en parallèle ; un appel qui se réfère à un résultat précédent doit l’attendre. Son article rapporte des économies de tokens par rapport à ReAct, mais le plan fixe exige un chemin de reprise explicite en cas d’échec d’un outil.
- Planner-executor — sépare la planification de l’exécution et peut ajouter une politique de replanification après un échec. Il permet un modèle différent pour chaque rôle, mais ajoute un état de plan et un second appel de modèle qui peut échouer.
| Pattern | Travail répété du modèle | Adaptabilité | Point de départ utile |
|---|---|---|---|
| ReAct | Lit les observations avant l’action suivante | Se met à jour après les observations | tool use incertain ou exploratoire |
| ReWOO | Réutilise un plan avec des dépendances explicites | Plan fixe sauf extension | Travail planifiable avant les tool results |
| Planner-executor | Planifie, exécute et peut replanifier | Peut réviser le plan explicite | Tâches plus longues qui gagnent à être contrôlées |
La figure dessine les trois patterns, pour que vous voyiez où chacun planifie et s’il a un chemin de retour après un tool result.
Le function calling est un mécanisme courant d’invocation d’outils. Les API exposent des définitions d’outils et renvoient des arguments structurés, ce qui réduit le besoin de parser du texte libre. Des arguments valides selon le schéma peuvent quand même sélectionner le mauvais outil ou contenir des valeurs invalides. Le function calling parallèle peut réduire les allers-retours quand les opérations sont indépendantes.
Les structured outputs et le constrained decoding imposent un schéma en restreignant les tokens disponibles à chaque étape de génération. Des moteurs comme xgrammar, utilisé dans vLLM et SGLang, peuvent supprimer de nombreux échecs de syntaxe et de parsing avec un faible overhead dans les configurations prises en charge. Ils ne garantissent pas que les valeurs extraites ou les décisions soient correctes. Le Schema-Guided Reasoning (SGR) utilise l’ordre des champs et la structure du schéma pour rendre l’état intermédiaire inspectable avant la décision finale. Ses trois patterns sont Cascade (étapes séquentielles), Routing (types union comme aiguillages sémantiques) et Cycle (listes bornées).
Un ensemble d’outils plus grand et une séquence d’actions plus longue peuvent réduire la qualité de sélection et augmenter la latence ou le coût en tokens. Mesurez ces courbes avec les descriptions d’outils réelles et la distribution réelle des échecs. Des frameworks comme LangGraph peuvent rendre explicites l’état et les chemins de reprise, mais ils ne suppriment pas la charge d’évaluation.
40. Prompt engineering pour la production
Le prompting de production est un problème d’évaluation : changez une partie du prompt ou du contexte, puis mesurez la qualité de la tâche et les modes de défaillance. Les techniques ci-dessous sont des points de départ courants, pas un ordre universel.
Les exemples few-shot sont souvent efficaces pour contrôler le format de sortie. Commencez avec 3 à 5 exemples qui couvrent les entrées vides, les requêtes ambiguës et les réponses en plusieurs parties, puis mesurez le résultat sur un jeu de validation mis de côté. Les exemples doivent couvrir la vraie distribution des entrées et pas seulement le cas nominal. Plus d’exemples consomment du contexte et ne garantissent pas d’autres gains.
Le prompting chain-of-thought (CoT) demande à un modèle d’exposer son raisonnement intermédiaire avant de répondre. Kojima et al. (2022) ont rapporté des gains avec le suffixe « Let’s think step by step » sur leurs tâches de raisonnement testées, mais l’effet varie selon le modèle et les API de raisonnement récentes peuvent ne pas exposer les traces cachées. En production, préférez une décomposition de tâche inspectable ou une justification concise quand elle est utile à l’évaluateur. L’auto-cohérence (Wang et al., 2023) échantillonne plusieurs chemins de raisonnement et agrège les réponses, échangeant un coût d’inférence supplémentaire contre de la robustesse sur les tâches adaptées.
Les structured outputs avec des JSON Schema explicites (Section 39) suppriment de nombreux échecs de parsing. Des moteurs de constrained decoding comme xgrammar peuvent imposer la grammaire prise en charge pendant la génération ; l’exactitude factuelle et la validité sémantique demandent toujours une évaluation, et les fonctionnalités de schéma non prises en charge peuvent encore demander un traitement.
Le prompt chaining découpe une tâche en étapes ciblées, par exemple classifier l’intention → récupérer le contexte → générer la réponse → valider la sortie. Il peut localiser les échecs, permettre des modèles différents par étape et exposer un état intermédiaire pouvant être mis en cache. Il ajoute aussi des interfaces et de la latence ; comparez-le donc à une référence en appel unique.
La température modifie la distribution d’échantillonnage. Des valeurs basses sont un point de départ raisonnable pour la classification ou l’extraction ; des valeurs plus élevées peuvent augmenter la diversité pour le brainstorming. Le comportement exact diffère selon les API de modèles et interagit avec top_p, top_k et les valeurs par défaut du fournisseur ; balayez donc les réglages pris en charge sur la tâche au lieu de copier une plage unique.
La séparation entre message système et message utilisateur garde la politique persistante à l’écart du contenu propre à chaque requête. Les chat templates et l’instruction tuning donnent à ces rôles des priorités différentes, mais ils ne font pas du message système une frontière d’application des règles. Mettez le comportement stable dans le message système, gardez les données non fiables dans le contenu utilisateur ou d’outil, et appliquez aussi les contraintes strictes, comme la suppression des PII, en dehors du modèle.
Le context engineering étend le travail sur les prompts à l’assemblage des documents récupérés, des tool results, de l’historique de conversation et des exemples. Liu et al. ont observé un effet lost-in-the-middle dans les modèles à contexte long qu’ils ont testés ; la position doit donc faire partie de l’évaluation au lieu d’être supposée sans importance. J’ai couvert le workflow plus large dans Context engineering pour les AI agents.
Partie VIII — Opérations en production
Les opérations en production transforment les concepts précédents en limites d’admission, tests de charge, alertes et décisions de capacité sous trafic réel.
41. Rate limiting pour les requêtes à coût variable
Le rate limiting traditionnel en requêtes par seconde suppose un coût à peu près égal par requête. Les LLM remettent cette hypothèse en cause. Un prompt de classification de 10 tokens et une analyse de document de 100K tokens atteignent le même endpoint d’API, mais leur longueur d’entrée diffère d’un facteur 10 000. Le coût total dépend aussi de la longueur de sortie, du modèle, de la mise en cache et des tarifs. Limiter en RPS laisse passer sans contrôle les requêtes coûteuses ou affame inutilement les requêtes peu coûteuses.
Les systèmes de production ont besoin d’un rate limiting par tokens selon plusieurs dimensions. OpenAI documente des limites de requêtes et de tokens par palier d’usage. Anthropic sépare les limites de tokens d’entrée et de tokens de sortie. Les quotas et algorithmes exacts peuvent changer ; considérez donc la documentation du fournisseur comme la source de référence. Le principe d’architecture est de budgétiser les requêtes et les tokens indépendamment.
Une implémentation au niveau de l’application est une hiérarchie de limites multidimensionnelle (utilisateur → application → organisation → global), avec des niveaux de priorité pour l’accès premium. Pour chaque requête, réservez les tokens à l’admission : estimez le total (entrée + max_tokens), soustrayez cette estimation du quota, puis restituez la partie inutilisée à la fin selon la consommation réelle. Cela empêche une rafale de longues générations d’épuiser la capacité avant de produire une sortie. Une requête de 2 000 tokens d’entrée avec max_tokens = 1 000 réserve 3 000 tokens. Si la réponse utilise 200 tokens de sortie, la consommation réelle est de 2 200 tokens et 800 sont restitués. C’est une politique locale d’admission ; les algorithmes de quota des fournisseurs peuvent utiliser d’autres estimations et des budgets d’entrée et de sortie séparés. Si le quota disponible est inférieur à 3 000, renvoyez un 429 ou mettez la requête en attente.
Pour les déploiements auto-hébergés, l’équivalent est le débit provisionné : réserver de la capacité GPU dédiée pour des débits de tokens cibles. Pour les déploiements vLLM, cela signifie configurer le contrôle d’admission autour des slots de decode actifs et de la pression sur le KV cache plutôt que du seul nombre de requêtes. Comme l’explique la Section 5, le débit et l’admission demandent tous deux des limites qui tiennent compte des tokens.
42. Modes de défaillance à anticiper
Le serving des LLM ajoute des modes de défaillance liés à la longueur variable des séquences, à la mémoire KV et au travail de decode de longue durée. Concevez et testez en charge les défenses avant que le trafic de production en dépende.
L’Out-of-Memory (OOM) est une défaillance courante. Un modèle 70B en FP16 a besoin d’environ 140 Go pour les seuls poids, et le KV cache d’une seule séquence de contexte 128K de Llama 3.1 70B peut ajouter environ 40 GiB selon les hypothèses de la Section 6. L’écart entre « tient en mémoire » et « OOM sous charge » est plus petit qu’il n’y paraît, car un batch de requêtes à long contexte peut consommer plus de mémoire KV que prévu. La prévention combine une réserve mémoire mesurée avec la quantification et l’allocation paginée du KV. Dans vLLM, --gpu-memory-utilization fixe la fraction de mémoire GPU que le moteur peut utiliser pour les poids, les activations et le KV cache ; le reste est la réserve. Pour les workloads à forte pression sur le KV, LMCache peut décharger les données KV vers la mémoire CPU ou le disque ; utilisez ses résultats publiés comme point de départ et mesurez la hiérarchie mémoire locale en benchmark.
La préemption survient quand la pression sur le KV cache force le scheduler à évincer ou à recalculer du travail. La stratégie exacte dépend de la version de serving et de la configuration. Du côté de l’utilisateur, le symptôme est une latence de bout en bout plus élevée sans erreur applicative évidente. Surveillez le nombre de préemptions et corrélez-le avec l’usage du KV, la profondeur de la file et les longueurs de requêtes.
La latence aux percentiles élevés peut exploser quand de gros prefills retardent le travail de decode. Le chunked prefill (Section 7) et l’ordonnancement tenant compte de la longueur ciblent cette interférence. Le scheduler Learning-to-Rank (Fu et al., 2024) et les articles sur CascadeInfer rapportent des améliorations par rapport à leurs références sous les workloads évalués, mais le résultat exact dépend de la distribution des longueurs de requêtes et de la configuration du scheduler.
Les défaillances en cascade peuvent démarrer quand des requêtes lentes font grossir la file, que les clients en amont expirent et que les retries ajoutent de la charge. Les défenses comprennent le contrôle d’admission, des limites de concurrence par tenant, des plafonds de sortie, des budgets de retry et des circuit breakers au niveau de la gateway. Des pools de prefill et de decode désagrégés peuvent aider quand les tests de charge montrent une interférence persistante entre phases. La figure montre la boucle et la défense placée sur chaque arête.
43. Monitoring des systèmes LLM
Le monitoring des LLM diffère de celui d’une API de trois façons : chaque requête a un coût différent, chaque requête comporte deux phases aux bottlenecks différents, et son empreinte mémoire dépend de la longueur de l’entrée et de celle de la sortie. La latence des requêtes et le taux d’erreur ne montrent aucun de ces trois points.
Le goodput est le nombre de requêtes par seconde qui respectent tous les seuils de SLO définis, tels que le TTFT, le TPOT et la latence totale. C’est une mesure combinée utile, car le débit brut peut sembler sain alors que les SLO de latence échouent : un système qui traite 100 requêtes par seconde mais manque ses seuils sur 40 % d’entre elles a un goodput de 60 requêtes par seconde. Optimiser le goodput garde la distribution de performance visible au lieu de ne rapporter que la moyenne.
vLLM expose un endpoint Prometheus sur /metrics avec les requêtes en cours et en attente, l’usage du KV cache, les distributions de longueurs de génération et des statistiques de prefix cache. Les noms de métriques peuvent changer d’une version à l’autre ; liez donc les dashboards à la version déployée. Une stack typique utilise Prometheus pour les métriques, Grafana pour la visualisation et des traces compatibles OpenTelemetry entre l’application et les composants de serving.
Voici des modèles d’alerte utiles. Dérivez leurs seuils de tests de charge plutôt que de copier ces exemples tels quels :
- Pics du nombre de préemptions — le runtime échange ou recalcule du travail, ce qui ajoute de la latence sans erreur applicative.
- Utilisation du KV cache proche de la zone de préemption testée — ajoutez de la capacité ou délestez la charge avant que les évictions ne se propagent en cascade.
- Profondeur de file durablement au-dessus de l’enveloppe de batch testée — le contrôle d’admission devrait commencer à rejeter ou à déprioriser.
- TTFT en hausse alors que le TPOT reste stable — cette divergence pointe d’abord vers la file d’attente, l’admission, le réseau ou la pression sur le prefill plutôt que vers le débit de decode. Utilisez les traces et les métriques de file pour les départager.
Dans vLLM, les trois premières alertes correspondent à vllm:num_preemptions_total, vllm:kv_cache_usage_perc et vllm:num_requests_waiting (métriques vLLM).
44. Optimisation des coûts : une stratégie cumulative
Les prix des fournisseurs et les rapports de prix entre entrée et sortie changent. Relevez les tarifs actuels avant une décision d’achat ; le niveau du modèle et la longueur de sortie peuvent dominer la facture avant même les optimisations d’infrastructure.
OpenAI, Anthropic et Google facturent tous les tokens de sortie plusieurs fois plus cher que les tokens d’entrée pour leurs modèles phares. Par ailleurs, la séparation prefill/decode explique les coûts d’exécution différents de l’entrée et de la sortie : le prefill traite les tokens du prompt ensemble, tandis que le decode ordinaire génère les tokens séquentiellement. Ce mécanisme seul n’établit pas comment un fournisseur fixe ses prix commerciaux. Réduire la sortie inutile (un max_tokens serré, des structured outputs, pas de reformulation de l’entrée) économise généralement plus que réduire le même nombre de tokens d’entrée.
Plusieurs approches peuvent se cumuler, mais seulement après avoir mesuré lesquelles s’appliquent au workload :
- La quantification du FP16 à l’INT4 réduit le stockage brut des valeurs des poids de 75 %, avant les échelles et autres métadonnées. Que cela réduise la facture dépend de la vitesse des kernels, de la taille du batch et de l’utilisation du hardware (Section 9).
- Le routage de modèles envoie le trafic éligible vers des modèles moins chers. Mesurez le taux de faux accepts du routeur et la qualité de bout en bout avant d’augmenter la part traitée par le modèle moins cher (Section 36).
- Le prompt caching réduit le travail sur les préfixes répétés. Les remises des fournisseurs et le traitement des limites de débit changent avec le temps ; combinez donc le taux de hit mesuré avec les conditions actuelles (Section 16).
- Les API de batch peuvent faire bénéficier d’une remise le travail non temps réel, comme les évaluations, la génération de données synthétiques et la classification en masse. Vérifiez les prix actuels et les délais d’achèvement.
- L’auto-hébergement peut être gagnant à utilisation soutenue, mais il n’existe pas de seuil de rentabilité universel en volume de tokens. Incluez l’ingénierie, l’orchestration, l’observabilité, la marge de capacité et les coûts d’astreinte en plus de la location de GPU.
Ne multipliez pas les gains d’optimisations séparées comme si toutes les requêtes en bénéficiaient indépendamment : la quantification modifie le débit, le routage modifie la répartition de la qualité, et la mise en cache et le traitement par lots ne concernent que le trafic admissible. Estimez les gains à partir des proportions de trafic mesurées et vérifiez-les sur la facture.
45. Capacity planning et autoscaling
Le capacity planning du serving des LLM doit tenir compte du coût variable des requêtes, du travail de decode de longue durée et d’une mémoire qui dépend de la séquence. Selon le workload, la ressource limitante peut être la mémoire KV, la bande passante mémoire, le calcul ou l’interconnexion.
La limite théorique de mémoire sur les requêtes concurrentes vient du budget de KV cache :
Pour l’arithmétique de capacité, supposons que le runtime expose un budget KV de 40 GiB pour Llama 3.1 70B avec un KV cache en FP16. Chaque séquence de 4K utilise environ 1,25 GiB et chaque séquence de 128K environ 40 GiB. Ce budget permet donc d’en faire tenir au plus environ 32 de 4K ou une seule de 128K, avant l’overhead de l’allocateur, du runtime, de la variance du workload et du SLO. La fonction kv_cache_bytes de la Section 6 refait ce calcul pour un autre modèle ou un autre budget. C’est pourquoi le choix du GPU et l’optimisation du KV cache pilotent directement le plan de capacité.
La formule de capacité pour dimensionner un parc :
Convertissez les deux débits dans la même unité de temps avant de diviser. Utilisez le débit par GPU mesuré au SLO cible, pas le débit de crête. Un multiplicateur de 1,3 prévoit un débit supérieur de 30 % à la demande attendue, ce qui laisse environ 23 % de la capacité provisionnée inutilisée à cette demande. Arrondissez au nombre supérieur de réplicas complets de serving ; un réplica TP/PP exige son groupe de GPU entier. Les débits par GPU ne sont utiles que pour une topologie de réplica fixe et mesurée. Choisissez le multiplicateur à partir des variations brusques de charge, des défaillances et du temps de reprise mesurés. Le débit de tokens de crête et le débit conforme au SLO peuvent diverger fortement quand la concurrence augmente. Mesurez en benchmark avec la vraie distribution de longueurs de prompt et de sortie aux seuils de TTFT et de TPOT requis, plutôt que d’utiliser un maximum théorique.
L’utilisation du GPU ne suffit pas comme seul signal d’autoscaling, car elle peut rester élevée aussi bien en traitement sain qu’en surcharge. Combinez-la avec la profondeur de file, l’utilisation du KV cache et la dégradation du goodput. Réglez les seuils à partir de tests de charge ; des valeurs comme 80 % d’utilisation du KV sont des points de départ, pas des limites universelles. Ces métriques sont présentées dans la Section 43.
Le scale-to-zero peut convenir aux environnements de développement et de staging avec de longues périodes d’inactivité. Les plateformes d’inférence serverless et les autoscalers basés sur Kubernetes comme KEDA peuvent supprimer la capacité inactive, mais les économies et le temps de démarrage à froid dépendent de la taille du modèle, du cache des images et des poids, et de l’infrastructure. Mesurez le temps de démarrage avant d’appliquer la même politique au trafic de production sensible à la latence.
Comment les concepts d’inférence s’enchaînent
Les Parties I à III relient la capacité mémoire à la performance du serving. La taille du KV par séquence (Section 6) donne une limite brute du nombre de séquences résidentes. Des batchs de decode plus grands peuvent améliorer la réutilisation des poids et l’intensité arithmétique (Section 1), mais le trafic d’attention, l’ordonnancement et la communication affectent aussi le TPOT et le débit. GQA et le stockage KV à plus faible précision réduisent les données du cache ; PagedAttention réduit les pertes d’allocation. Avec la configuration Llama 3.1 70B indiquée, un KV cache en FP16 et un budget de 40 GiB, la limite brute est de 32 séquences de 4K tokens ou une de 128K, avant le surcoût du runtime et les contraintes de latence. Le contrôle d’admission peut mettre en attente ou rejeter du travail avant d’atteindre cette limite. Sous pression KV, le runtime peut préempter des requêtes ; des allocations non contrôlées peuvent provoquer un OOM (Section 42).
Le routage, le caching, la quantification et le choix du hardware ne se cumulent que lorsque chacun est évalué par rapport à la même cible de qualité et de latence. Choisissez un symptôme dans le tableau en haut de page, établissez cette référence et faites en sorte que le changement suivant soit facile à annuler.
Lectures complémentaires
Deep dives associés de ce blog, organisés par thème :
- Guide du fine-tuning des LLM — fine-tuning, RAG ou prompt engineering : quand choisir quoi
- Variantes de LLM open source et formats de fichiers — associer les variantes de modèles et les formats quantifiés au hardware
- Guide LoRAX Serving — servir des milliers d’adapters LoRA en production
- Mettre à l’échelle les grands modèles de langage — stratégies multi-GPU et multi-nœuds
- LLM locaux sur macOS — mise en place pratique avec llama.cpp et Ollama
- Boucles de raisonnement des AI agents en 2026 — deep dive sur les boucles ReAct, ReWOO et planner-executor
- Architecture mémoire des AI agents en 2026 — checkpoints, vector stores et mémoire documentaire pour les agents à état
Références
Organisées par domaine.
Inférence et attention
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness - Dao et al., NeurIPS 2022
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning - Dao, 2023
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision - Shah et al., NeurIPS 2024
- Flash-Decoding for long-context inference - Dao et al., 2023
- Efficient Memory Management for Large Language Model Serving with PagedAttention - Kwon et al., SOSP 2023
- Orca: A Distributed Serving System for Transformer-Based Generative Models - Yu et al., OSDI 2022
- GQA: Training Generalized Multi-Query Attention - Ainslie et al., 2023
- Triton: an intermediate language and compiler for neural network computations - Tillet et al., MAPL 2019
- FlashNorm: Fast Normalization for LLMs - 2024
- Deep Kernel Fusion for Transformers - DeepFusionKernel, 2026
Speculative decoding
- Accelerating Large Language Model Decoding with Speculative Sampling - Chen et al., 2023
- EAGLE-3: Scaling up Inference Acceleration of Large Language Models - Li et al., NeurIPS 2025
- Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads - ICML 2024
Quantification
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration - MLSys 2024, Best Paper
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers - Frantar et al., ICLR 2023
- Marlin: Mixed-Precision (FP16xINT4) LLM Inference Kernel - Frantar et al., 2024
Entraînement et fine-tuning
- LoRA: Low-Rank Adaptation of Large Language Models - Hu et al., ICLR 2022
- QLoRA: Efficient Finetuning of Quantized LLMs - Dettmers et al., NeurIPS 2023
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models - Rajbhandari et al., SC20
- ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning - Rajbhandari et al., 2021
- Self-Instruct: Aligning Language Models with Self-Generated Instructions - Wang et al., ACL 2023
- WizardLM: Empowering Large Language Models to Follow Complex Instructions - Xu et al., ICLR 2024
- Phi-4 Technical Report - Microsoft, 2024
- Training Deep Nets with Sublinear Memory Cost - Chen et al., 2016 (gradient checkpointing)
- AI models collapse when trained on recursively generated data - Shumailov et al., Nature 2024
Alignment
- Direct Preference Optimization: Your Language Model is Secretly a Reward Model - Rafailov et al., NeurIPS 2023
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models - Introduit GRPO
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning - DeepSeek, 2025
Scaling et architecture
- The Llama 3 Herd of Models - Meta, 2024
- LLaMA: Open and Efficient Foundation Language Models - Touvron et al. (Meta), 2023
- Llama 2: Open Foundation and Fine-Tuned Chat Models - Touvron et al. (Meta), 2023
- Qwen3 Technical Report - Qwen Team (Alibaba), 2025
- Training Compute-Optimal Large Language Models - Hoffmann et al. (Chinchilla), NeurIPS 2022
- RoFormer: Enhanced Transformer with Rotary Position Embedding - Su et al., 2021
- YaRN: Efficient Context Window Extension of Large Language Models - Peng et al., ICLR 2024
- SGLang: Efficient Execution of Structured Language Model Programs - Zheng et al., NeurIPS 2024
- Mixtral of Experts - Jiang et al. (Mistral AI), 2024
Embeddings
- Matryoshka Representation Learning - Kusupati et al., NeurIPS 2022
- pplx-embed-v1: Diffusion-Pretrained Dense and Contextual Embeddings - Perplexity AI, 2026
Architectures d’agents
- ReAct: Synergizing Reasoning and Acting in Language Models - Yao et al., ICLR 2023
- ReWOO: Decoupling Reasoning from Observations for Efficient Augmented Language Models - Xu et al., 2023
Prompting
- Large Language Models are Zero-Shot Reasoners - Kojima et al., NeurIPS 2022
- Self-Consistency Improves Chain of Thought Reasoning in Language Models - Wang et al., ICLR 2023
Routage
- RouteLLM: Learning to Route LLMs with Preference Data - Ong et al., ICLR 2025
Benchmarks
- MLPerf Inference v5.0 Results - MLCommons, avril 2025
Architectures de serving
- Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve - Agrawal et al., OSDI 2024 (chunked prefill)
- Splitwise: Efficient Generative LLM Inference Using Phase Splitting - Patel et al., ISCA 2024 (serving désagrégé)
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving - Zhong et al., OSDI 2024 (serving désagrégé)
Serving frameworks
- vLLM - Moteur de serving fondé sur PagedAttention
- SGLang - RadixAttention et génération structurée
- TensorRT-LLM - Inférence optimisée de NVIDIA
- llama.cpp - Inférence C/C++ portable
- DeepSpeed - Bibliothèque d’entraînement distribué de Microsoft
- Ollama - Exécuteur local de LLM
Opérations
- Efficient LLM Scheduling by Learning to Rank - Fu et al., NeurIPS 2024 (vLLM-LTR)
- CascadeInfer: Length-Aware Scheduling of LLM Serving with Low Latency and Load Balancing - Yuan et al., 2025
- Goodput metric as measure of ML productivity - Google Cloud, 2024
- vLLM Optimization and Tuning - Documentation vLLM
- vLLM Metrics - Documentation vLLM
- LMCache: KV Cache Management for LLM Serving - Déchargement du KV cache
- OpenAI Rate Limits - Documentation de l’API OpenAI
- Anthropic Rate Limits - Documentation de l’API Anthropic